
Figure 1 From Improving Romanian Llm Pretraining Data Using Diversity
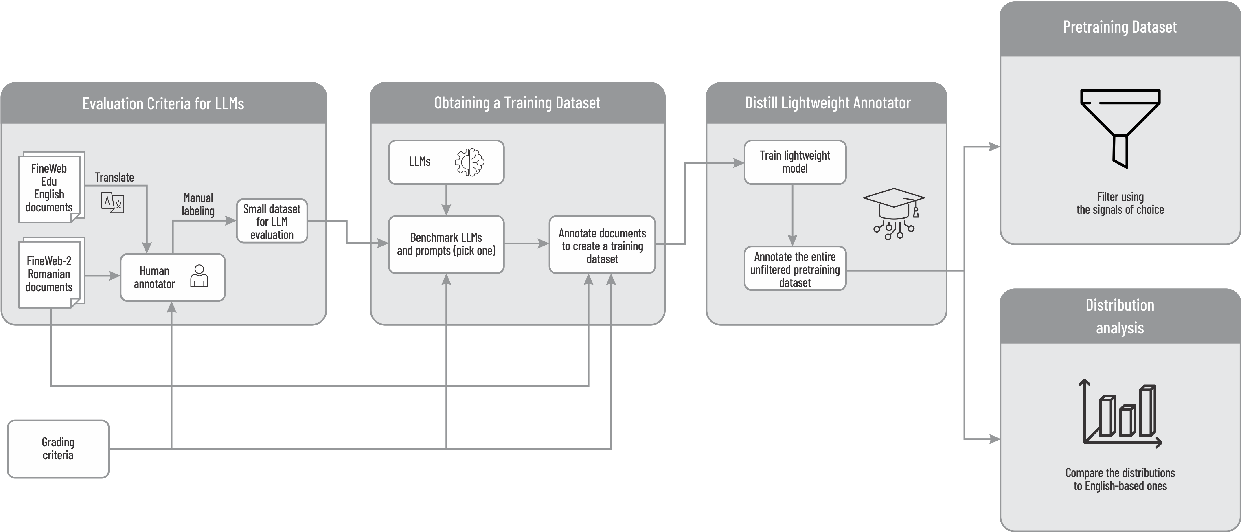
Figure 1 from Improving Romanian LLM Pretraining Data using Diversity ...

Paper page - Improving Romanian LLM Pretraining Data using Diversity ...
Improving Romanian LLM Pretraining Data using Diversity and Quality ...

Figure 2 from Improving Pretraining Data Using Perplexity Correlations ...
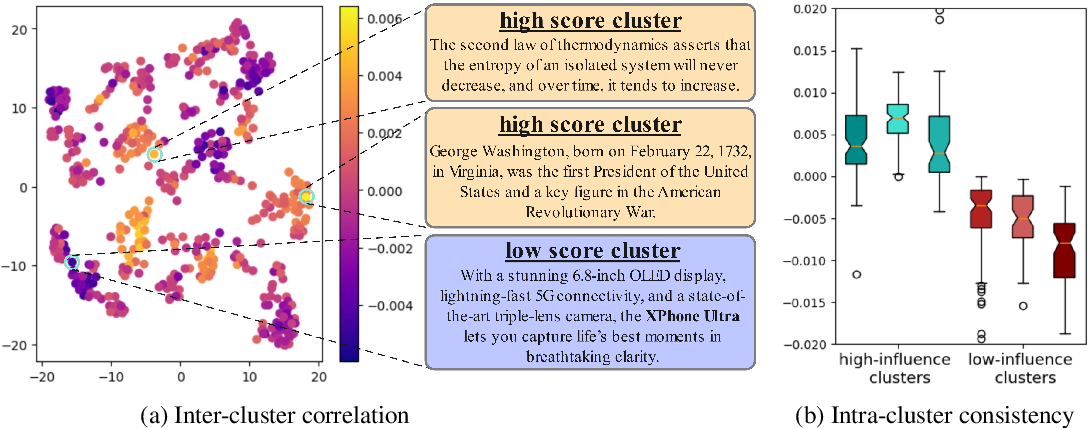
Figure 1 from Harnessing Diversity for Important Data Selection in ...

Table 1 from Efficient Pretraining Data Selection for Language Models ...

Table 1 from Efficient Pretraining Data Selection for Language Models ...

(PDF) Improving Pretraining Data Using Perplexity Correlations

[논문 리뷰] Improving Pretraining Data Using Perplexity Correlations
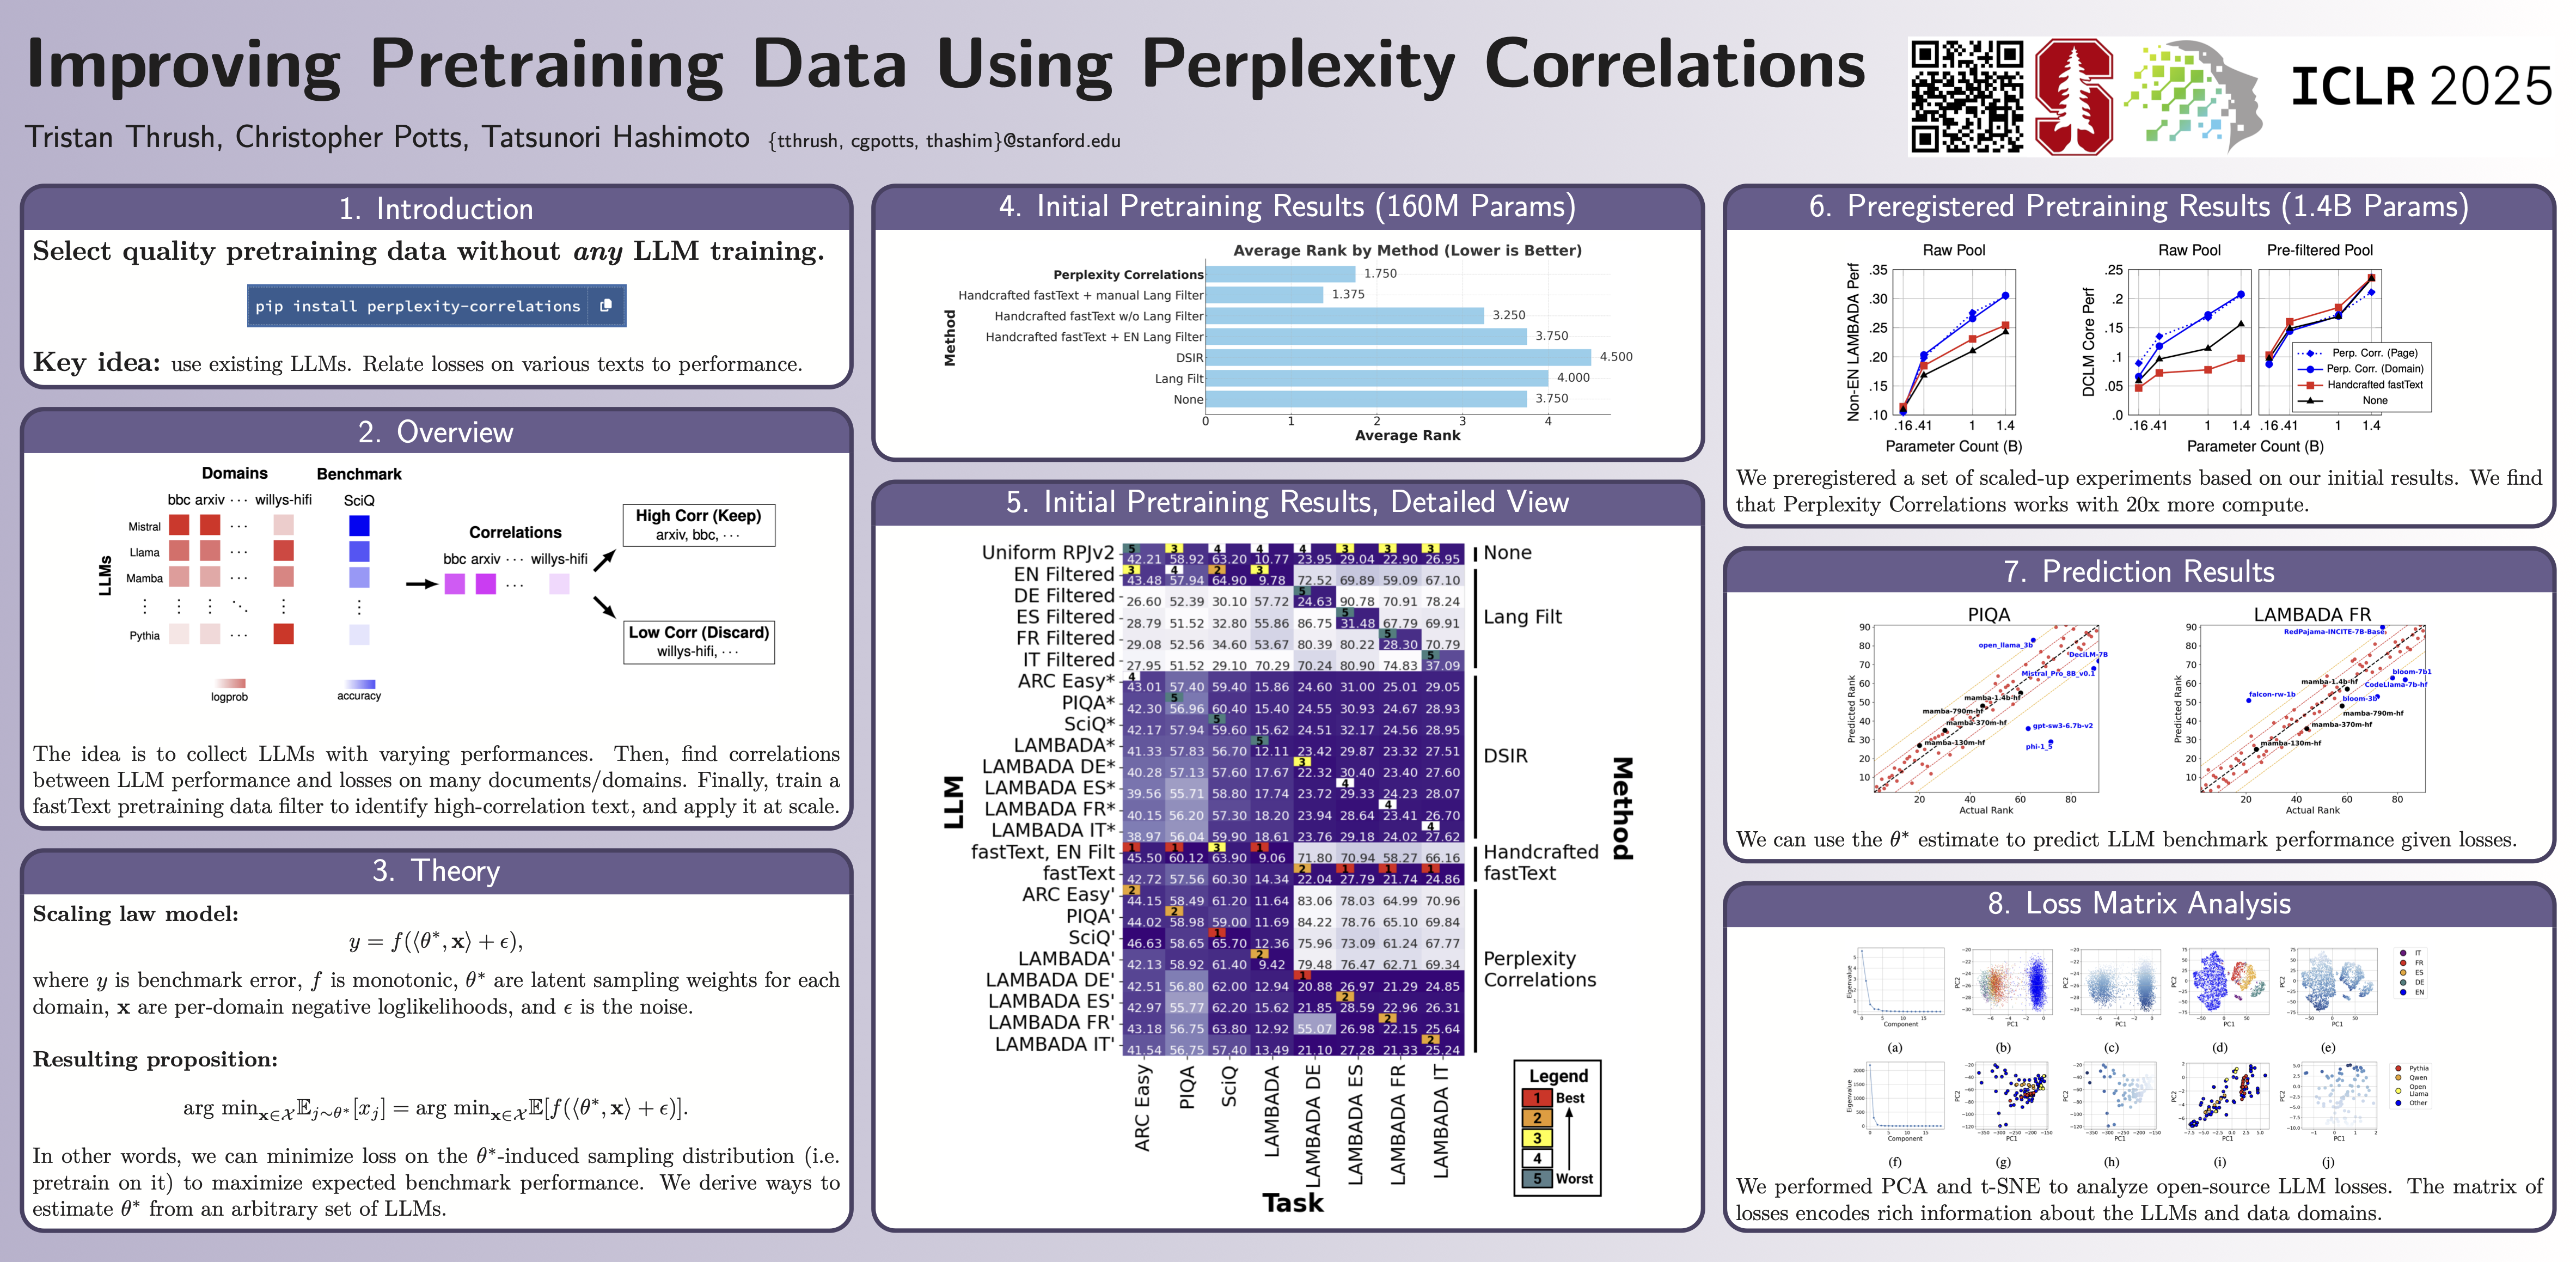
ICLR Poster Improving Pretraining Data Using Perplexity Correlations
Advertisement Space (300x250)
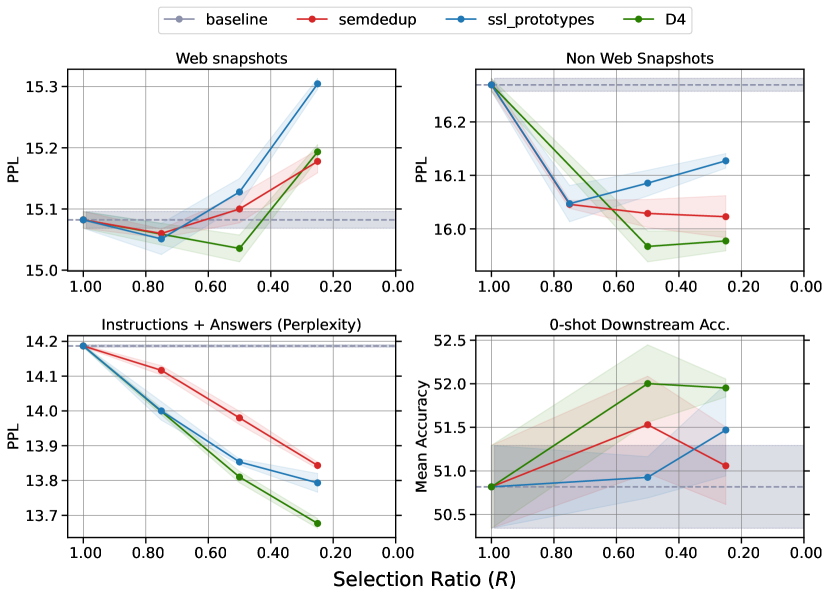
[2308.12284] D4: Improving LLM Pretraining via Document De-Duplication ...
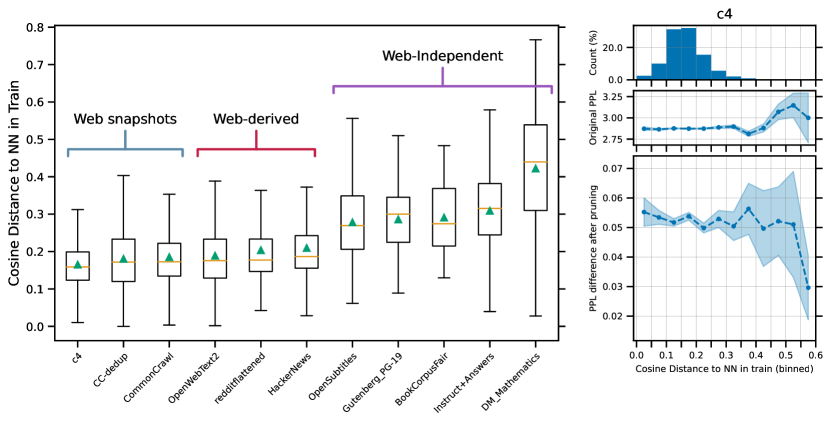
[2308.12284] D4: Improving LLM Pretraining via Document De-Duplication ...

Harnessing Diversity for Important Data Selection in Pretraining Large ...
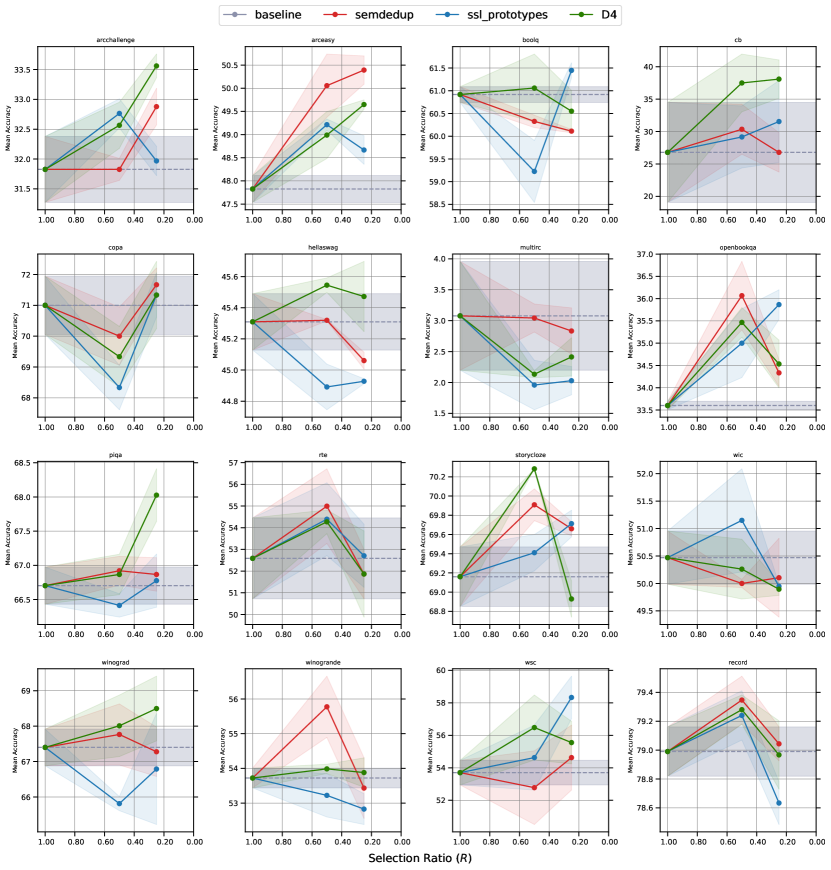
[2308.12284] D4: Improving LLM Pretraining via Document De-Duplication ...
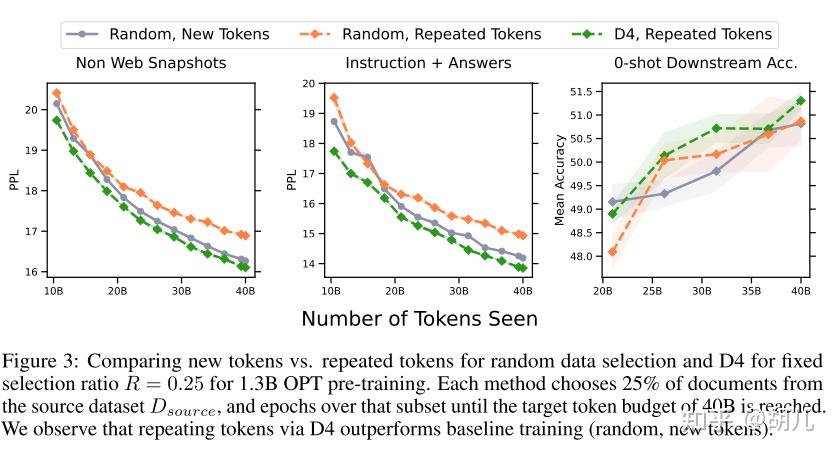
Meta论文:D4: Improving LLM Pretraining via Document De-Duplication and ...

(PDF) D4: Improving LLM Pretraining via Document De-Duplication and ...

Beyond URLs: Metadata Diversity and Position for Efficient LLM Pretraining

LLMs From Scratch - Chapter 5: Pretraining from Unlabeled Data – Daniel ...

Multilingual Prompting for Improving LLM Generation Diversity | AI ...

(PDF) Enhancing Multilingual LLM Pretraining with Model-Based Data ...
Advertisement Space (336x280)

Beyond URLs: Metadata Diversity and Position for Efficient LLM Pretraining

(PDF) Register Always Matters: Analysis of LLM Pretraining Data Through ...

Beyond URLs: Metadata Diversity and Position for Efficient LLM Pretraining

Multilingual Prompting for Improving LLM Generation Diversity | alphaXiv
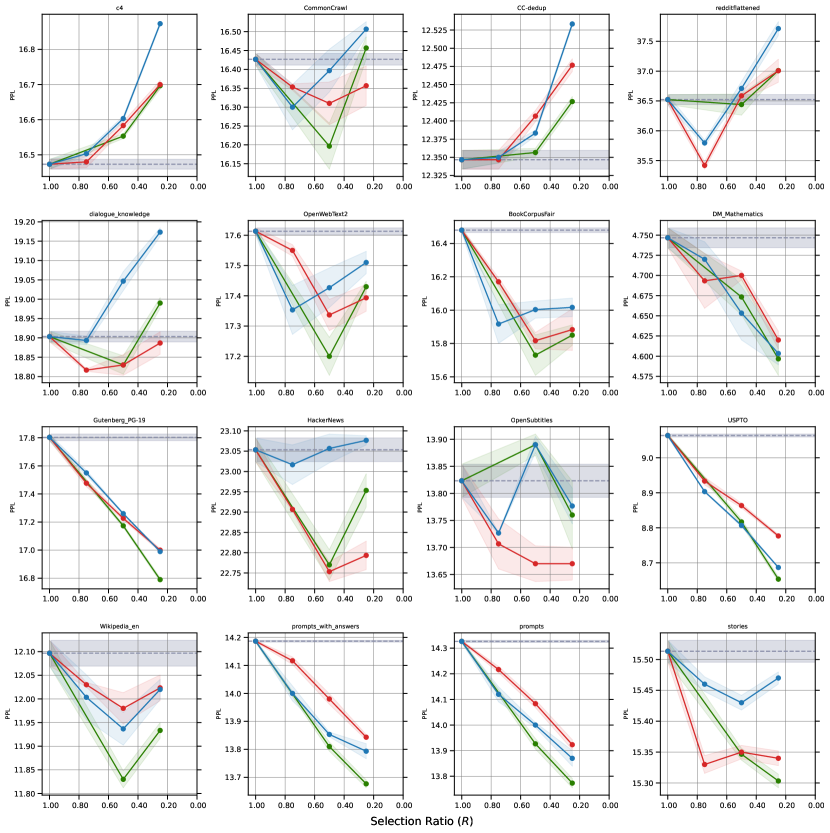
[2308.12284] D4: Improving LLM Pretraining via Document De-Duplication ...

Beyond URLs: Metadata Diversity and Position for Efficient LLM Pretraining
Enhancing Multilingual LLM Pretraining with Model-Based Data Selection ...

Figure 1 from How to Train Data-Efficient LLMs | Semantic Scholar

Pretraining Data and Tokenizer for Indic LLM | PDF
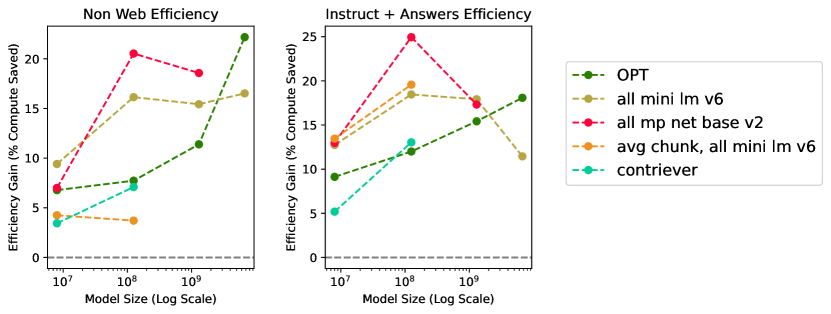
[2308.12284] D4: Improving LLM Pretraining via Document De-Duplication ...
Advertisement Space (336x280)

Beyond URLs: Metadata Diversity and Position for Efficient LLM Pretraining
On Pretraining Data Diversity for Self-Supervised Learning | AI ...

[논문 리뷰] Multilingual Prompting for Improving LLM Generation Diversity

Narratives in LLM Pretraining Data - a teagrjohnson Collection

Optimizing Pretraining Data Mixes with LLM-Estimated Utility
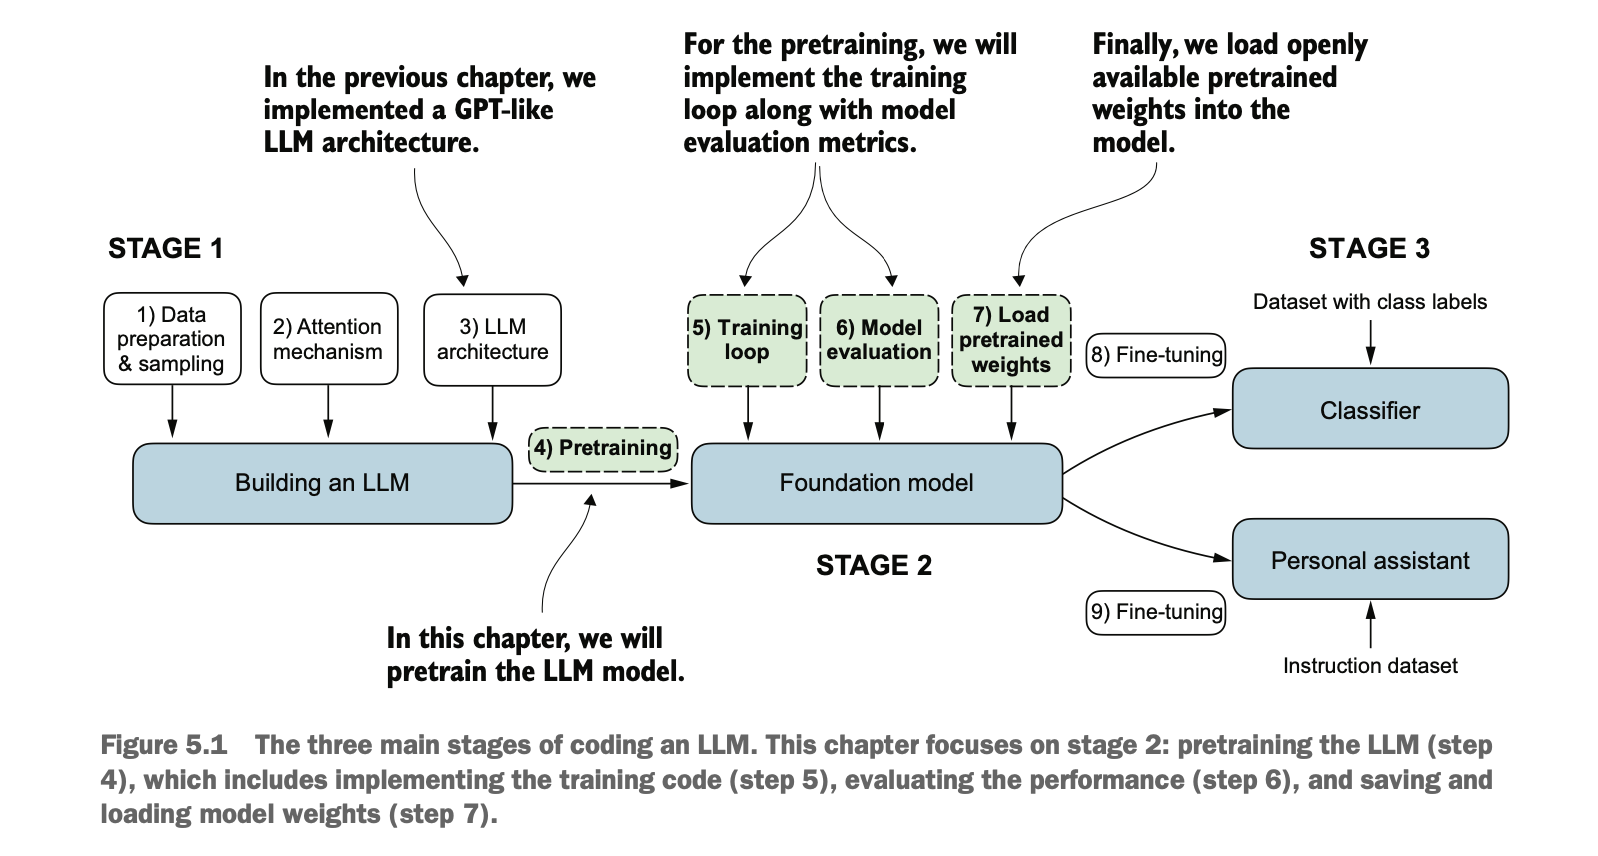
大语言模型LLM之使用无标签数据预训练 Pretraining On Unlabeled Data of Large Language ...