
Figure 1 From Interpretability Aware Vision Transformer Semantic Scholar
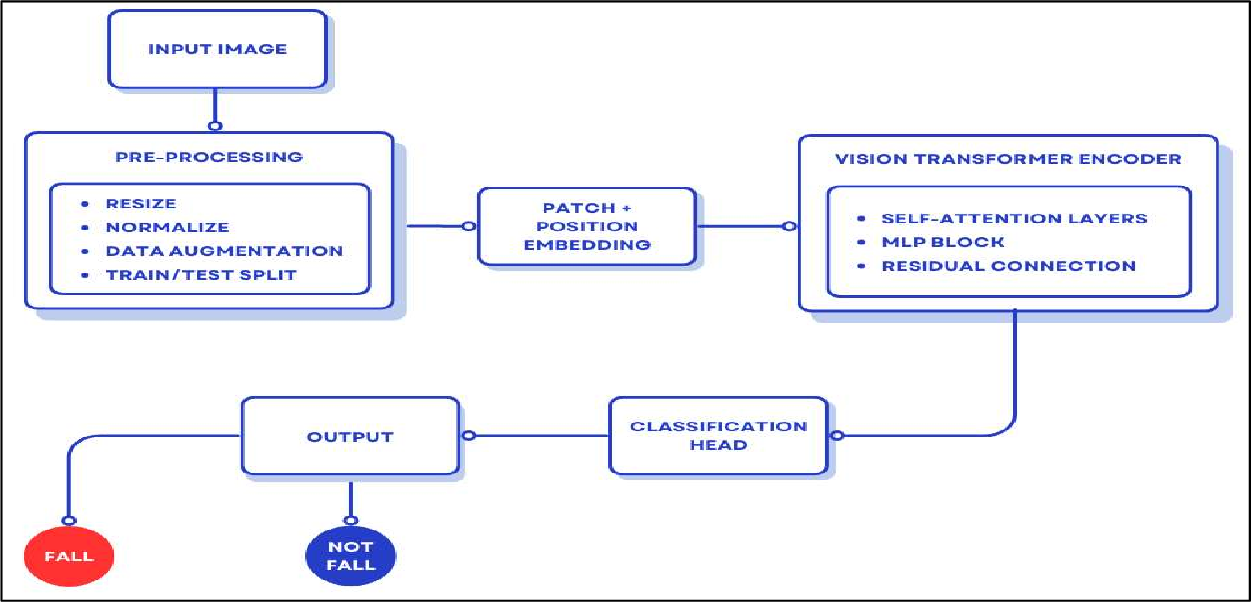
Figure 1 from Fall Detection Using Vision Transformer | Semantic Scholar
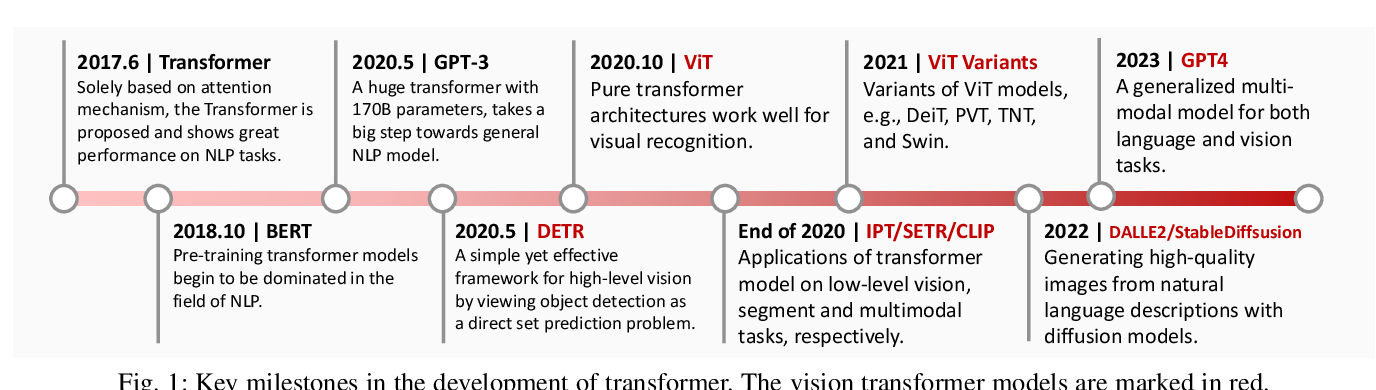
Figure 1 from A Survey on Vision Transformer | Semantic Scholar
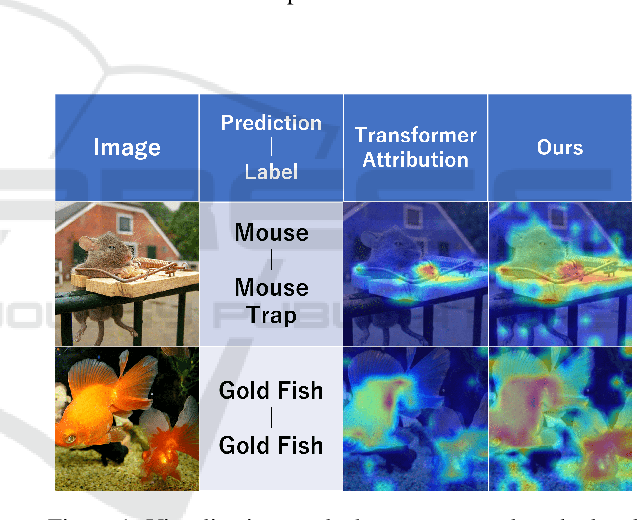
Figure 1 from Vision Transformer Interpretability via Prediction of ...
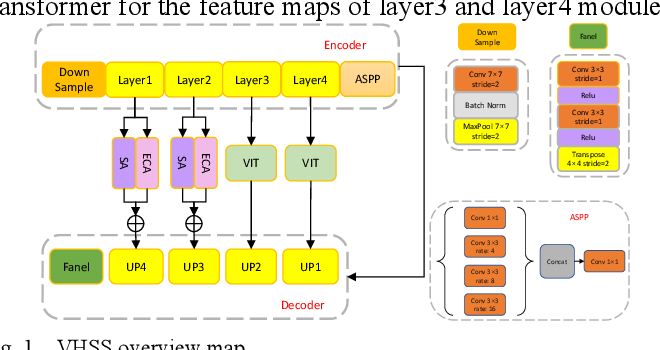
Figure 1 from Vision Transformer is Required for Hyperspectral Semantic ...
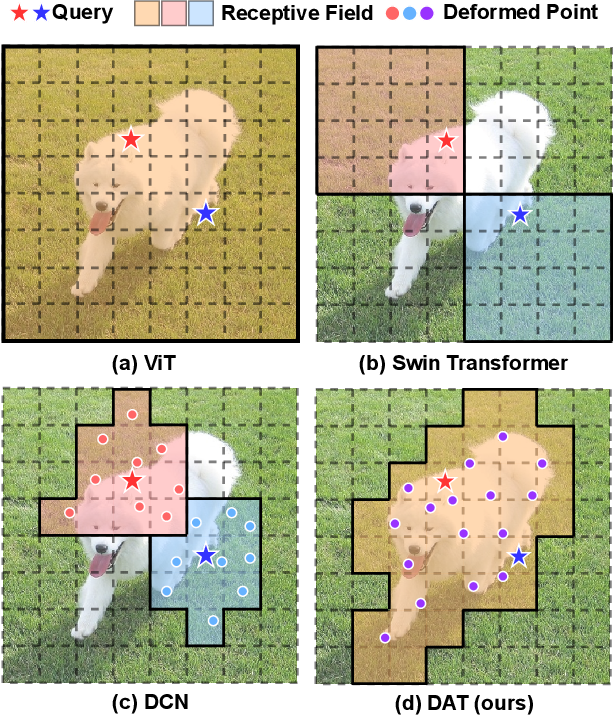
Figure 1 from Vision Transformer with Deformable Attention | Semantic ...

Figure 1 from Adversarial Vision Transformer for Medical Image Semantic ...
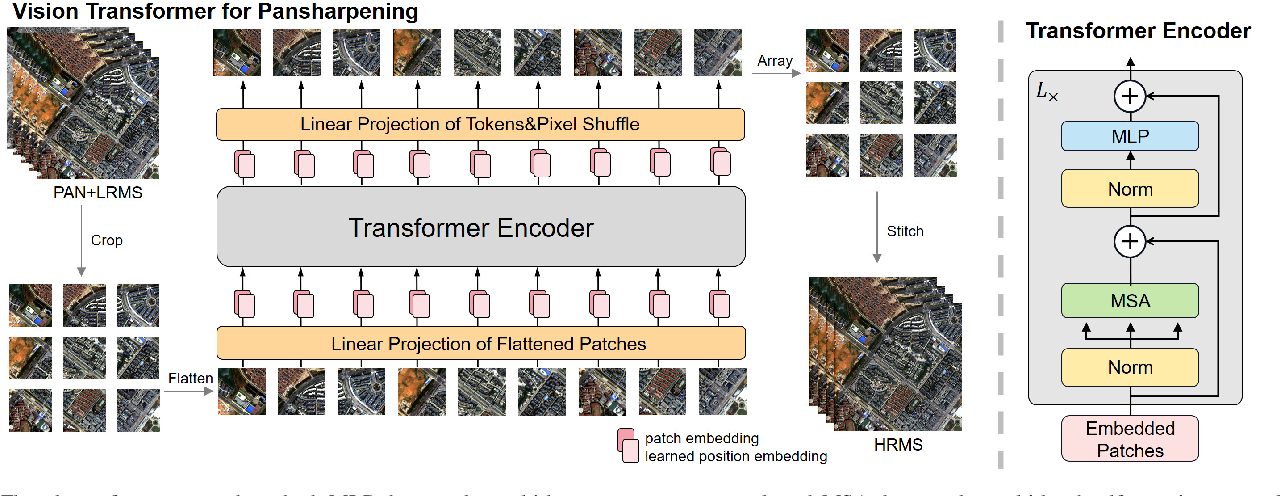
Figure 2 from Vision Transformer for Pansharpening | Semantic Scholar
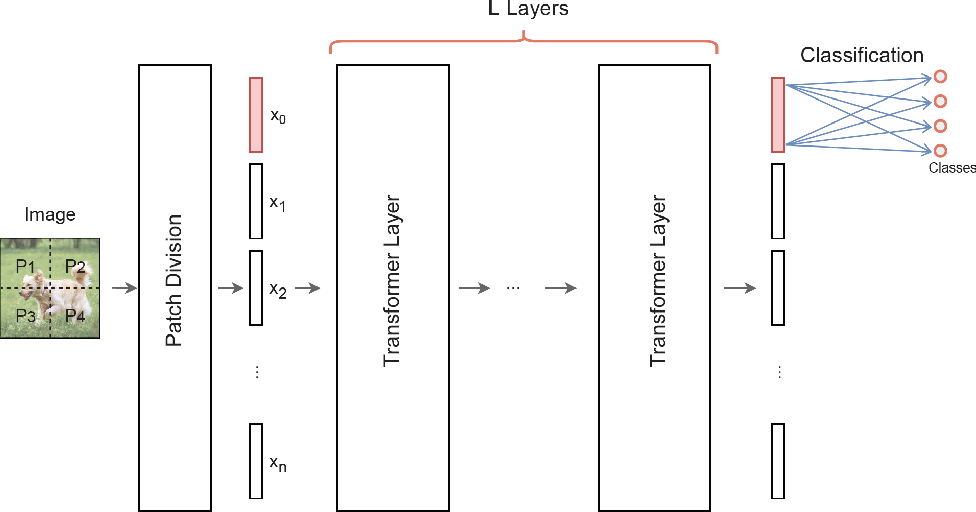
Figure 1 from Quantum Vision Transformers | Semantic Scholar

Figure 1 from Adapting LLaMA Decoder to Vision Transformer | Semantic ...

Figure 1 from Exploring Vision Transformer Layer Choosing for Semantic ...
Advertisement Space (300x250)

Figure 1 from A Convolutional Vision Transformer for Semantic ...
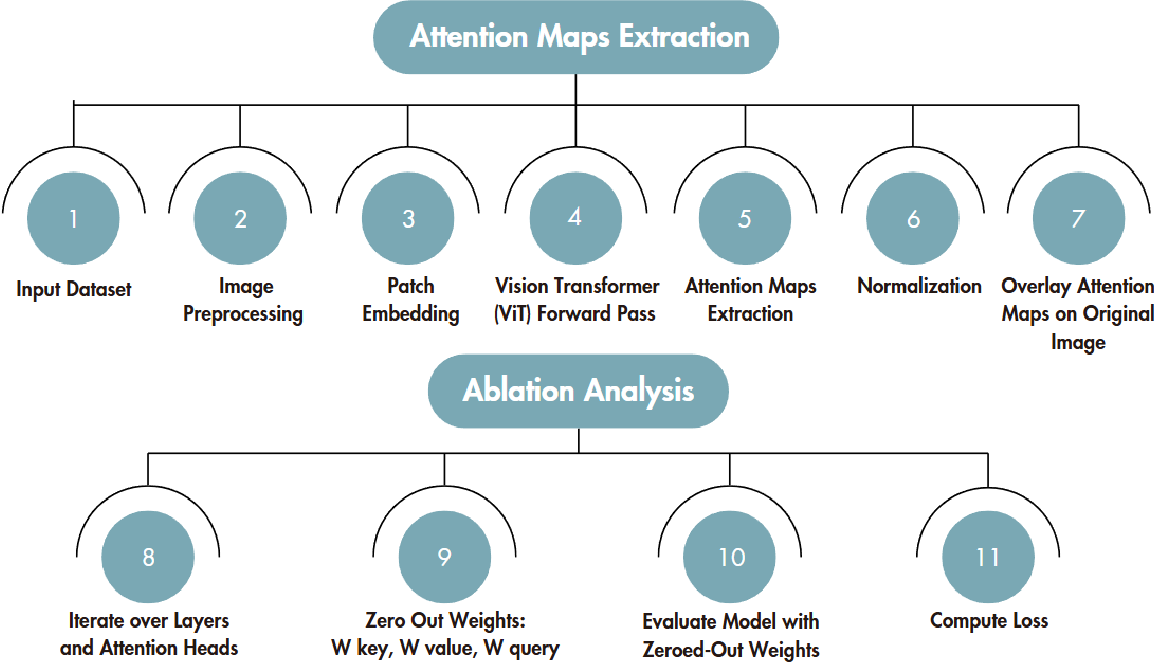
Figure 1 from Mechanistic Interpretability of Fine-Tuned Vision ...

Figure 1 from SAViT: Structure-Aware Vision Transformer Pruning via ...

Figure 1 from Vision Transformer Visualization: What Neurons Tell and ...

Figure 1 from Transformer Interpretability Beyond Attention ...

Figure 1 from History Aware Multimodal Transformer for Vision-and ...

Figure 1 from A Semantic and Motion-Aware Spatiotemporal Transformer ...
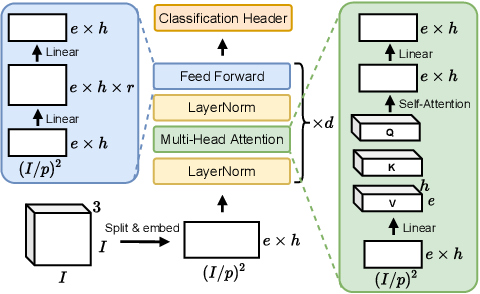
Figure 1 from An Investigation on Hardware-Aware Vision Transformer ...
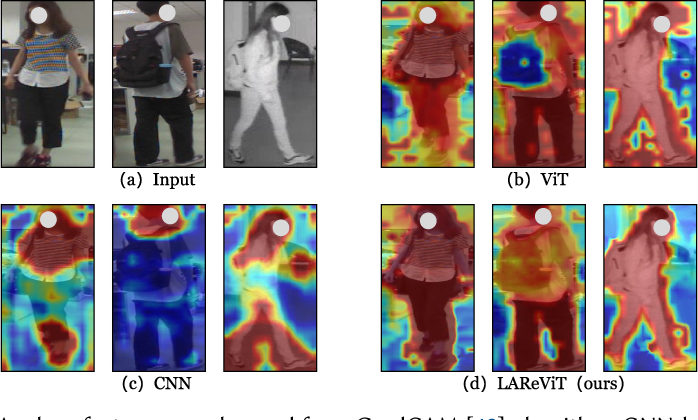
Figure 1 from Local-Aware Residual Attention Vision Transformer for ...

Figure 1 from Adaptive and Background-Aware Vision Transformer for Real ...
Advertisement Space (336x280)
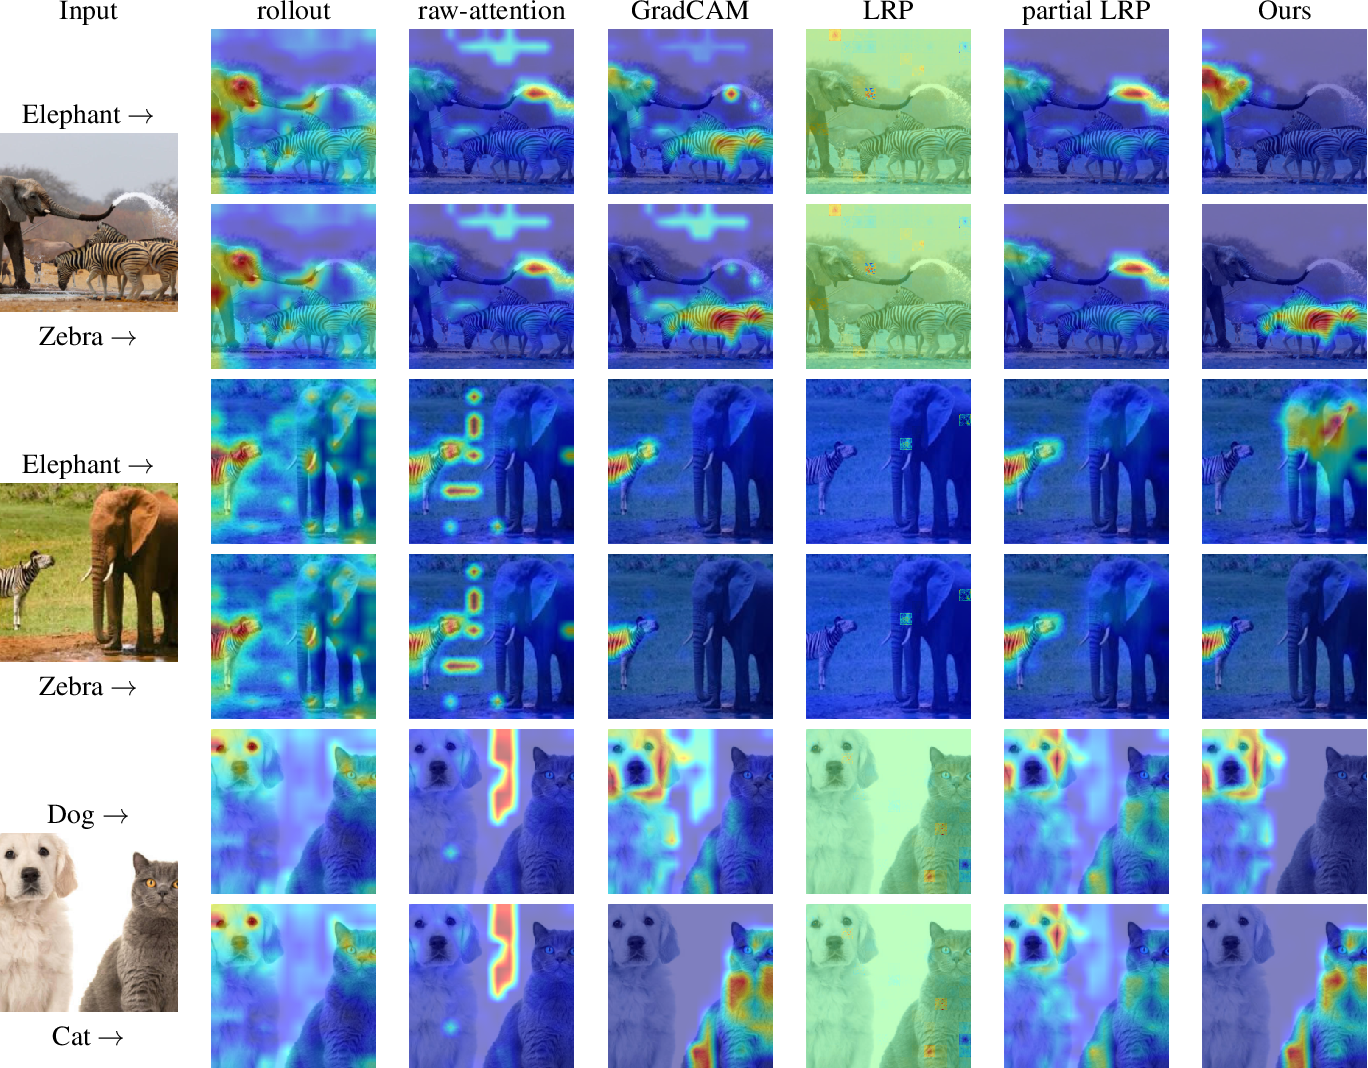
Figure 1 from Transformer Interpretability Beyond Attention ...

Figure 2 from Question Aware Vision Transformer for Multimodal ...
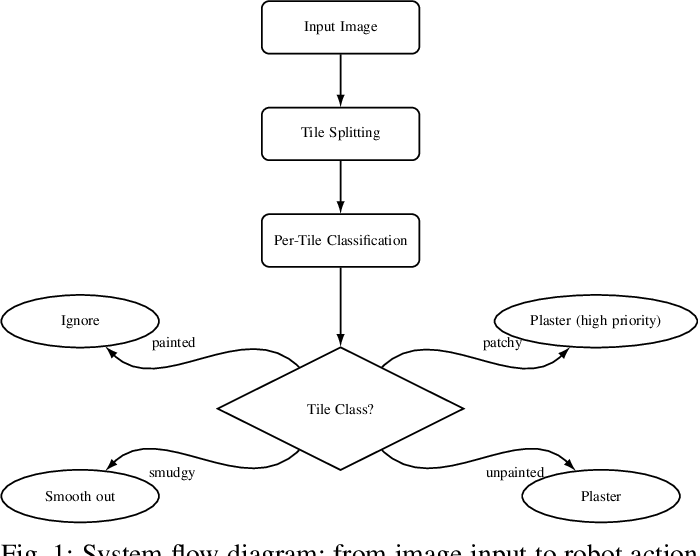
Figure 1 from Neighbor-Aware Vision Transformer for Plastering Location ...

Figure 1 from Semantic Segmentation using Vision Transformers: A survey ...
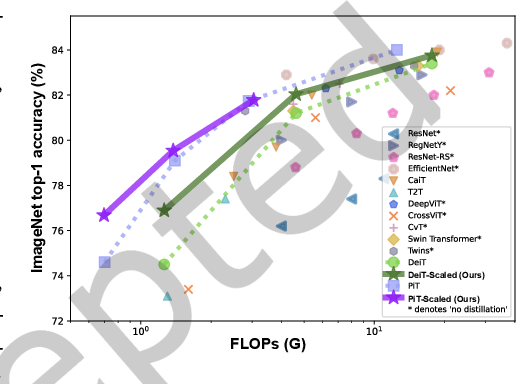
Figure 1 from An Investigation on Hardware-Aware Vision Transformer ...

Figure 1 from Slide-Transformer: Hierarchical Vision Transformer with ...
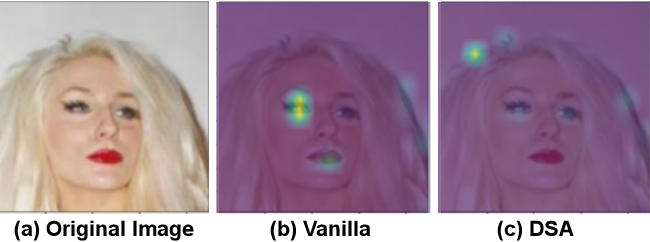
Figure 1 from Fairness-aware Vision Transformer via Debiased Self ...

Figure 1 from Building Vision Transformers with Hierarchy Aware Feature ...

Figure 1 from Vision And Text Transformer For Predicting Answerability ...

Figure 1 from History Aware Multimodal Transformer for Vision-and ...
Advertisement Space (336x280)

Figure 1 from Holistically Explainable Vision Transformers | Semantic ...

Figure 1 from Computationally-Efficient Vision Transformer for Medical ...

Figure 1 from History Aware Multimodal Transformer for Vision-and ...

Figure 2 from Vision Transformer Interpretability via Prediction of ...

Figure 1 from Semi-Supervised Convolutional Vision Transformer with Bi ...

Figure 1 from A Multimodal Automated Interpretability Agent | Semantic ...