
Figure 2 From Vision Transformer For Pansharpening Semantic Scholar
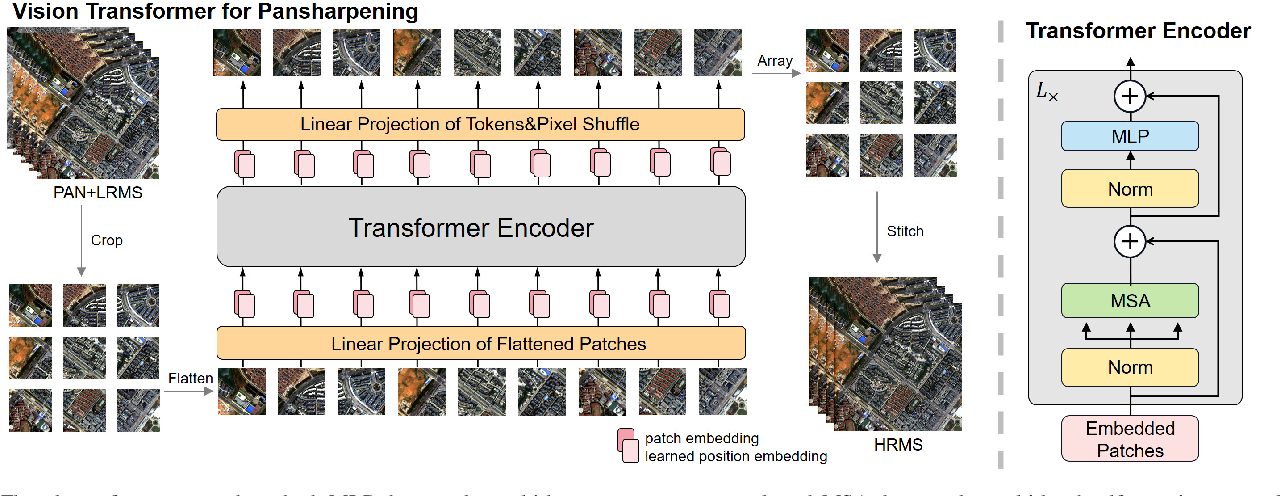
Figure 2 from Vision Transformer for Pansharpening | Semantic Scholar
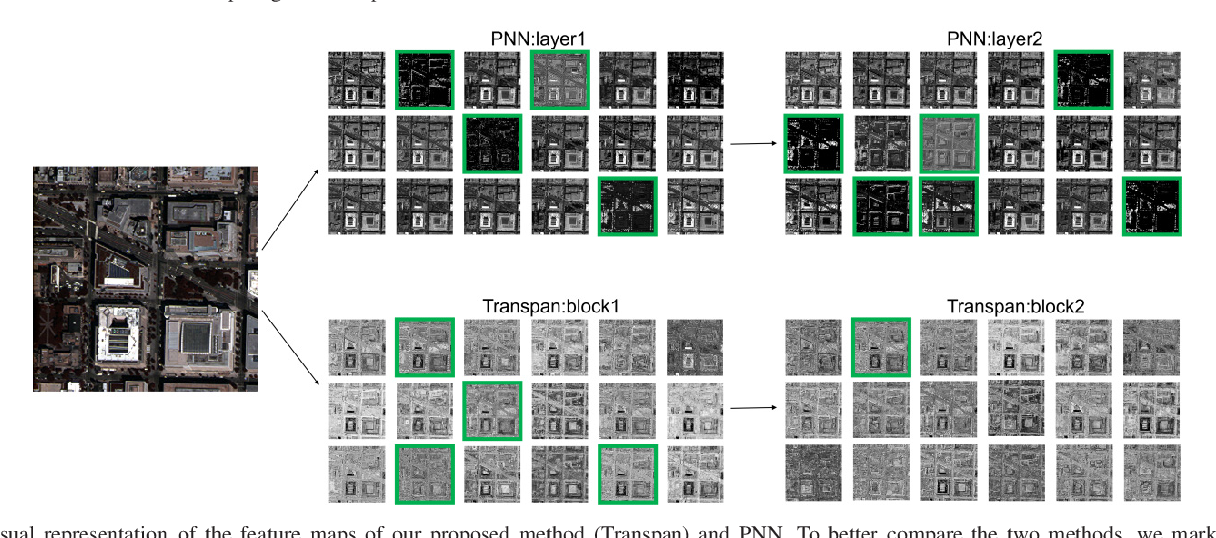
Figure 9 from Vision Transformer for Pansharpening | Semantic Scholar
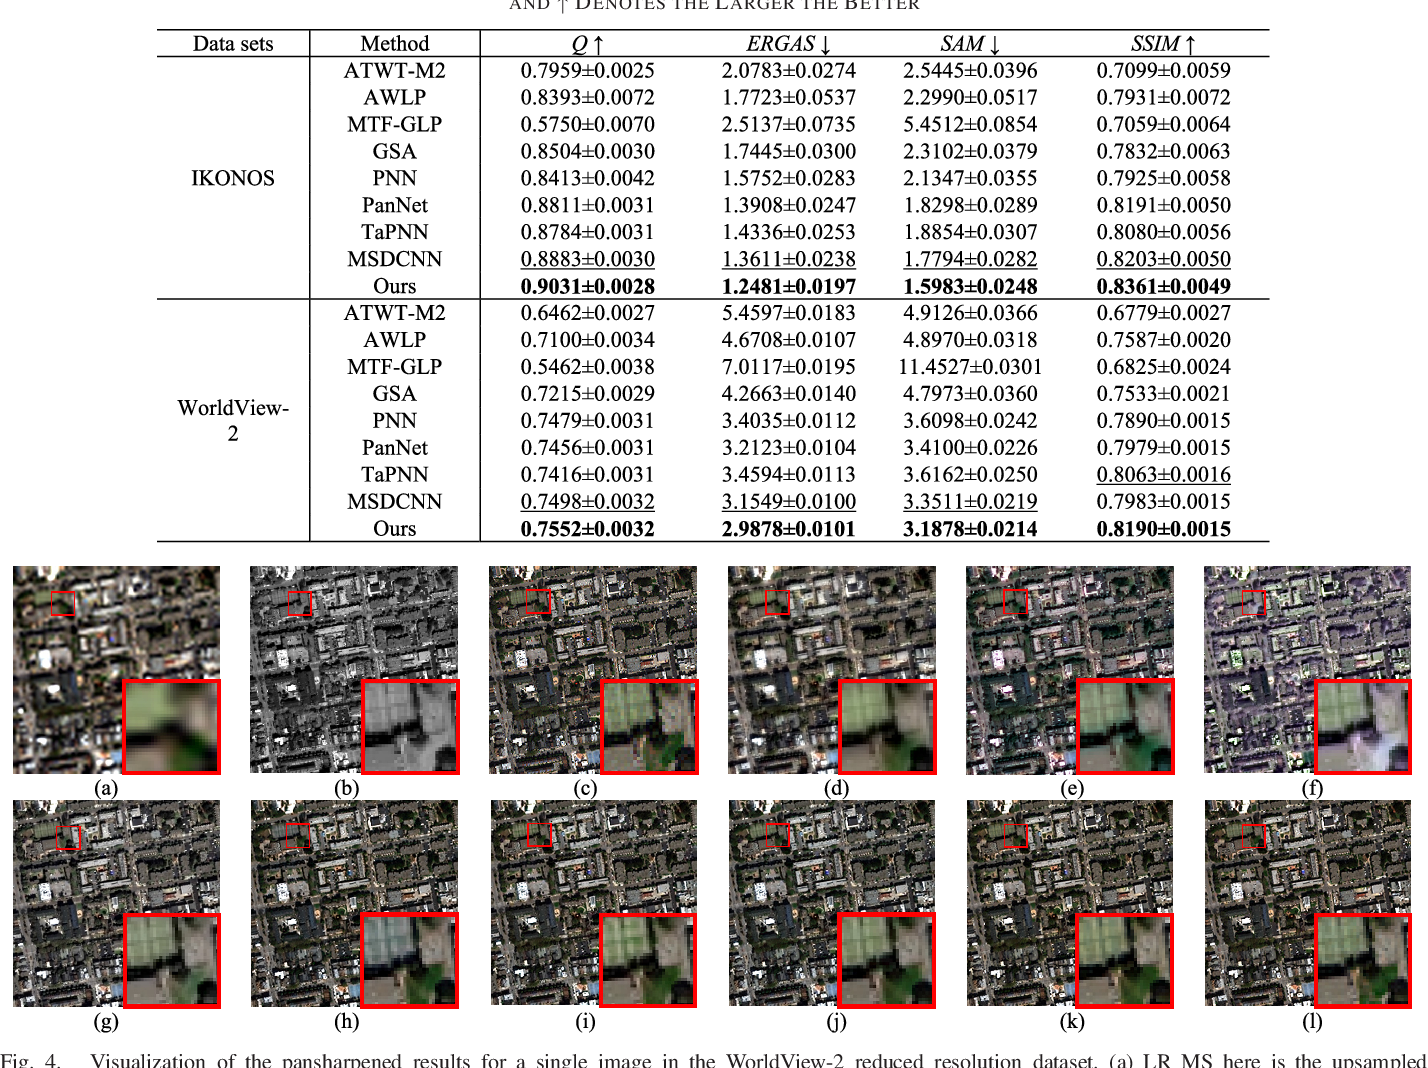
Figure 4 from Vision Transformer for Pansharpening | Semantic Scholar
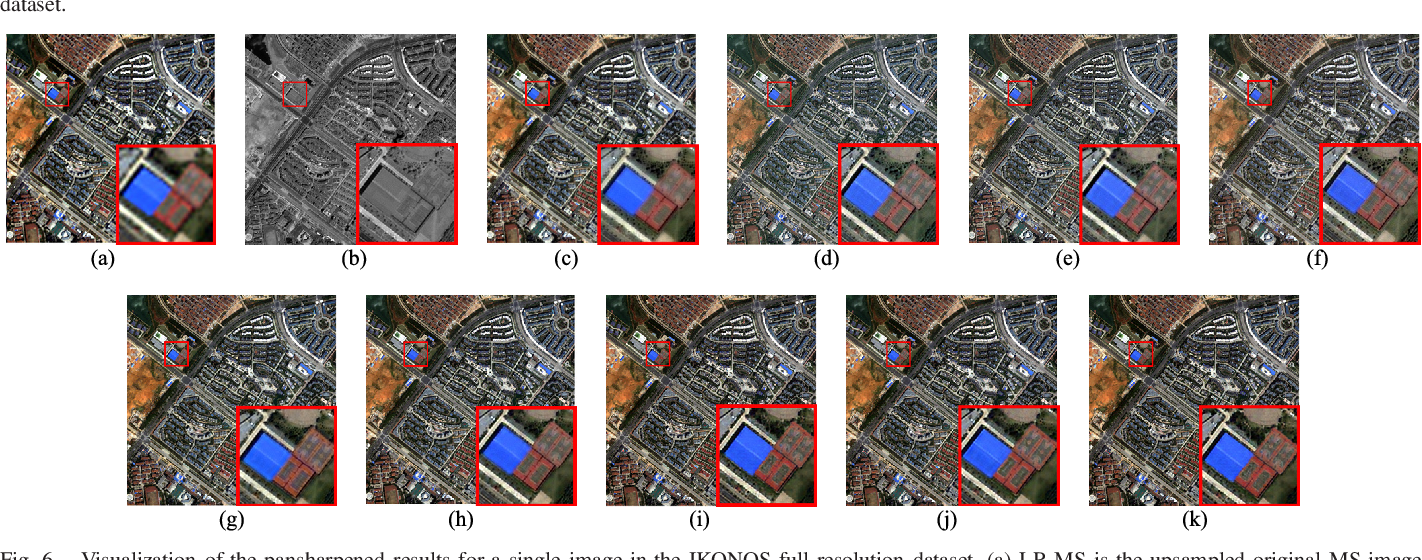
Figure 6 from Vision Transformer for Pansharpening | Semantic Scholar
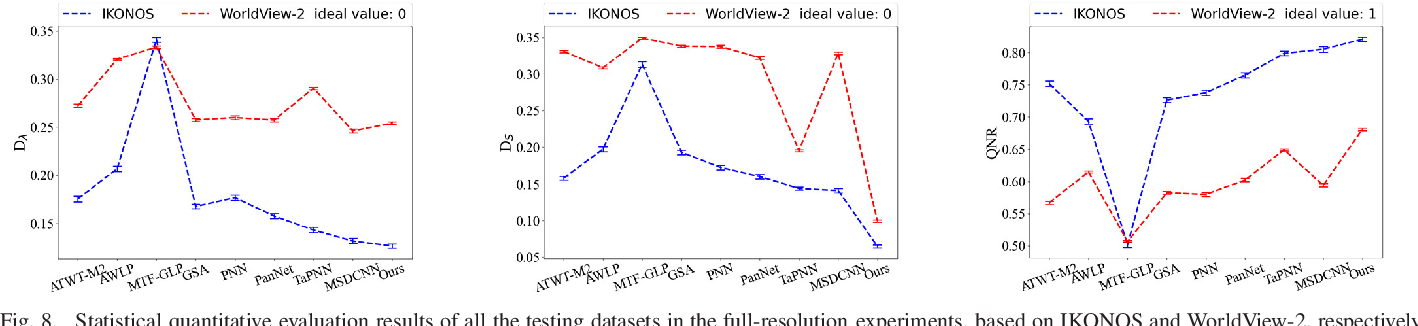
Figure 8 from Vision Transformer for Pansharpening | Semantic Scholar
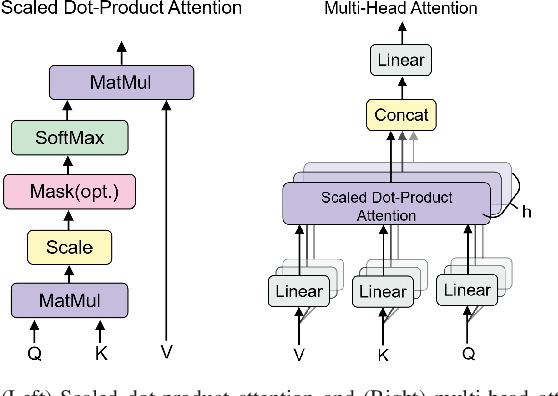
Figure 1 from Vision Transformer for Pansharpening | Semantic Scholar

Figure 2 from Exploring Vision Transformer Layer Choosing for Semantic ...
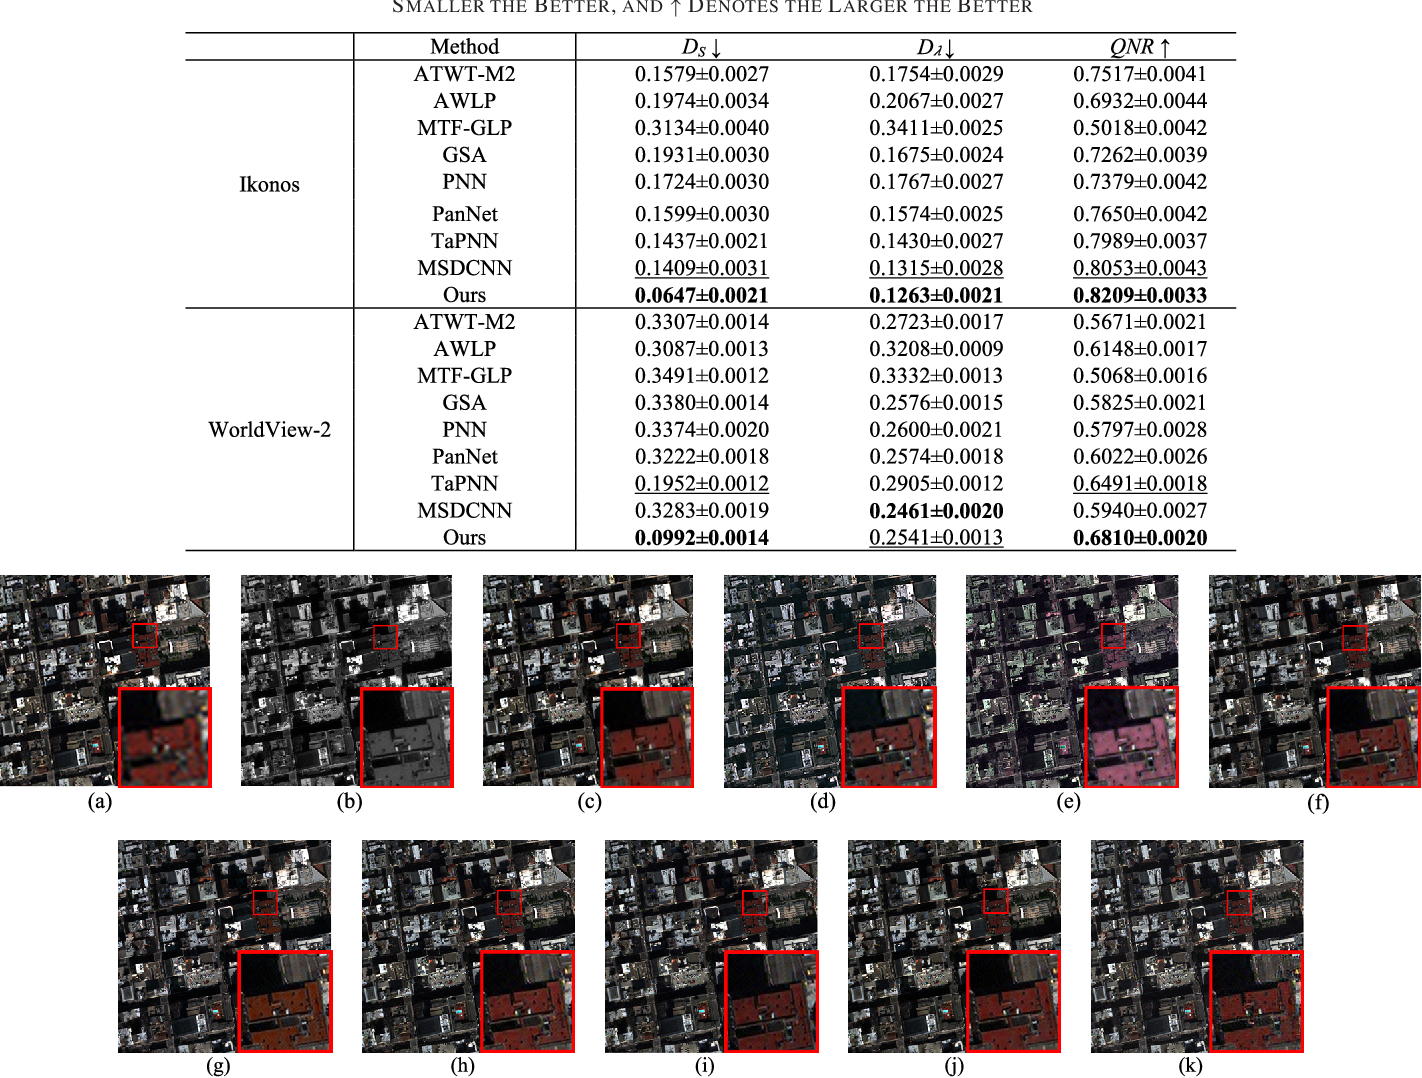
Table IV from Vision Transformer for Pansharpening | Semantic Scholar

Figure 2 from A Convolutional Vision Transformer for Semantic ...

Figure 2 from Dual Vision Transformer | Semantic Scholar
Advertisement Space (300x250)

Figure 2 from Multi-Scale Convolutional Vision Transformer for Semantic ...
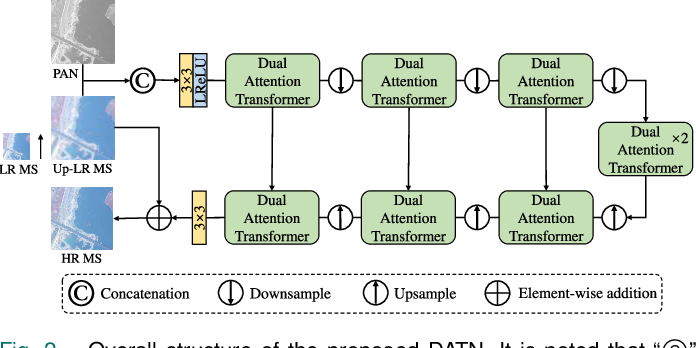
Figure 2 from A Dual-Attention Transformer Network for Pansharpening ...
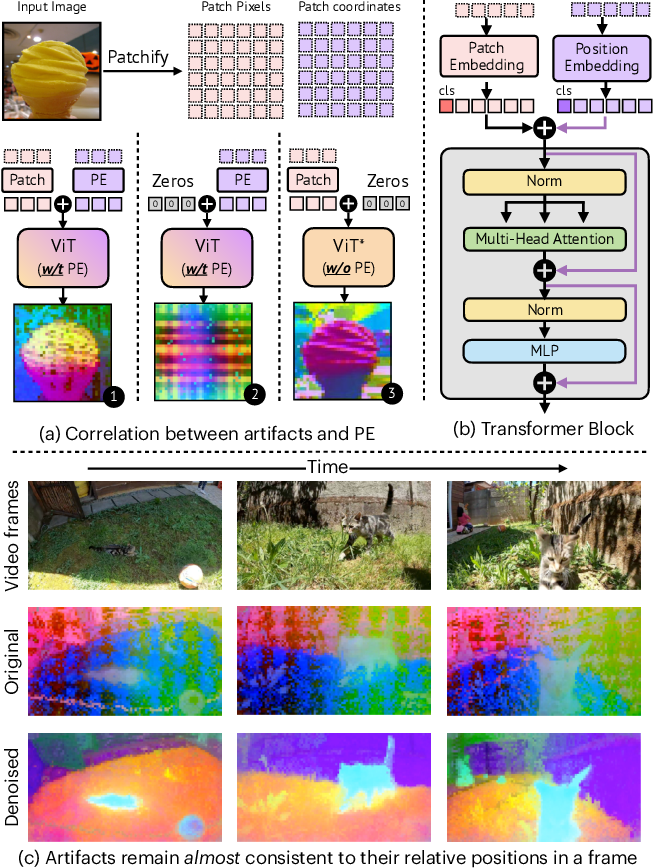
Figure 2 from Denoising Vision Transformers | Semantic Scholar

Figure 1 from Dual Vision Transformer | Semantic Scholar
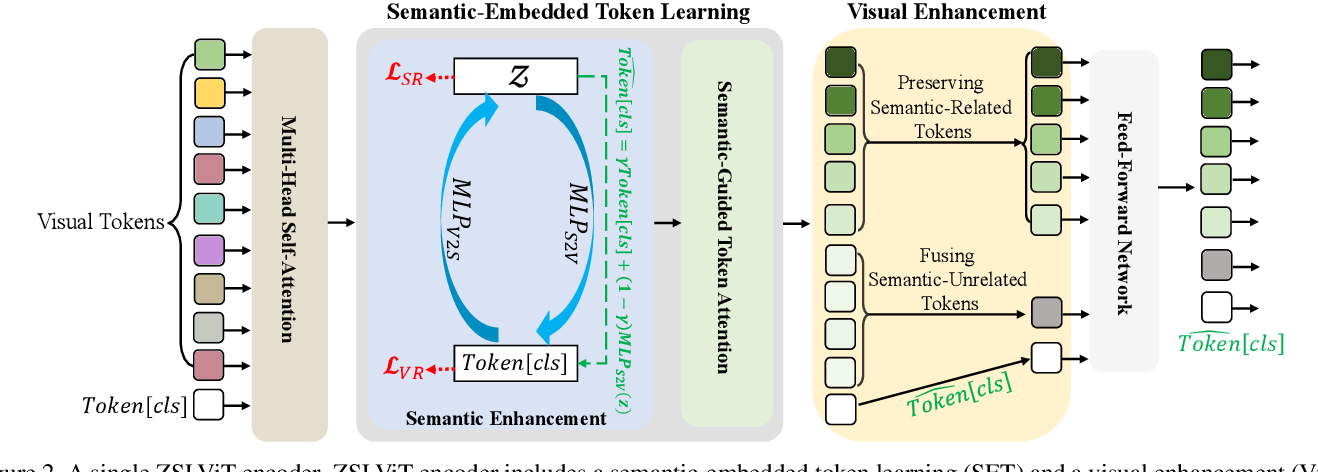
Figure 2 from Progressive Semantic-Guided Vision Transformer for Zero ...
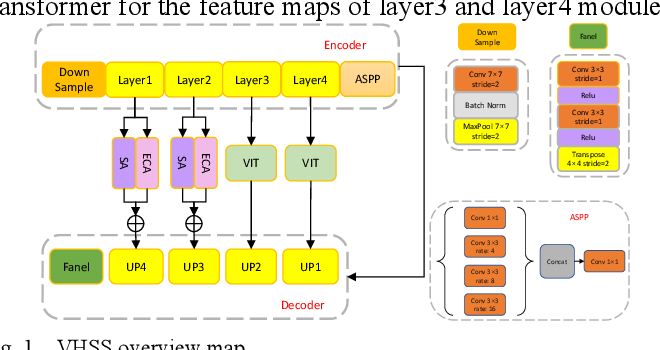
Figure 1 from Vision Transformer is Required for Hyperspectral Semantic ...

Figure 2 from Expediting Large-Scale Vision Transformer for Dense ...
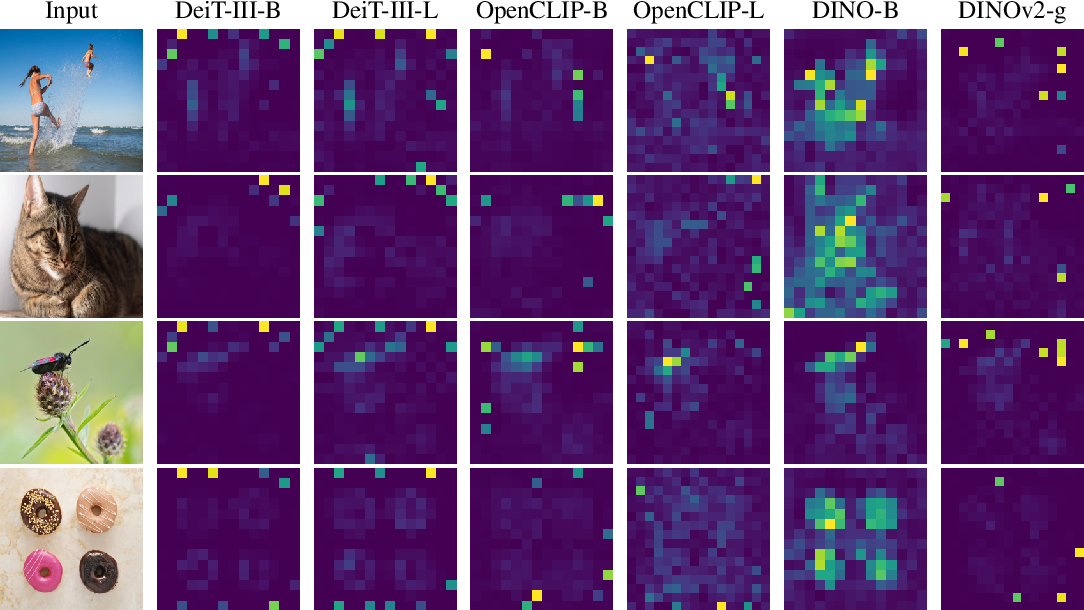
Figure 2 from Vision Transformers Need Registers | Semantic Scholar

Figure 3 from A Convolutional Vision Transformer for Semantic ...
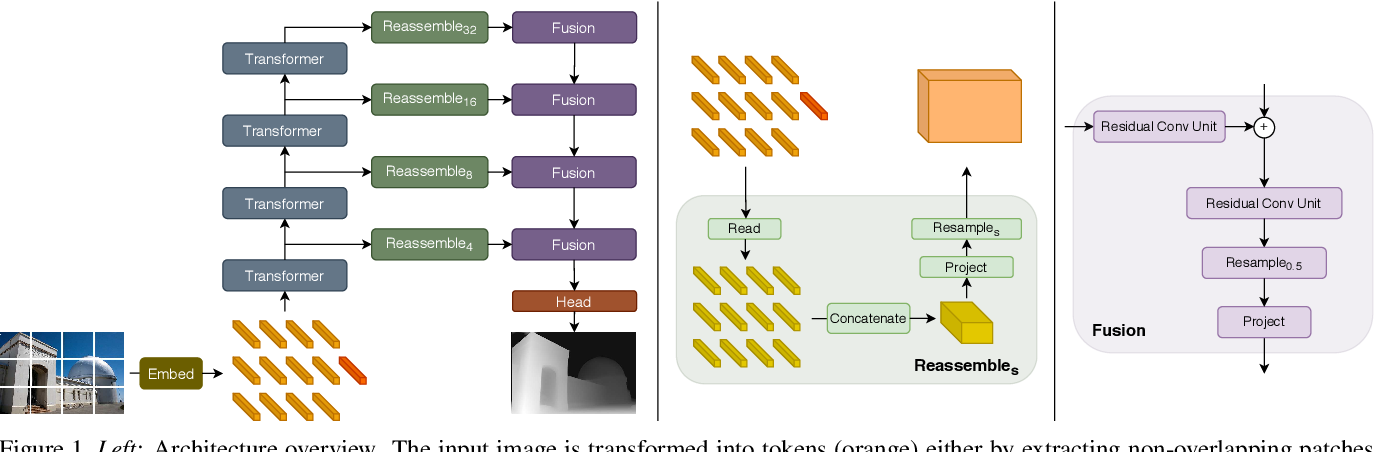
Figure 1 from Vision Transformers for Dense Prediction | Semantic Scholar
Advertisement Space (336x280)
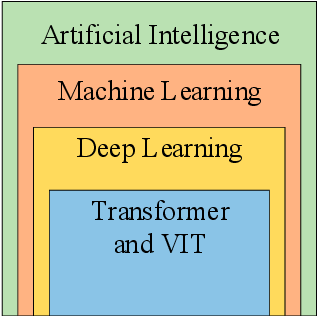
Figure 2 from Deep Learning and Vision Transformer for Medical Image ...

Figure 1 from Exploring Vision Transformer Layer Choosing for Semantic ...

Figure 2 from Convolution-Embedded Vision Transformer With Elastic ...
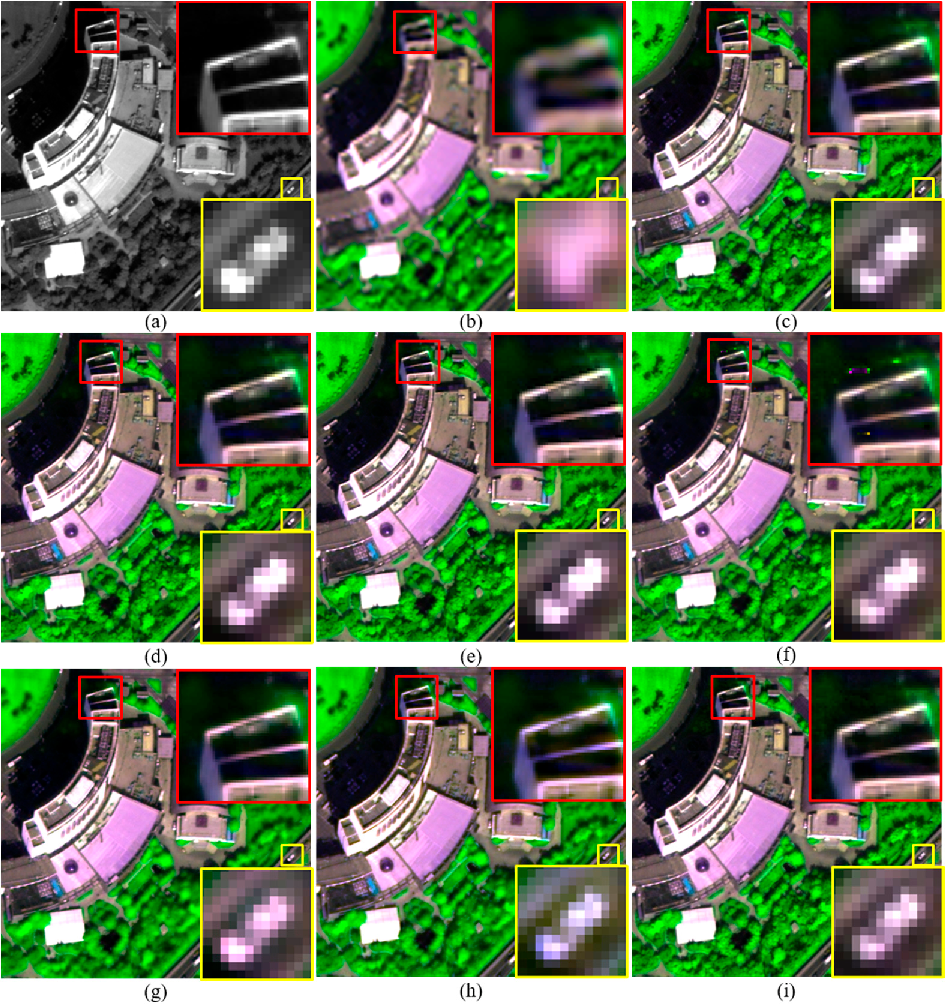
Figure 2 from An Improved Pansharpening Method for Misaligned ...

Figure 1 from Vision Transformer with Progressive Sampling | Semantic ...

Figure 2 from Mutiscale Hybrid Attention Transformer for Remote Sensing ...

Figure 2 from How to Train Vision Transformer on Small-scale Datasets ...
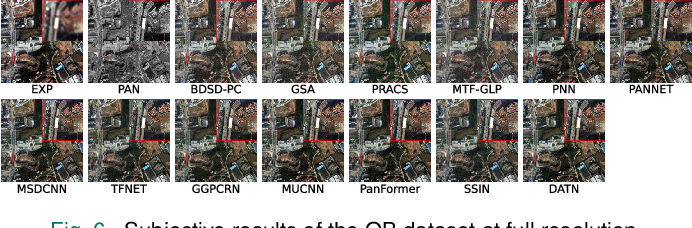
Figure 6 from A Dual-Attention Transformer Network for Pansharpening ...

Figure 2 from Vision-Language Transformer for Interpretable Pathology ...
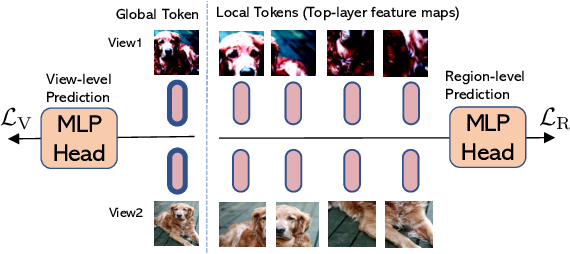
Figure 2 from Efficient Self-supervised Vision Transformers for ...
Advertisement Space (336x280)

Figure 5 from A Dual-Attention Transformer Network for Pansharpening ...

Figure 2 from An Overview of Vision Transformers for Image Processing ...
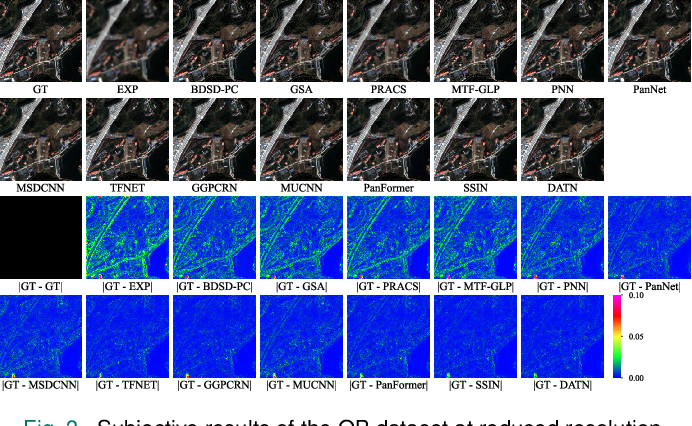
Figure 3 from A Dual-Attention Transformer Network for Pansharpening ...
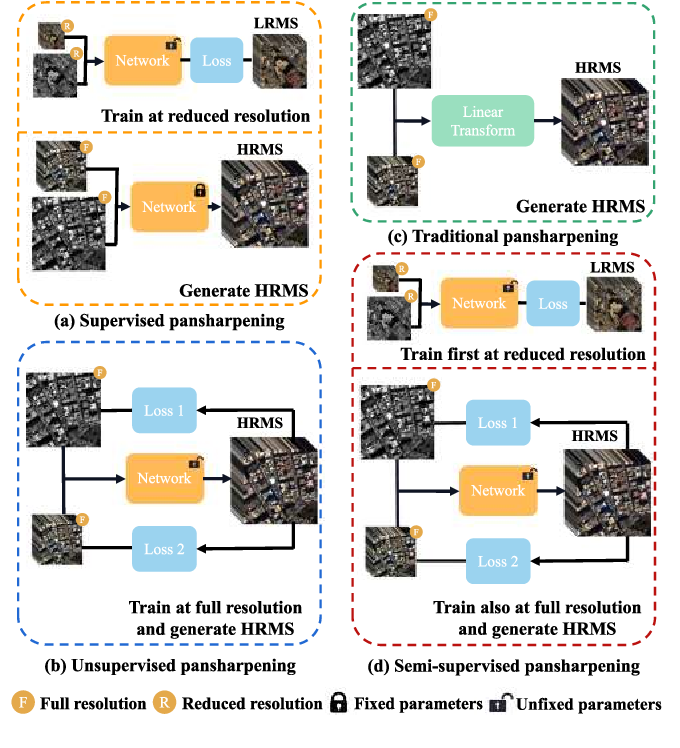
Figure 2 from Zero-shot semi-supervised learning for pansharpening ...
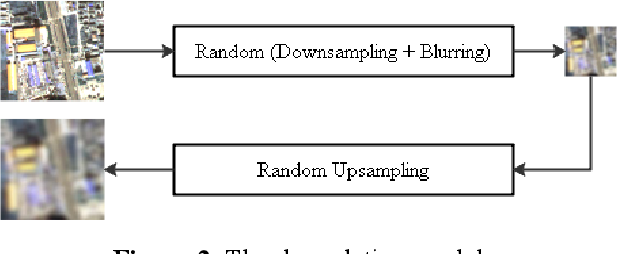
Figure 2 from Learning Image Downscaling for Pansharpening Using an ...
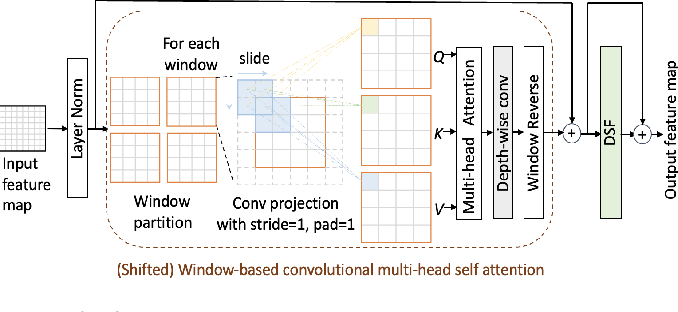
Figure 2 from Optimizing Vision Transformers for Medical Image ...