
Figure 1 From Jova Unified Multimodal Learning For Joint Video Audio
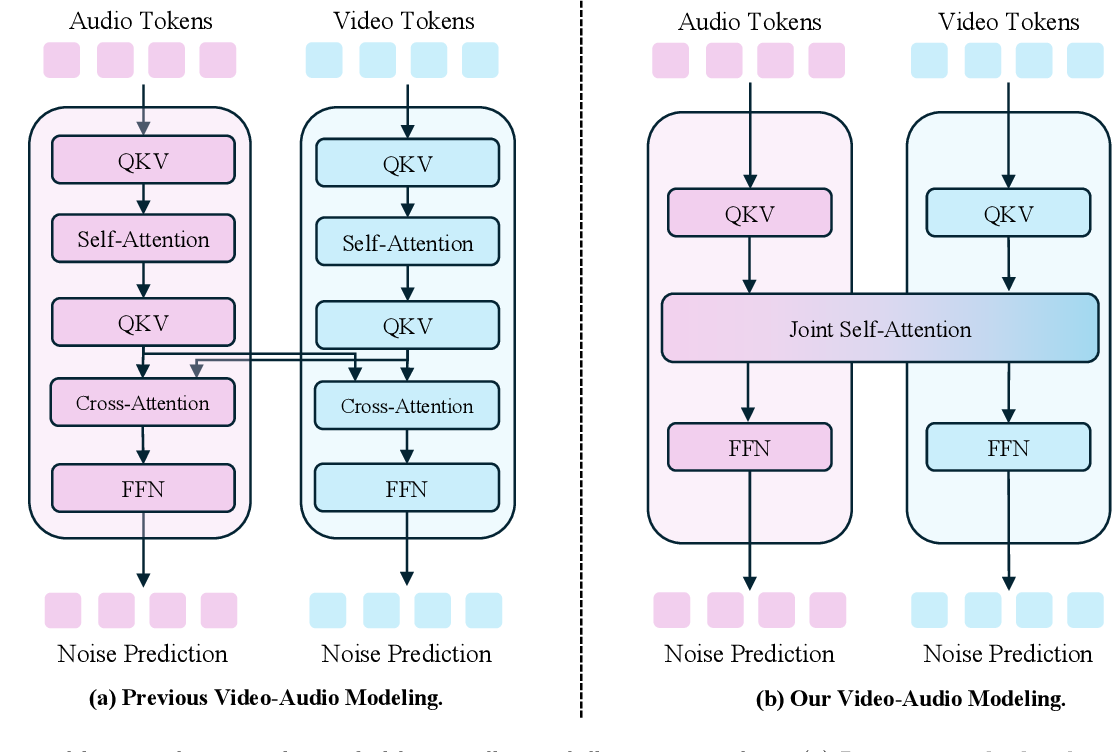
Figure 1 from JoVA: Unified Multimodal Learning for Joint Video-Audio ...

[論文レビュー] JoVA: Unified Multimodal Learning for Joint Video-Audio Generation

JoVA: Unified Multimodal Learning for Joint Video-Audio Generation | AI ...

Paper page - JoVA: Unified Multimodal Learning for Joint Video-Audio ...
JoVA: Unified Multimodal Learning for Joint Video-Audio Generation - 智源社区论文

Figure 1 from Unsupervised Joint Learning of Optical Flow and Intensity ...

JoVA: Unified Multimodal Learning for Joint Video-Audio Generation

Learning Joint Embedding with Multimodal Cues for Cross-Modal Video ...

Figure 1 from JTMA: Joint Multimodal Feature Fusion and Temporal Multi ...

Table 1 from AudioGen-Omni: A Unified Multimodal Diffusion Transformer ...
Advertisement Space (300x250)

Figure 2 from Fine-grained Audio-Visual Joint Representations for ...
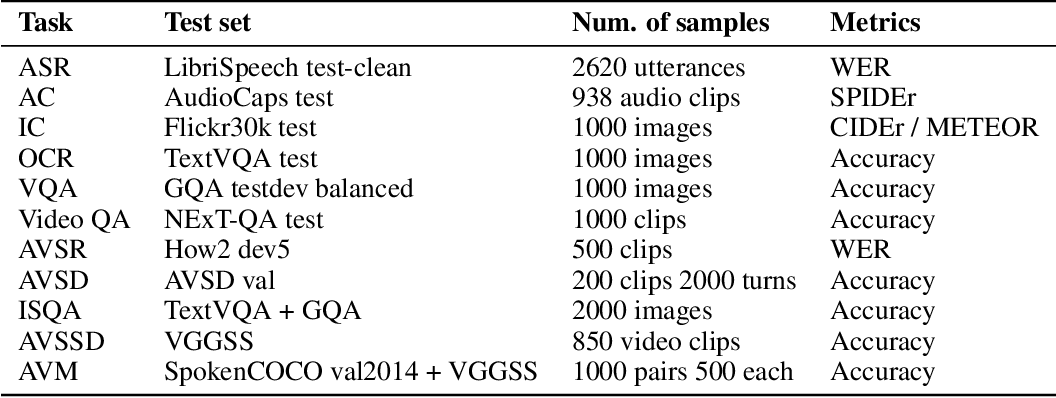
Table 1 from Fine-grained Audio-Visual Joint Representations for ...

Figure 3 from JTMA: Joint Multimodal Feature Fusion and Temporal Multi ...

Taming Multimodal Joint Training for High-Quality Video-to-Audio ...
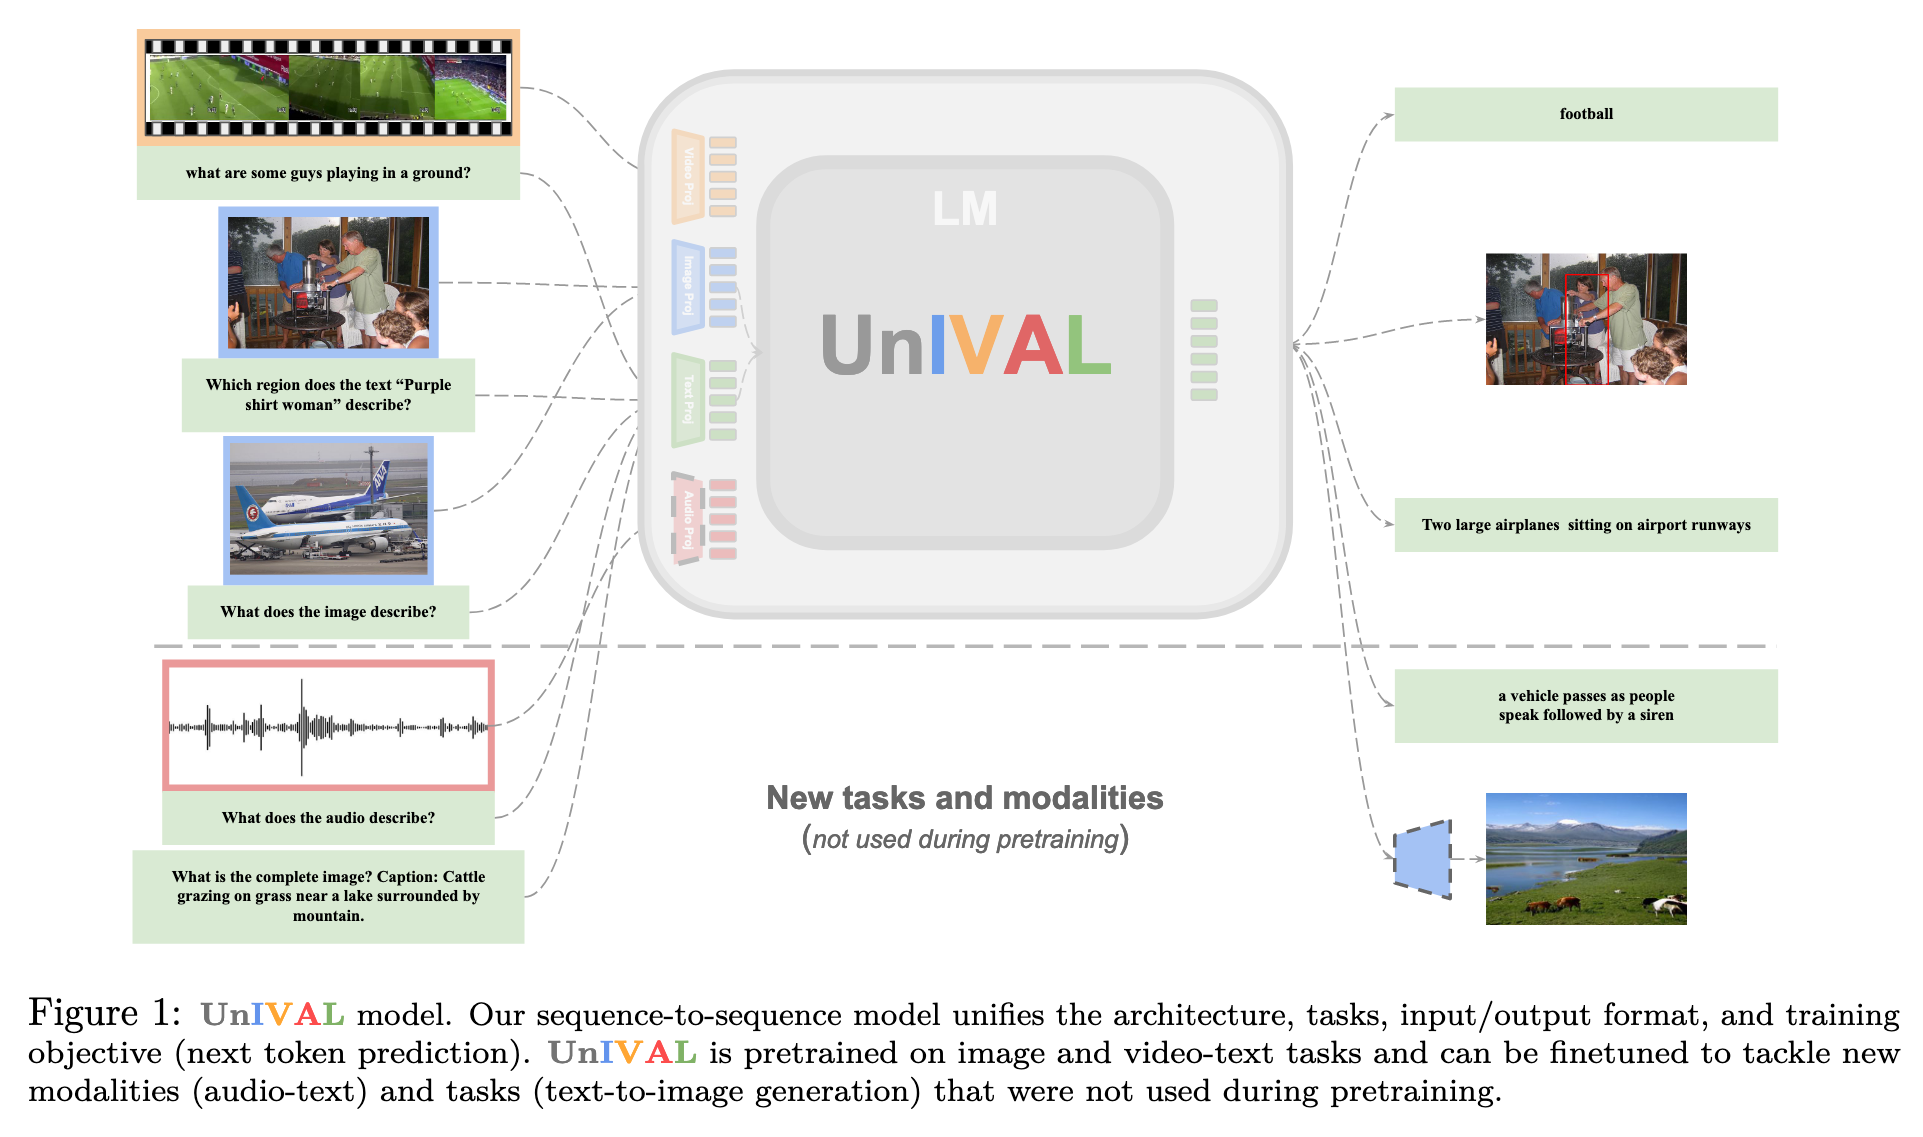
Unified Model for Image, Video, Audio and Language Tasks | Qiang Zhang

Taming Multimodal Joint Training for High-Quality Video-to-Audio ...

Paper page - UnityVideo: Unified Multi-Modal Multi-Task Learning for ...

[Literature Review] Joint Speaker Features Learning for Audio-visual ...

Jointist: Joint Learning for Multi-instrument Transcription and Its ...

Figure 1 from An Empirical Analysis of Audio-Visual Teaching and ...
Advertisement Space (336x280)

Paper page - Taming Multimodal Joint Training for High-Quality Video-to ...

Figure 2 from Joyful: Joint Modality Fusion and Graph Contrastive ...
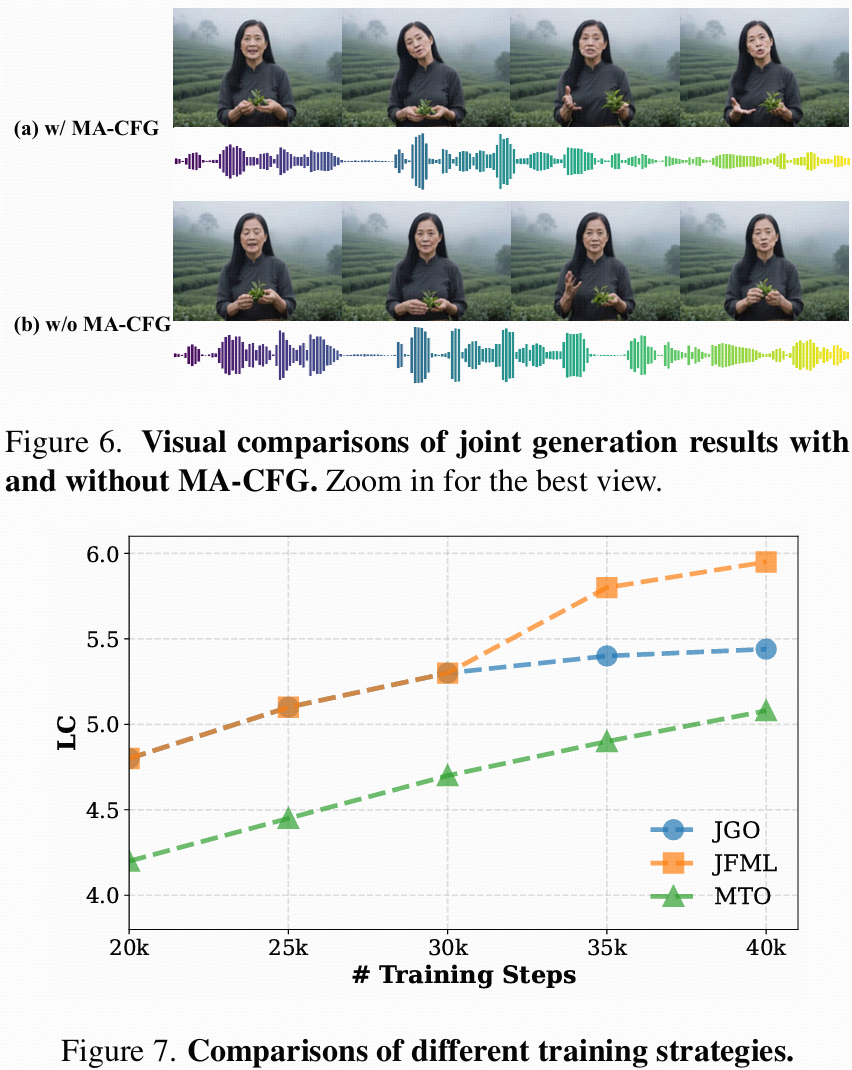
【论文阅读】UniAVGen: Unified Audio and Video Generation with Asymmetric ...
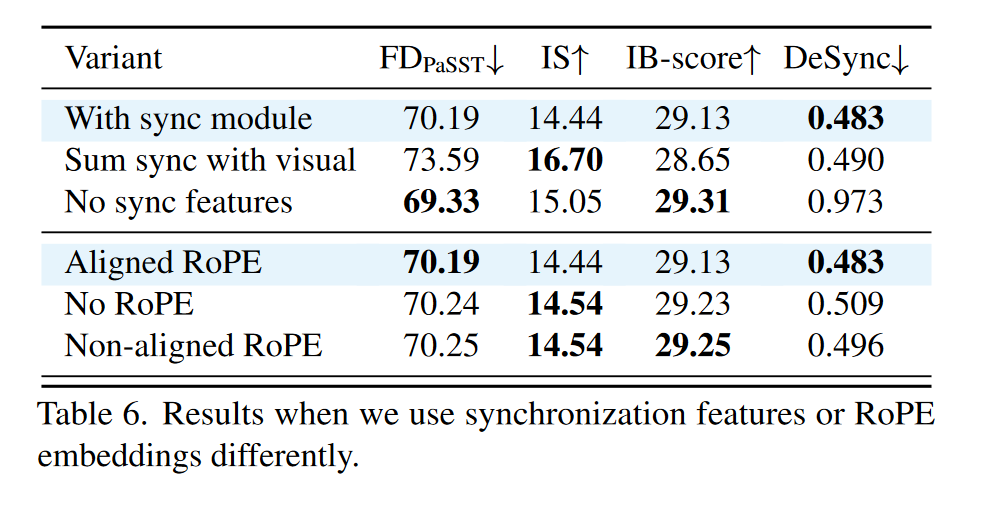
MMAudio: Taming Multimodal Joint Training for High-Quality Video-to ...

Coordinated Joint Multimodal Embeddings for Generalized Audio-Visual ...

Joyful: Joint Modality Fusion and Graph Contrastive Learning for ...

The past and future of multimodal learning from an audio-visual ...

The past and future of multimodal learning from an audio-visual ...
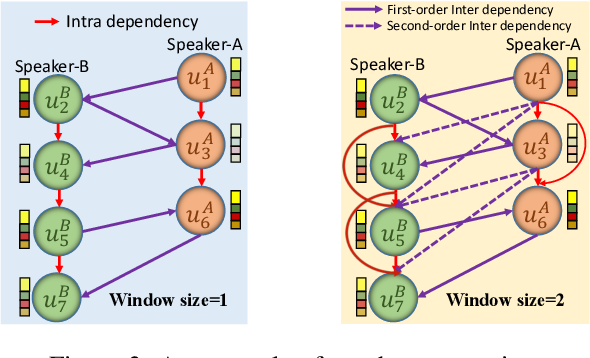
Figure 3 from Joyful: Joint Modality Fusion and Graph Contrastive ...

UnityVideo: Unified Multi-Modal Multi-Task Learning for Enhancing World ...
Advertisement Space (336x280)
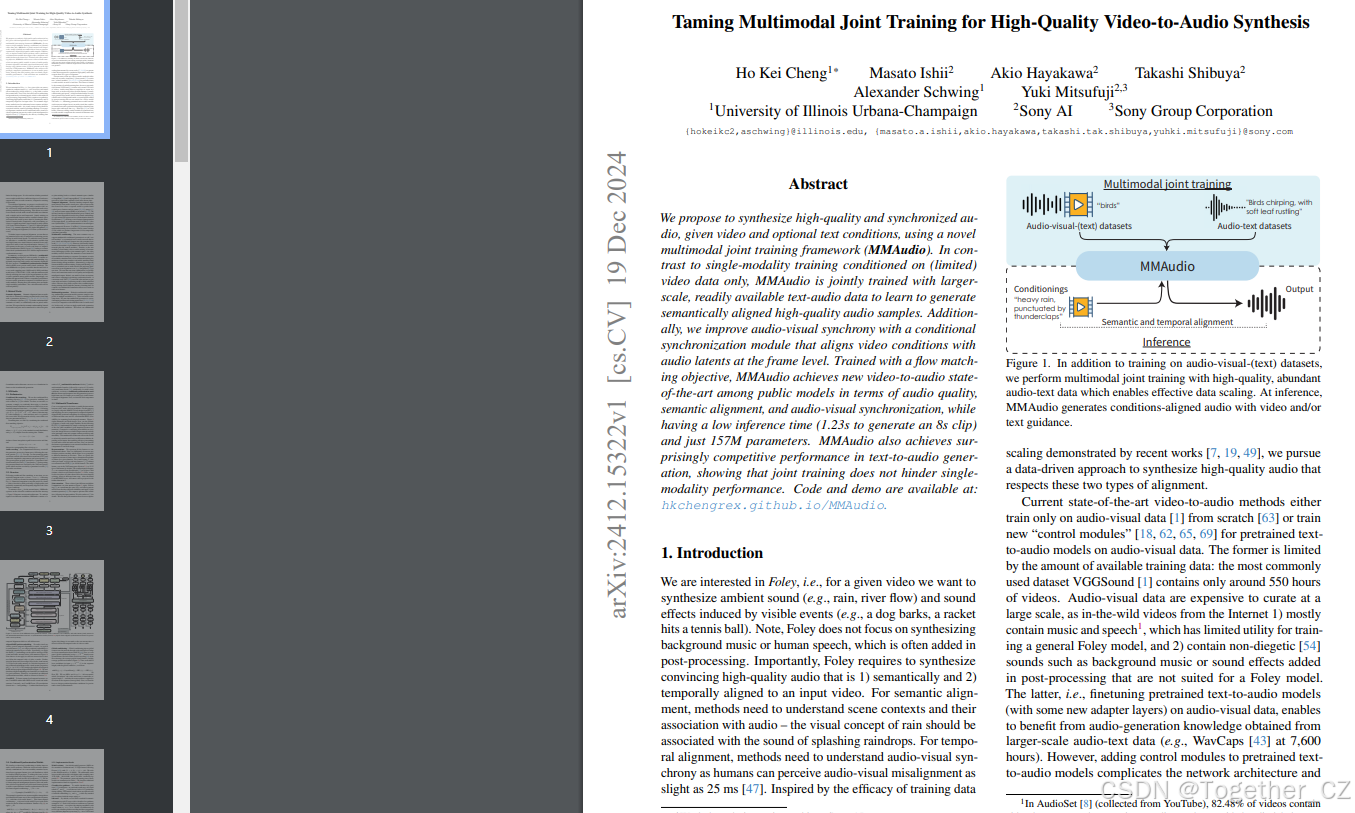
Taming Multimodal Joint Training for High-Quality Video-to-Audio ...
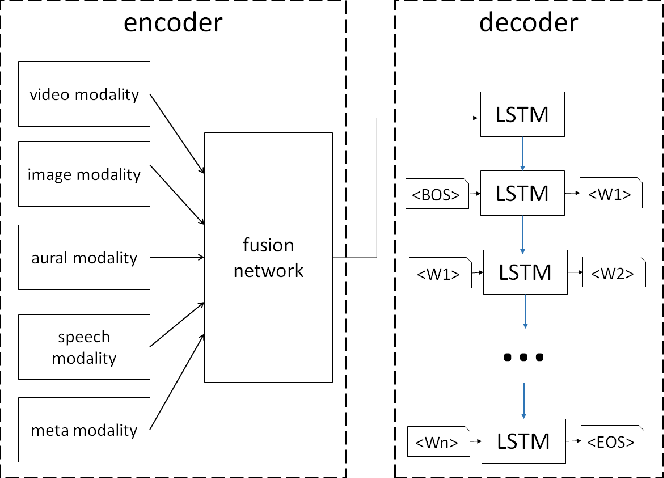
Figure 1 from Describing Videos using Multi-modal Fusion | Semantic Scholar
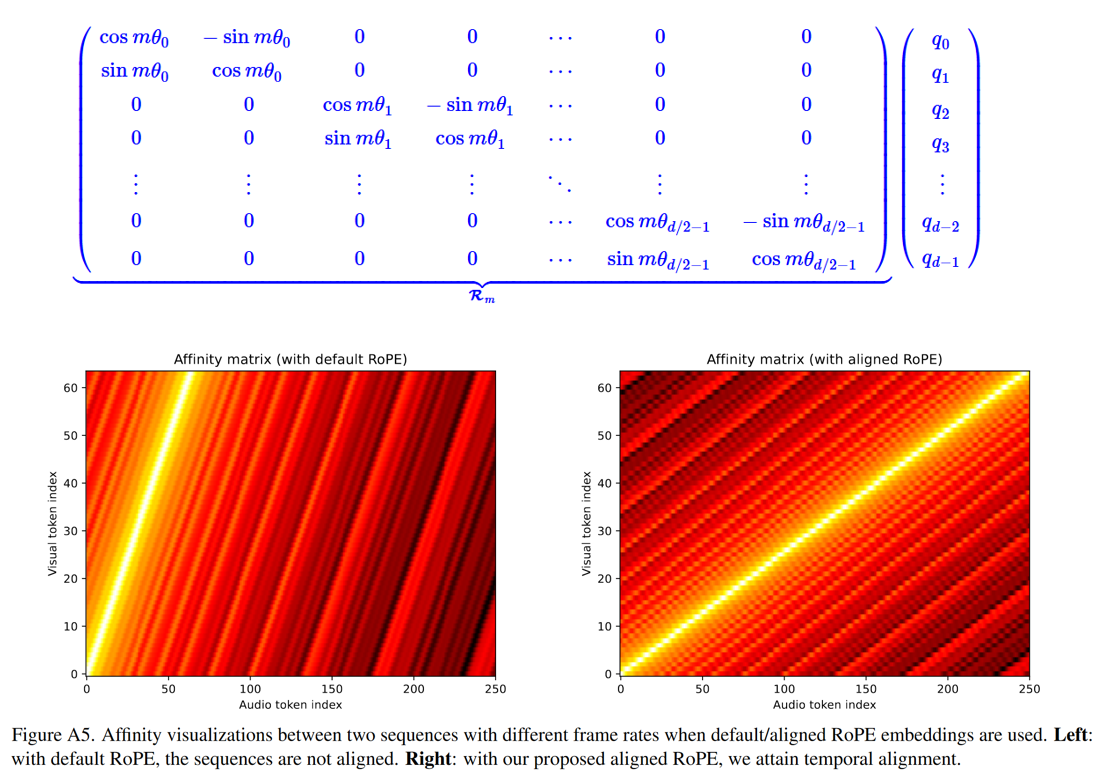
MMAudio: Taming Multimodal Joint Training for High-Quality Video-to ...
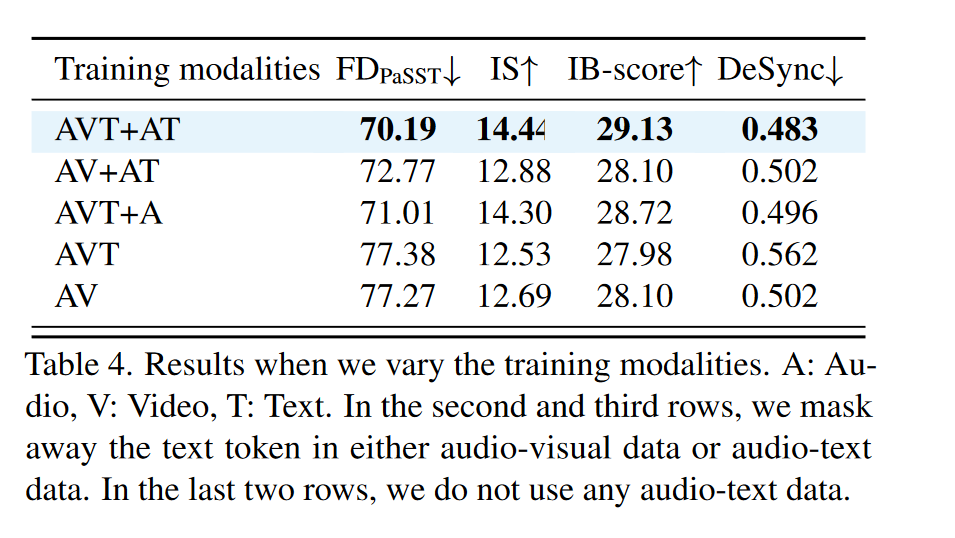
MMAudio: Taming Multimodal Joint Training for High-Quality Video-to ...
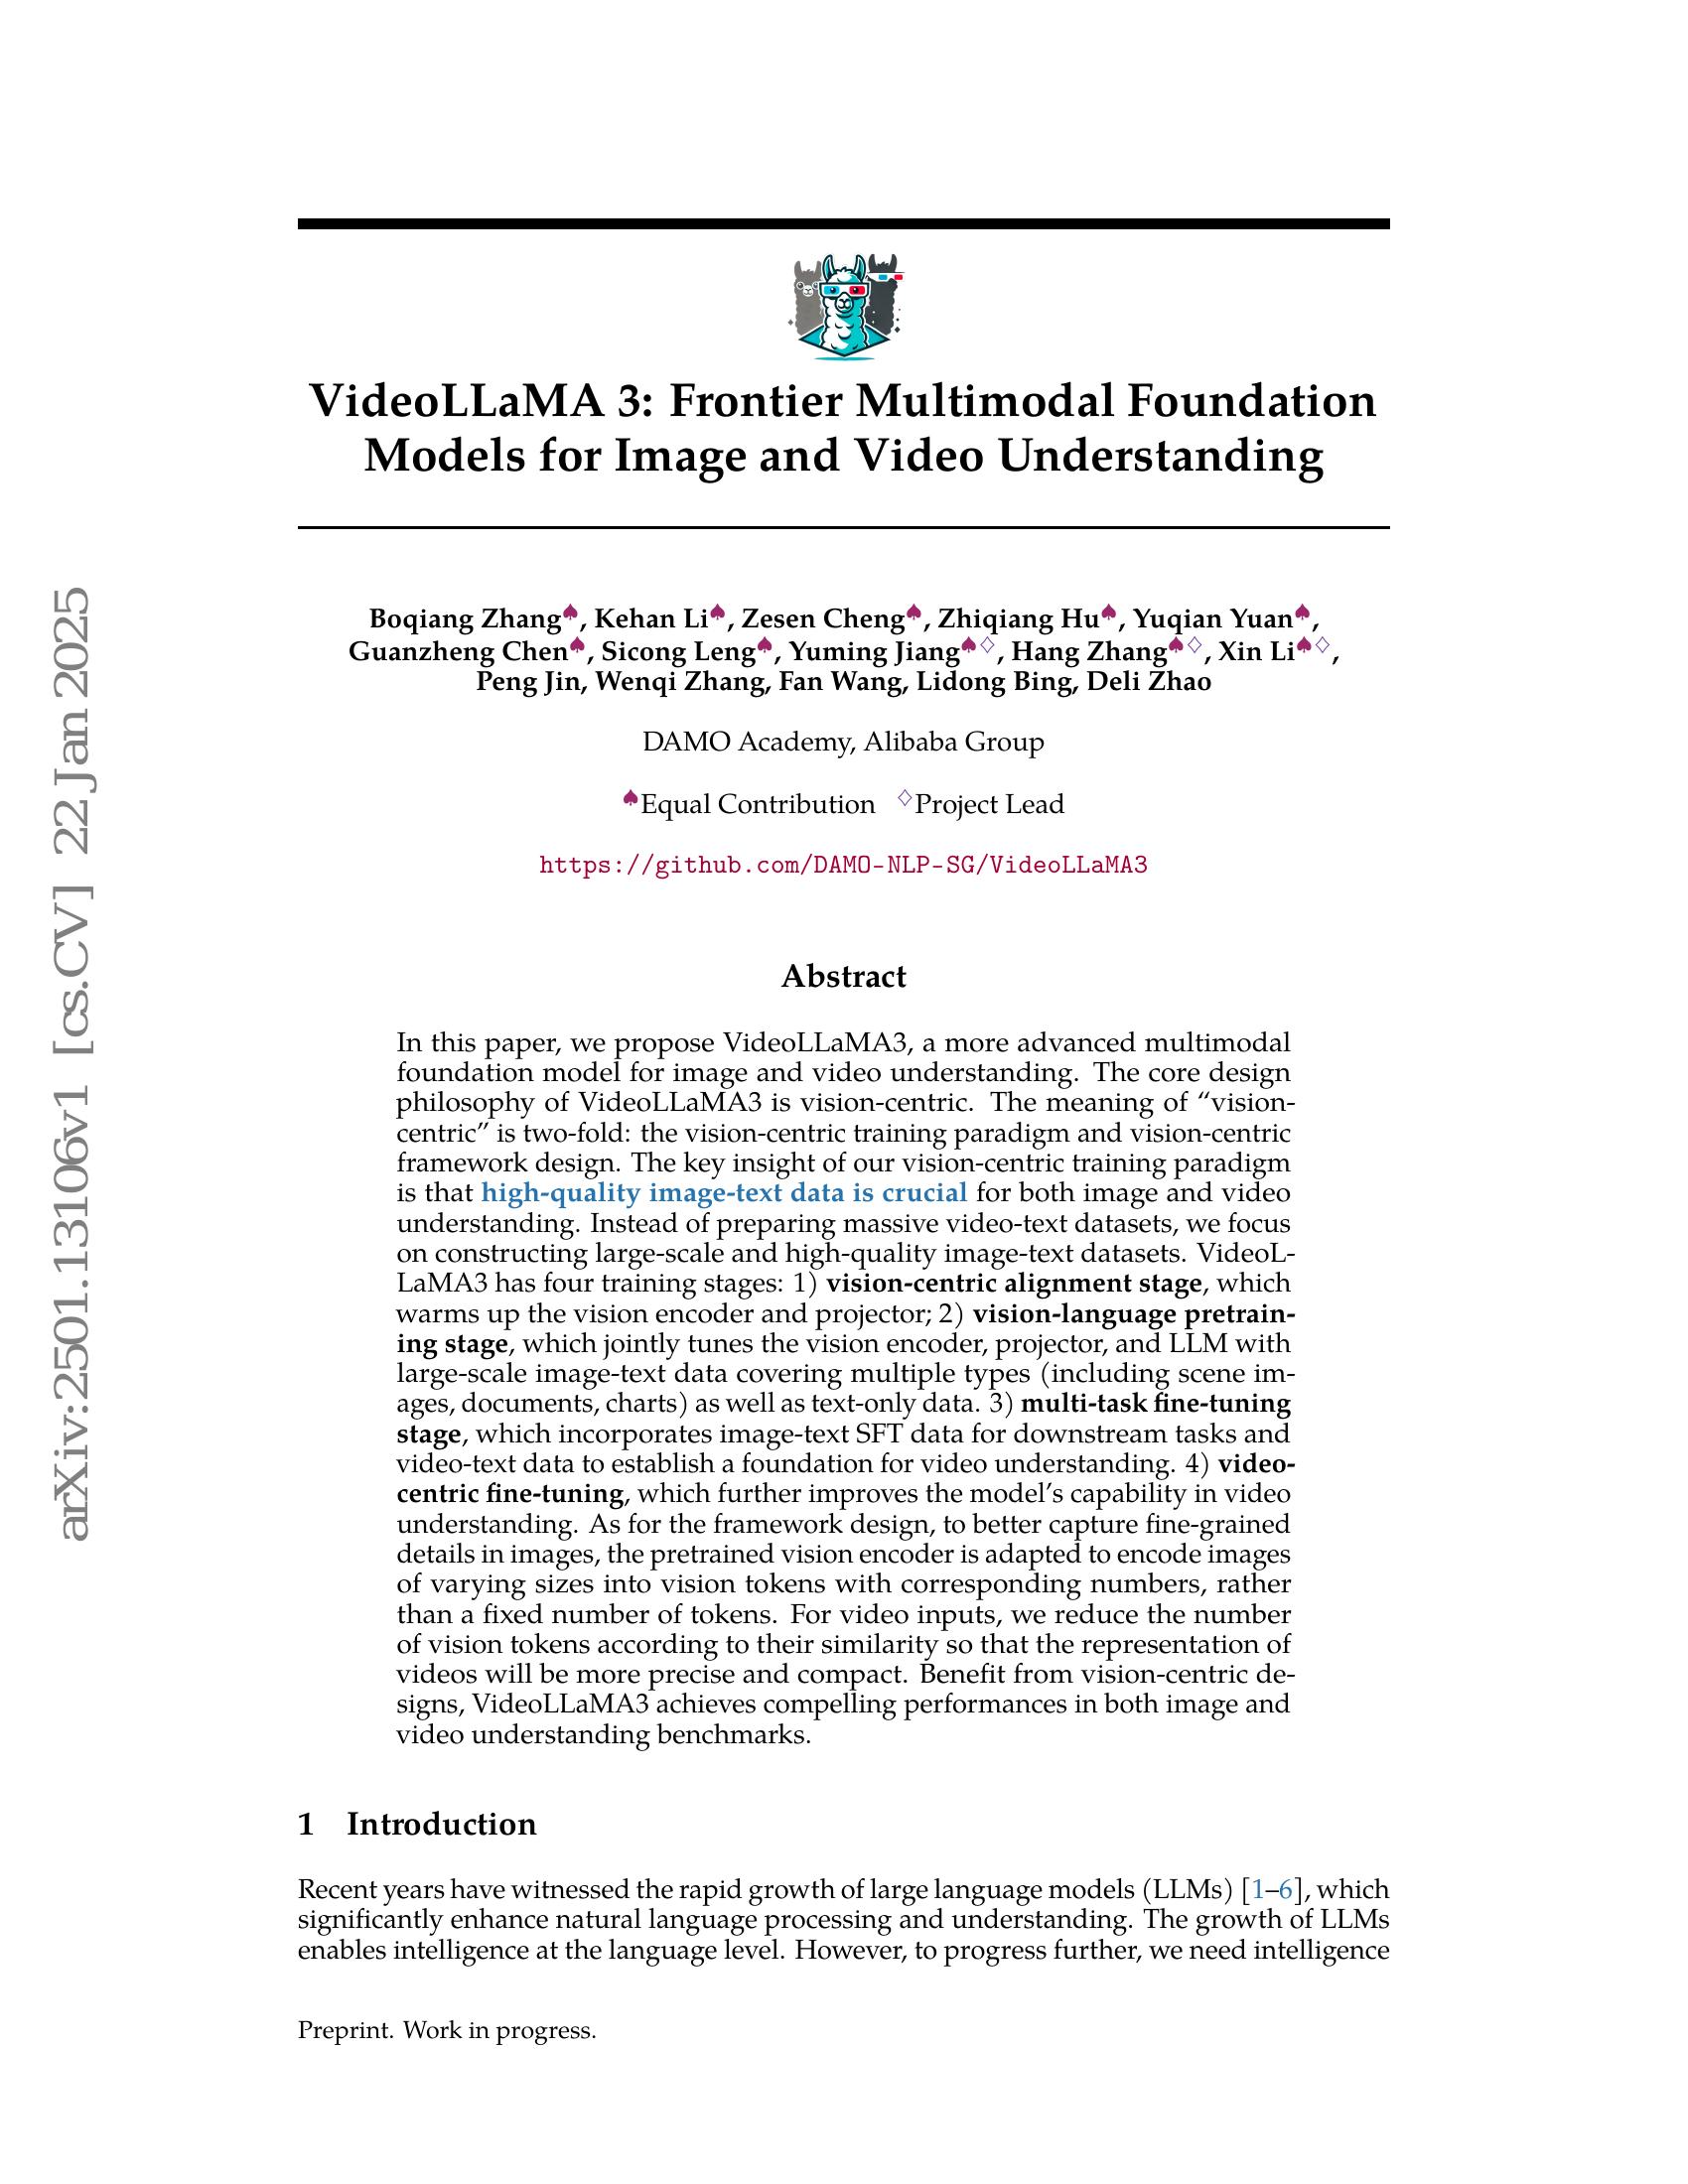
VideoLLaMA 3: Frontier Multimodal Foundation Models for Image and Video ...

[논문 리뷰] Joint Learning using Mixture-of-Expert-Based Representation for ...