
Figure 1 From Language Based Audio Retrieval Task In Dcase 2022

Figure 1 from Language-Based Audio Retrieval Task in DCASE 2022 ...

Table 1 from Language-Based Audio Retrieval Task in DCASE 2022 ...
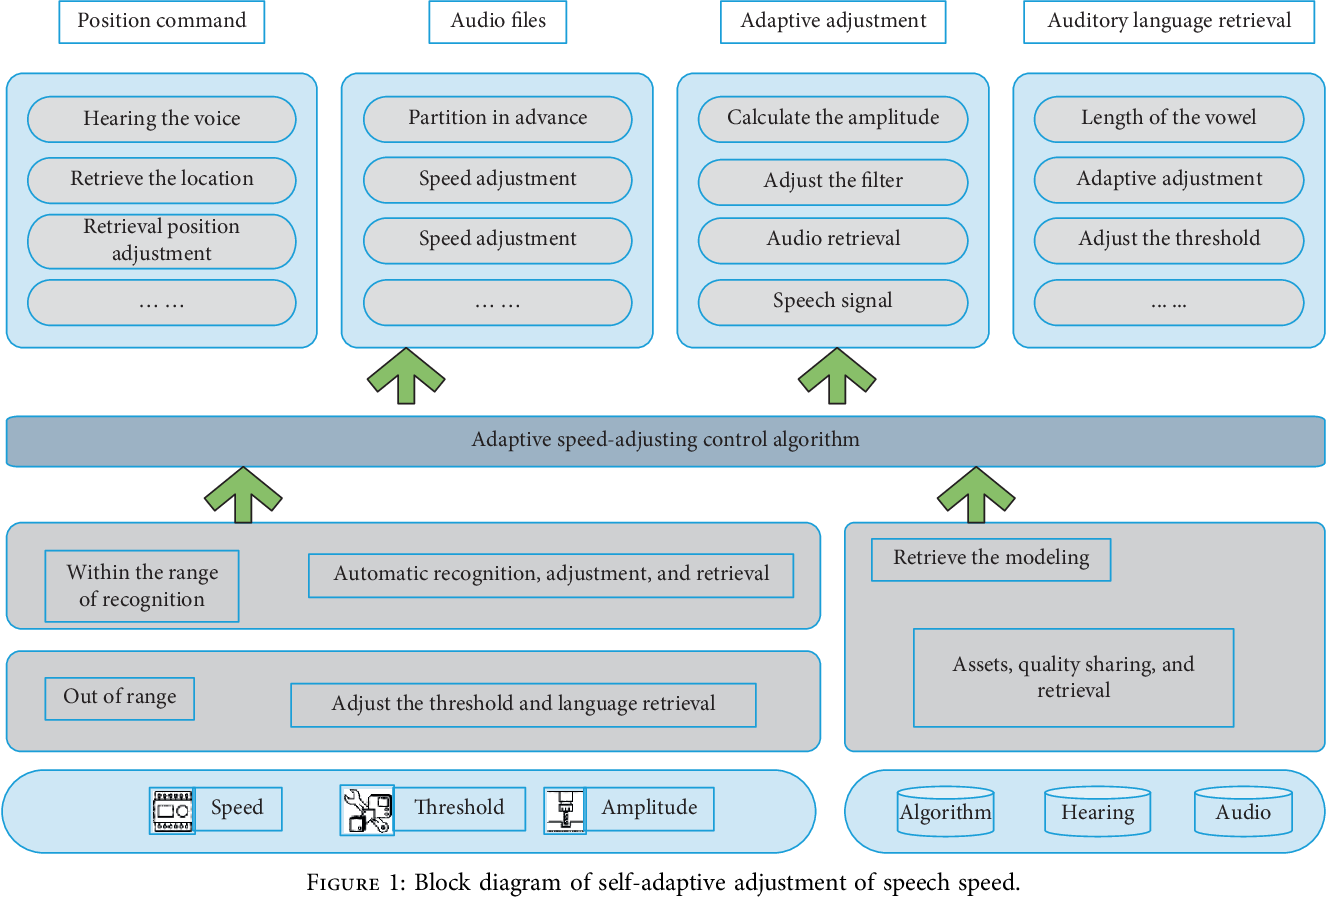
Figure 1 from English Audio Language Retrieval Based on Adaptive Speech ...

Table 2 from Language-Based Audio Retrieval Task in DCASE 2022 ...

(PDF) Language-based Audio Retrieval Task in DCASE 2022 Challenge
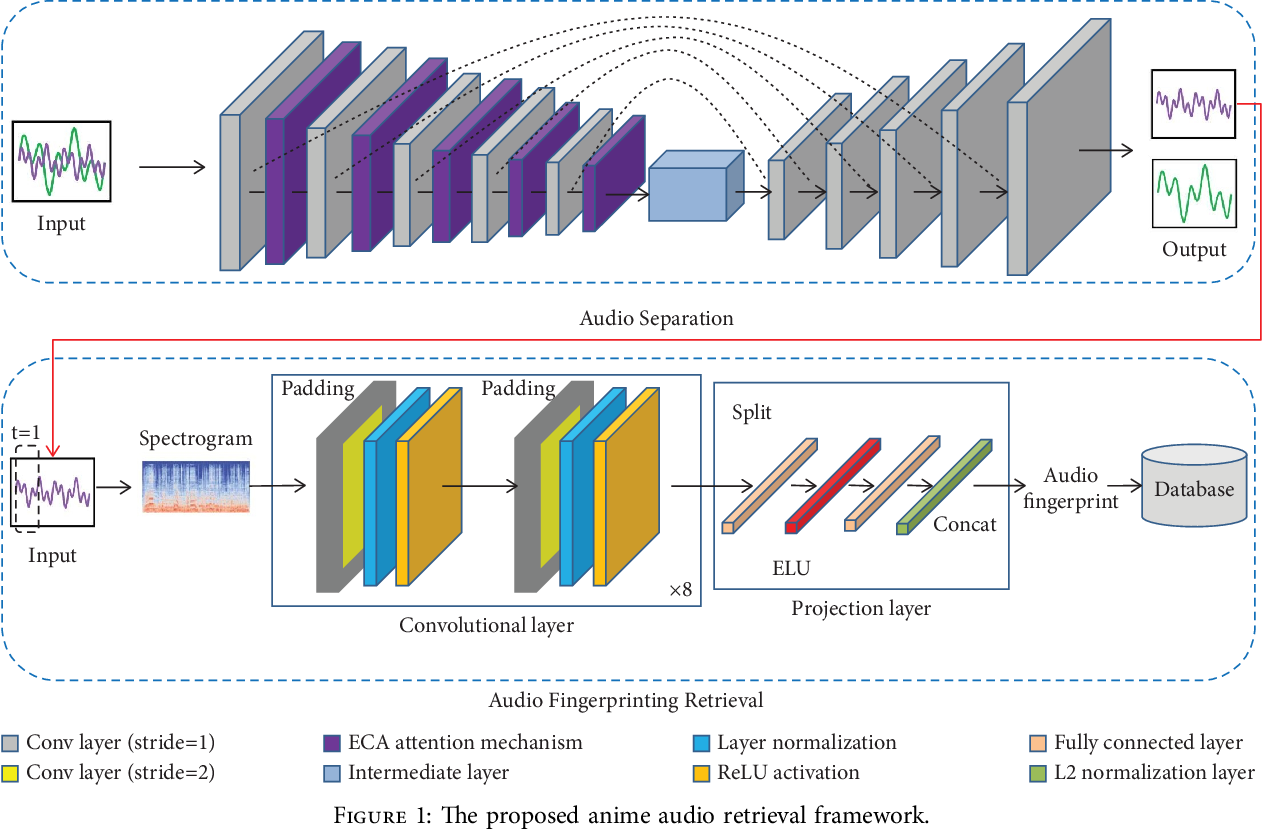
Figure 1 from Anime Audio Retrieval Based on Audio Separation and ...

Figure 1 from THE DCASE 2021 CHALLENGE TASK 6 SYSTEM: AUTOMATED AUDIO ...
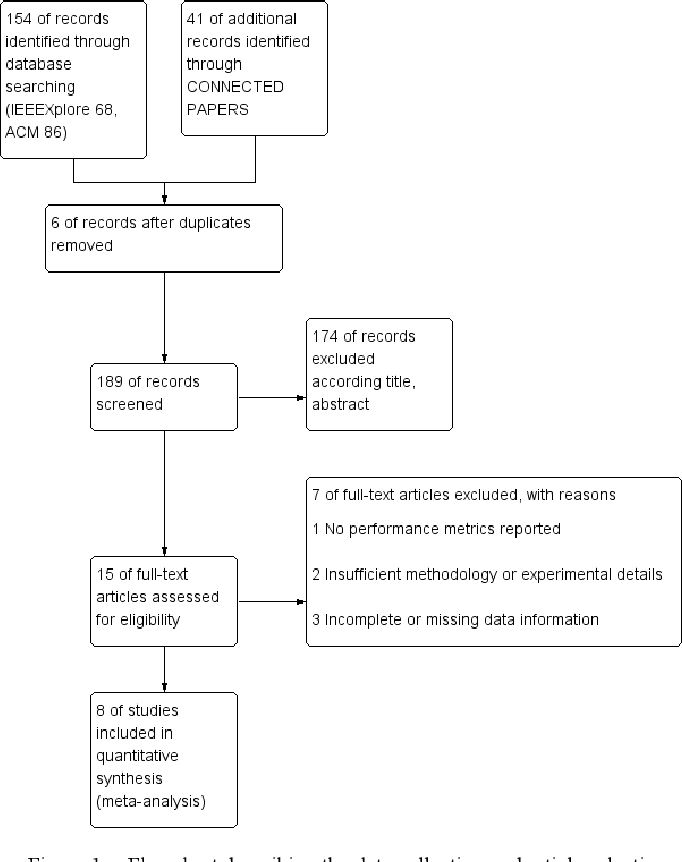
Figure 1 from Cloud-Base Retrieval Augmented Language Models in Multi ...

(PDF) DCASE 2022 Challenge Task 6B: Language-Based Audio Retrieval

Figure 1 from Language-based audio retrieval with Converging Tied ...
Advertisement Space (300x250)

Figure 1 from Language-Based Audio Retrieval with Textual Embeddings of ...

Figure 1 from Language-based Audio Retrieval with GPT-Augmented ...
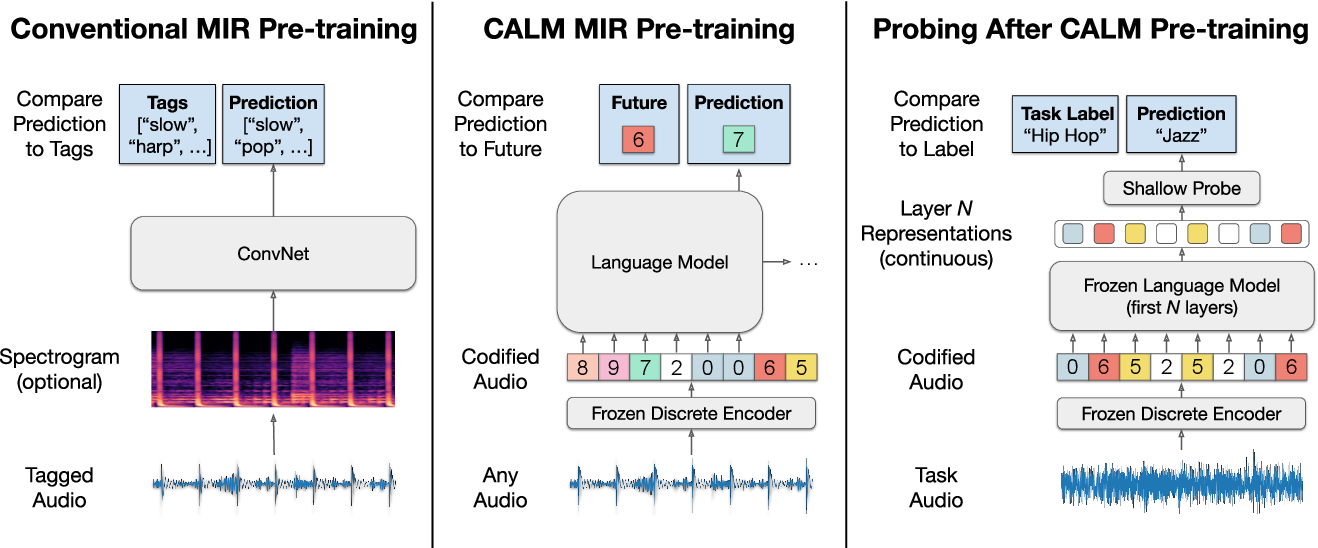
Figure 1 from Codified audio language modeling learns useful ...

Figure 1 from Bio-inspired Audio Content-Based Retrieval Framework ( B ...

Figure 1 from Retrieval Augmented Generation in Prompt-based Text-to ...
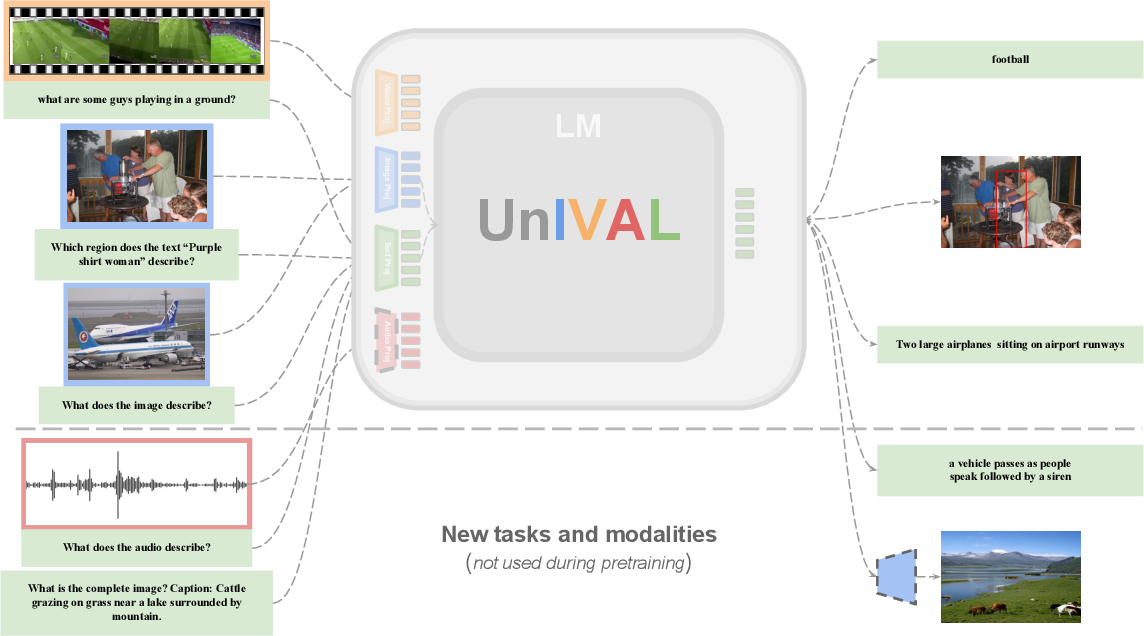
Figure 1 from Unified Model for Image, Video, Audio and Language Tasks ...

Figure 1 from Pengi: An Audio Language Model for Audio Tasks | Semantic ...

Figure 1 from Retrieval Augmented Generation in Prompt-based Text-to ...
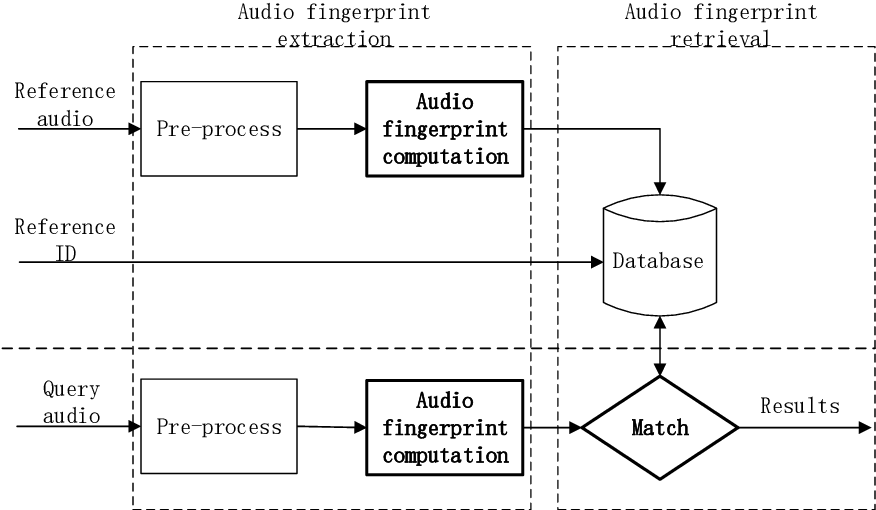
Figure 1 from Audio Fingerprint Extraction Based on Locally Linear ...

Figure 1 from Natural Language Supervision For General-Purpose Audio ...
Advertisement Space (336x280)
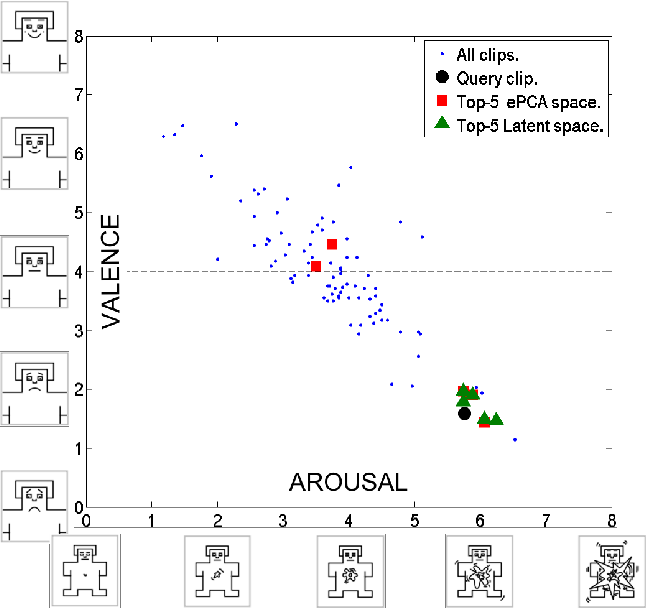
Figure 1 from Towards evaluation of example-based audio retrieval ...

Figure 1 from Real-Time Audio Retrieval Method and Automatic Commercial ...
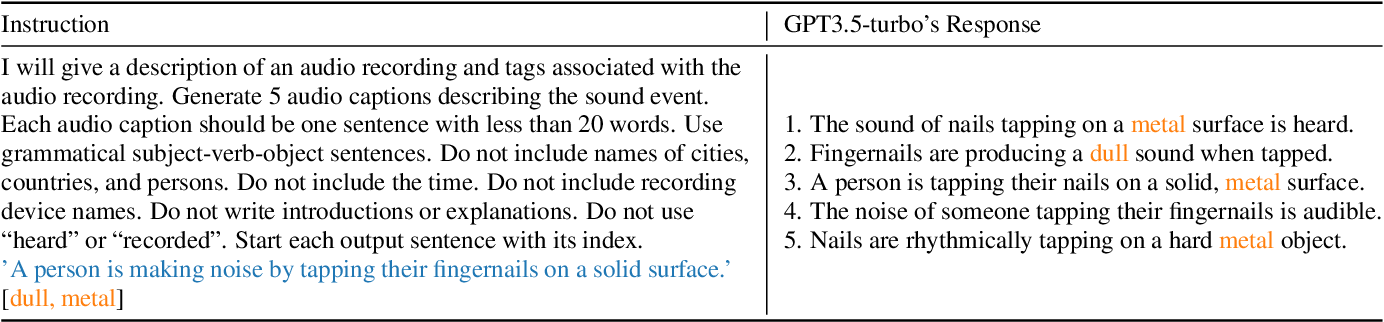
Table 1 from Advancing Natural-Language Based Audio Retrieval with ...
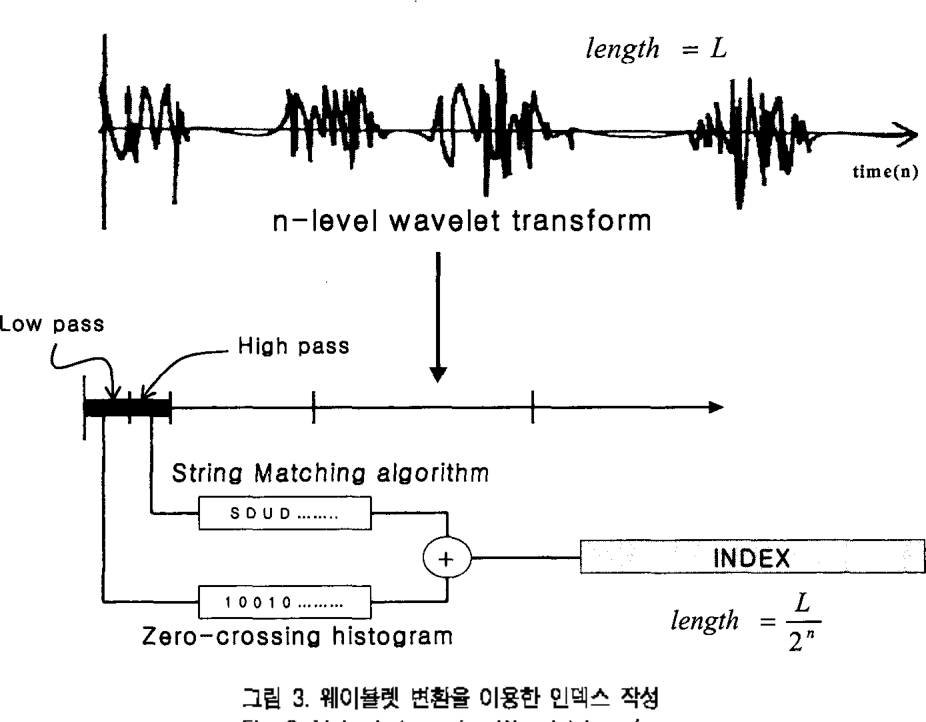
Figure 1 from Implementation of an Efficient Wavelet Based Audio Data ...
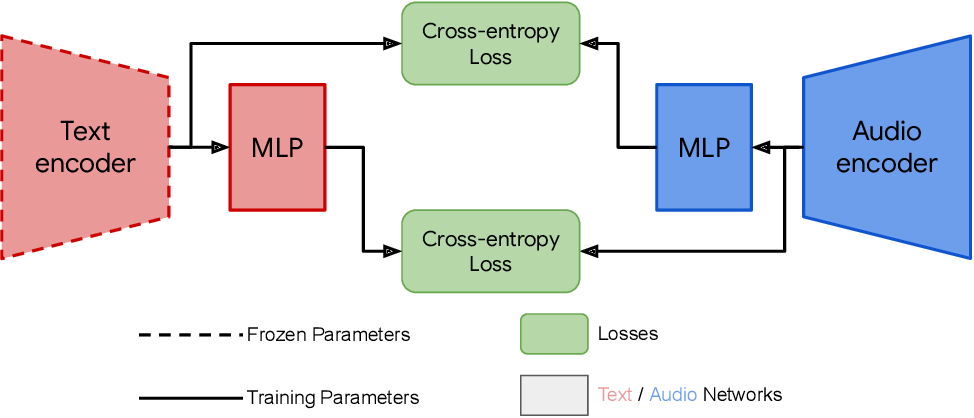
Figure 1 from TEXT-TO-AUDIO RETRIEVAL VIA LARGE-SCALE CONTRASTIVE ...

Figure 1 from Improving Audio-Text Retrieval via Hierarchical Cross ...
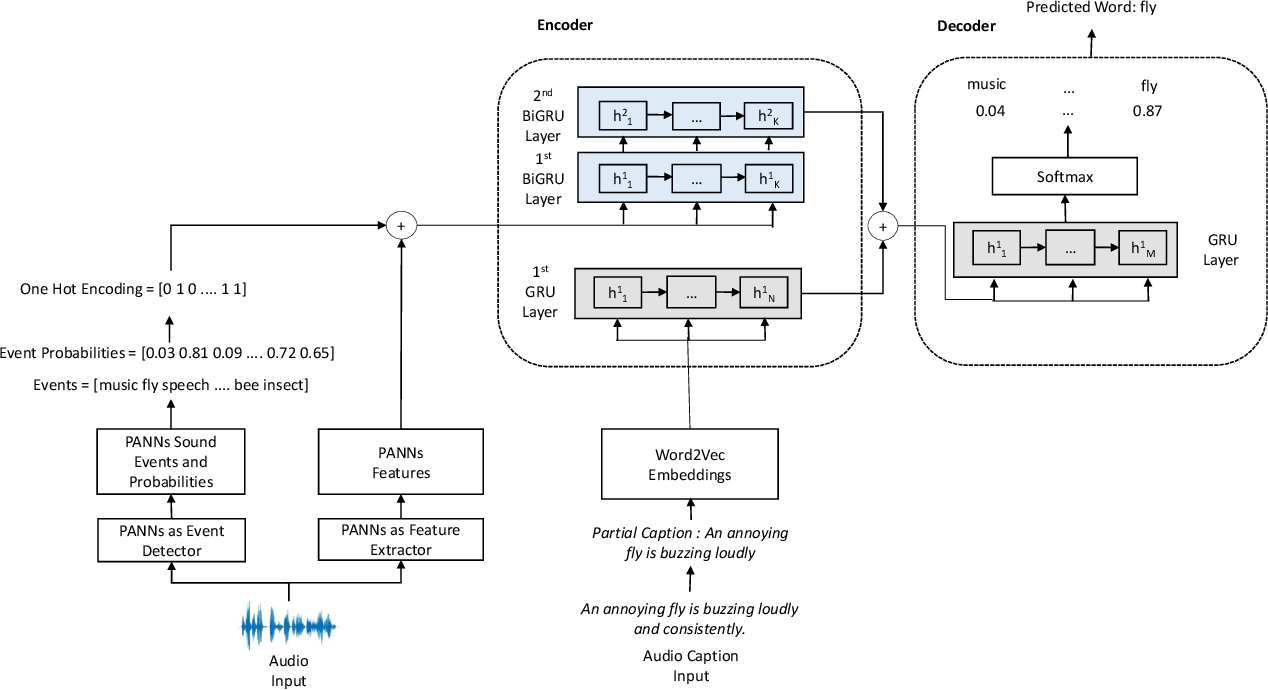
Figure 1 from Audio Captioning Using Sound Event Detection | Semantic ...

Figure 1 from QG-DETR: Query-Guided Detection Transformer for Audio ...

Figure 1 from Learning Audio Concepts from Counterfactual Natural ...

The audio components selected for machinery type in the DCASE 2022 ...
Advertisement Space (336x280)
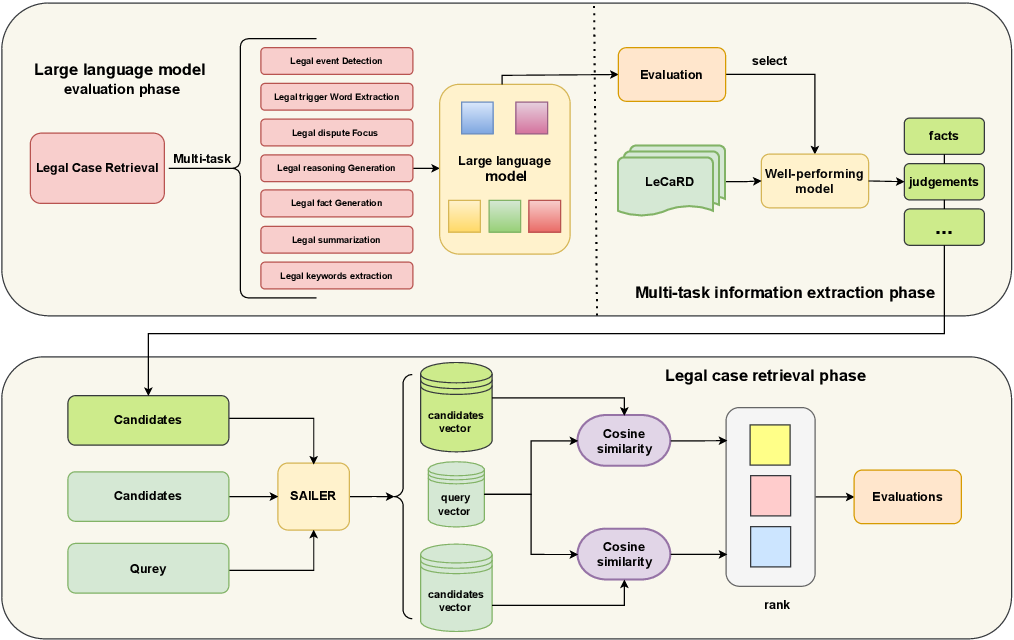
Figure 1 from A Large Language Model Evaluation Method for Legal Case ...

Figure 1 from Refining Knowledge Transfer on Audio-Image Temporal ...

Figure 1 from Retrieval-Augmented Text-to-Audio Generation | Semantic ...

Figure 1 from Introducing Auxiliary Text Query-modifier to Content ...
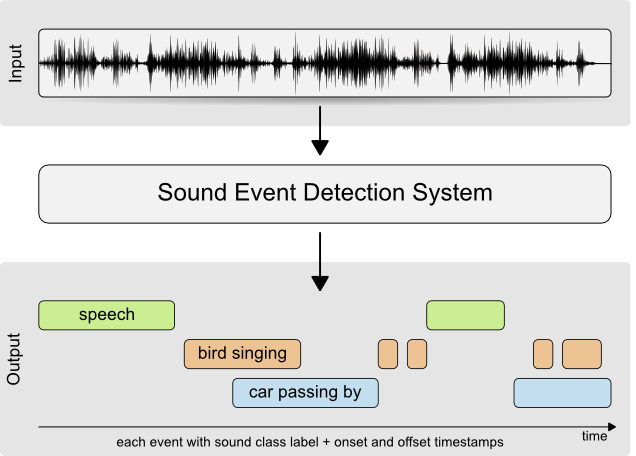
Sound event detection in real life audio - DCASE
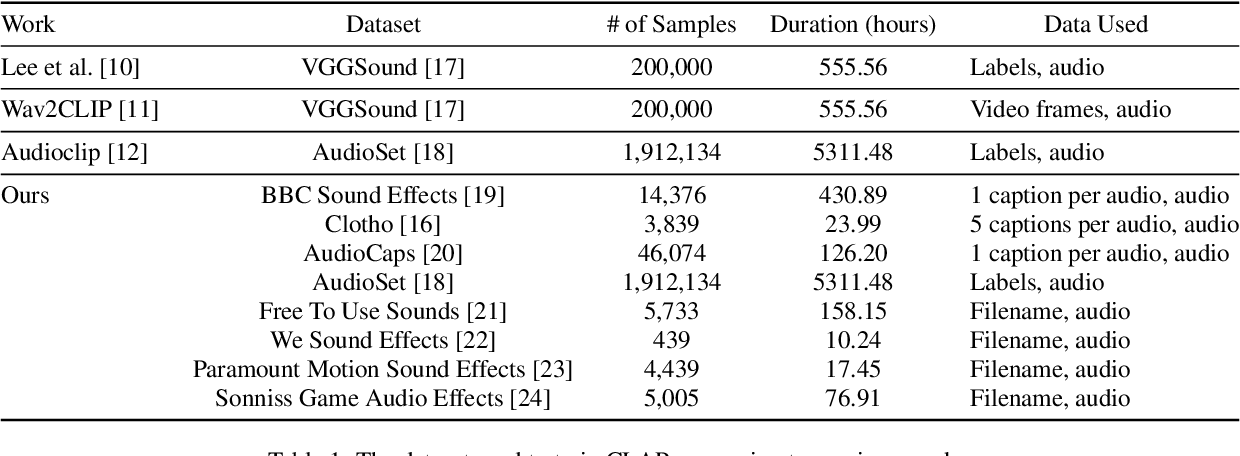
Table 1 from TEXT-TO-AUDIO RETRIEVAL VIA LARGE-SCALE CONTRASTIVE ...