
Figure 1 From Lf Vit Reducing Spatial Redundancy In Vision Transformer
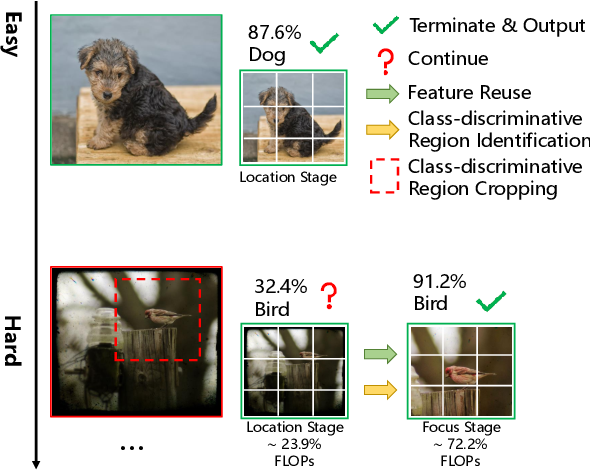
Figure 1 from LF-ViT: Reducing Spatial Redundancy in Vision Transformer ...

Table 1 from LF-ViT: Reducing Spatial Redundancy in Vision Transformer ...
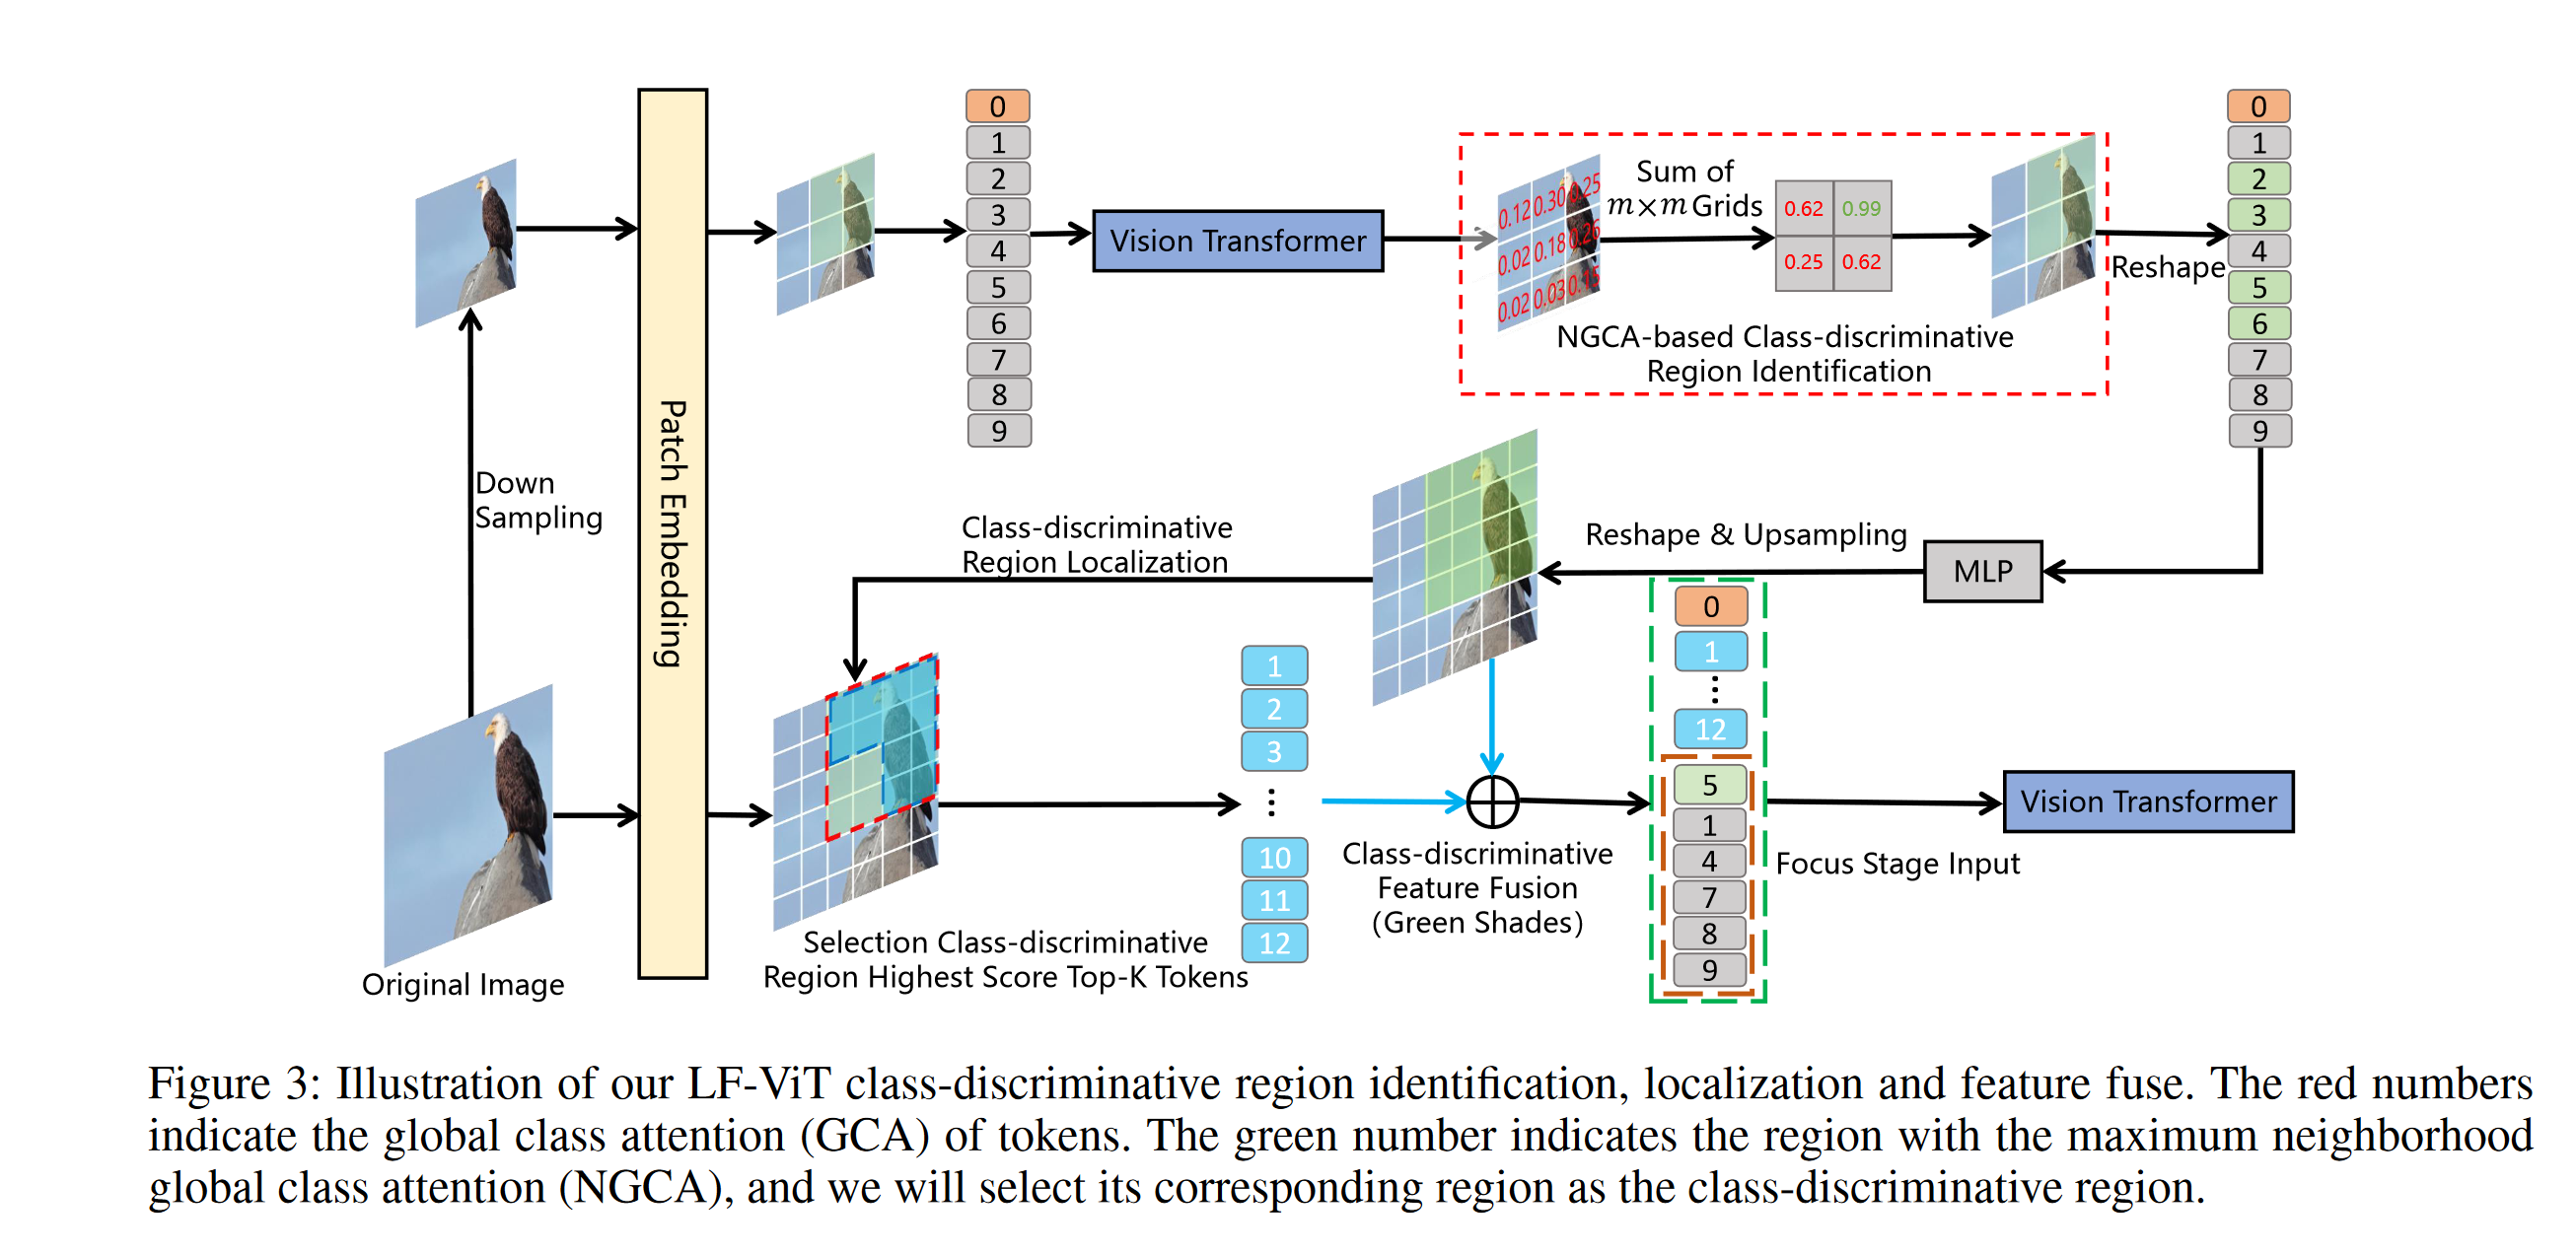
LF-ViT: Reducing Spatial Redundancy in Vision Transformer for Efficient ...
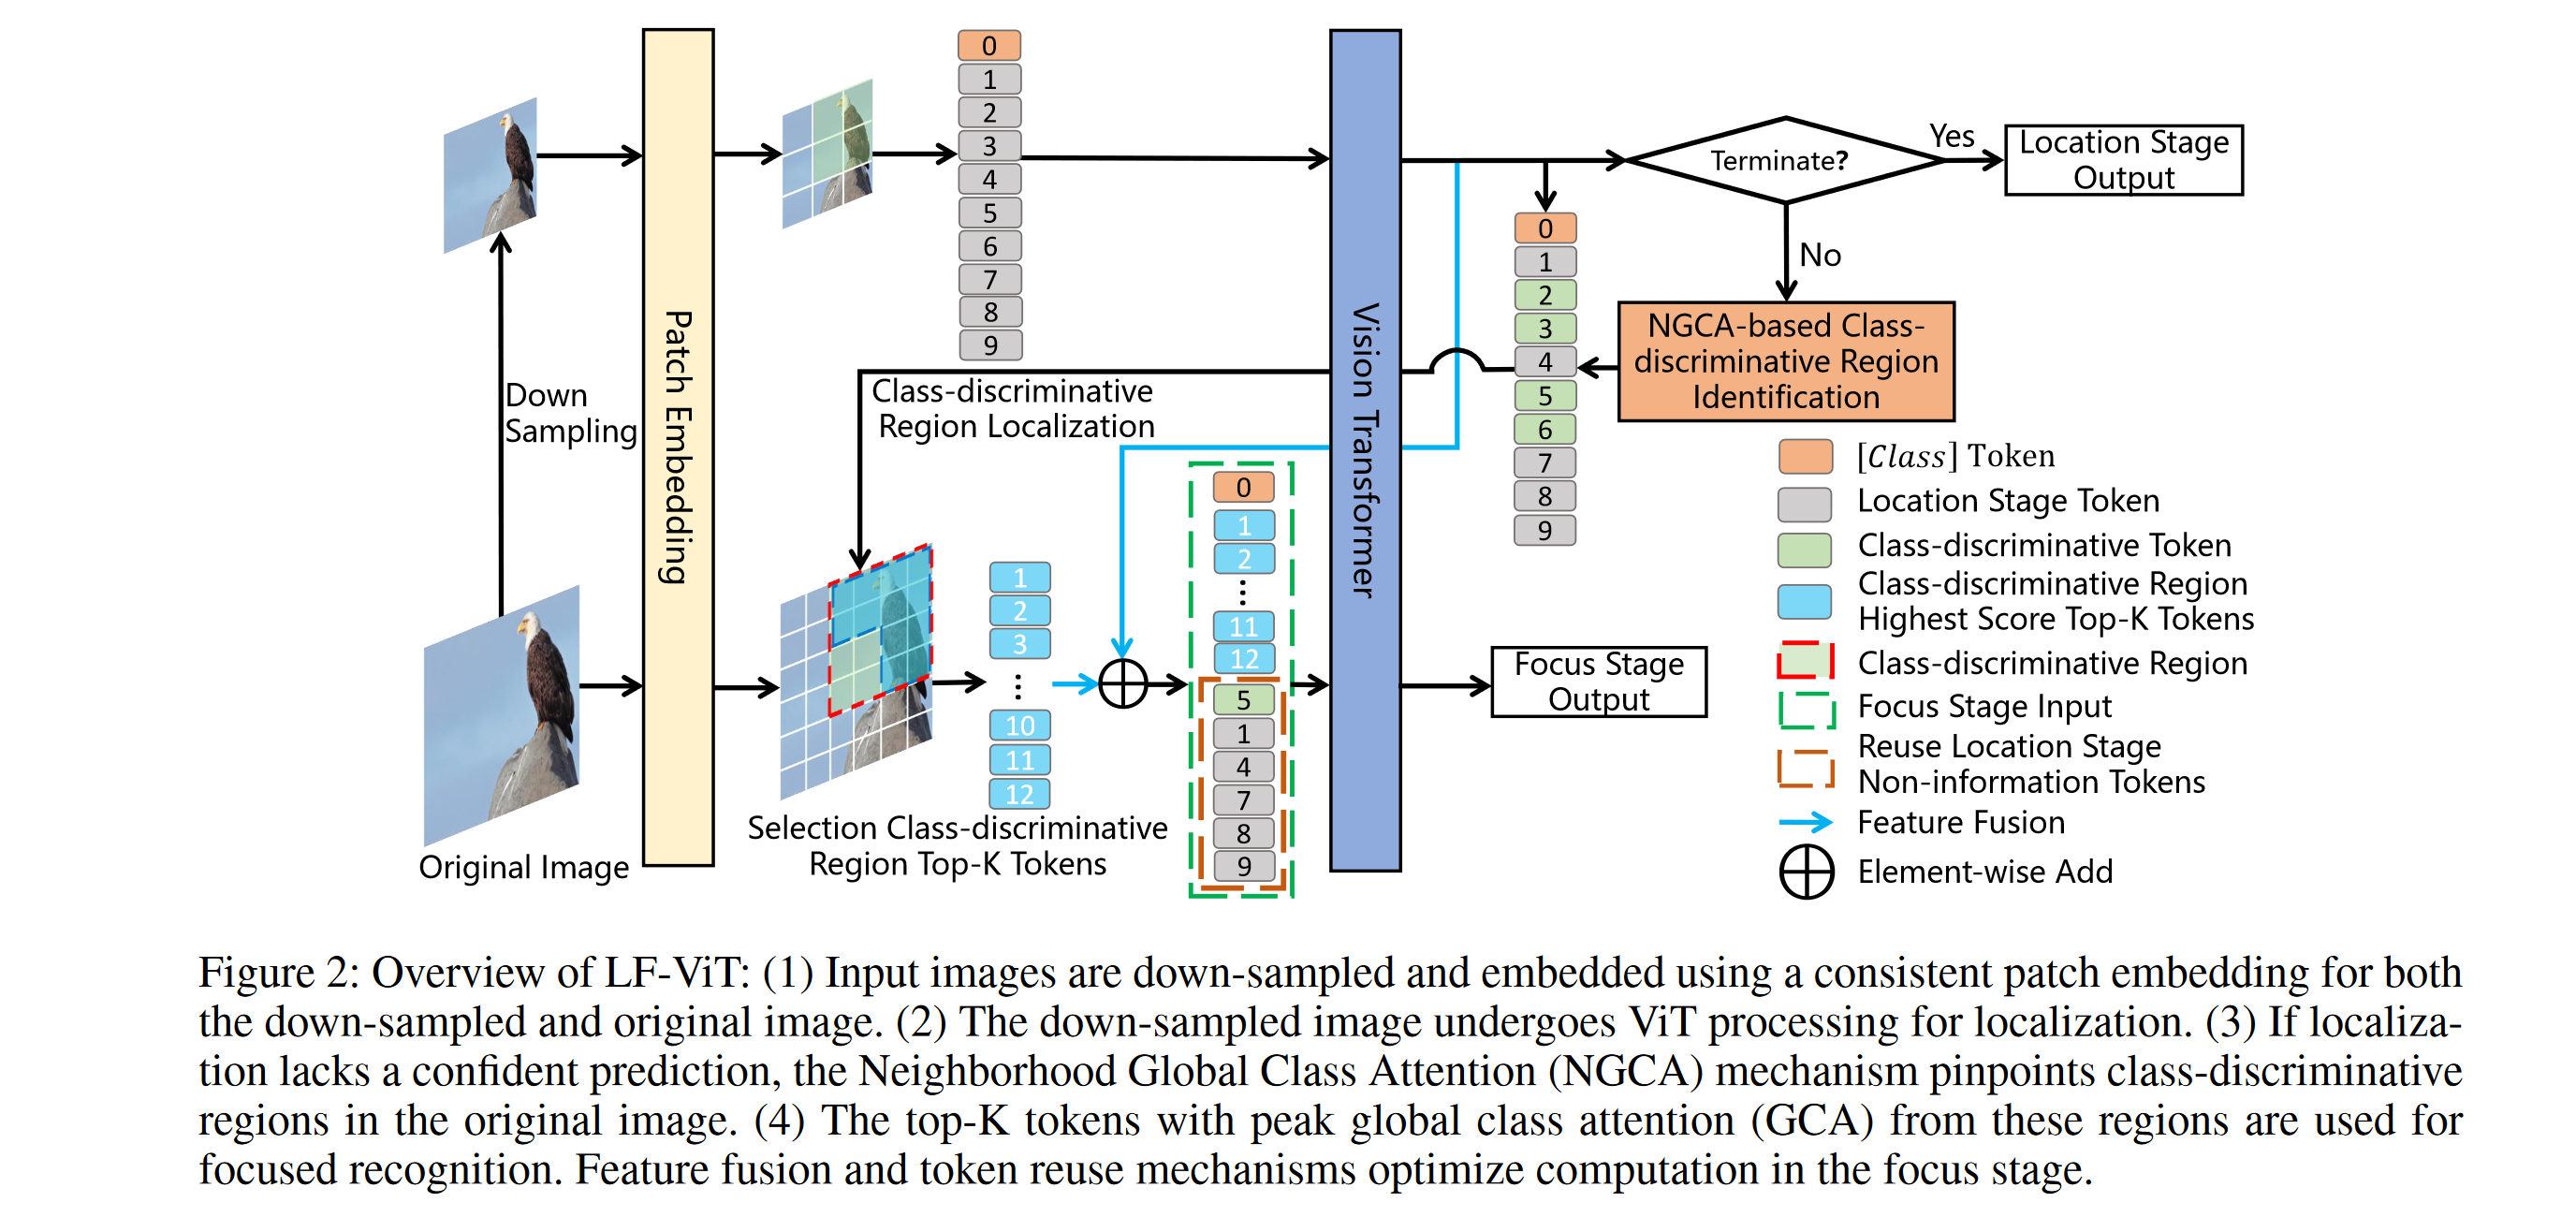
LF-ViT: Reducing Spatial Redundancy in Vision Transformer for Efficient ...

[2402.00033] LF-ViT: Reducing Spatial Redundancy in Vision Transformer ...
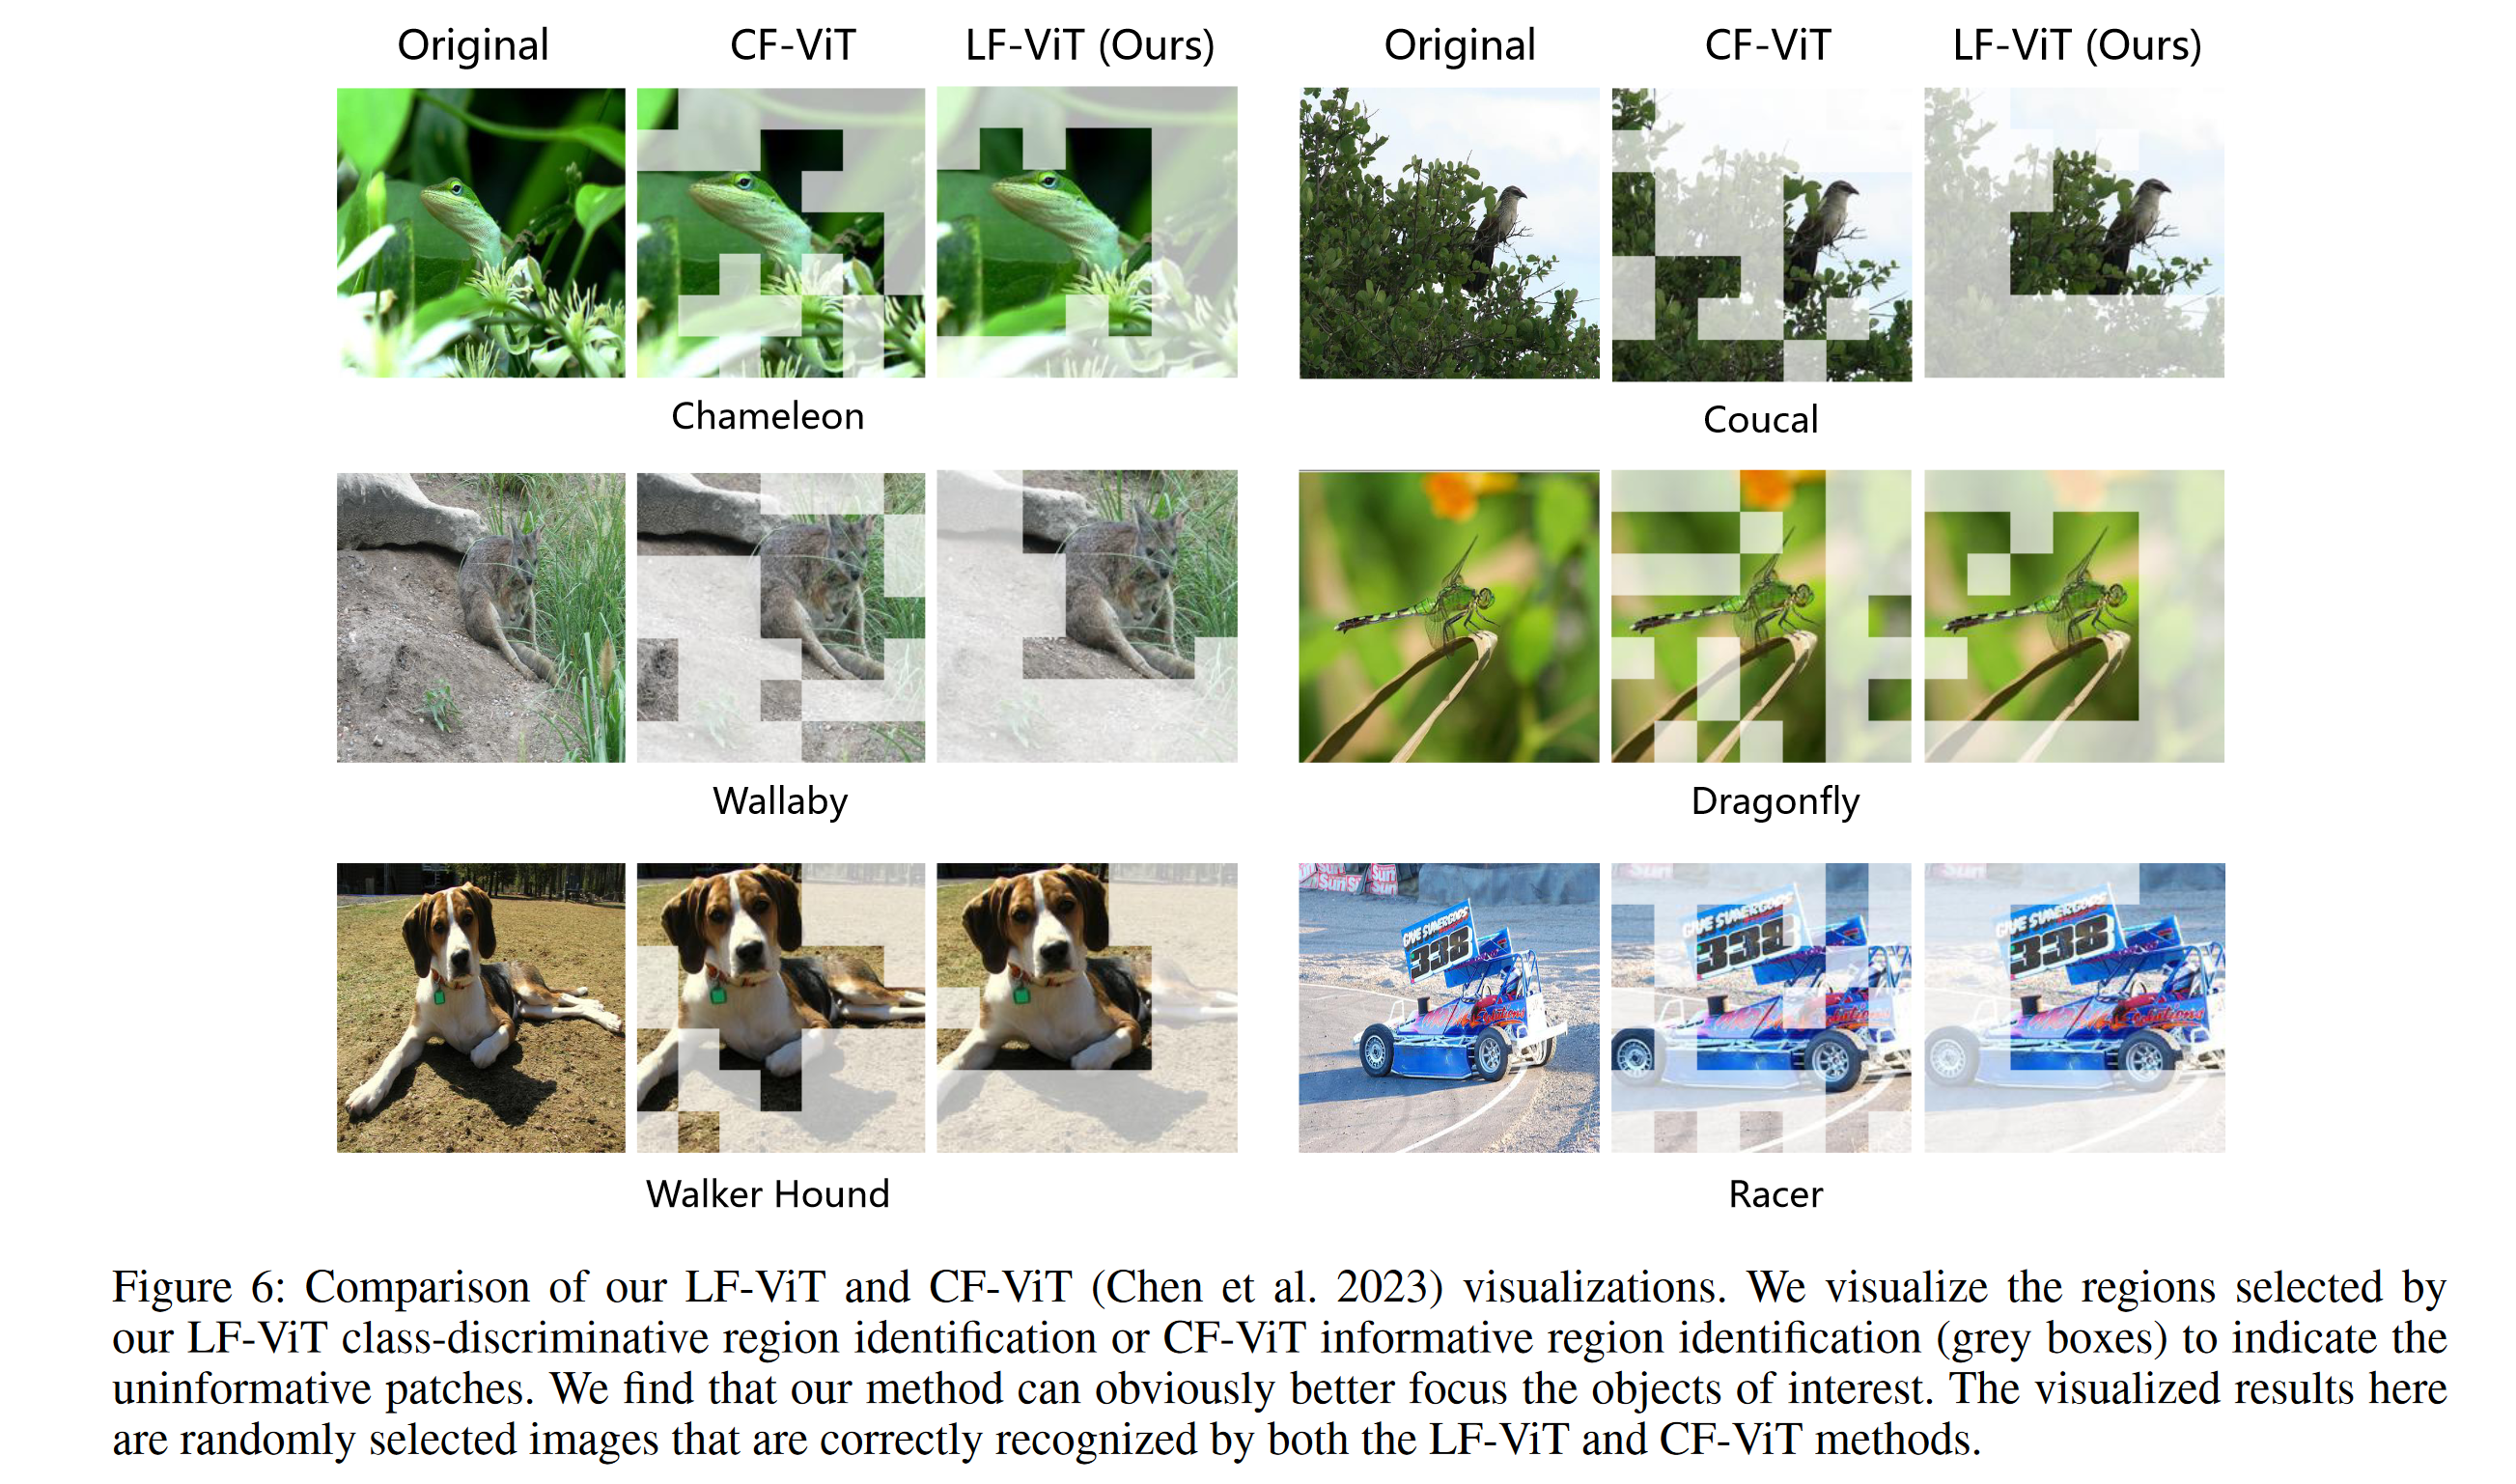
LF-ViT: Reducing Spatial Redundancy in Vision Transformer for Efficient ...

[2402.00033] LF-ViT: Reducing Spatial Redundancy in Vision Transformer ...

(PDF) LF-ViT: Reducing Spatial Redundancy in Vision Transformer for ...

[2402.00033] LF-ViT: Reducing Spatial Redundancy in Vision Transformer ...

LF-ViT: Reducing Spatial Redundancy in Vision Transformer for Efficient ...
Advertisement Space (300x250)

[2402.00033] LF-ViT: Reducing Spatial Redundancy in Vision Transformer ...

[2402.00033] LF-ViT: Reducing Spatial Redundancy in Vision Transformer ...

Figure 1 from CST-ViT: Cascaded Spatio–Temporal Redundancy Elimination ...

Figure 1 from CST-ViT: Cascaded Spatio–Temporal Redundancy Elimination ...

Figure 1 from CST-ViT: Cascaded Spatio–Temporal Redundancy Elimination ...
[2211.05187] Training a Vision Transformer from scratch in less than 24 ...

Figure 1 from CST-ViT: Cascaded Spatio–Temporal Redundancy Elimination ...

-General architecture of Vision Transformer VIT | Download Scientific ...

ViT | Vision Transformer | Vision Transformer (ViT) Architecture ...
Vision Transformer ViT model overall architecture | Download Scientific ...
Advertisement Space (336x280)

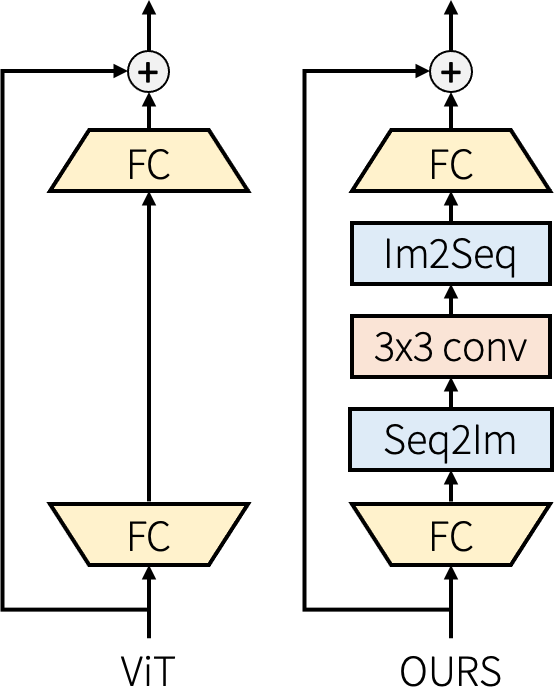
| The left side of the figure is the original vision transformer ...

From Vision Transformer Paper to code

Vision Transformer 论文 + 详解( ViT )_vision transformer论文-CSDN博客

Vision Transformer 论文 + 详解( ViT )_vision transformer论文-CSDN博客

(PDF) Spatial redundancy transformer for self-supervised fluorescence ...
Spatial redundancy transformer for self-supervised fluorescence image ...
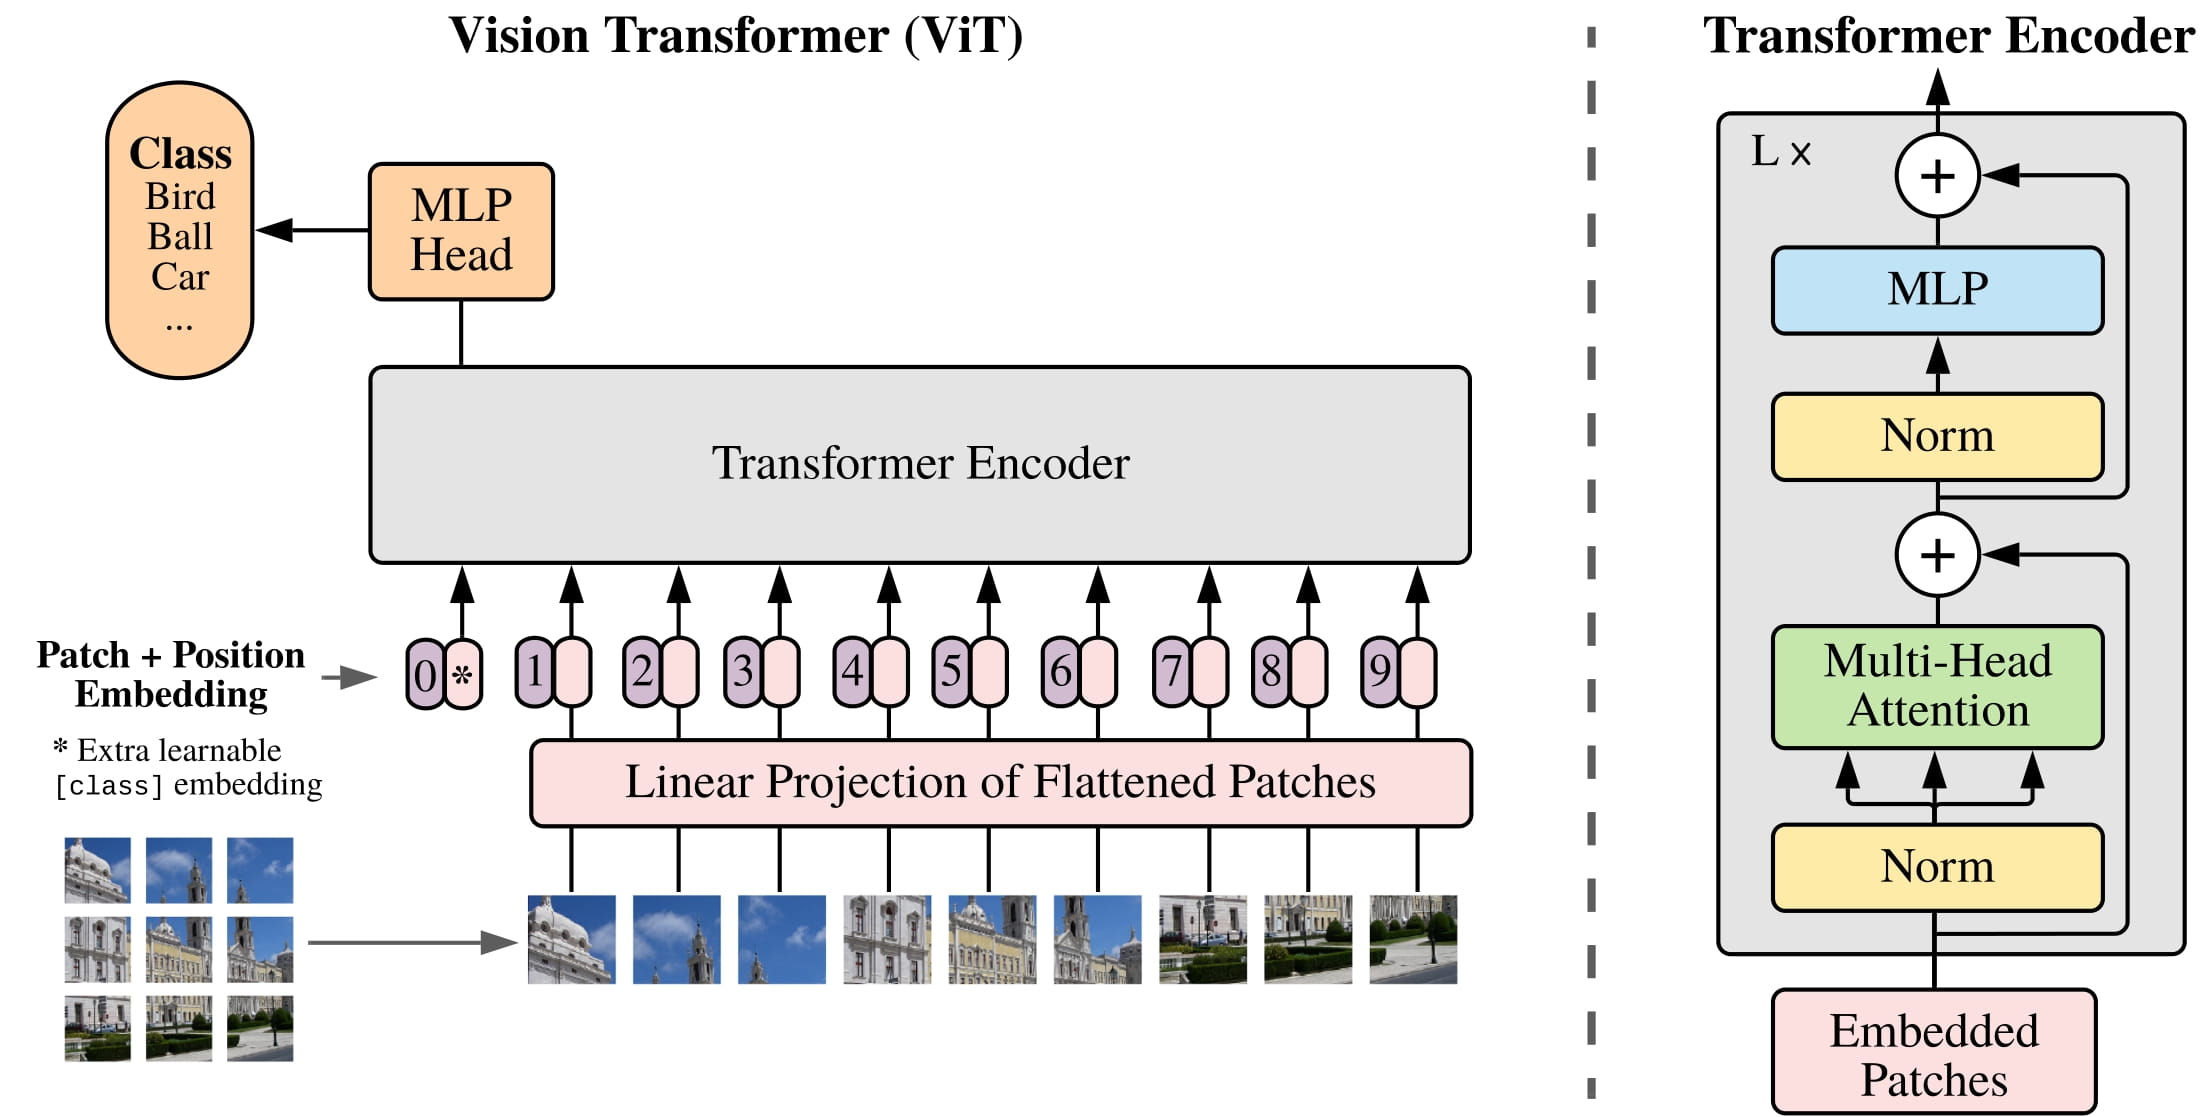
Vision Transformer (ViT)
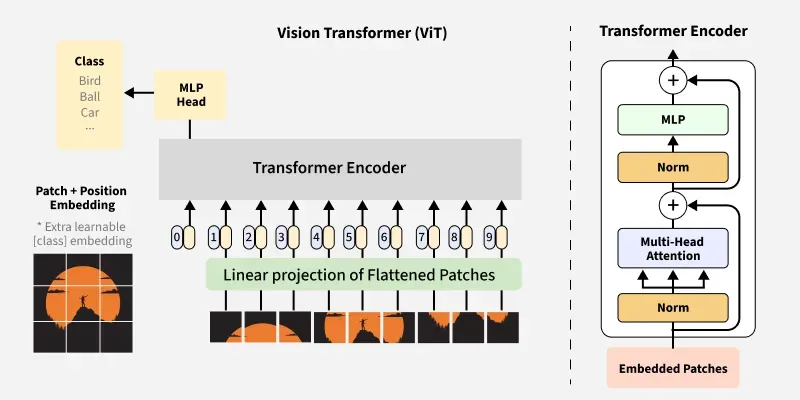
Vision Transformer (ViT) Architecture | GeeksforGeeks
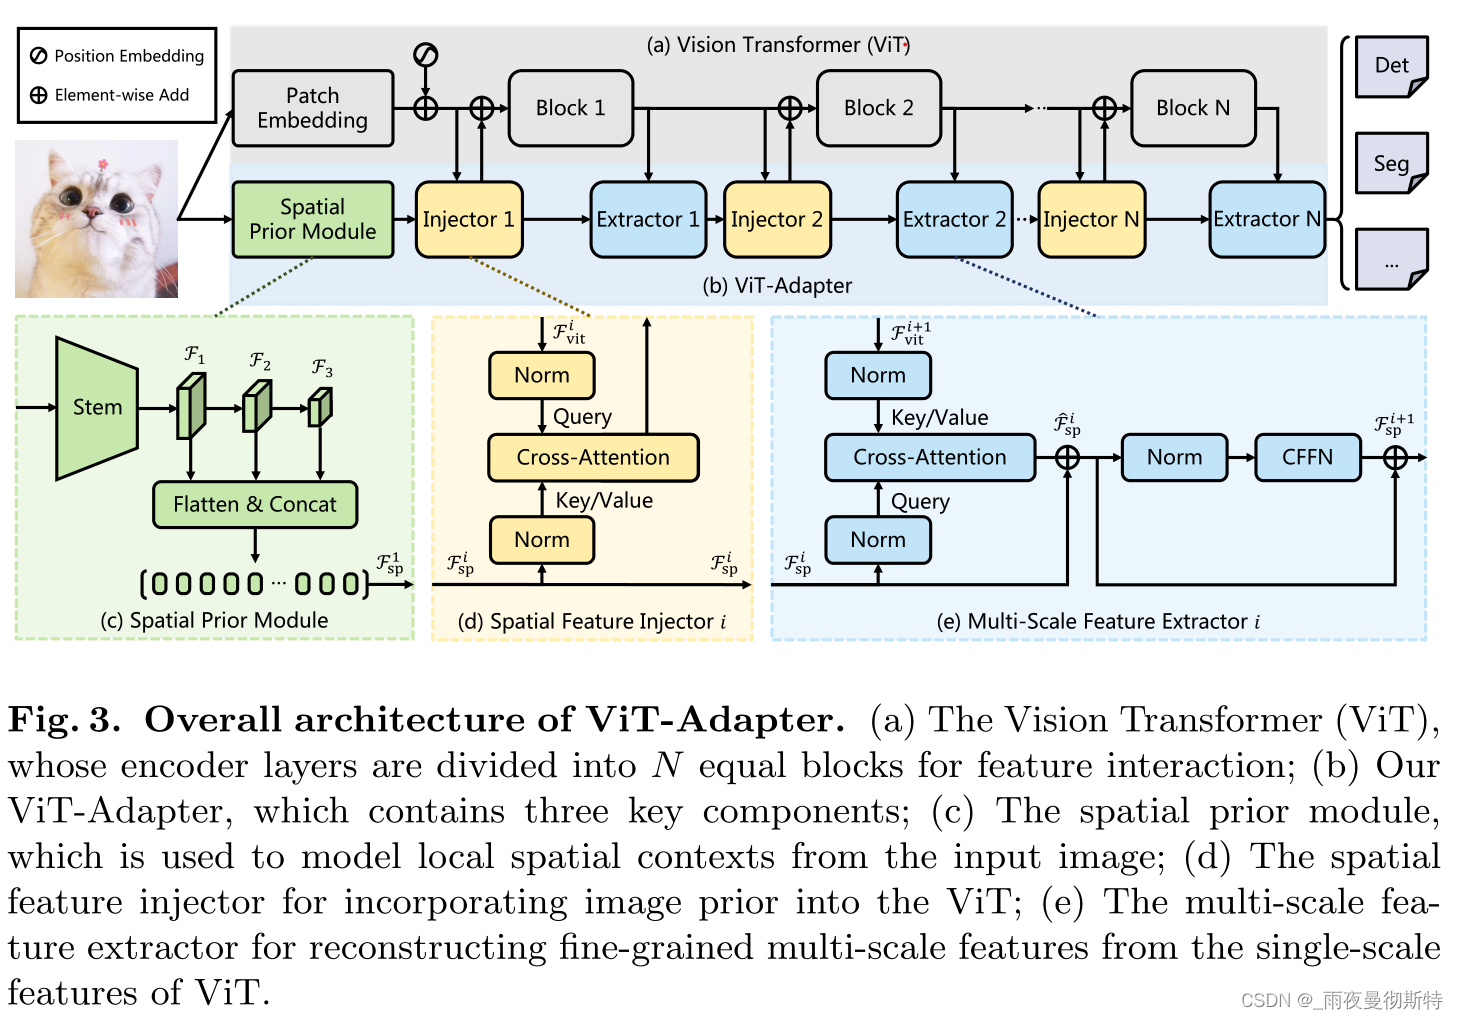
Vision Transformer Adapter for Dense Predictions 文献阅读-CSDN博客

GitHub - czczup/ViT-Adapter: [ICLR 2023 Spotlight] Vision Transformer ...
Advertisement Space (336x280)

An Improved Vision Transformer Network with a Residual Convolution ...

Vision Transformer 简介_vision transformer是谁提出的-CSDN博客
Illustration of the Vision Transformer (ViT) block model with 16 ...

The Vision Transformer Model - MachineLearningMastery.com

Vision Transformer (ViT) main architecture | Download Scientific Diagram

Detail architecture of Vision Transformer (ViT) | Download Scientific ...