
Figure 1 From Magic Multi Modality Guided Image Completion Semantic
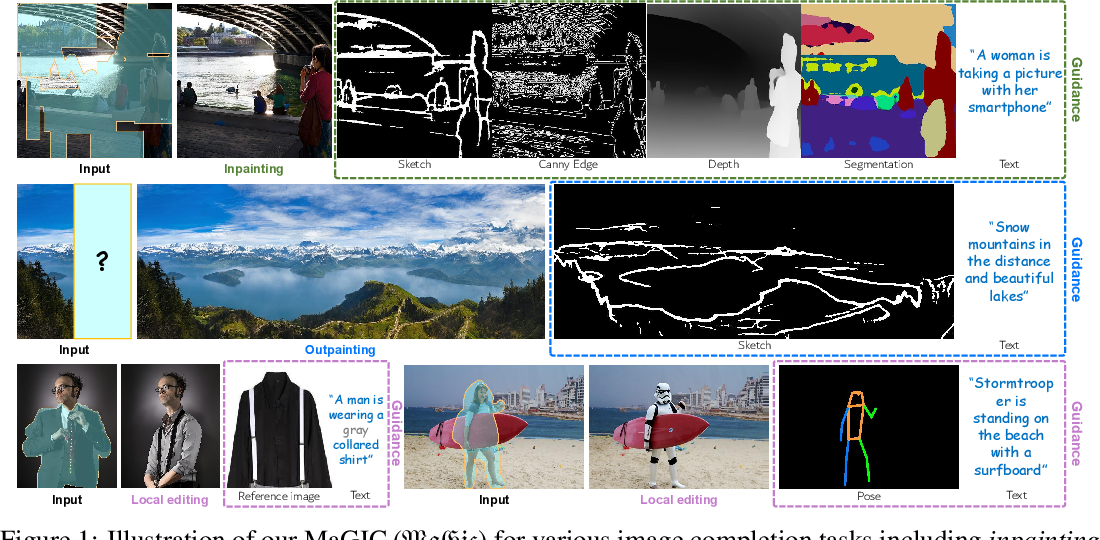
Figure 1 from MaGIC: Multi-modality Guided Image Completion | Semantic ...
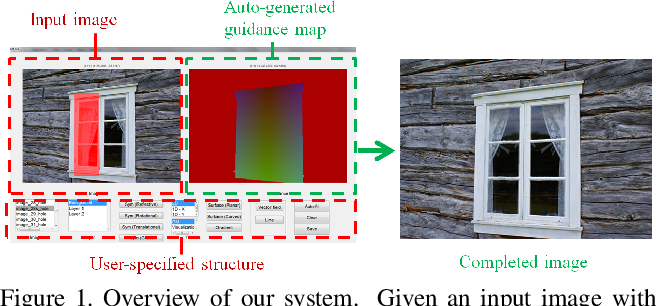
Figure 1 from Transformation guided image completion | Semantic Scholar
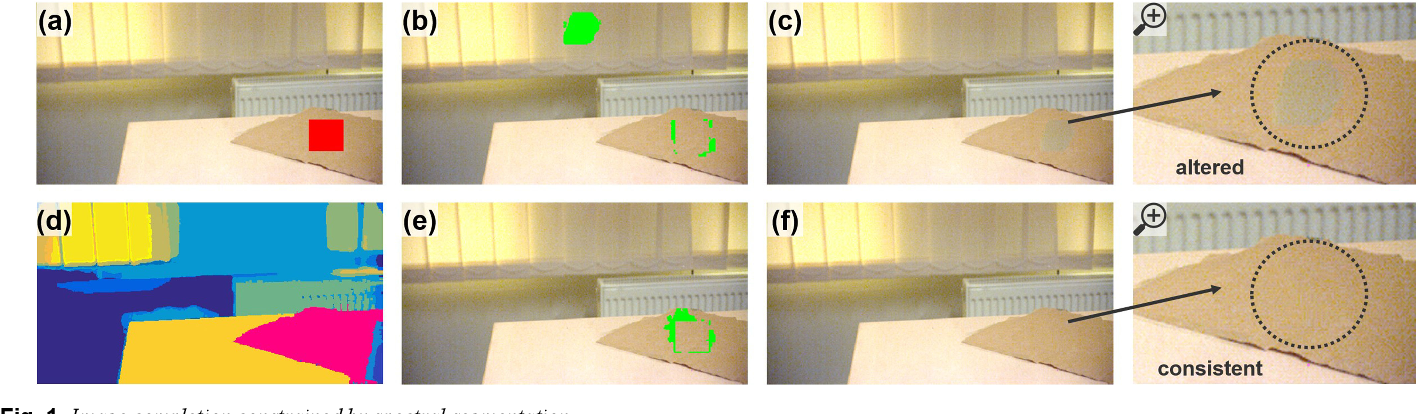
Figure 1 from Image completion using multispectral imaging | Semantic ...
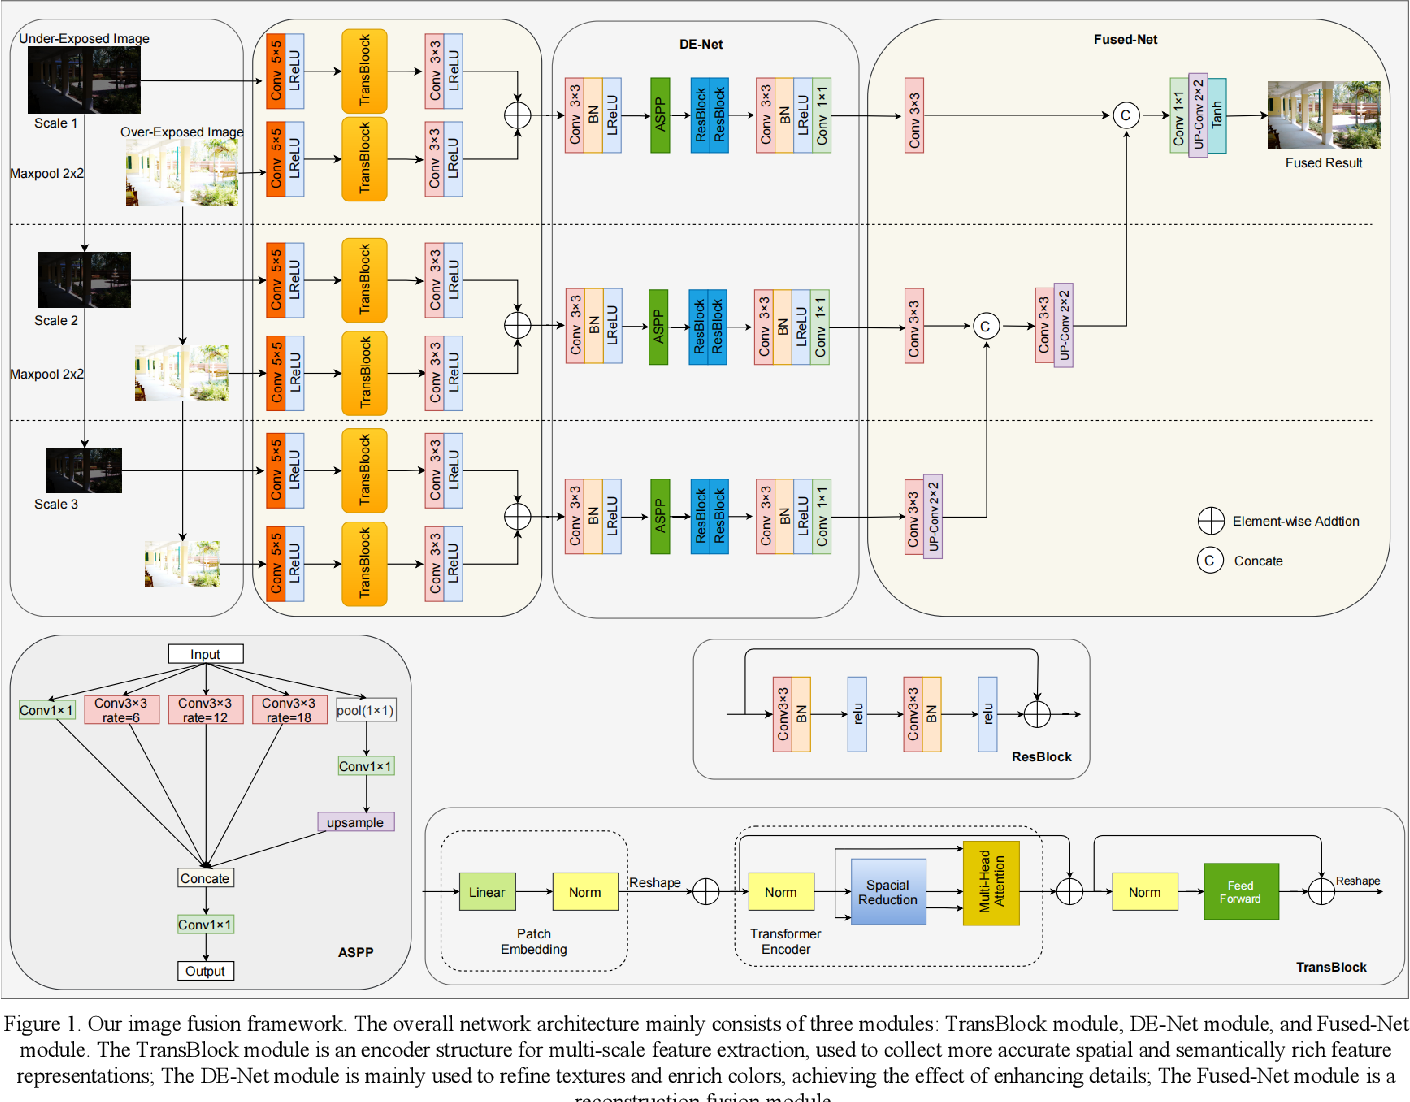
Figure 1 from Multi-Exposure Image Fusion via Attention Guided Multi ...

Figure 1 from Semantically Multi-Modal Image Synthesis | Semantic Scholar

Figure 1 from Equivariant Multi-Modality Image Fusion | Semantic Scholar
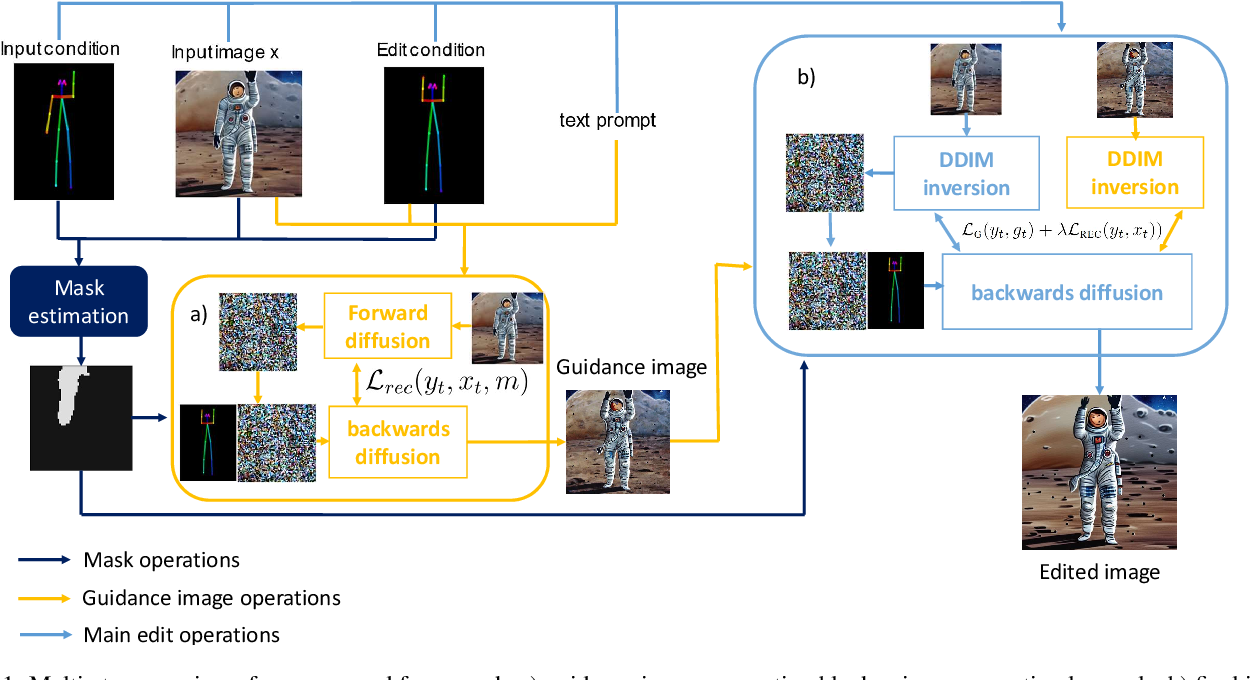
Figure 1 from Optimisation-Based Multi-Modal Semantic Image Editing ...

Figure 1 from Multi-Modality Image Manipulation Detection | Semantic ...
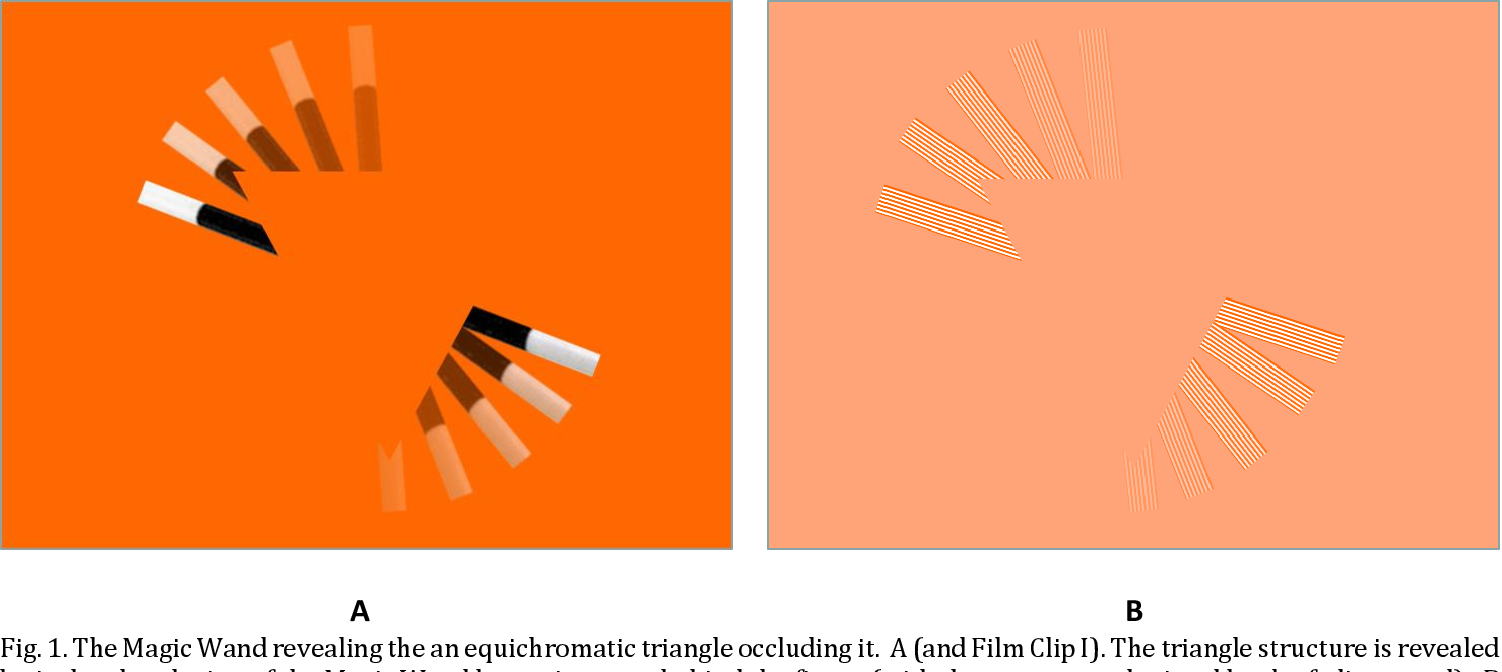
Figure 1 from Dynamic Amodal Completion Through the Magic Wand Illusion ...
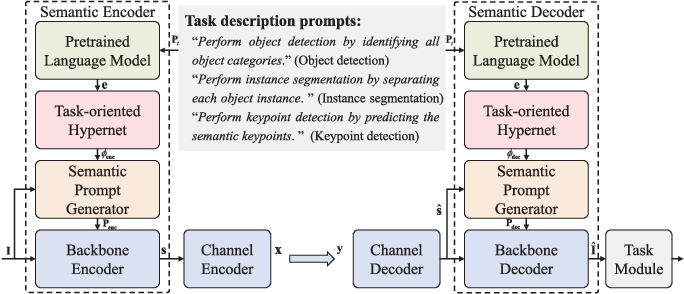
Figure 1 from Prompt-Guided Multi-Task Semantic Communication for Image ...
Advertisement Space (300x250)

Figure 1 from Mind the Gap: Understanding the Modality Gap in Multi ...
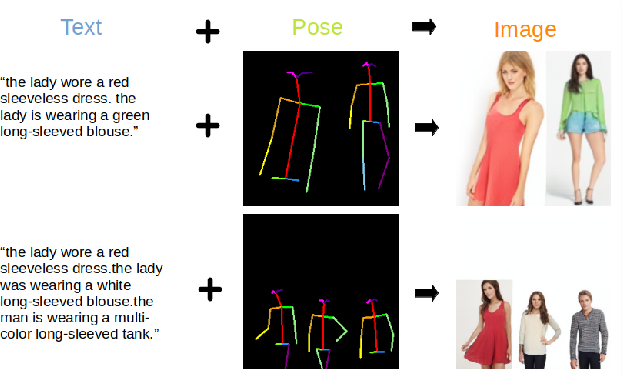
Figure 1 from Pose Guided Multi-person Image Generation From Text ...
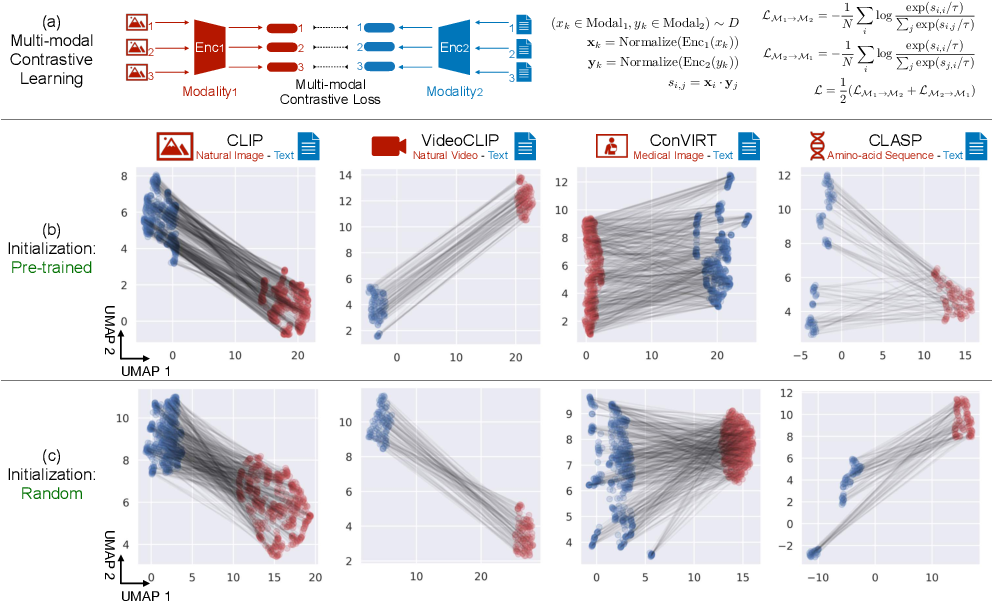
Figure 1 from Mind the Gap: Understanding the Modality Gap in Multi ...
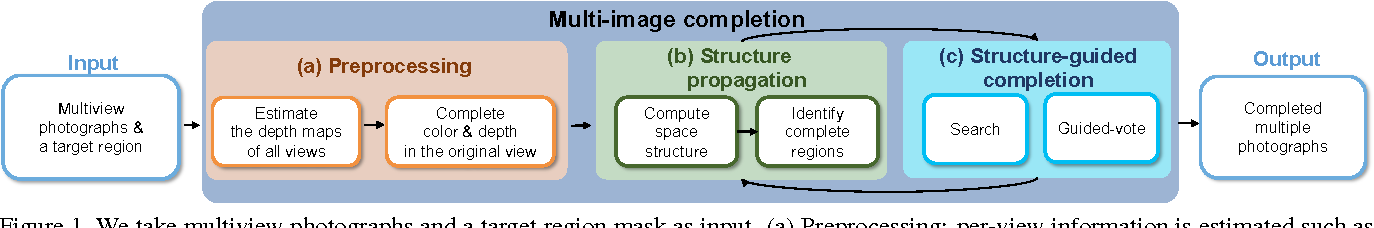
Figure 1 from Multiview Image Completion with Space Structure ...

Figure 1 from Multi-Domain Image Completion for Random Missing Input ...
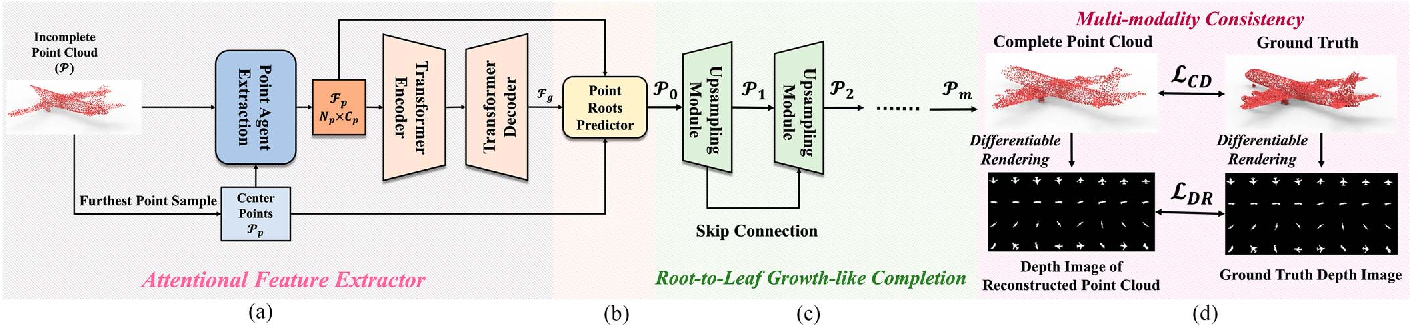
Figure 1 from Multimodality Consistency for Point Cloud Completion via ...

Figure 1 from Semantic Features Aided Multi-scale Reconstruction of ...
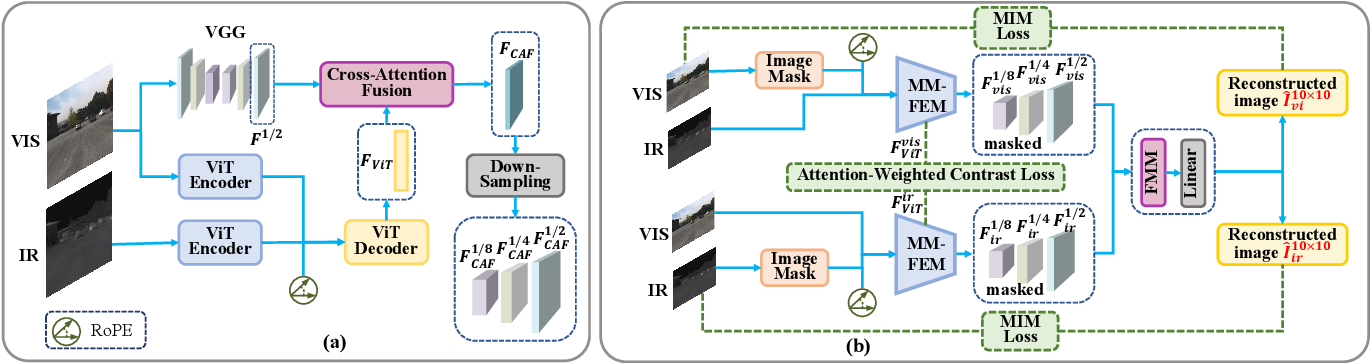
Figure 1 from Multimodal Image Matching Based on Cross-Modality ...

Figure 1 from Preserving Modality Structure Improves Multi-Modal ...

Figure 1 from Multi-Modality Image Fusion and Object Detection Based on ...
Advertisement Space (336x280)

Figure 1 from Multi-modal Prototype Guided Few-shot Object Detection ...
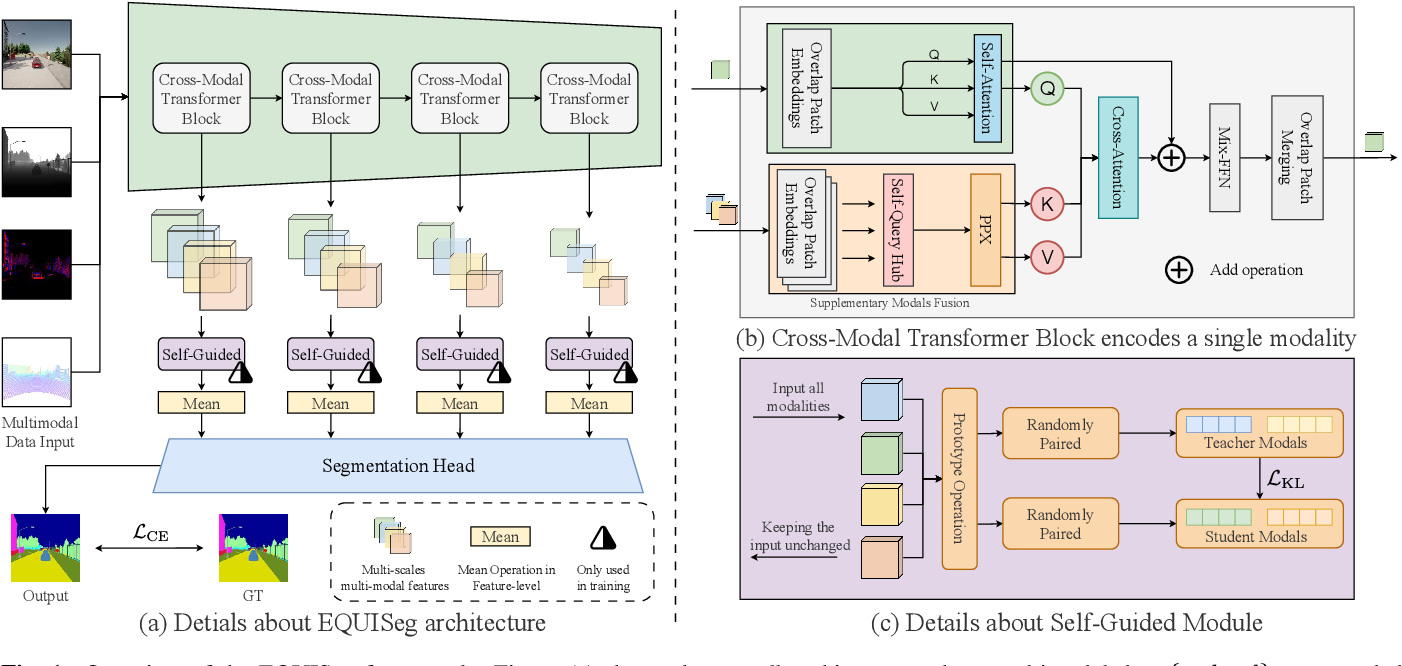
Figure 1 from Robust Multimodal Semantic Segmentation with Balanced ...
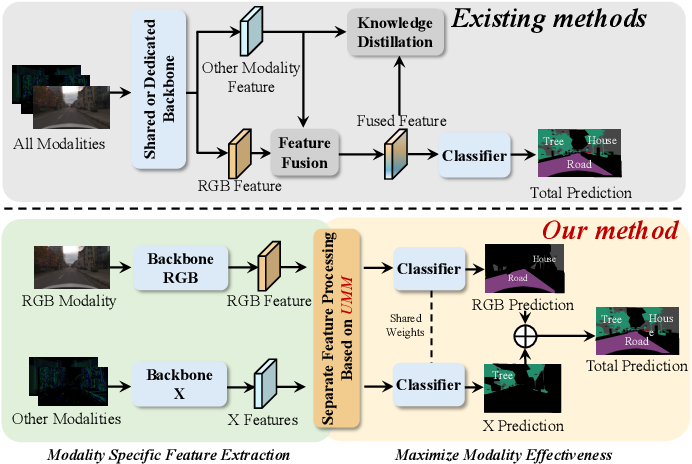
Figure 1 from BiXFormer: A Robust Framework for Maximizing Modality ...

Figure 1 from Multi-Modal Knowledge Graph Completion Enhanced by Muti ...
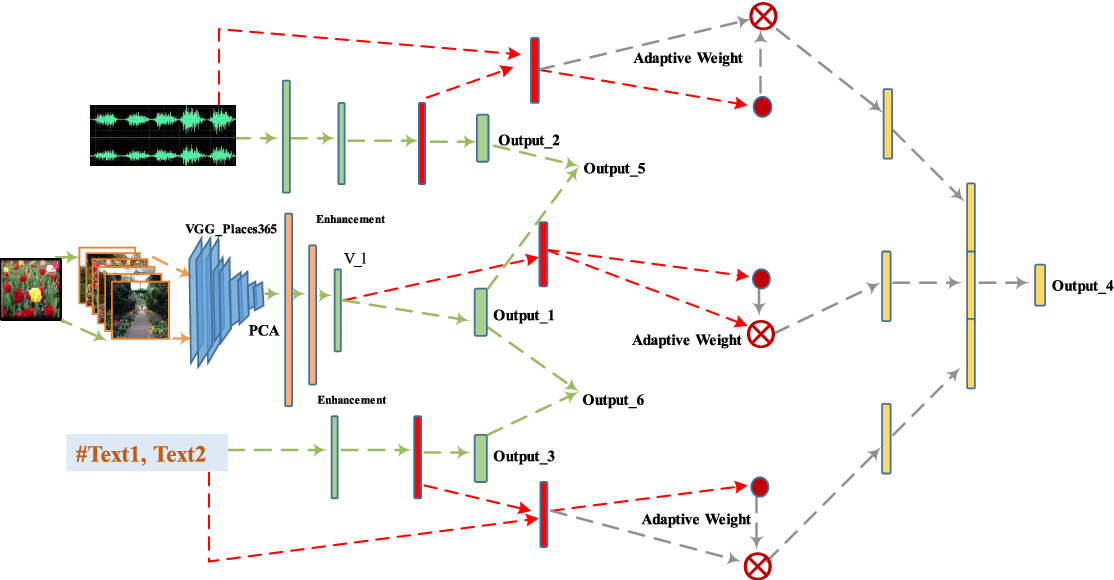
Figure 1 from Mutual Complementarity: Multi-Modal Enhancement Semantic ...
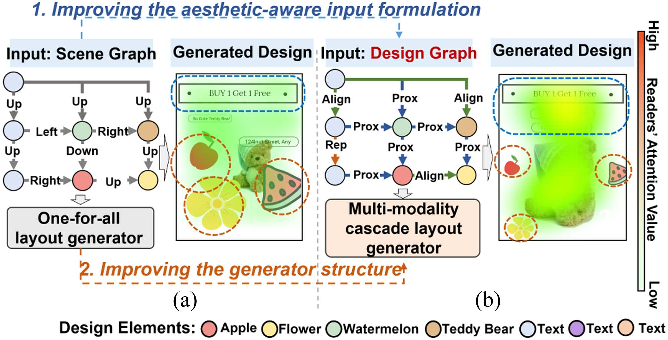
Figure 1 from Design Graph Guided Element Importance-Aware Layout ...

Figure 1 from A Two-stage hybrid CNN-Transformer Network for RGB Guided ...

Figure 1 from Depth Completion With Super-Resolution and Cross-Modality ...

Figure 1 from Geometric multimodal representation learning | Semantic ...

Figure 1 from Visual Navigation for Embodied Agents Using Semantic ...
Advertisement Space (336x280)
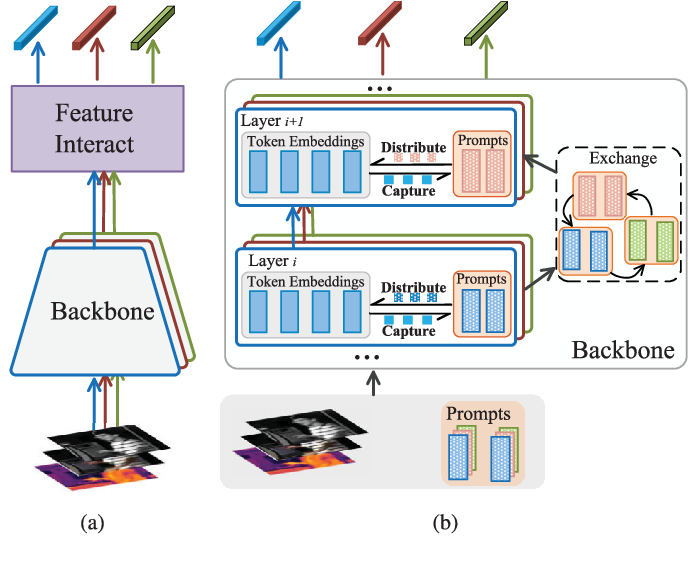
Figure 1 from Prompt-Based Modality Alignment for Effective Multi-Modal ...

Figure 1 from Generative Pretraining in Multimodality | Semantic Scholar

Figure 1 from Modality Invariant Multimodal Learning to Handle Missing ...
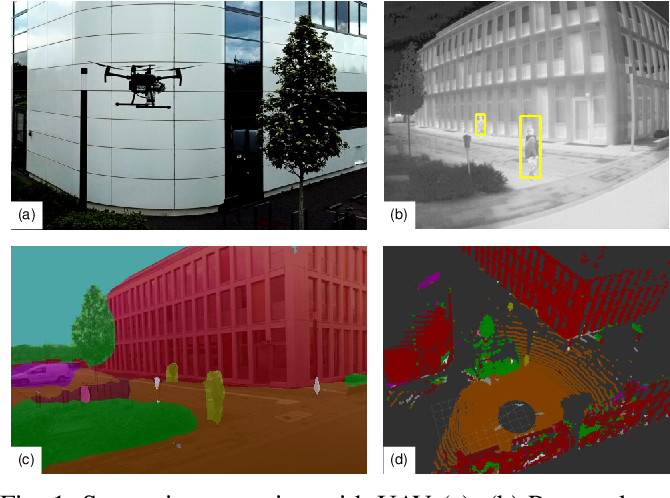
Figure 1 from Real-Time Multi-Modal Semantic Fusion on Unmanned Aerial ...

Figure 1 from Prototype-guided Cross-modal Completion and Alignment for ...

Figure 1 from Indoor Semantic Scene Understanding using Multi-modality ...