
Figure 1 From Multi Task Diffusion Model For Simultaneous Text And
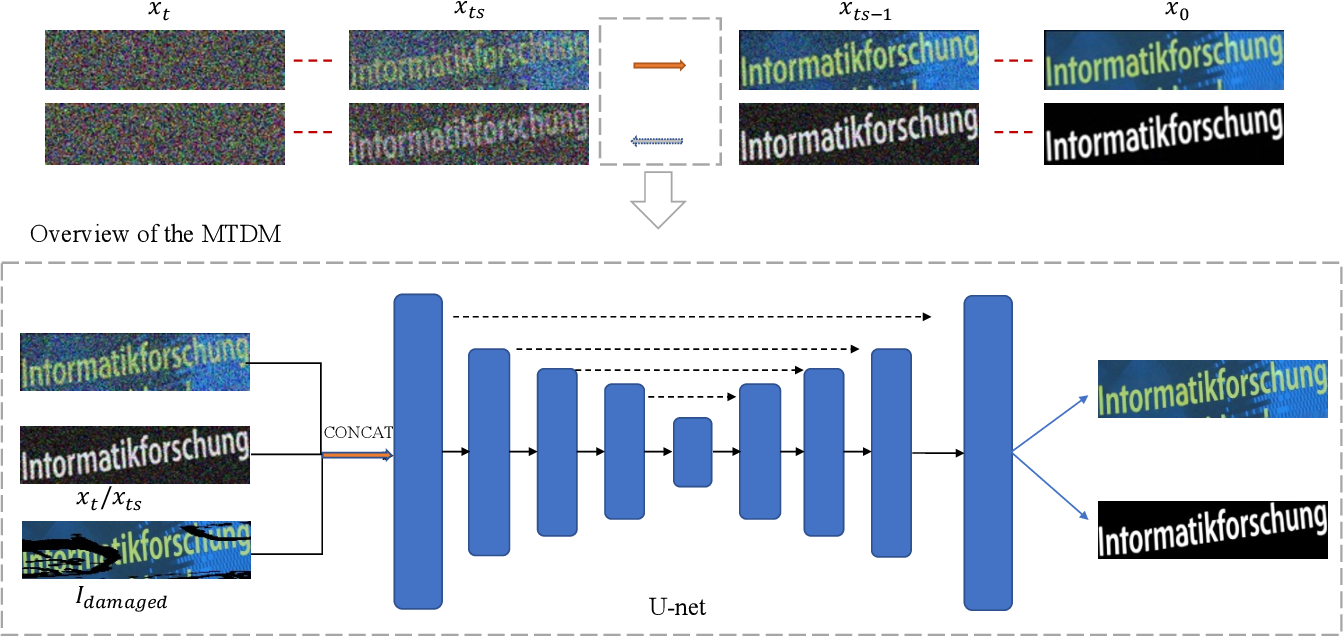
Figure 1 from Multi-Task Diffusion Model for Simultaneous Text and ...

Figure 1 from Conditional Diffusion Model for Multi-Agent Dynamic Task ...

Figure 1 from Diffusion Model is an Effective Planner and Data ...

Figure 1 from 3M-Diffusion: Latent Multi-Modal Diffusion for Text ...

Figure 1 from Diffusion Model is an Effective Planner and Data ...
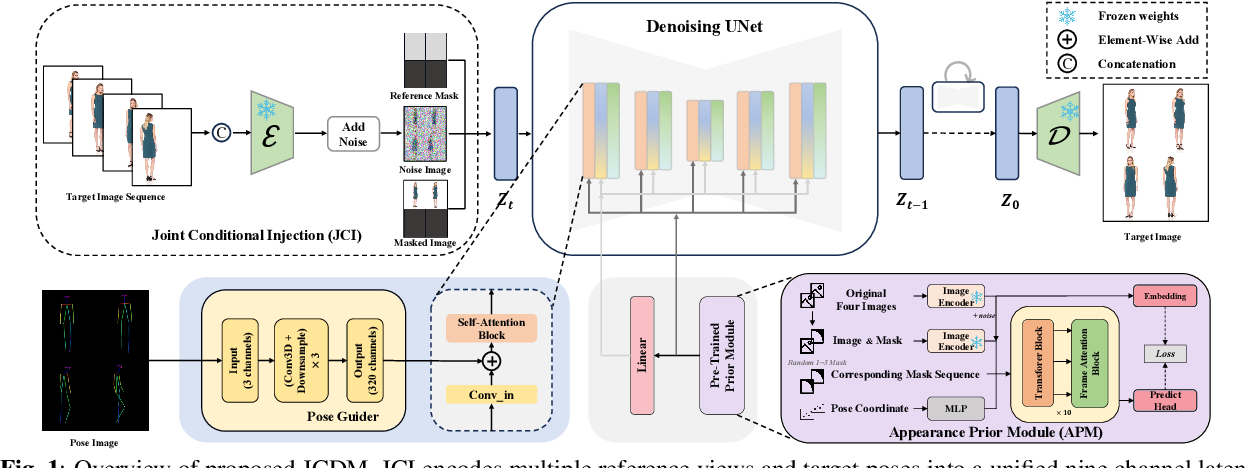
Figure 1 from Jointly Conditioned Diffusion Model for Multi-View Pose ...

Figure 1 from Multi-Source Diffusion Models for Simultaneous Music ...

Figure 1 from Adaptive Latent Diffusion Model for 3D Medical Image to ...

Figure 1 from Diffusion Model is an Effective Planner and Data ...
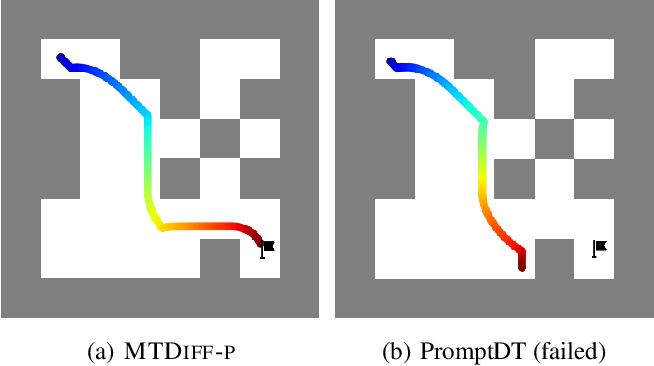
Figure 1 from Diffusion Model is an Effective Planner and Data ...
Advertisement Space (300x250)

Figure 1 from Diffusion Model is an Effective Planner and Data ...

Figure 1 from Diffusion Model is an Effective Planner and Data ...

Figure 1 from A Diffusion Model for Multimessage Multidimensional ...
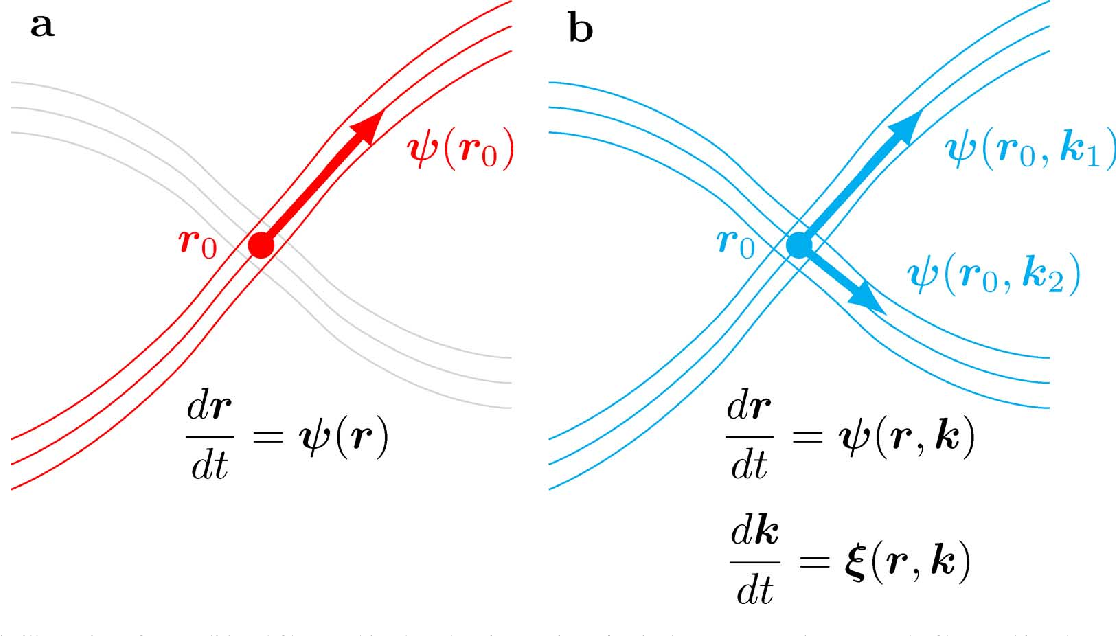
Figure 1 from Simultaneous Multi-Scale Diffusion Estimation and ...

Figure 1 from Dual-Conditionally Guided Diffusion Models for Fusion of ...
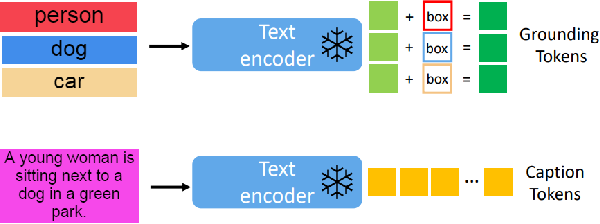
Figure 1 from Grounding Text-To-Image Diffusion Models For Controlled ...

Figure 1 from Training-Free Safe Text Embedding Guidance for Text-to ...

Figure 2 from Multiple Noises in Diffusion Model for Semi-Supervised ...

Figure 3 from Regularized Conditional Diffusion Model for Multi-Task ...

Figure 1 from Federated Learning with Diffusion Models for Privacy ...
Advertisement Space (336x280)
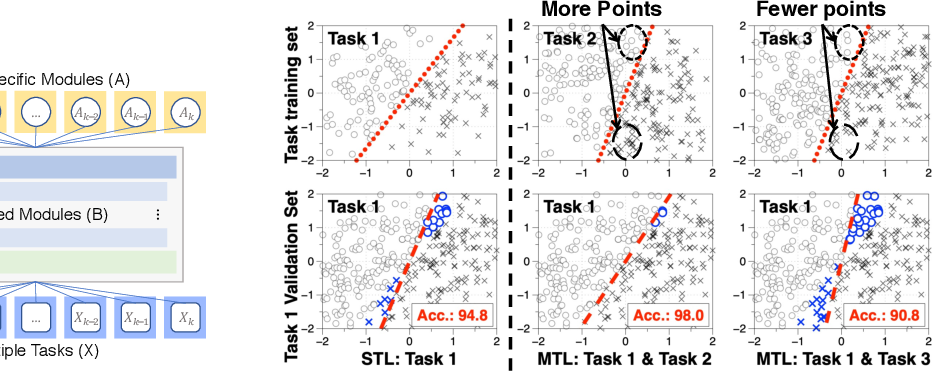
Figure 1 from Understanding and Improving Information Transfer in Multi ...

Figure 1 from A Diffusion Model-Based Joint Dual-Task Network for Low ...
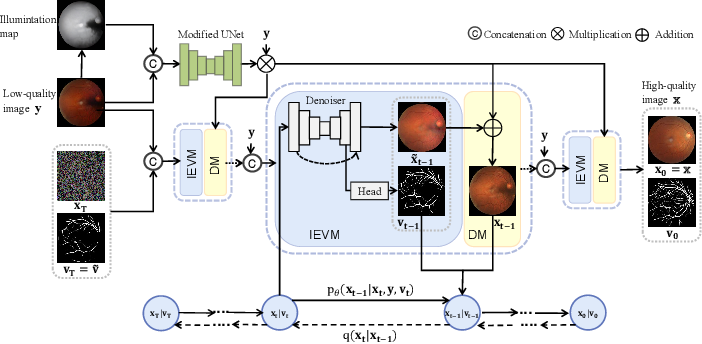
Figure 1 from A Diffusion Model-Based Joint Dual-Task Network for Low ...

Figure 1 from DiffusionMTL: Learning Multi-Task Denoising Diffusion ...

Figure 1 from Forward Diffusion Guided Reconstruction as a Multi-Modal ...

MixDiff-TTS: Mixture Alignment and Diffusion Model for Text-to-Speech

Figure 1 from Diffusion Language Models Can Perform Many Tasks with ...

Conditional Diffusion Model for Multi-Agent Dynamic Task Decomposition ...

MixDiff-TTS: Mixture Alignment and Diffusion Model for Text-to-Speech

Multi-Source Diffusion Models for Simultaneous Music Generation and ...
Advertisement Space (336x280)

Figure 1 from Aligning Text-to-Image Diffusion Models without Human ...

Figure 1 from Pre-trained Text-to-Image Diffusion Models Are Versatile ...

Figure 1 from Diffusion Language Models Can Perform Many Tasks with ...
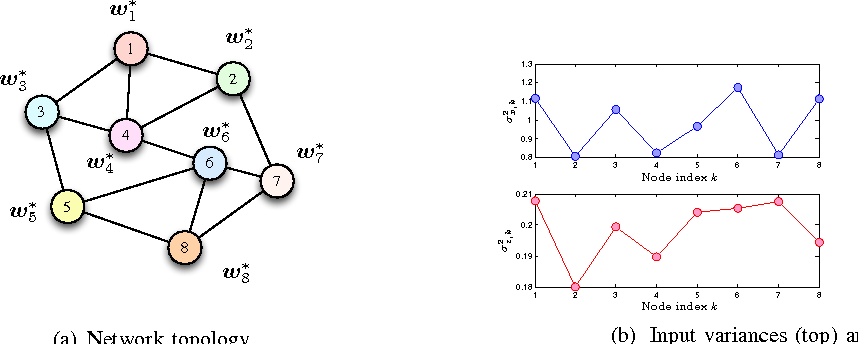
Figure 1 from Diffusion LMS Over Multitask Networks | Semantic Scholar

M2Diff: Multi-Modality Multi-Task Enhanced Diffusion Model for MRI ...

MoTe: Learning Motion-Text Diffusion Model for Multiple Generation Tasks