
Figure 1 From Multimodal Attention Fusion For Target Speaker Extraction

Figure 1 from Multimodal Attention Fusion for Target Speaker Extraction ...

Figure 2 from Multimodal Attention Fusion for Target Speaker Extraction ...

Figure 1 from Target Speaker Extraction with Attention Enhancement and ...
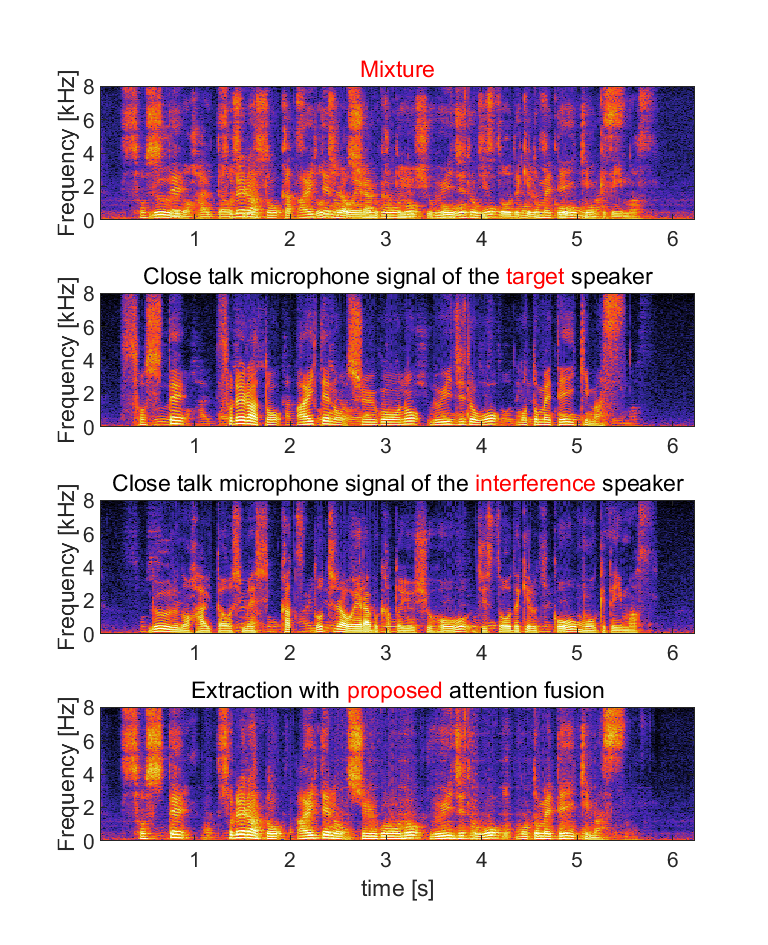
Multimodal Attention Fusion for Target Speaker Extraction
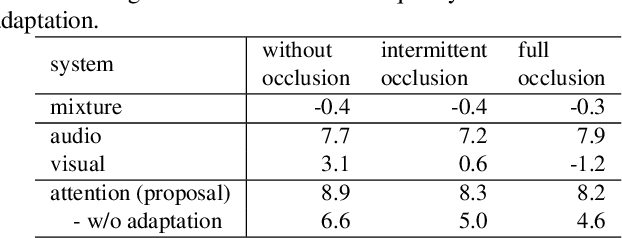
Multimodal Attention Fusion for Target Speaker Extraction

Figure 1 from Multi-level Attention Fusion for Multimodal Driving ...

Figure 1 from Binaural Selective Attention Model for Target Speaker ...

Multimodal Attention Fusion For Target Speaker Extraction | URC | IEEE ...

Figure 1 from Target Speaker Extraction for Multi-Talker Speaker ...

Multimodal Attention Fusion for Target Speaker Extraction | DeepAI
Advertisement Space (300x250)

Figure 1 from Cross-Modality Gated Attention Fusion for Multimodal ...

Figure 1 from A Multimodal Target Speech Extraction Algorithm Based on ...
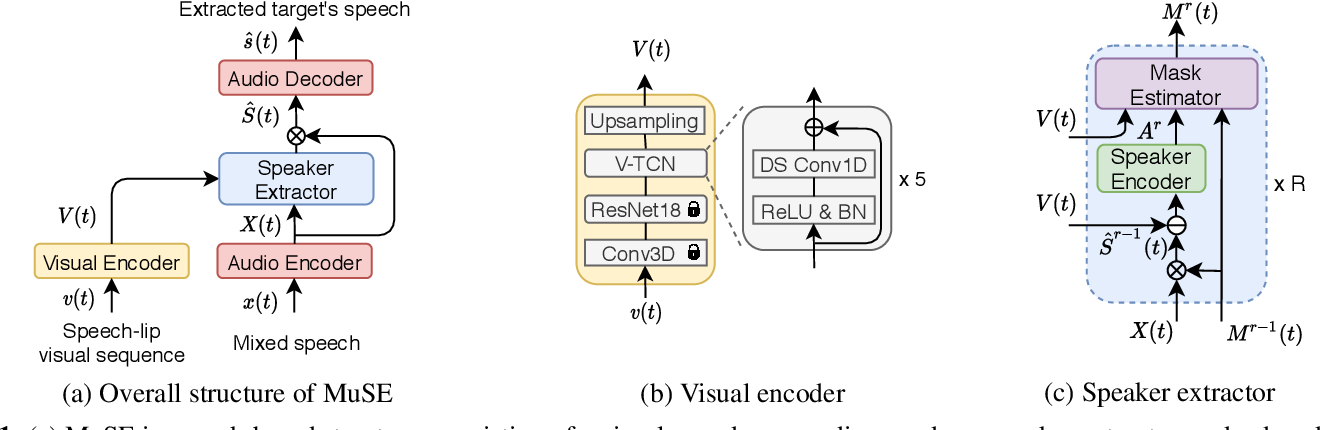
Figure 1 from Muse: Multi-Modal Target Speaker Extraction with Visual ...

Figure 1 from Audio-Visual Target Speaker Extraction with Reverse ...

Figure 1 from Audio-Visual Target Speaker Extraction with Reverse ...

Figure 1 from Audio-Visual Target Speaker Extraction with Reverse ...

Figure 1 from Sef-VIO: Self-attention-based Multimodal Fusion for ...
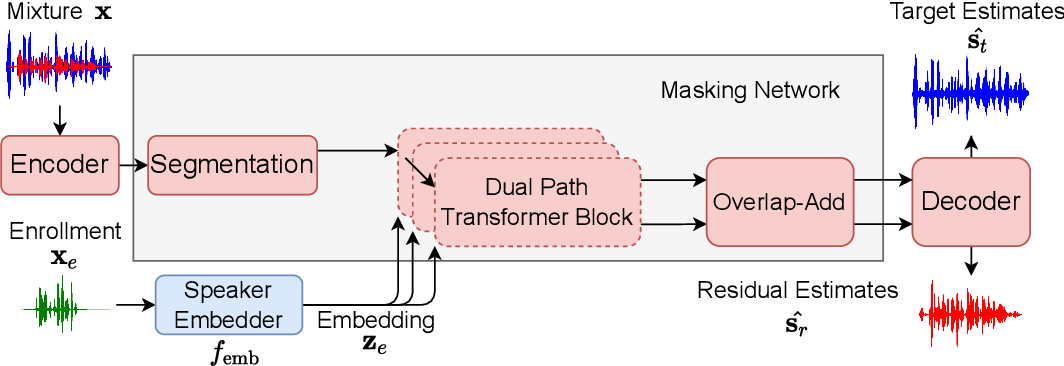
Figure 1 from Semi-supervised Time Domain Target Speaker Extraction ...

Figure 1 from Graph Reconstruction Attention Fusion Network for ...

Figure 2 from Target Speaker Extraction with Attention Enhancement and ...
Advertisement Space (336x280)

Figure 1 from Simultaneous Speech Extraction for Multiple Target ...
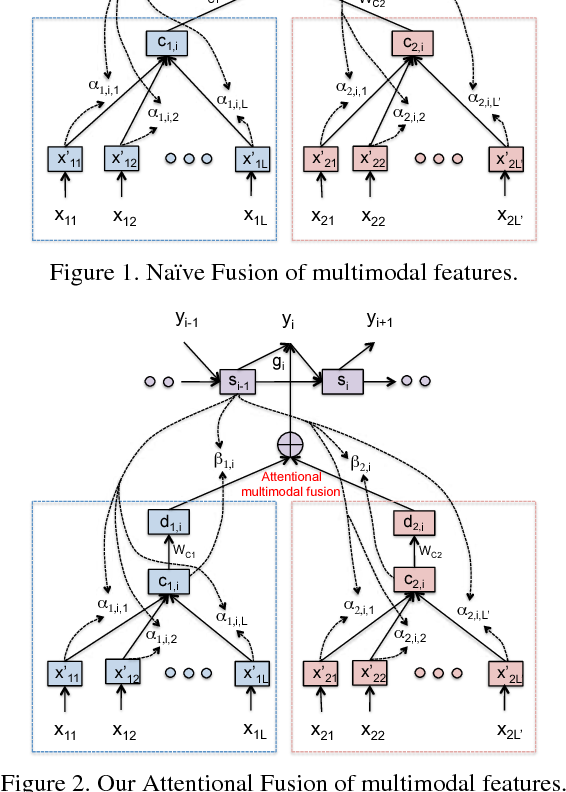
Figure 2 from Multimodal Attention for Fusion of Audio and ...
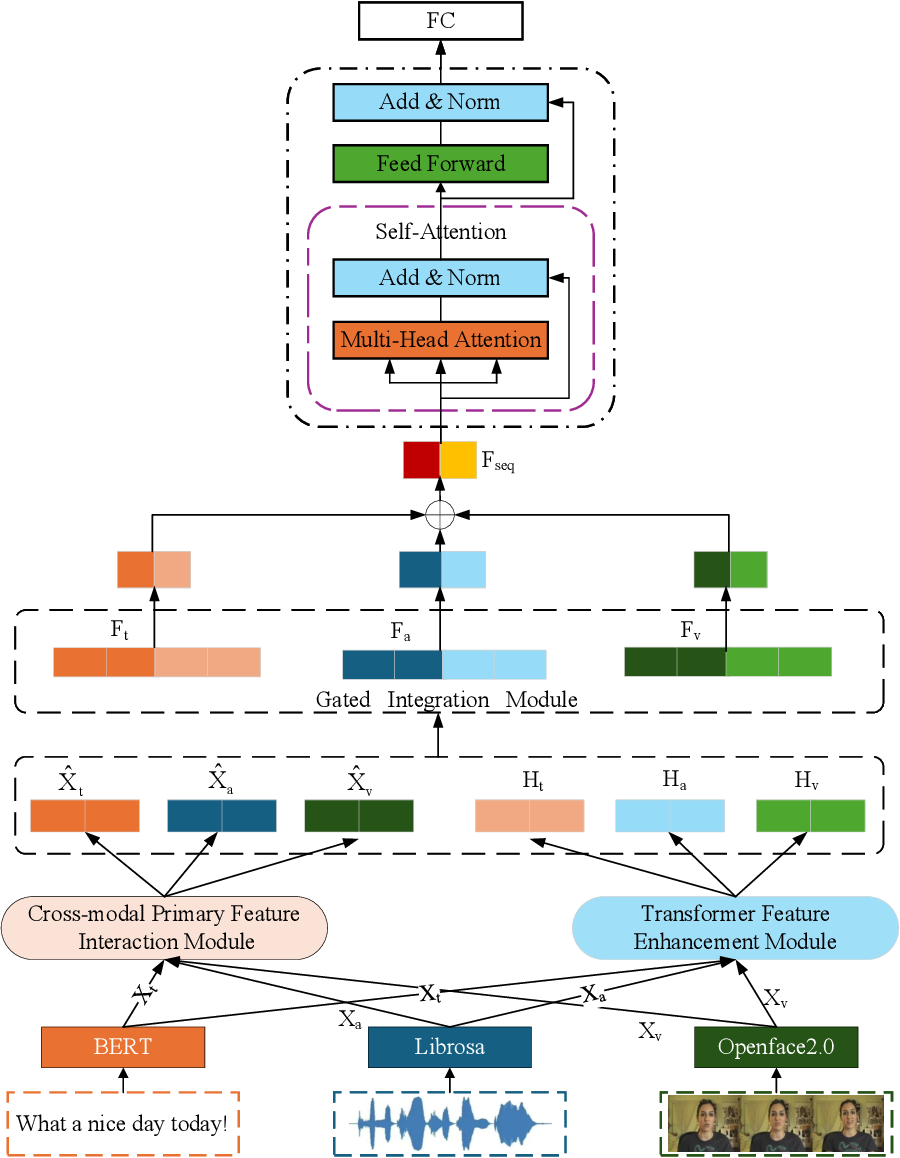
Figure 1 from Multilevel Feature Fusion and Attention Enhancement for ...

Figure 1 from Attentive Multimodal Fusion for Optical and Scene Flow ...
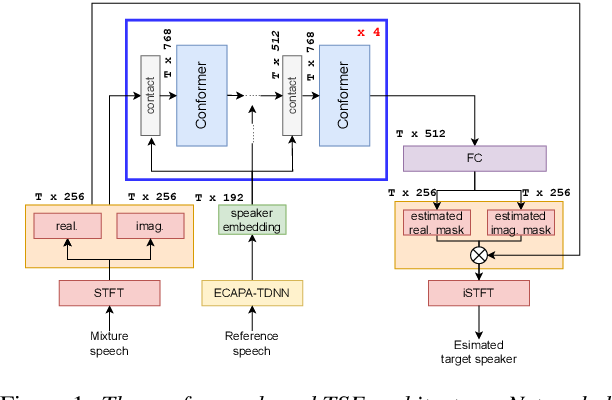
Figure 1 from Target Speaker Extraction with Curriculum Learning ...

Figure 1 from Multimodal Attention-Based Fusion Model for Context-Aware ...
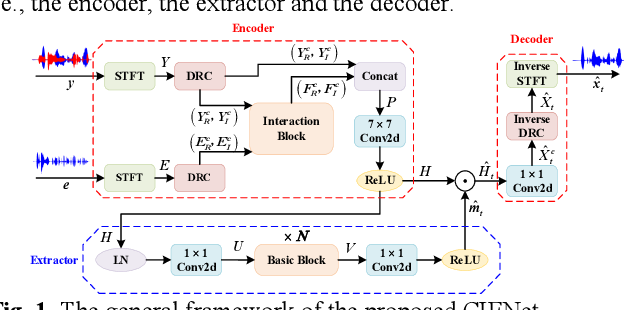
Figure 1 from Target Speaker Extraction by Directly Exploiting ...

Figure 2 from Cross-Modality Gated Attention Fusion for Multimodal ...
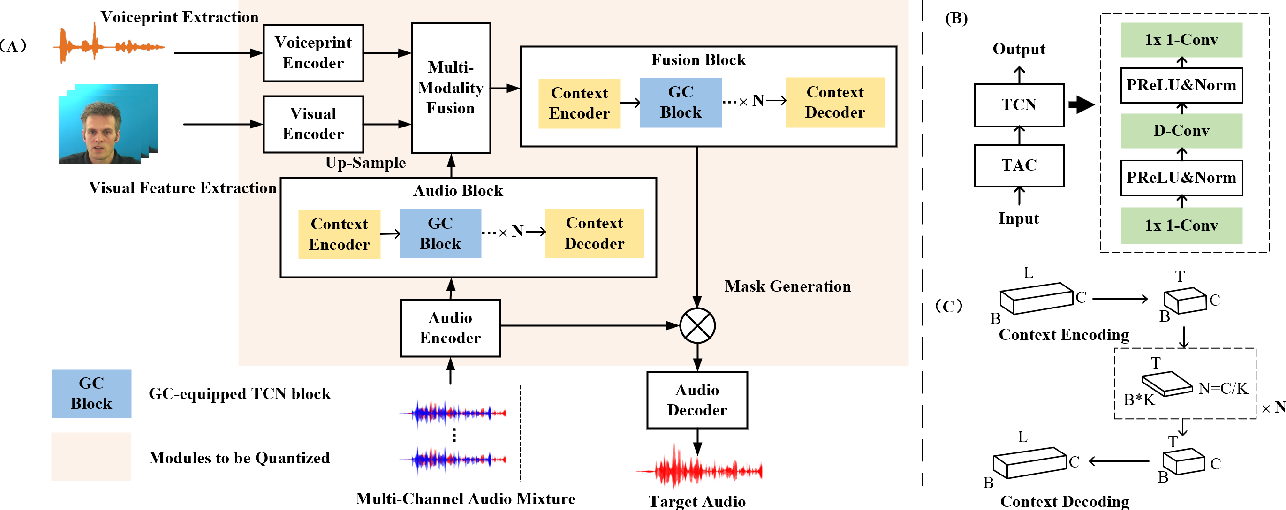
Figure 1 from LiMuSE: Lightweight Multi-Modal Speaker Extraction ...
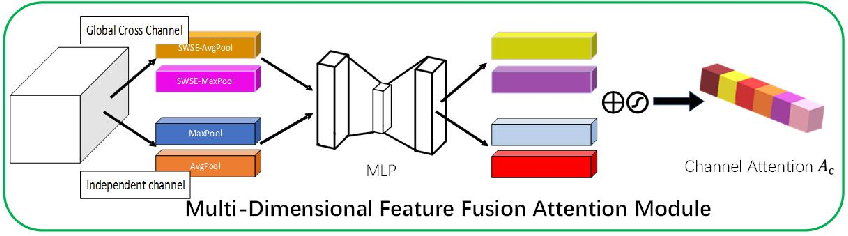
Figure 1 from Advanced Multi-Dimensional Feature Fusion Attention ...
Advertisement Space (336x280)

Figure 11 from Audio-Visual Target Speaker Extraction with Reverse ...
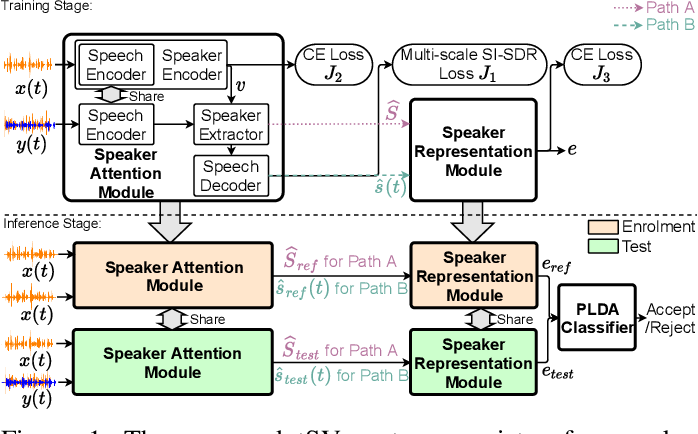
Figure 1 from Target Speaker Verification With Selective Auditory ...

Figure 1 from Domain-Separated Bottleneck Attention Fusion Framework ...
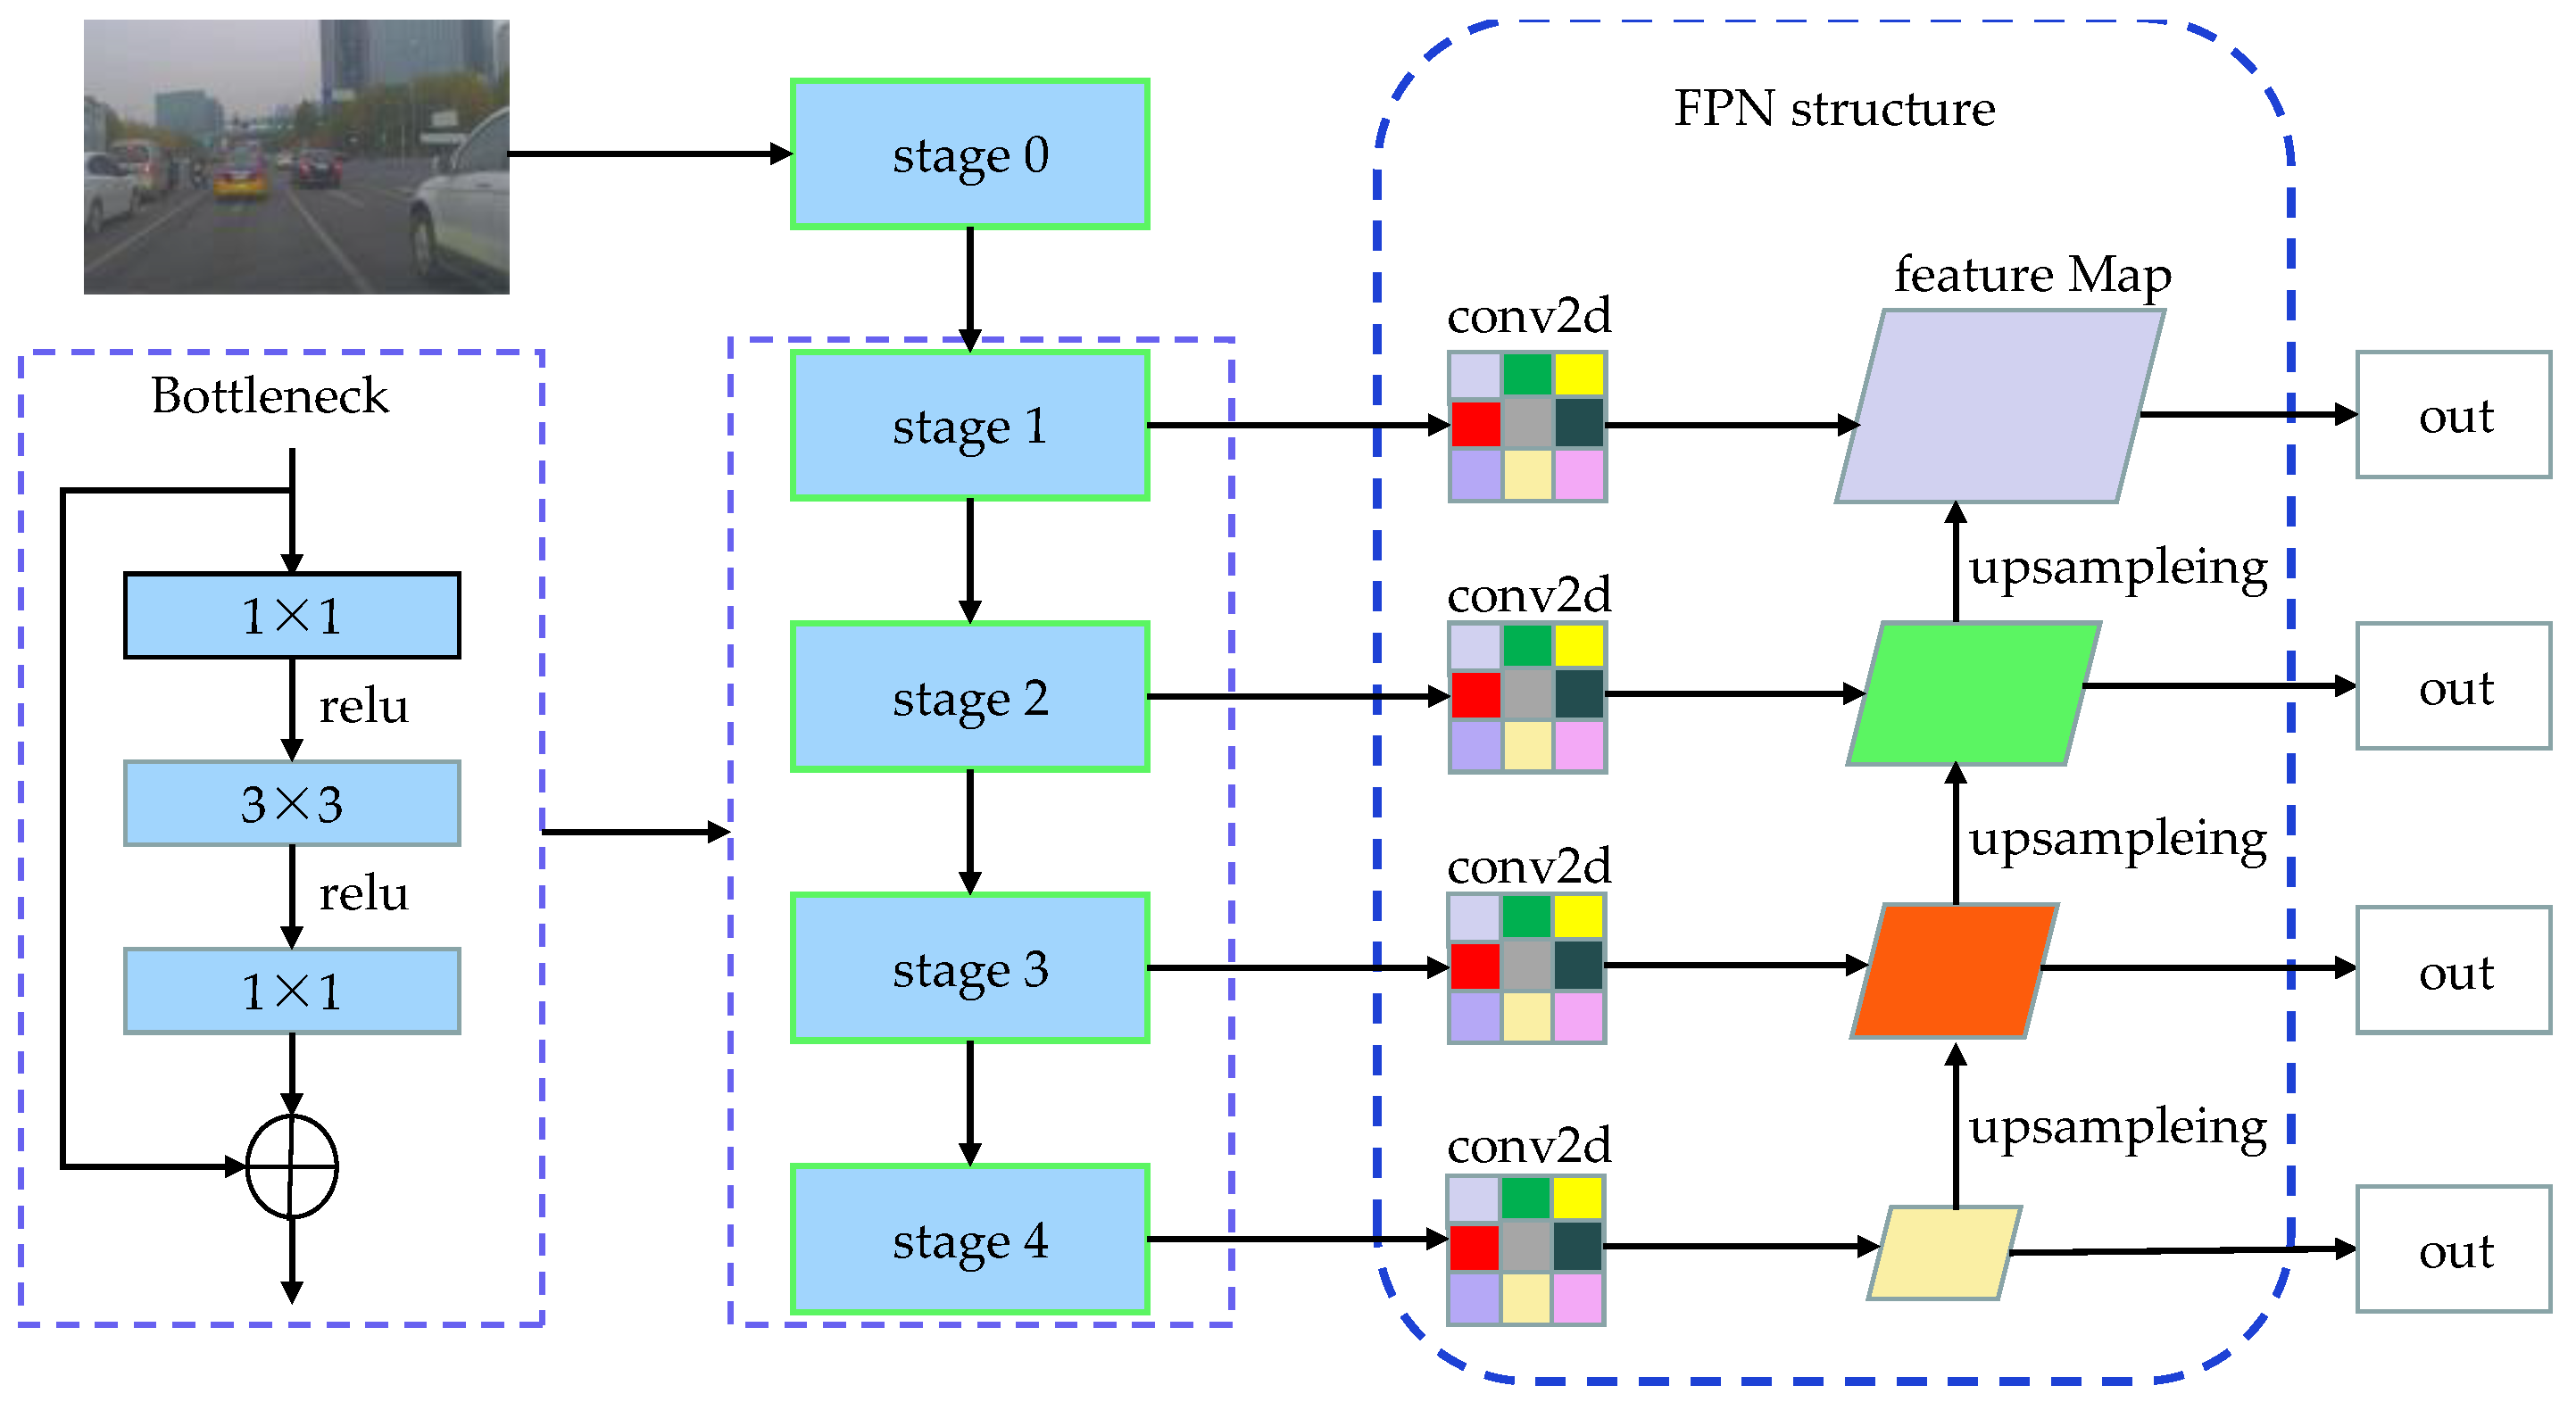
Multimodal Fusion with Multiple Attention Mechanisms for 3D Target ...
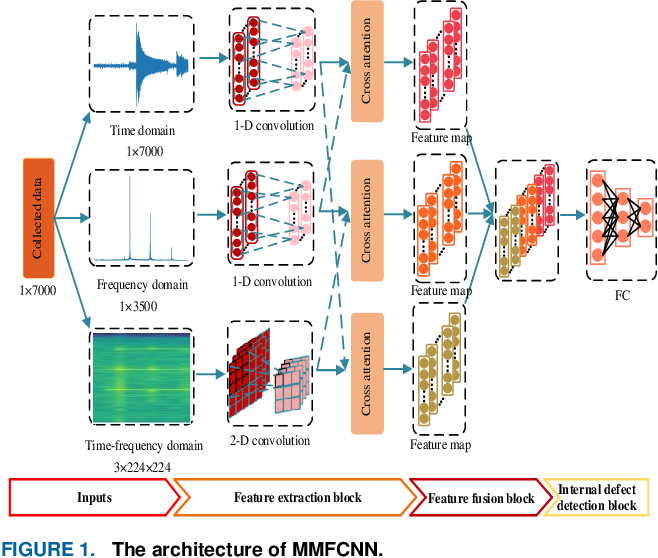
Figure 1 from Multimodal Fusion Convolutional Neural Network with Cross ...

Figure 1 from Attention-based Multimodal Fusion with Adversarial ...