
Figure 1 From Multitask Learning For Cross Domain Image Captioning
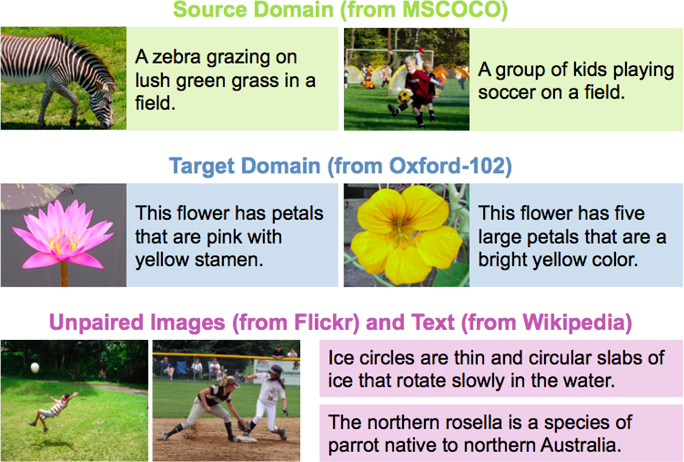
Figure 1 from Multitask Learning for Cross-Domain Image Captioning ...

Figure 1 from Transformer based Multitask Learning for Image Captioning ...
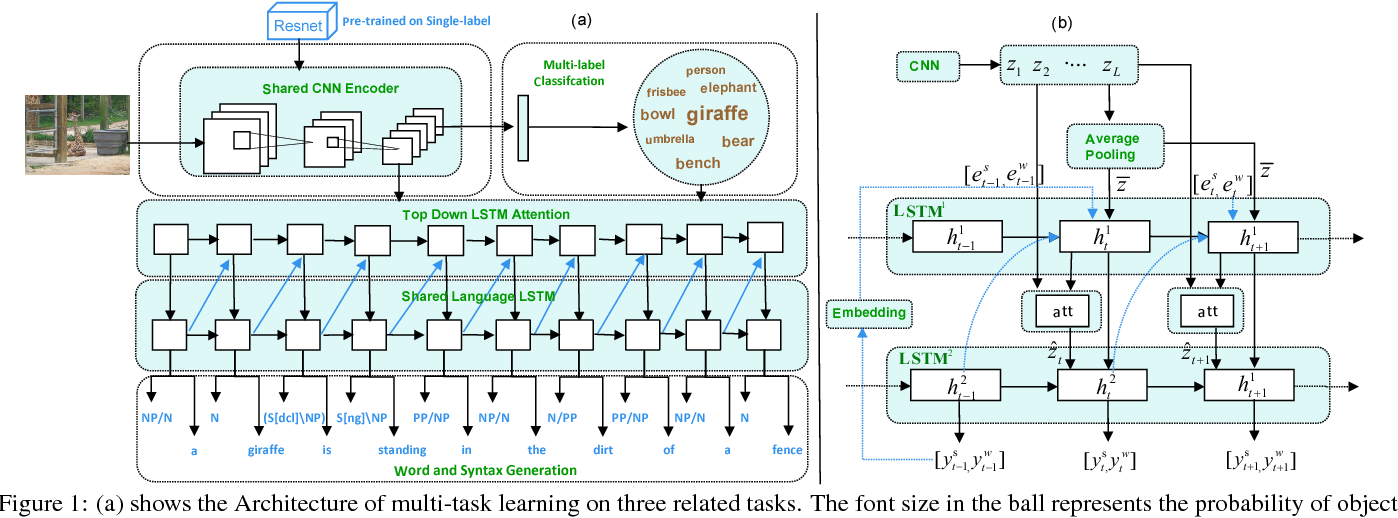
Figure 1 from A Multi-task Learning Approach for Image Captioning ...

Figure 1 from Multi-task learning for captioning images with novel ...
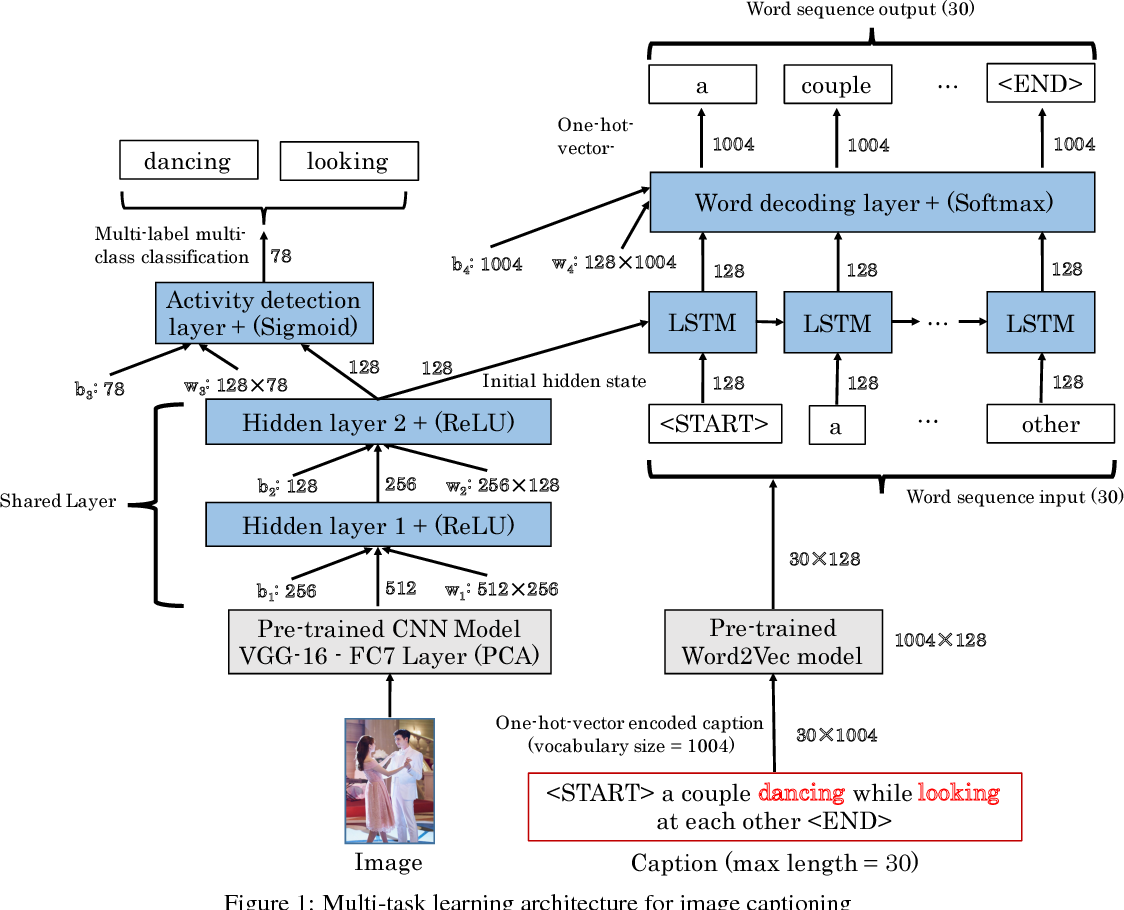
Figure 1 from Automatic image captioning using multi-task learning ...

Figure 1 from A Multitask Learning Encoder-Decoders Framework for ...

Figure 1 from A Review of Deep Learning for Video Captioning | Semantic ...
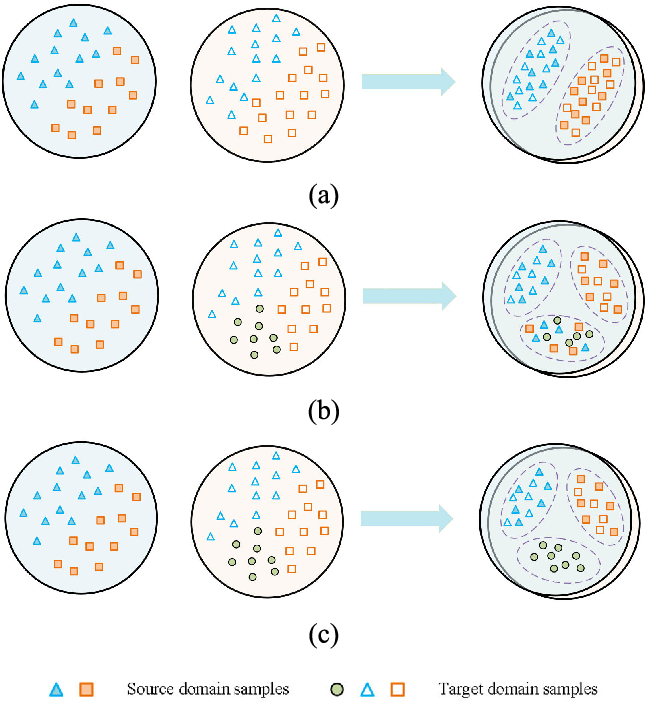
Figure 1 from Domain Adaptation With Multi-Adversarial Learning for ...

Figure 1 from Sparse Multitask Learning for Efficient Neural ...
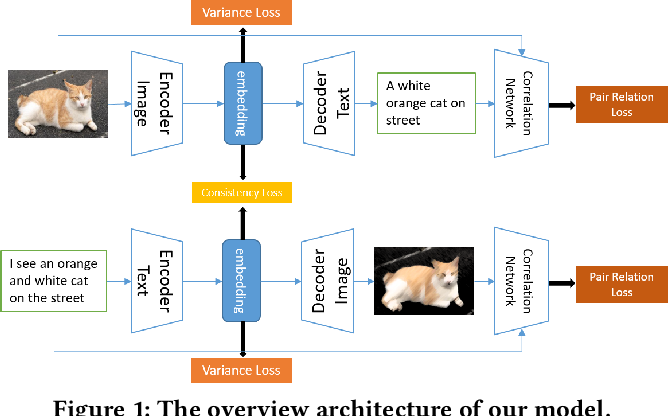
Figure 1 from Cross-modal Image-Text Retrieval with Multitask Learning ...
Advertisement Space (300x250)
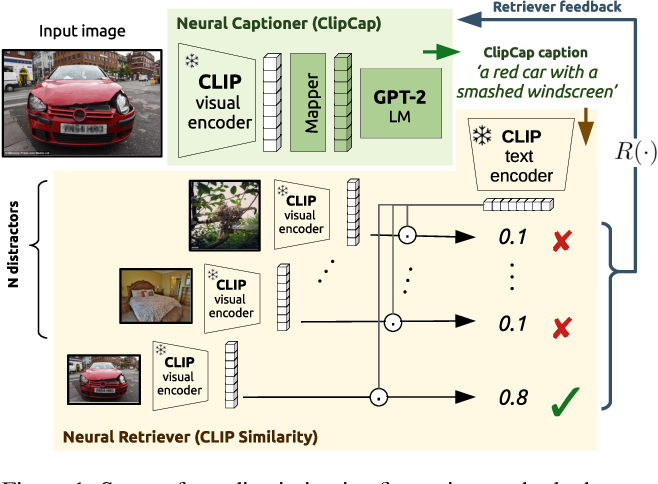
Figure 1 from Cross-Domain Image Captioning with Discriminative ...

Figure 1 from Sequential Cross Attention Based Multi-Task Learning ...

Figure 1 from Cross-Domain Modality Fusion for Dense Video Captioning ...

Figure 1 from Cross-Domain Multi-task Learning for Object Detection and ...
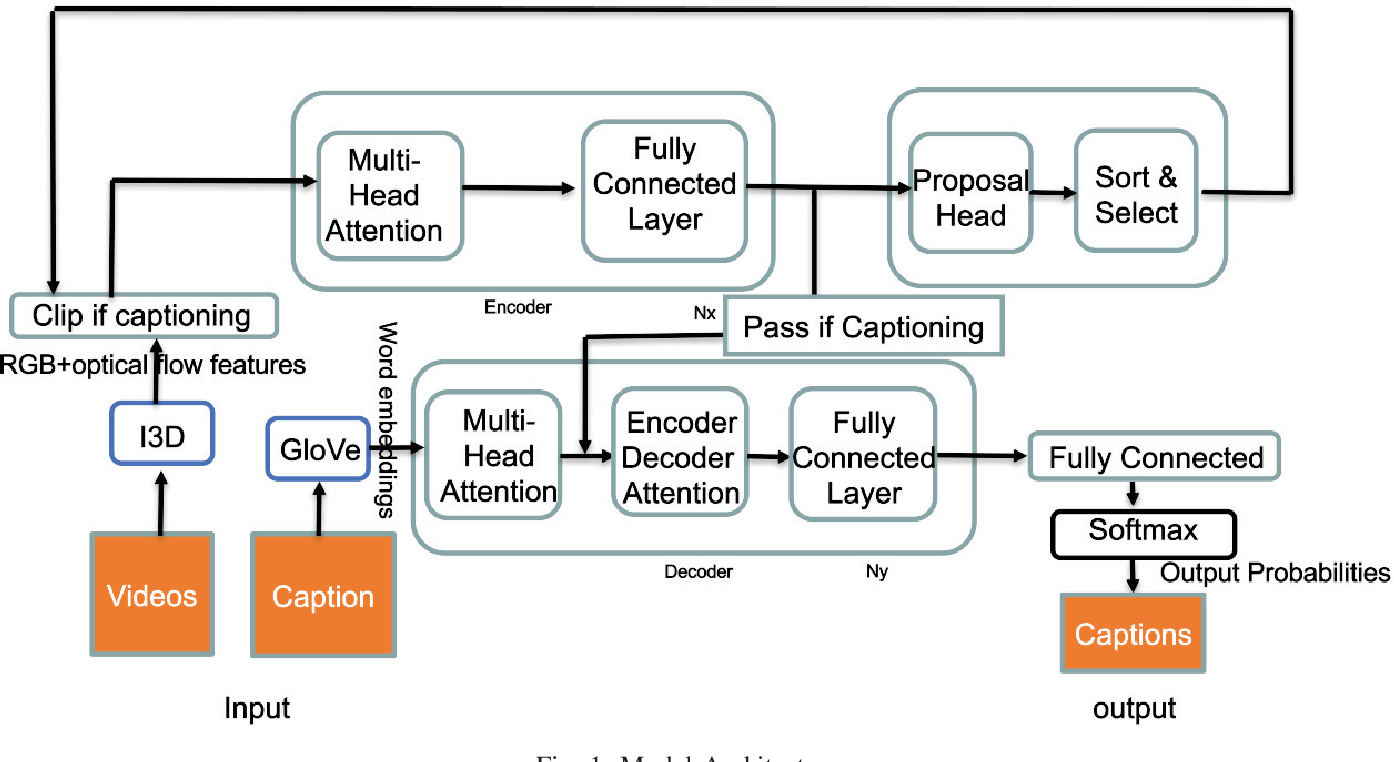
Figure 1 from Video Captioning using Deep Learning and NLP to Detect ...

Figure 1 from Integrating Contrastive Learning into a Multitask ...

Figure 1 from Deep Learning Based Captioning of Toys in a Smart ...

Figure 1 from Cross-Modal Supervision-Based Multitask Learning With ...
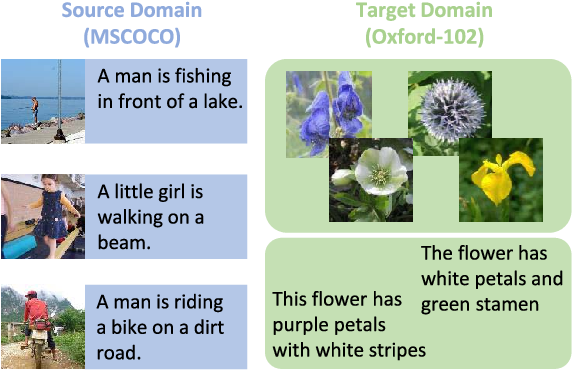
Figure 1 from Cross-Domain Image Captioning via Cross-Modal Retrieval ...

Figure 1 from Cross-Modal Graph With Meta Concepts for Video Captioning ...
Advertisement Space (336x280)

Figure 2 from Prototype-Guided Multitask Adversarial Network for Cross ...

Figure 1 from Unsupervised Cross-lingual Image Captioning | Semantic ...
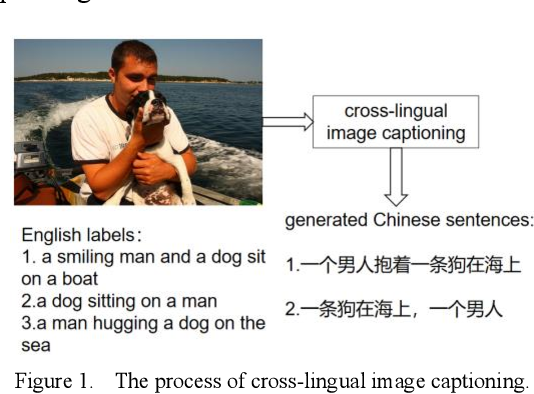
Figure 1 from An Improved Method of Cross-Lingual Image Captioning ...

Figure 1 from Multi-task learning from Unlabelled Data to Improve Cross ...

Figure 1 from Cross-Domain Multitask Model for Head Detection and ...

Figure 1 from Boosted Multifeature Learning for Cross-Domain Transfer ...

Figure 1 from Spatial Cross-Attention for Transformer-Based Image ...

Figure 1 from Multi-graph Convolutional Feature Transfer for Cross ...
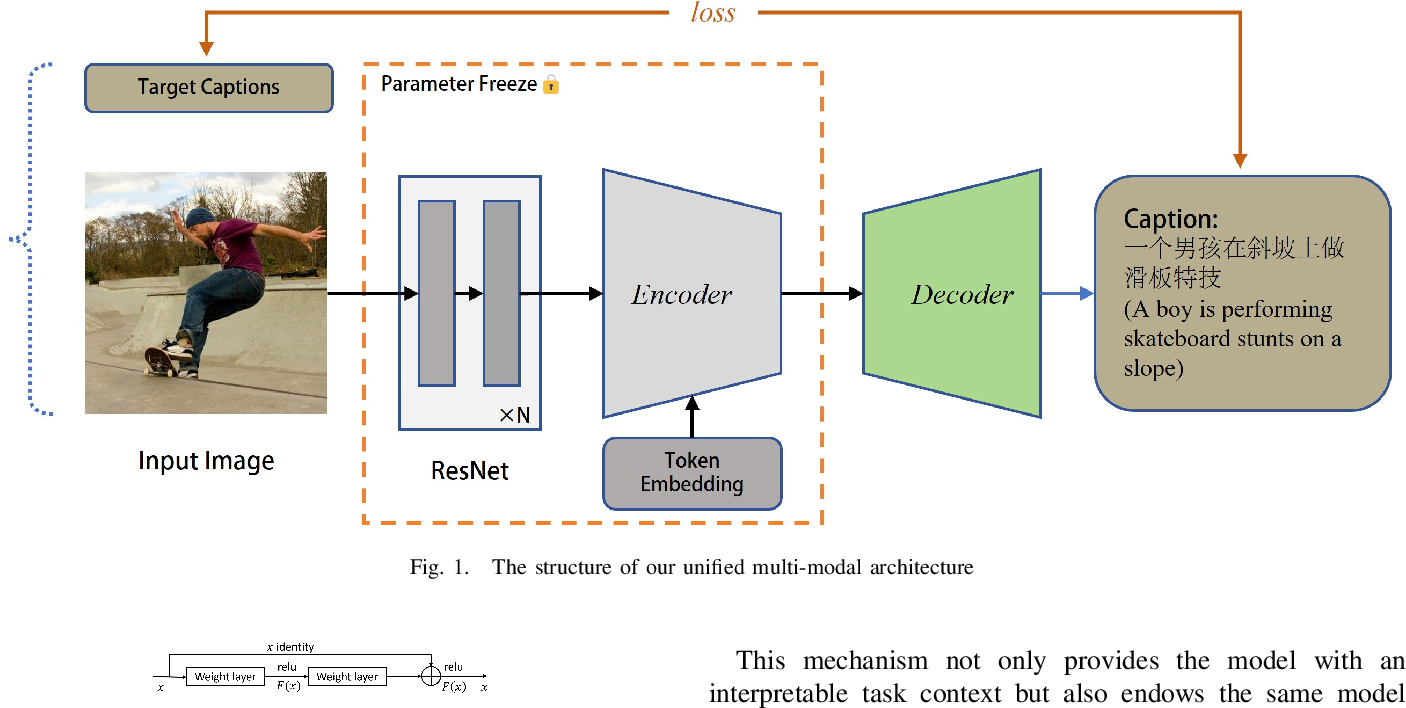
Figure 1 from Lightweight Multi-Model Based Document Image Captioning ...
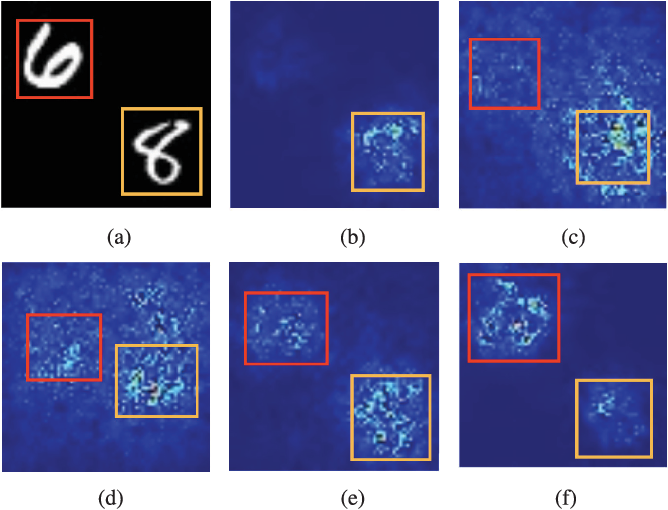
Figure 1 from Multitask Causal Contrastive Learning | Semantic Scholar
Advertisement Space (336x280)

Figure 1 from Video Captioning via Relation-Aware Graph Learning ...

Figure 1 from Cross-task Attention Mechanism for Dense Multi-task ...

(PDF) Dual Learning for Cross-domain Image Captioning
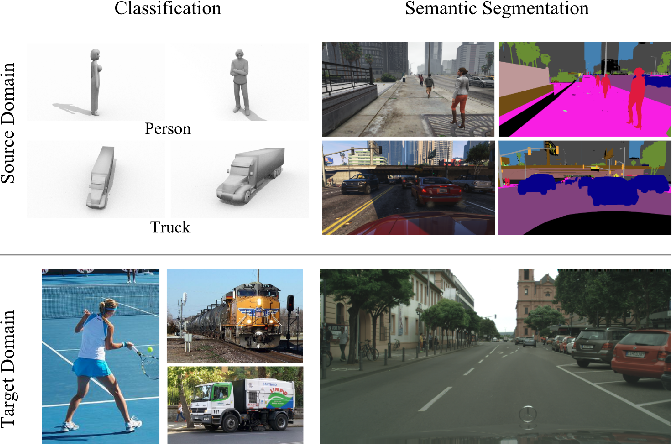
Figure 1 from Unsupervised Multi-Task Domain Adaptation | Semantic Scholar

Figure 1 from Learning Unsupervised Cross-domain Image-to-Image ...

(PDF) Dual Learning for Cross-domain Image Captioning