
Figure 1 From Patchmixing Masked Autoencoders For 3d Point Cloud Self
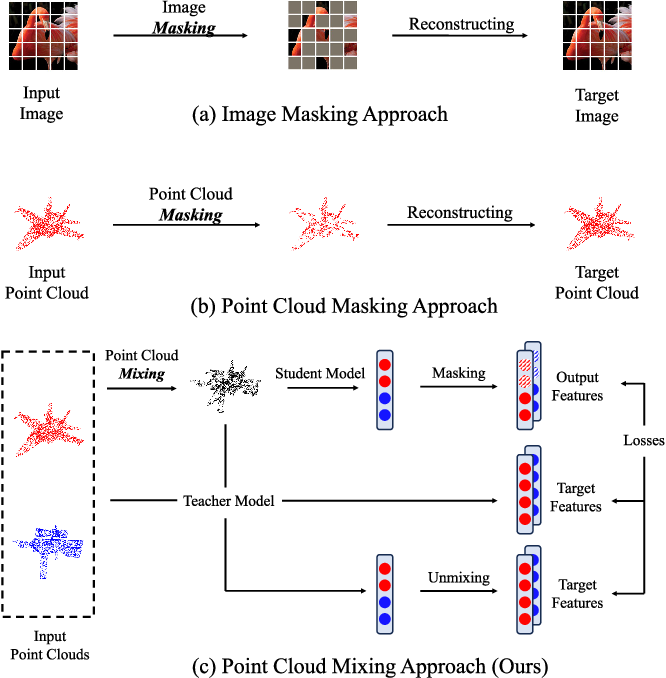
Figure 1 from PatchMixing Masked Autoencoders for 3D Point Cloud Self ...
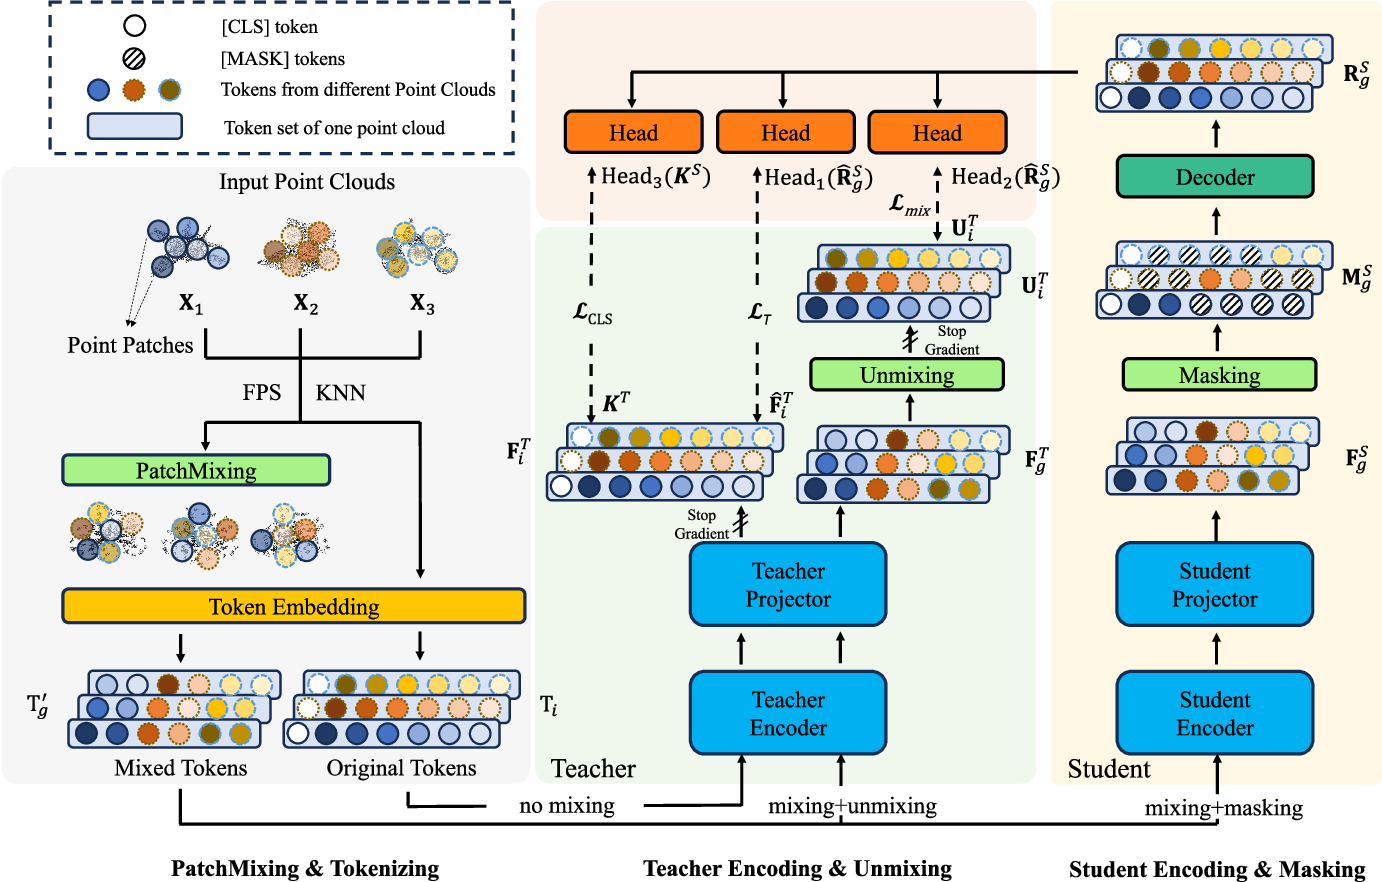
Figure 3 from PatchMixing Masked Autoencoders for 3D Point Cloud Self ...

Figure 4 from PatchMixing Masked Autoencoders for 3D Point Cloud Self ...

Figure 2 from PatchMixing Masked Autoencoders for 3D Point Cloud Self ...

Figure 1 from Masked Autoencoders for Point Cloud Self-supervised ...
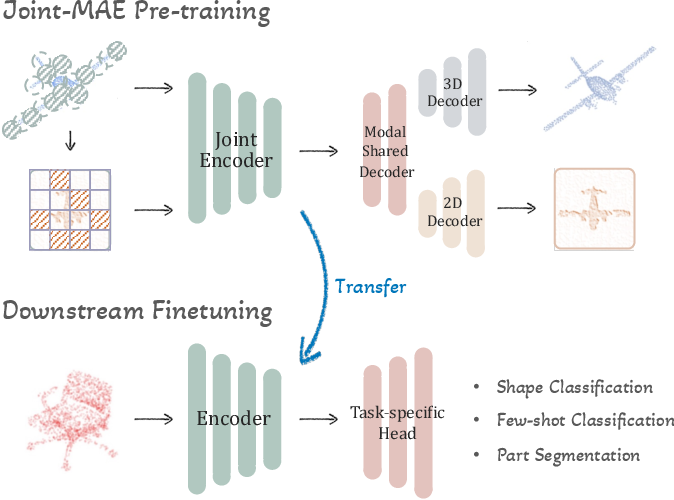
Figure 1 from Joint-MAE: 2D-3D Joint Masked Autoencoders for 3D Point ...

Figure 1 from Masked Autoencoders in 3D Point Cloud Representation ...

Figure 3 from Masked Autoencoders in 3D Point Cloud Representation ...

Figure 3 from Masked Autoencoders for Point Cloud Self-supervised ...

Figure 2 from DiffPMAE: Diffusion Masked Autoencoders for Point Cloud ...
Advertisement Space (300x250)

Figure 6 from Masked Autoencoders in 3D Point Cloud Representation ...

Figure 1 from BEV-MAE: Bird's Eye View Masked Autoencoders for Point ...

Figure 2 from Masked Autoencoders in 3D Point Cloud Representation ...

Figure 1 from Scene Graph Masked Variational Autoencoders for 3D Scene ...

Figure 1 from Self Pre-Training with Masked Autoencoders for Medical ...

Figure 1 from Point Cloud Self-supervised Learning via 3D to Multi-view ...

Figure 1 from Masked Autoencoders for Self-Supervised Learning on ...

Figure 1 from PiMAE: Point Cloud and Image Interactive Masked ...
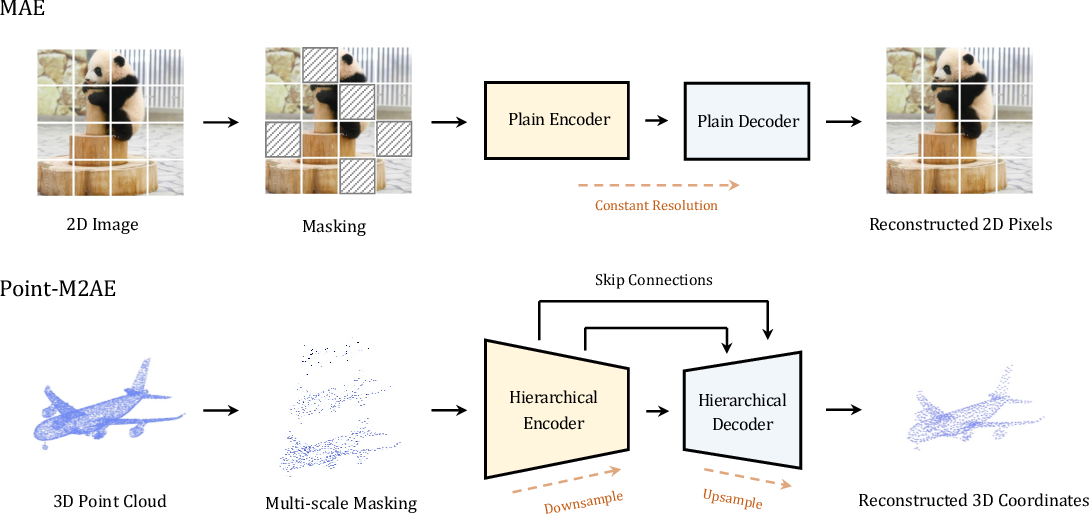
Figure 1 from Point-M2AE: Multi-scale Masked Autoencoders for ...

Figure 1 from 3D Feature Prediction for Masked-AutoEncoder-Based Point ...
Advertisement Space (336x280)
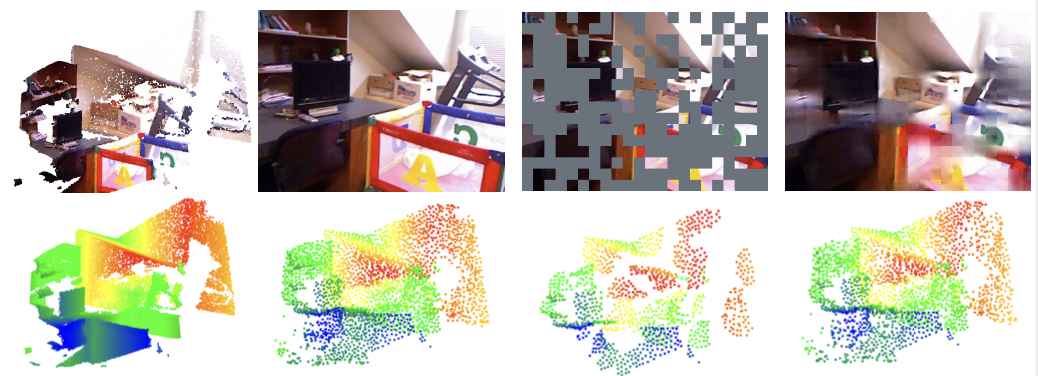
PiMAE: Point cloud and Image Interactive Masked Autoencoders for 3D ...
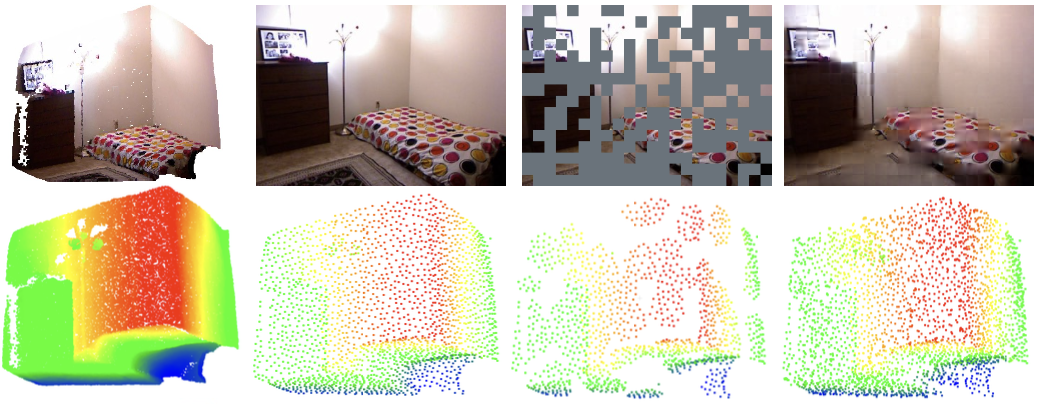
PiMAE: Point cloud and Image Interactive Masked Autoencoders for 3D ...
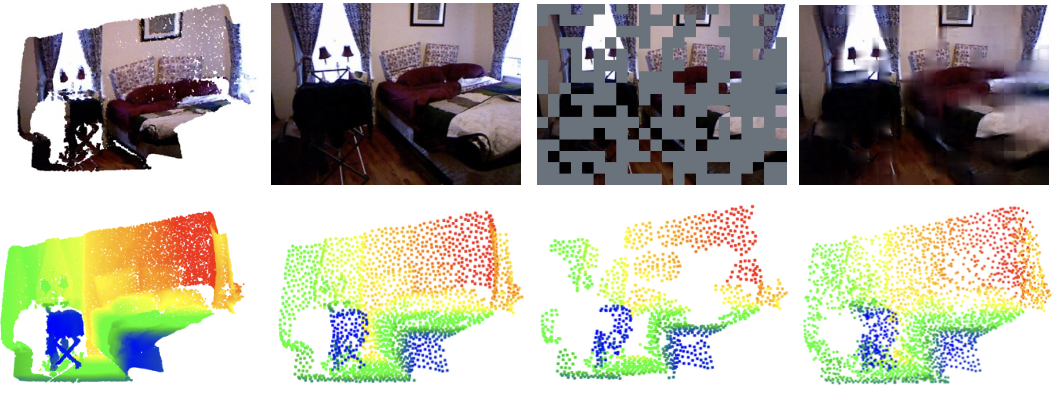
PiMAE: Point cloud and Image Interactive Masked Autoencoders for 3D ...
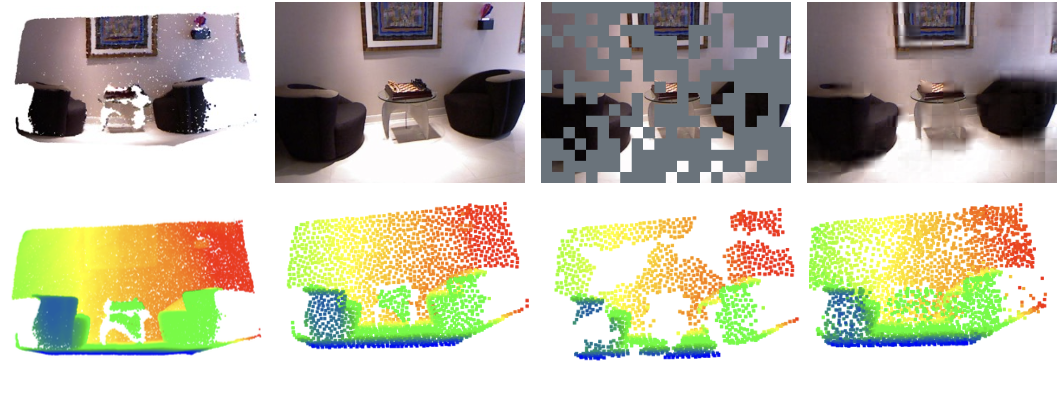
PiMAE: Point cloud and Image Interactive Masked Autoencoders for 3D ...
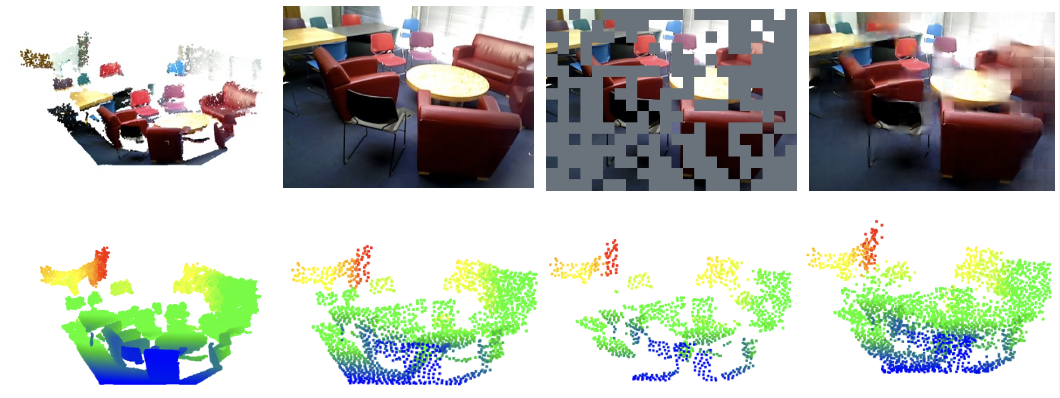
PiMAE: Point cloud and Image Interactive Masked Autoencoders for 3D ...
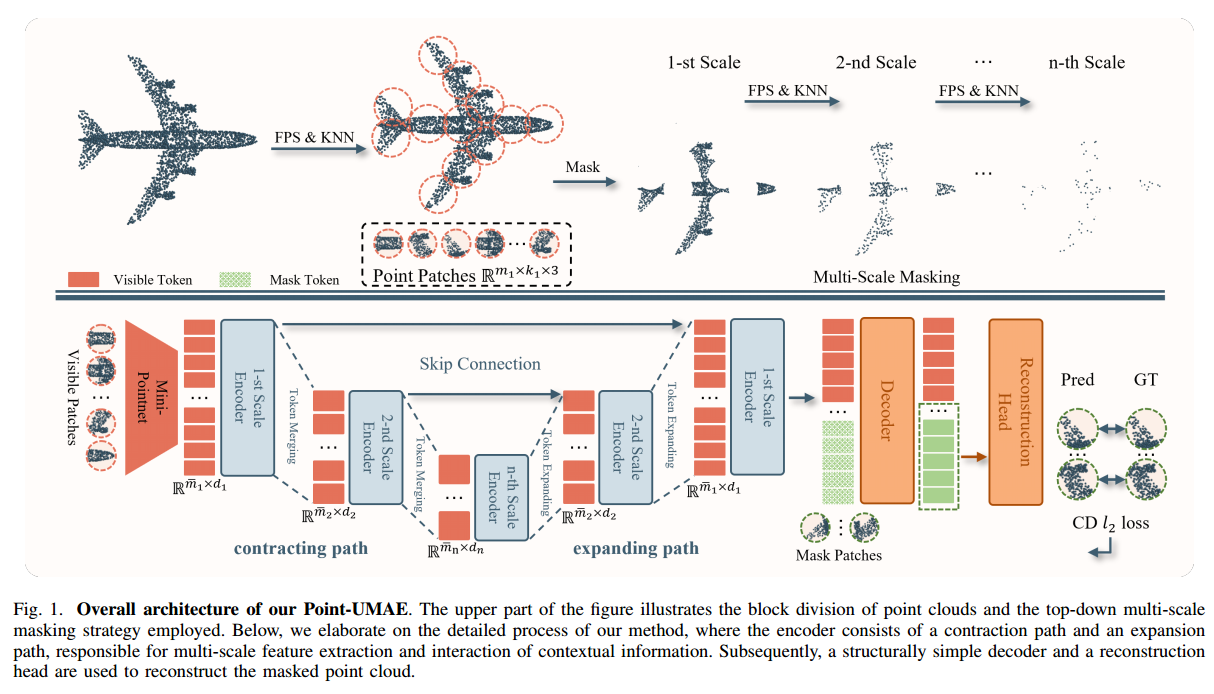
Point-UMAE: Unet-like Masked Autoencoders for Point Cloud Self ...

Figure 1 from Self Pre-Training with Adaptive Mask Autoencoders for ...

Figure 1 from Voxel-MAE: Masked Autoencoders for Pre-training Large ...
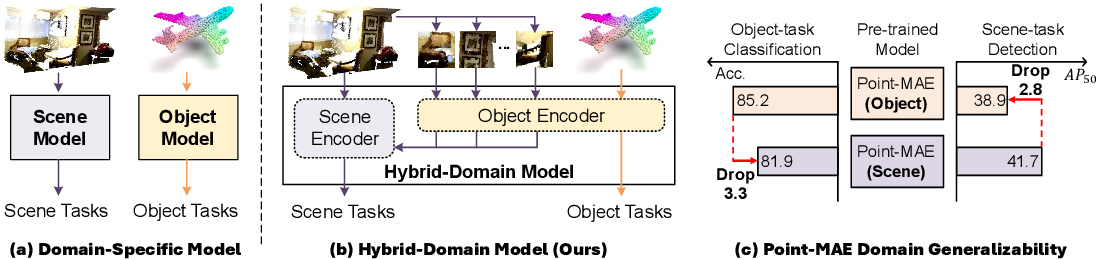
Figure 1 from Block-to-Scene Pre-training for Point Cloud Hybrid-Domain ...

Table I from Masked Autoencoders in 3D Point Cloud Representation ...
Advertisement Space (336x280)
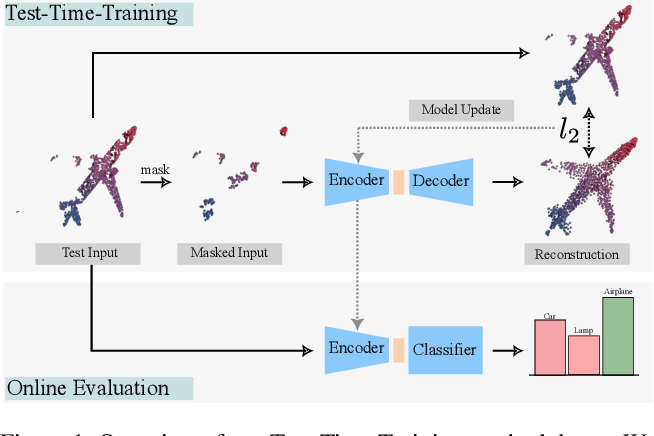
Figure 1 from MATE: Masked Autoencoders are Online 3D Test-Time ...

Figure 1 from Masked Autoencoders for Unsupervised Anomaly Detection in ...

Figure 1 from Self-Supervised Learning with Masked Autoencoders for ...

Figure 1 from CMAE-V: Contrastive Masked Autoencoders for Video Action ...

Table II from Masked Autoencoders in 3D Point Cloud Representation ...

[2022] Masked Autoencoders for Point Cloud Self-supervised Learning - 知乎