
Figure 1 From Pose Guided Modality Invariant Feature Alignment For

Figure 1 from Pose-Guided Modality-Invariant Feature Alignment for ...

Figure 1 from Pose and Expression Invariant Alignment based Multi-View ...
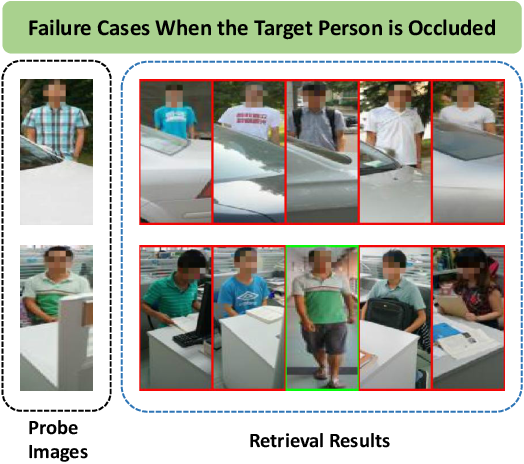
Figure 1 from Pose-Guided Feature Alignment for Occluded Person Re ...

Figure 1 from Learning a High Fidelity Pose Invariant Model for High ...

Figure 1 from Enhanced Invariant Feature Joint Learning via Modality ...

Figure 1 from Fusional Modality and Distribution Alignment Learning for ...
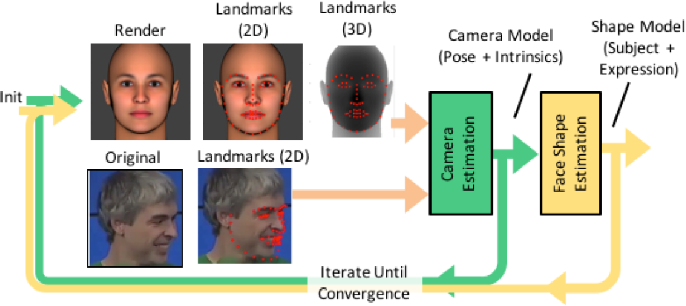
Figure 1 from Dataset Augmentation for Pose and Lighting Invariant Face ...

Figure 1 from View-invariant Feature using Pose Information and ...
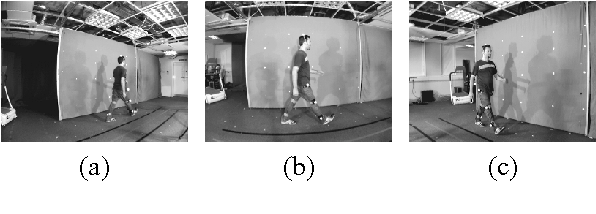
Figure 1 from Towards pose invariant gait reconstruction | Semantic Scholar

Figure 1 from Temporal Feature Alignment and Mutual Information ...
Advertisement Space (300x250)

Figure 2 from Pose-Guided Modality-Invariant Feature Alignment for ...

Figure 4 from Pose-Guided Modality-Invariant Feature Alignment for ...

Figure 1 from Improving Cross-modal Alignment for Text-Guided Image ...

Figure 1 from Modality-Adaptive Mixup and Invariant Decomposition for ...

Figure 5 from Pose-Guided Modality-Invariant Feature Alignment for ...
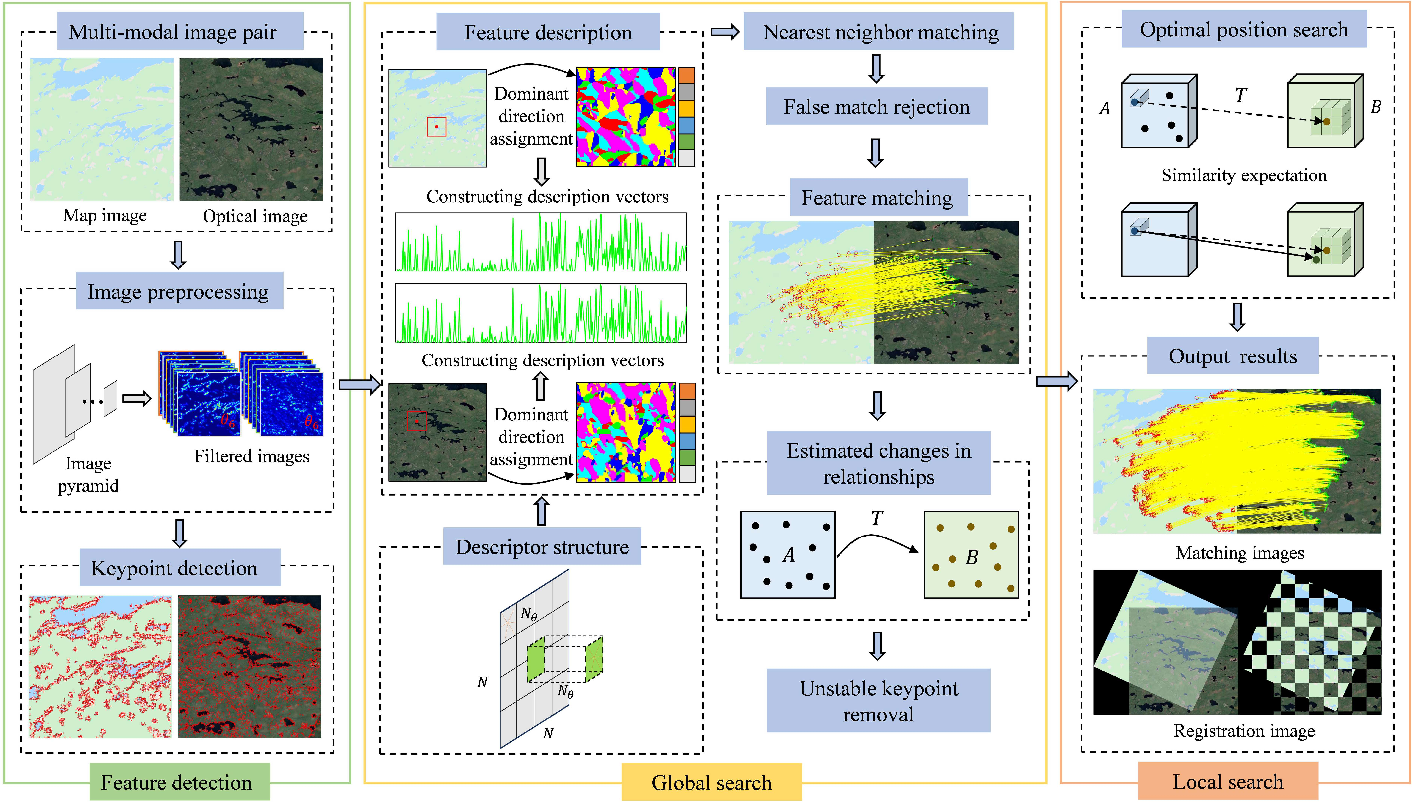
Figure 1 from GLIFT: A Global-to-Local Invariant Feature Transformation ...

Figure 3 from Pose-Guided Modality-Invariant Feature Alignment for ...
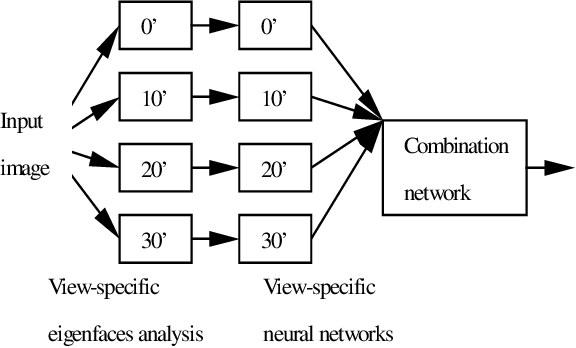
Figure 1 from Pose invariant face recognition | Semantic Scholar

Figure 1 from ENHANCING SECURITY USING POSE INVARIANT TECHNIQUE WITH ...

Figure 1 from Dual-alignment Feature Embedding for Cross-modality ...
Advertisement Space (336x280)

Figure 1 from Domain-Invariant Feature Alignment Using Variational ...

Figure 1 from Learning Invariant Representation via Contrastive Feature ...

Figure 2 from Enhanced Invariant Feature Joint Learning via Modality ...

Figure 1 from Domain-Invariant Feature Alignment Using Variational ...

Figure 1 from Learning Clothing and Pose Invariant 3D Shape ...

Figure 6 from Enhanced Invariant Feature Joint Learning via Modality ...

Figure 1 from Modality Invariant Multimodal Learning to Handle Missing ...

Figure 1 from The Application of Improved Scale Invariant Feature ...

Figure 1 from Modality-Invariant Structural Feature Representation for ...

Figure 1 from Dual-alignment Feature Embedding for Cross-modality ...
Advertisement Space (336x280)

Figure 1 from Modality Invariant Multimodal Learning to Handle Missing ...
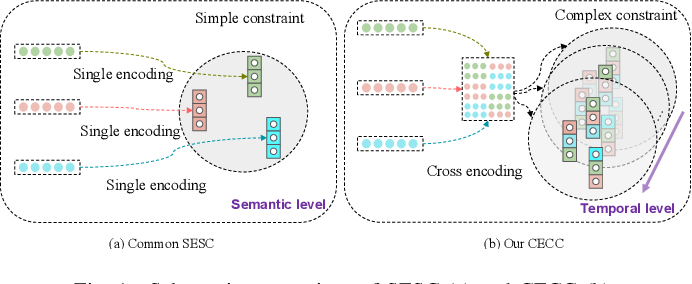
Figure 1 from Temporal Invariant Feature Combined with Arbitrary ...

Figure 1 from Pose-Invariant 3D Face Alignment | Semantic Scholar

Figure 1 from Modality-invariant and Specific Prompting for Multimodal ...

Figure 1 from GDA: Geometry-Guided Dual-Alignment Learning for RGB ...

Figure 3 from View-invariant Feature using Pose Information and ...