
Figure 1 From Preconditioned Gradient Descent For Overparameterized

Figure 1 from Preconditioned Gradient Descent for Overparameterized ...

Figure 1 from Preconditioned Gradient Descent for Over-Parameterized ...

Figure 1 from Preconditioned Gradient Descent for Over-Parameterized ...
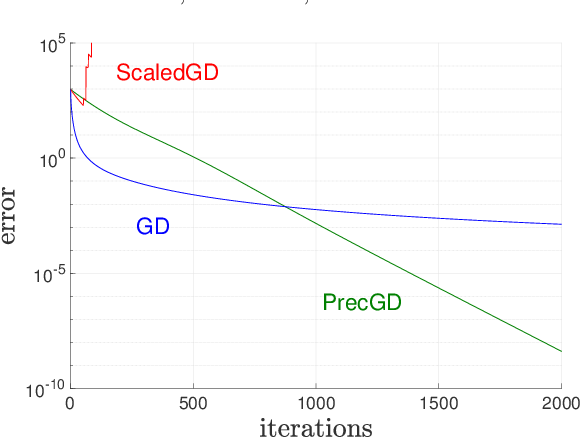
Figure 3 from Preconditioned Gradient Descent for Overparameterized ...

Figure 1 from Preconditioned Gradient Descent Algorithm for Inverse ...
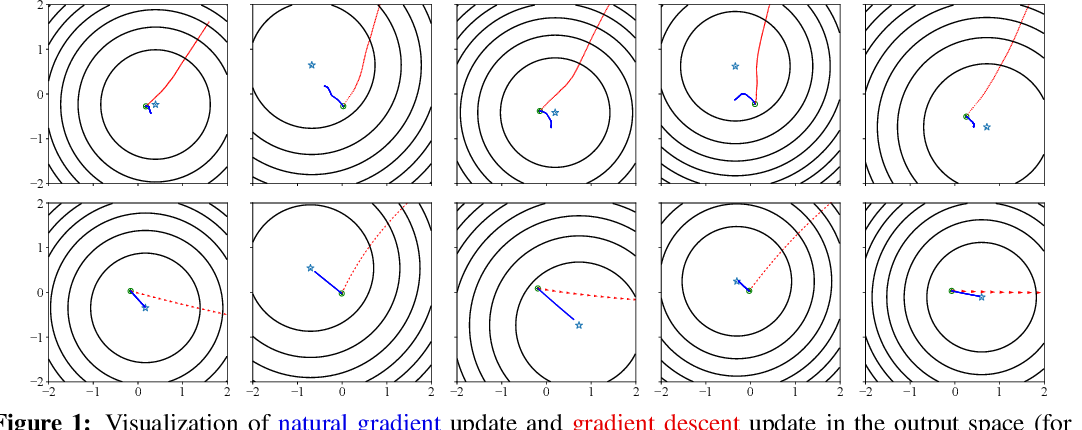
Figure 1 from Fast Convergence of Natural Gradient Descent for ...
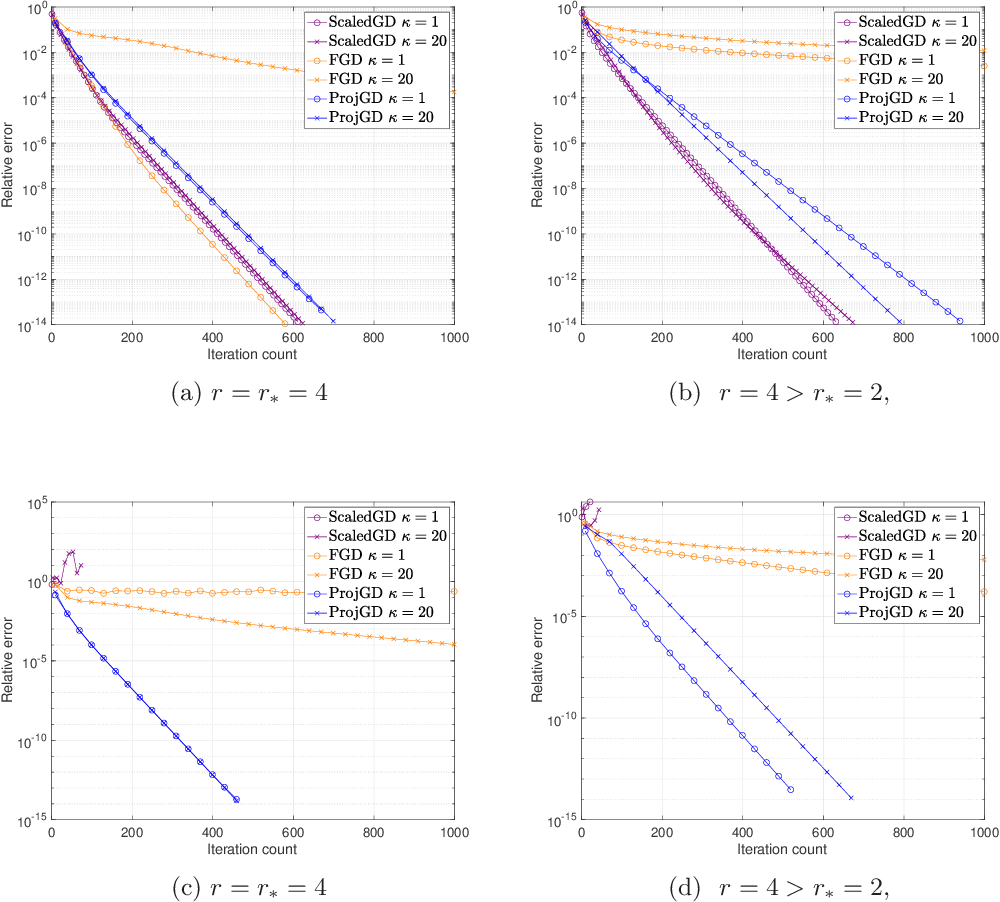
Figure 1 from Projected Gradient Descent Algorithm for Low-Rank Matrix ...
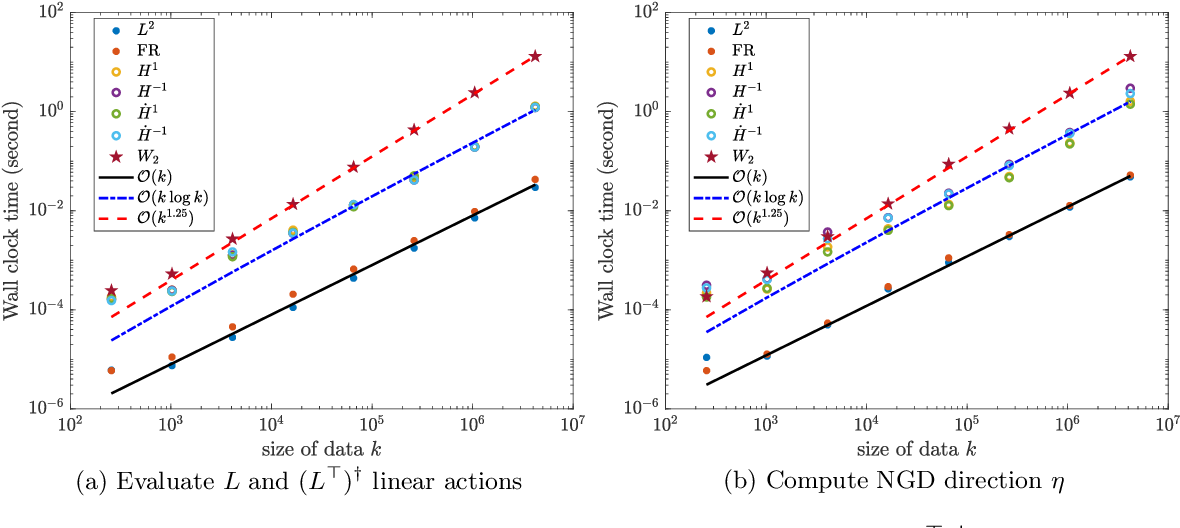
Figure 1 from Efficient Natural Gradient Descent Methods for Large ...
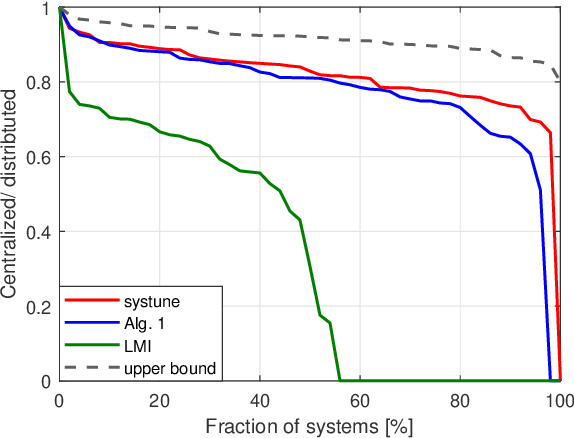
Figure 1 from A Gradient Descent Method for Finite Horizon Distributed ...

Preconditioned Gradient Descent for Overparameterized Nonconvex Burer ...
Advertisement Space (300x250)
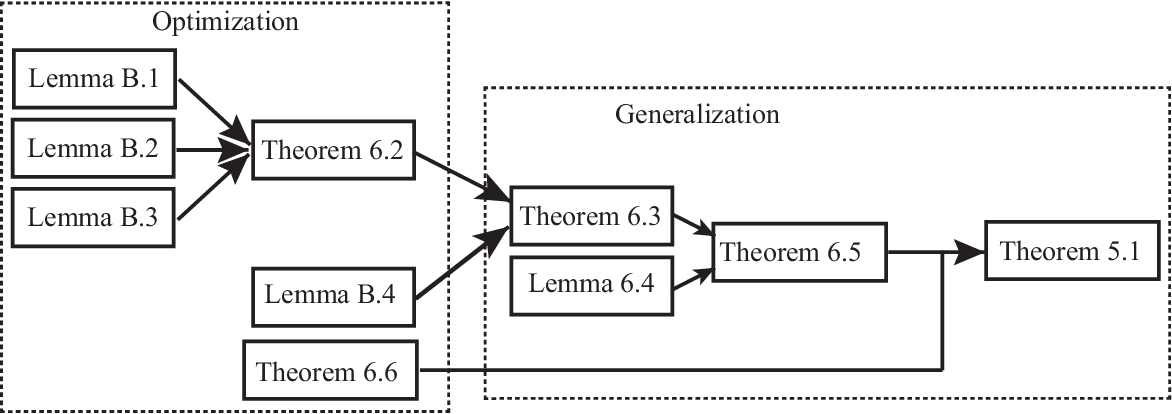
Figure 1 from Gradient Descent Finds Over-Parameterized Neural Networks ...

Preconditioned Gradient Descent for Overparameterized Nonconvex Burer ...

Figure 1 from Comparing Decentralized Gradient Descent Approaches and ...
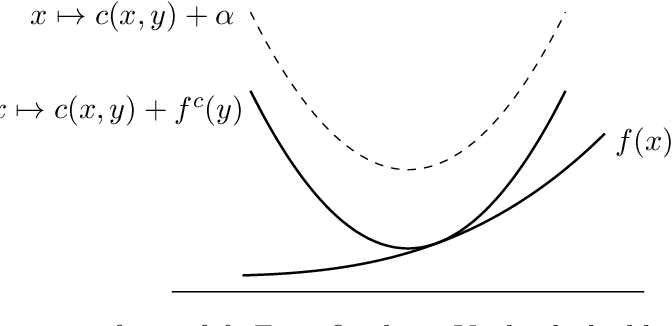
Figure 1 from Gradient descent with a general cost | Semantic Scholar

Figure 1 from Transformers learn to implement preconditioned gradient ...
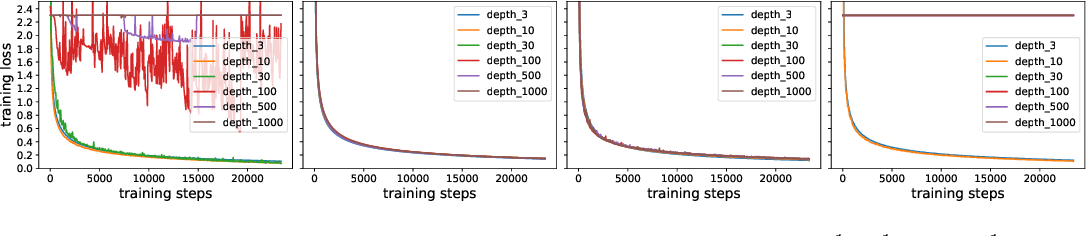
Figure 1 from gradient descent converges linearly to the global minima ...

Figure 1 from The Implicit Regularization of Momentum Gradient Descent ...
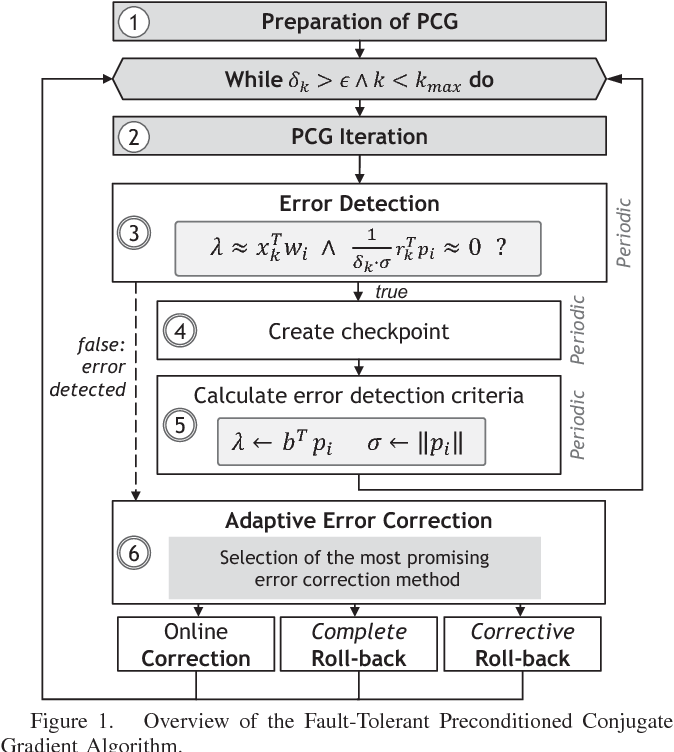
Figure 1 from Low-overhead fault-tolerance for the preconditioned ...

Figure 1 from Gradient Descent Happens in a Tiny Subspace | Semantic ...
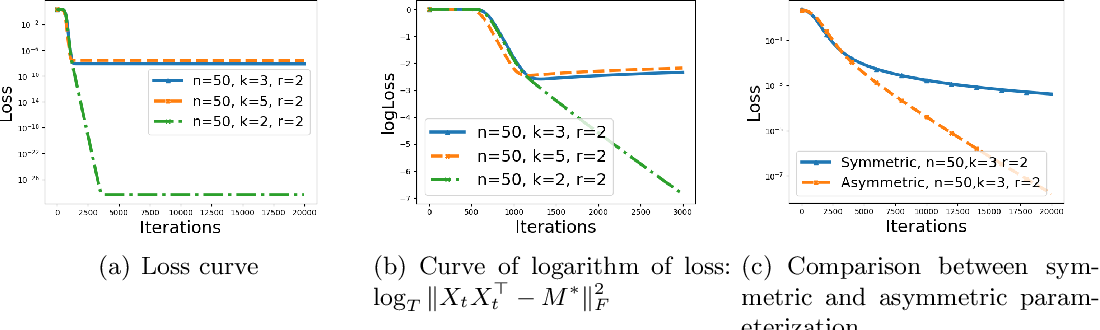
Figure 1 from How Over-Parameterization Slows Down Gradient Descent in ...
Advertisement Space (336x280)

Figure 1 from Transformers learn in-context by gradient descent ...

Figure 2 from Dual Space Preconditioning for Gradient Descent in the ...

[2504.09708] Preconditioned Gradient Descent for Over-Parameterized ...
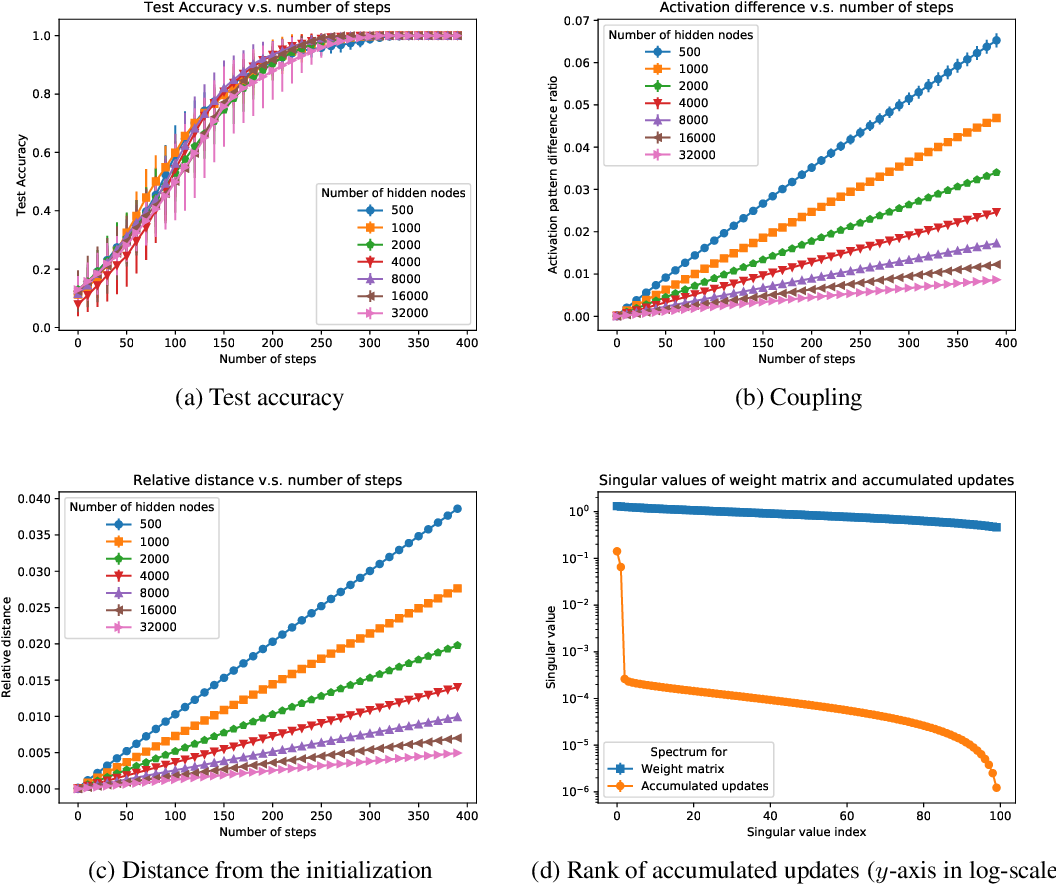
Figure 1 from Learning Overparameterized Neural Networks via Stochastic ...
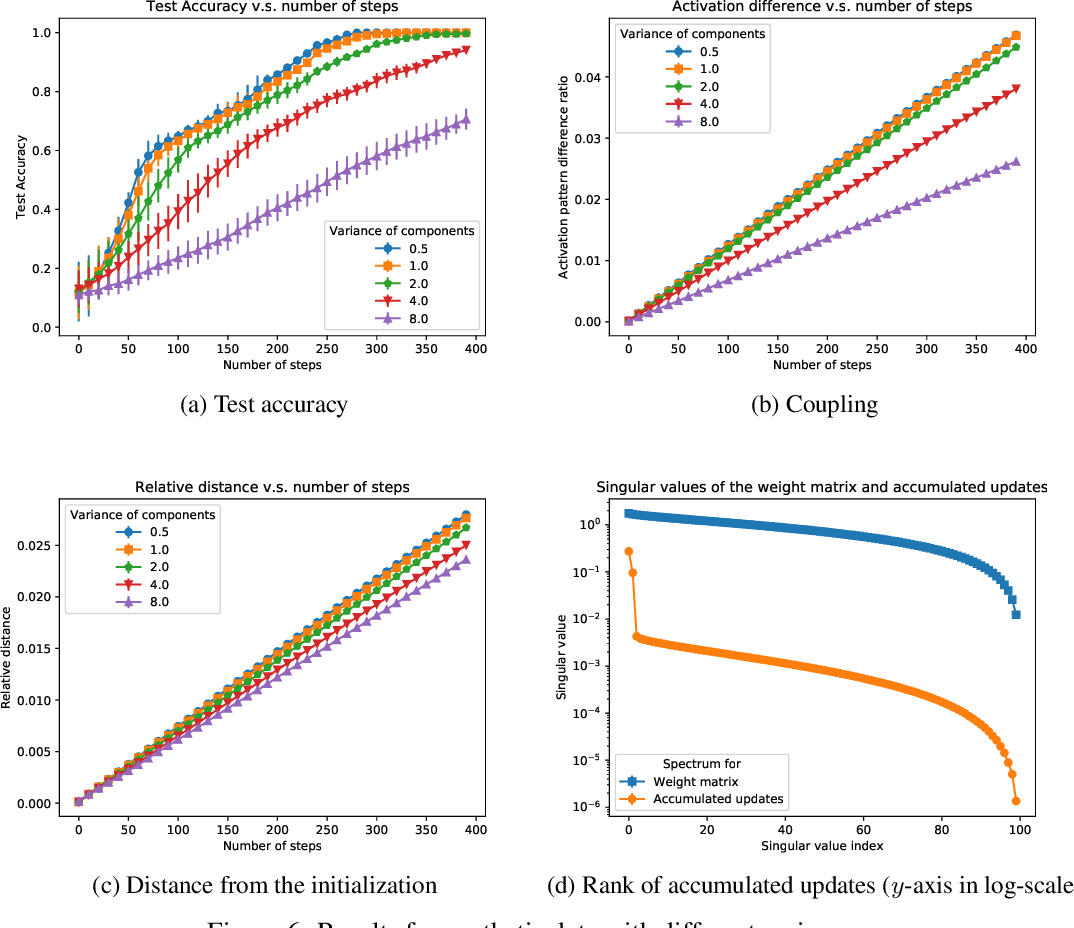
Figure 1 from Learning Overparameterized Neural Networks via Stochastic ...
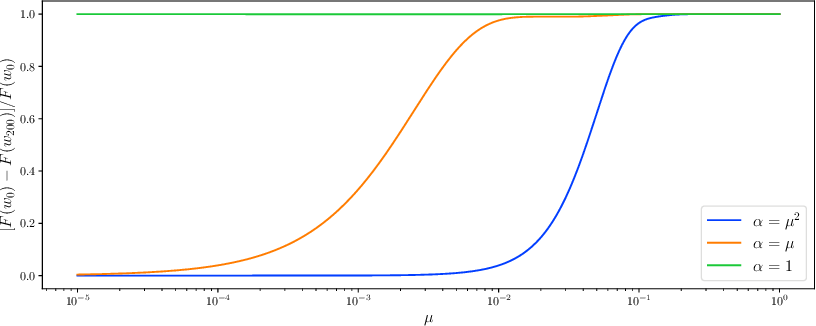
Figure 3.1 from Adaptive Step Sizes for Preconditioned Stochastic ...
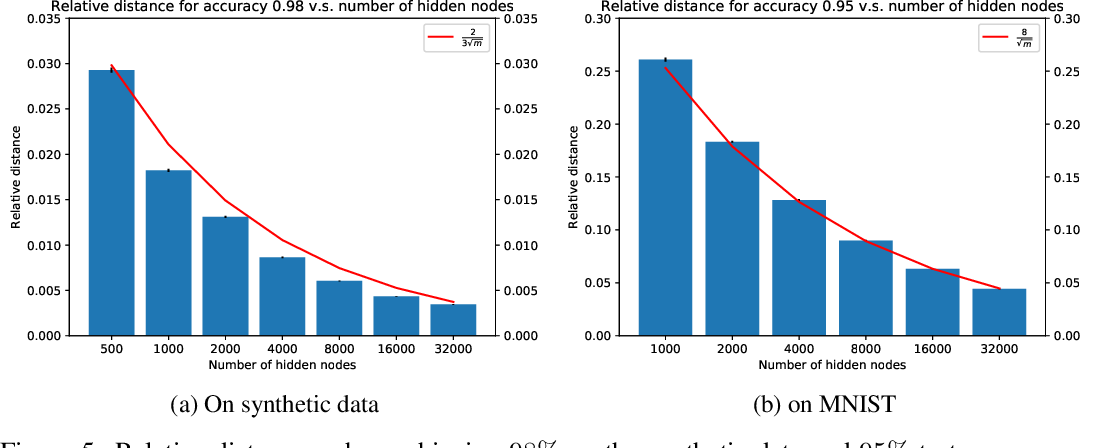
Figure 1 from Learning Overparameterized Neural Networks via Stochastic ...

Figure 7.1 from Adaptive Step Sizes for Preconditioned Stochastic ...

Figure 1 from A modified scaled memoryless BFGS preconditioned ...

Figure 7.2 from Adaptive Step Sizes for Preconditioned Stochastic ...
Advertisement Space (336x280)
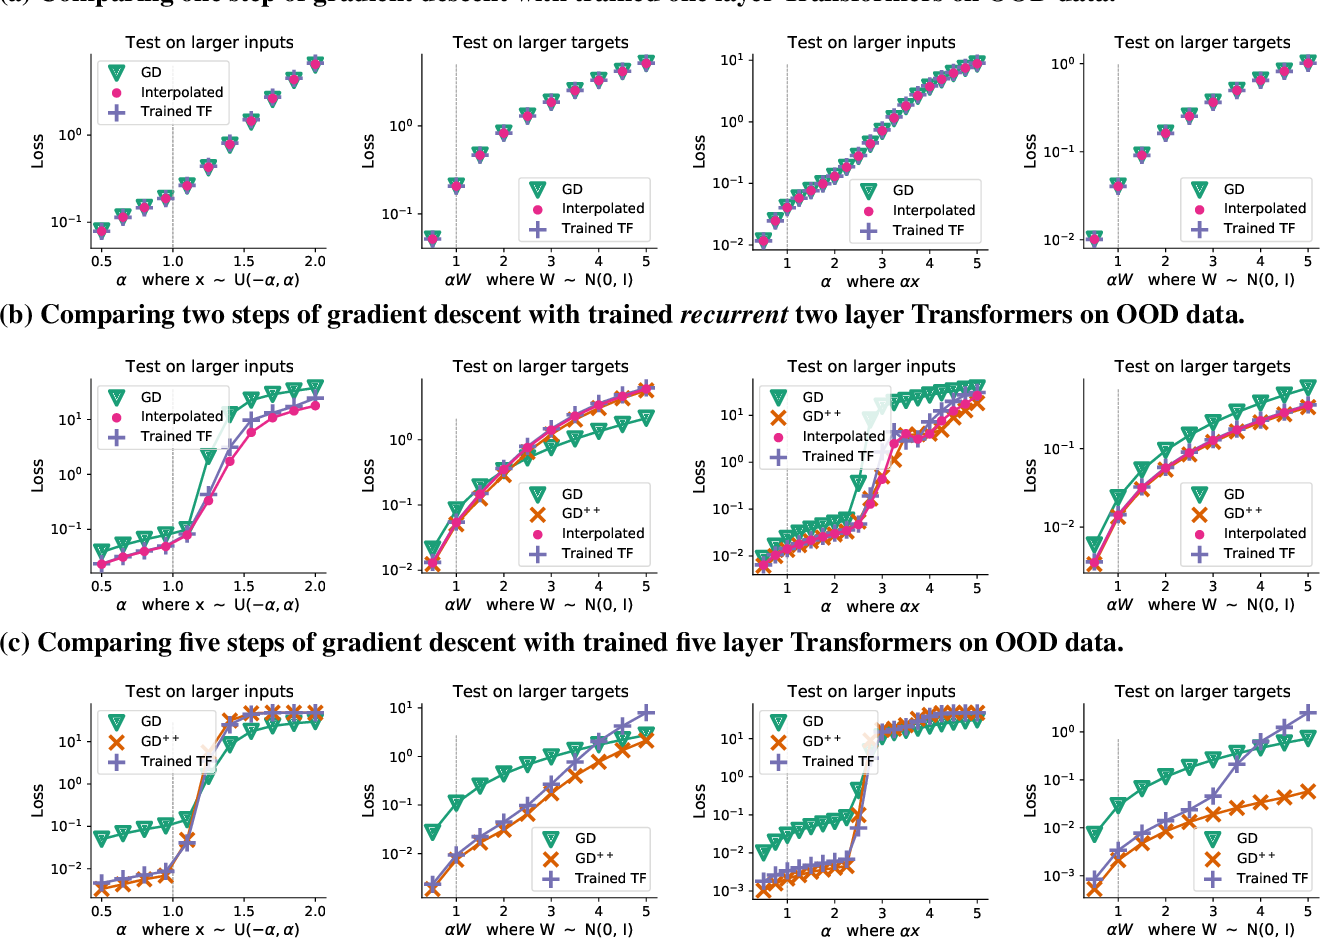
Figure 6 from Transformers learn in-context by gradient descent ...

On the Global Convergence of Gradient Descent for Over-parameterized ...
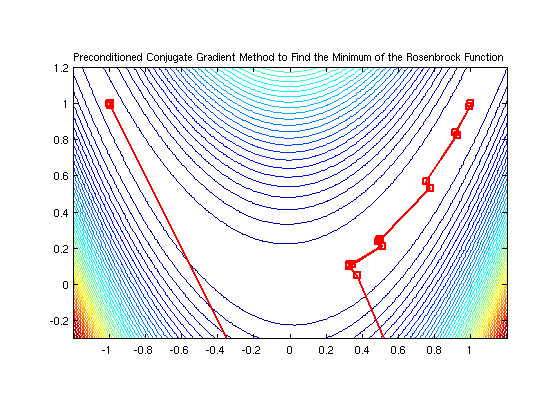
Figure 2. Convergence path of the preconditioned conjugate gradient ...

The Dynamics of Gradient Descent for Overparametrized Neural Networks

Preconditioned Stochastic Gradient Descent

Dual Space Preconditioning for Gradient Descent in the ...