
Figure 1 From Relation Enhanced Vision Language Pre Training Semantic

Figure 1 from Relation Enhanced Vision Language Pre-Training | Semantic ...
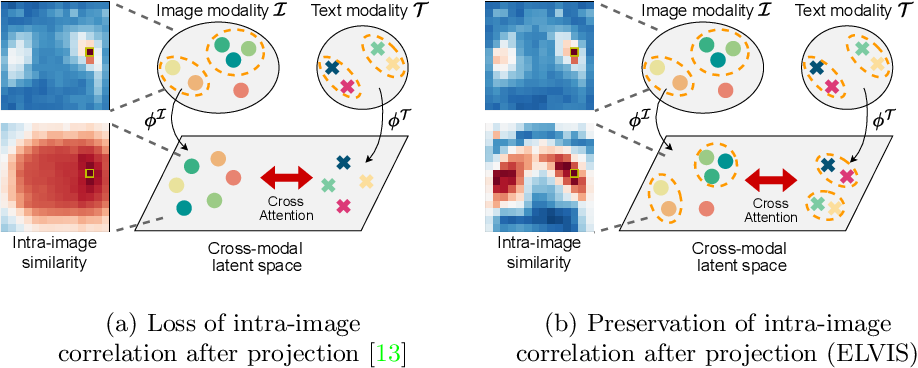
Figure 1 from ELVIS: Empowering Locality of Vision Language Pre ...

Figure 1 from Retrieval-based Knowledge Augmented Vision Language Pre ...

Figure 1 from Unified Vision and Language Prompt Learning | Semantic ...
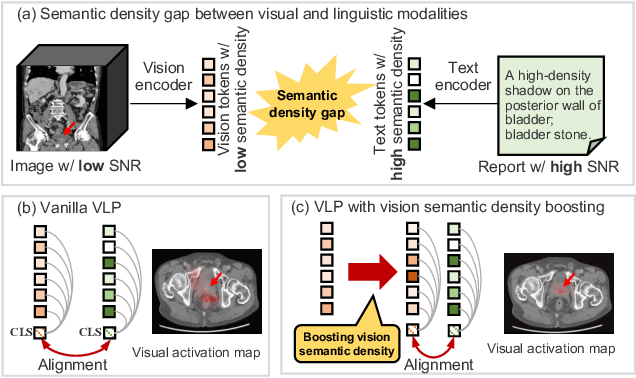
Figure 1 from Boosting Vision Semantic Density with Anatomy Normality ...
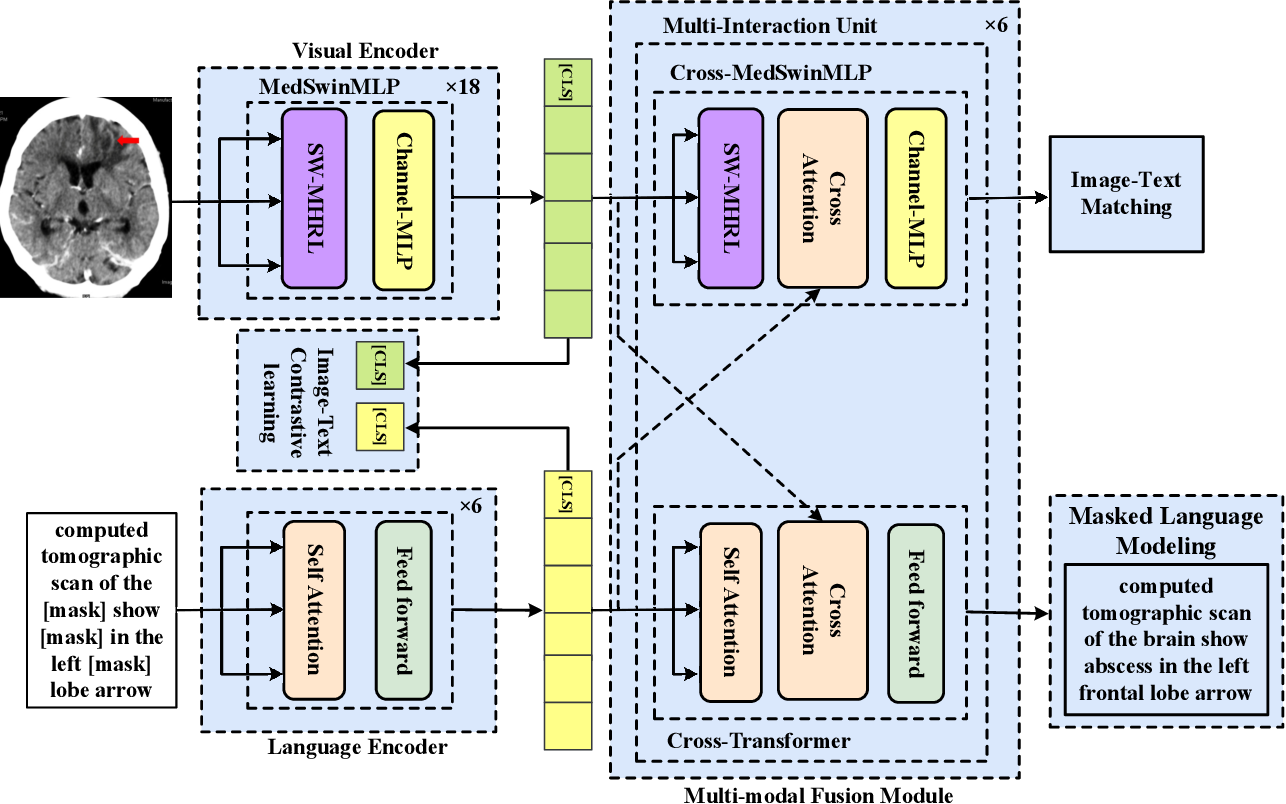
Figure 1 from MLP-Based Vision Language Pre-Training for Medical Visual ...
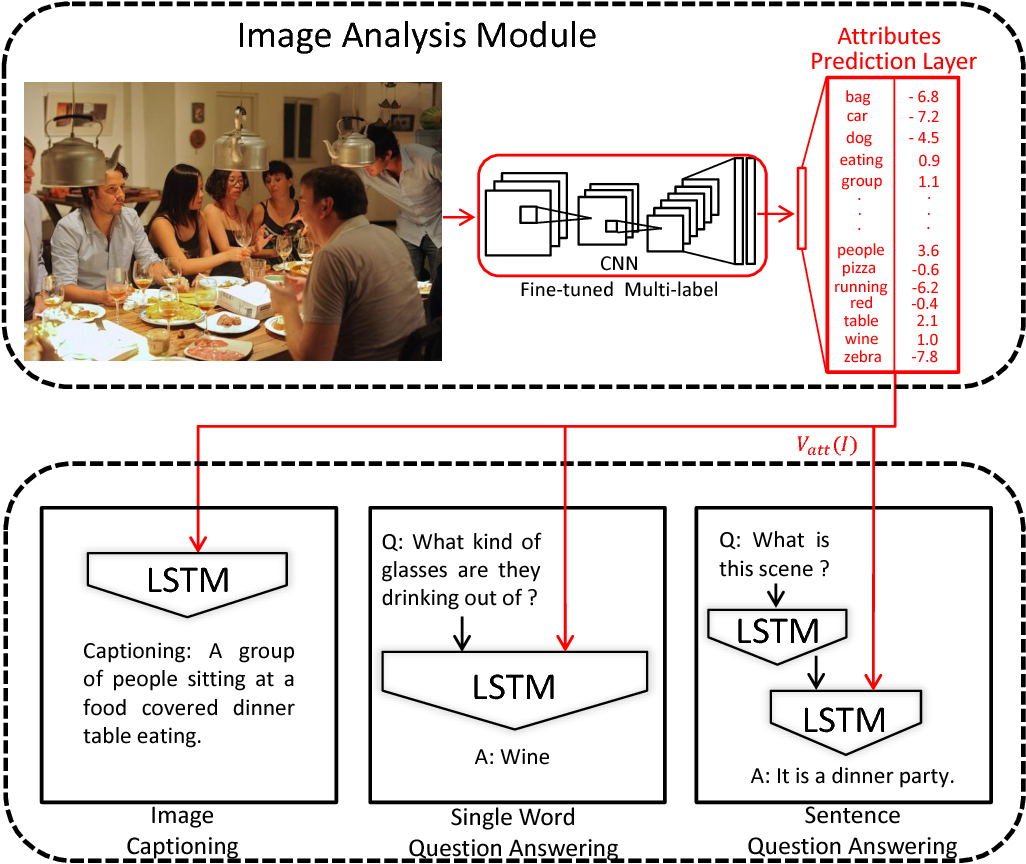
Figure 1 from What value high level concepts in vision to language ...

Figure 1 from Masked Vision and Language Modeling for Multi-modal ...
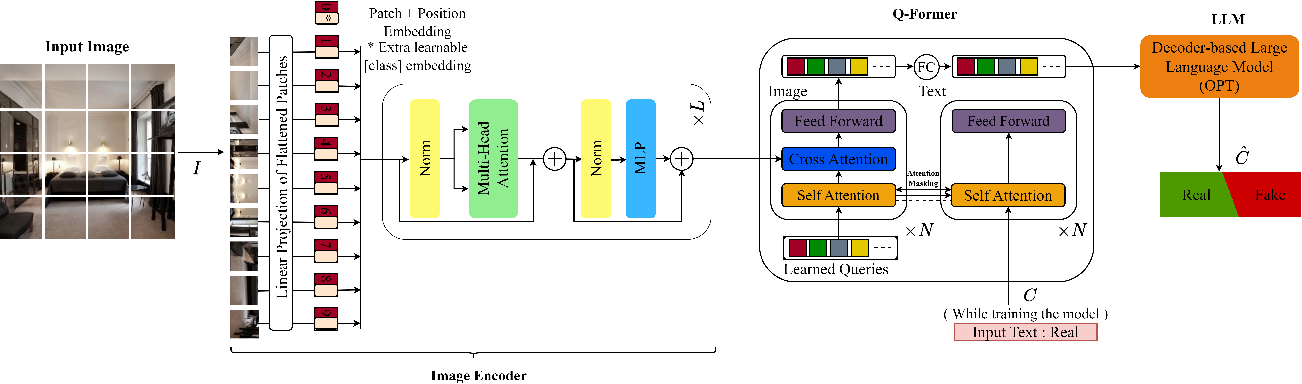
Figure 1 from Harnessing the Power of Large Vision Language Models for ...
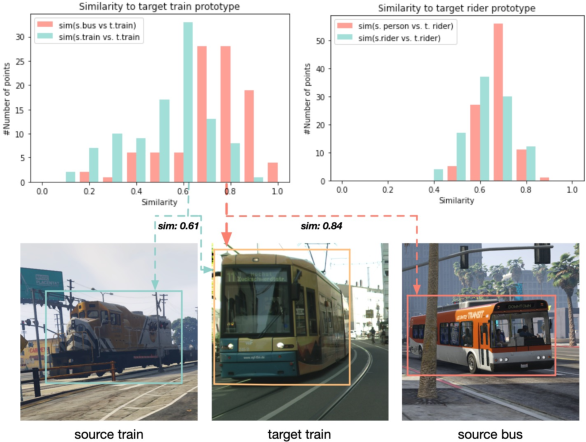
Figure 1 from Domain-Adaptive Semantic Segmentation Emerges From Vision ...
Advertisement Space (300x250)
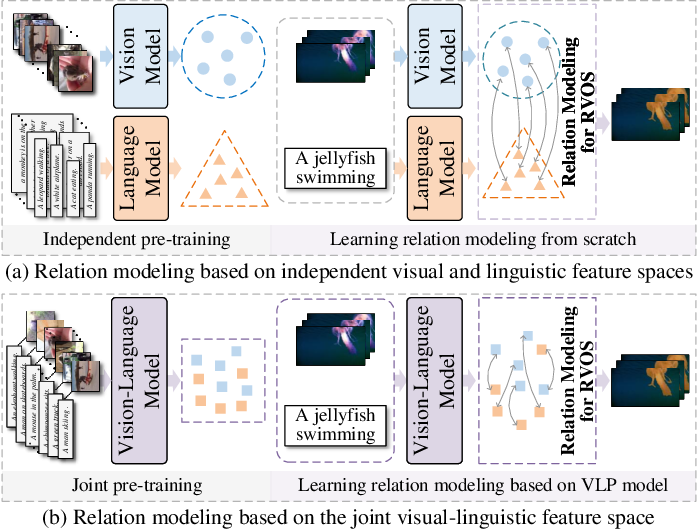
Figure 1 from Driving Referring Video Object Segmentation with Vision ...

Figure 1 from Enhance Vision-Language Alignment with Noise | Semantic ...

Figure 1 from An Explainable Toolbox for Evaluating Pre-trained Vision ...
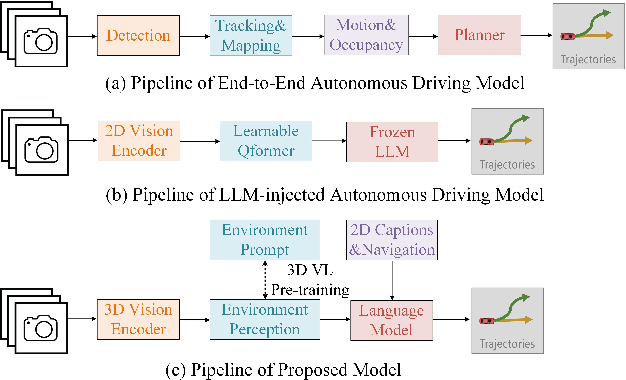
Figure 1 from Generative Planning with 3D-vision Language Pre-training ...

Figure 1 from Domain Knowledge Enhanced Vision-Language Pretrained ...

Figure 1 from Utilizing Synthetic Data for Medical Vision-Language Pre ...

Figure 1 from Knowledge Boosting: Rethinking Medical Contrastive Vision ...
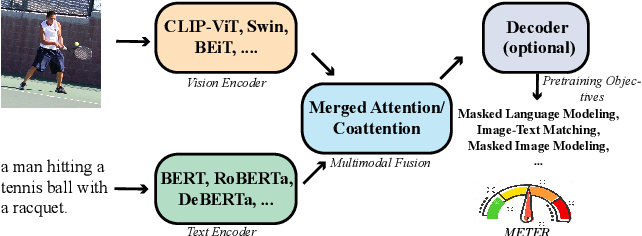
Figure 1 from An Empirical Study of Training End-to-End Vision-and ...

Figure 1 from Decomposing Disease Descriptions for Enhanced Pathology ...

Figure 2 from Graph Structure Enhanced Pre-Training Language Model for ...
Advertisement Space (336x280)

Figure 1 from Semantic Compositions Enhance Vision-Language Contrastive ...

Figure 1 from Dual Modality Prompt Tuning for Vision-Language Pre ...
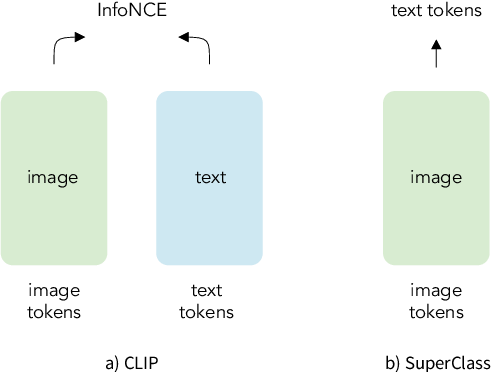
Figure 1 from Classification Done Right for Vision-Language Pre ...
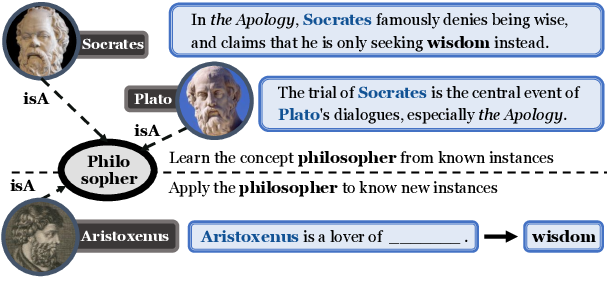
Figure 1 from ConcEPT: Concept-Enhanced Pre-Training for Language ...
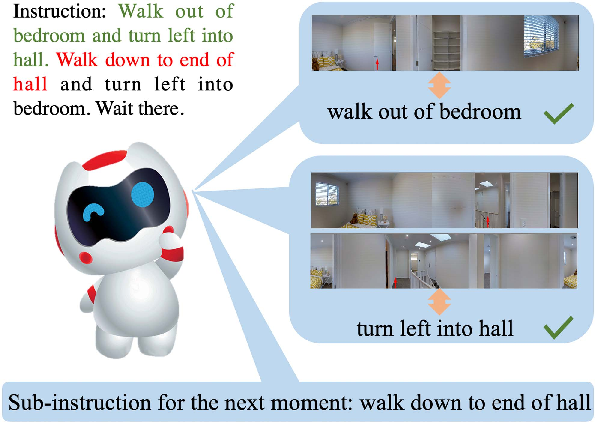
Figure 1 from Vision-and-Language Navigation via Latent Semantic ...
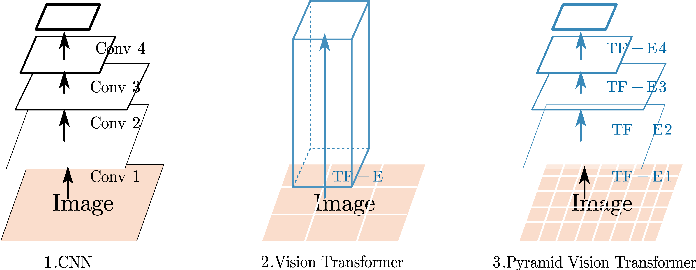
Figure 1 from Research on Image Captioning Based on Vision-language Pre ...
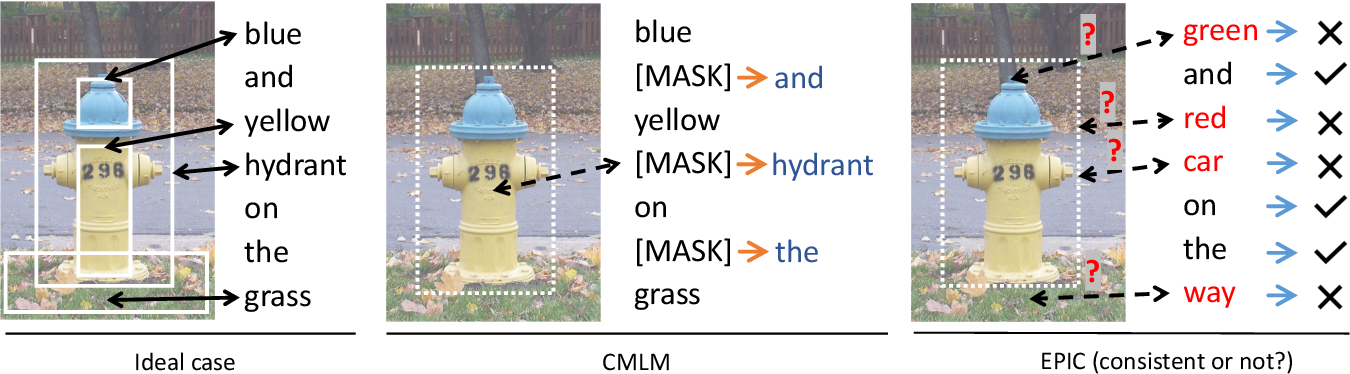
Figure 1 from Leveraging per Image-Token Consistency for Vision ...
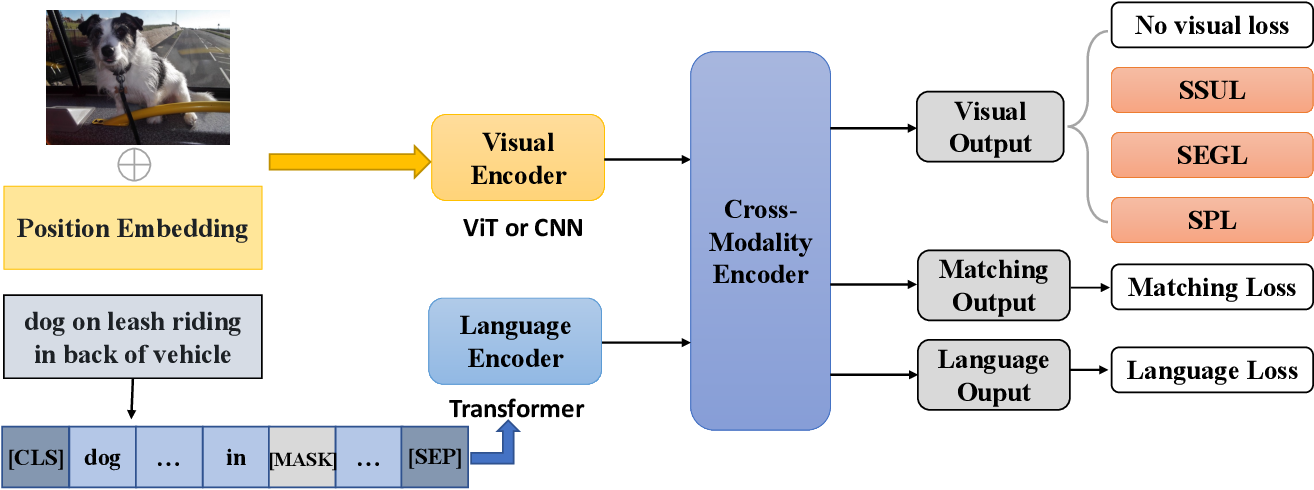
Figure 2 from Effective End-to-End Vision Language Pretraining With ...

Figure 1 from Approximated Prompt Tuning for Vision-Language Pre ...

Figure 1 from Unified Vision-Language Pre-Training for Image Captioning ...
Advertisement Space (336x280)

Figure 1 from Enhancing Vision-Language Pre-Training with Jointly ...

Figure 1 from Unleashing the Potential of Vision-Language Pre-Training ...

Figure 1 from Efficient Vision-Language Pretraining with Visual ...

Figure 1 from Vision-Language Pre-training with Object Contrastive ...

Figure 2 from Exploiting the Textual Potential from Vision-Language Pre ...

Figure 1 from End-to-End Unsupervised Vision-and-Language Pre-training ...