
Figure 1 From Rethinking Audiovisual Segmentation With Semantic

Figure 1 from Rethinking Audiovisual Segmentation with Semantic ...

Table 1 from Rethinking Audiovisual Segmentation with Semantic ...
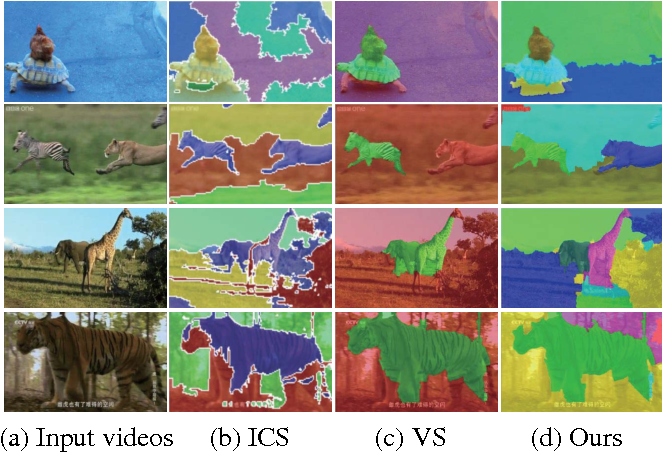
Figure 1 from Semantic Single Video Segmentation with Robust Graph ...
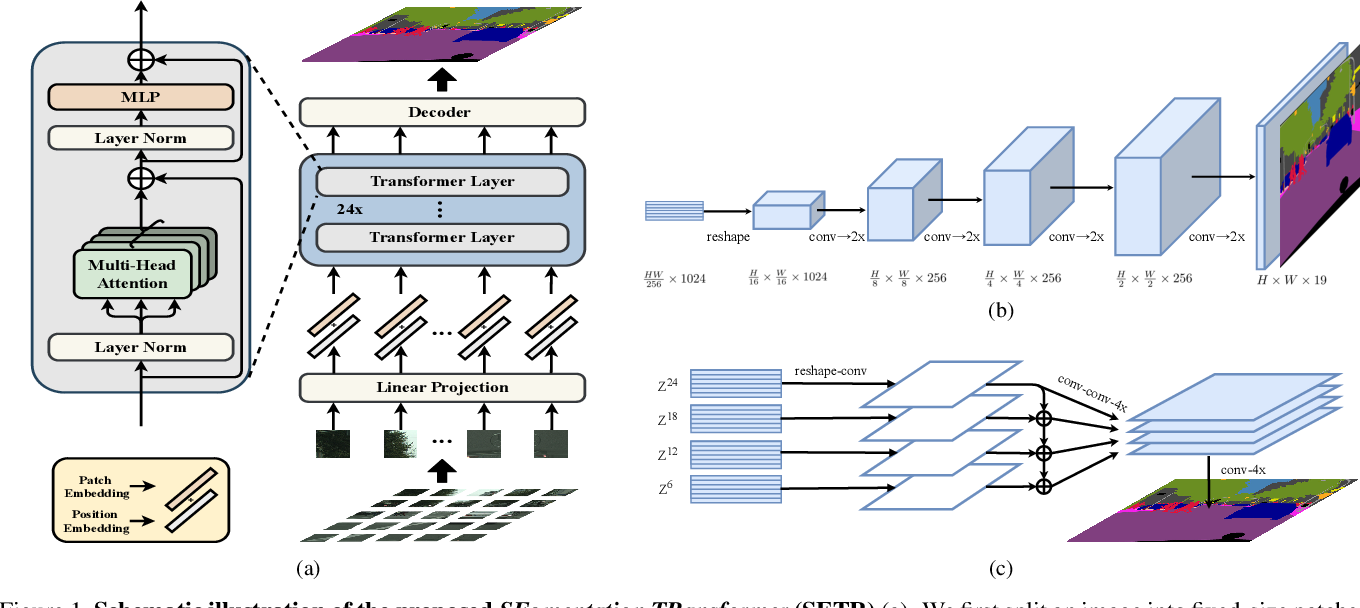
Figure 1 from Rethinking Semantic Segmentation from a Sequence-to ...
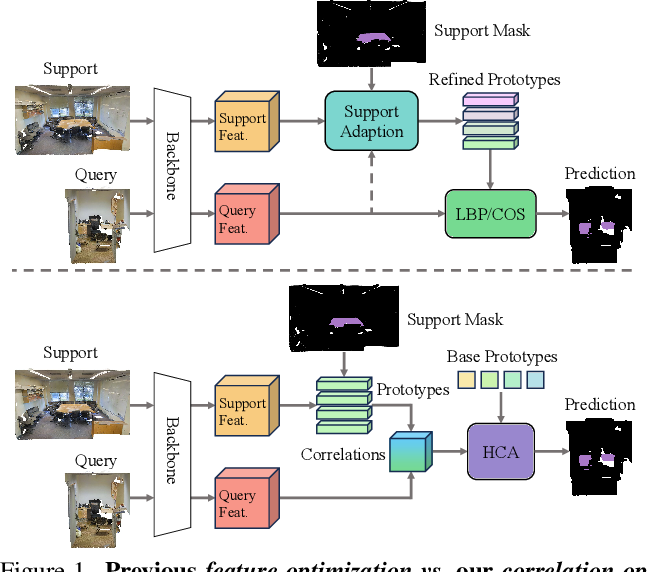
Figure 1 from Rethinking Few-shot 3D Point Cloud Semantic Segmentation ...

Rethinking Audiovisual Segmentation with Semantic Quantization and ...

Figure 1 from Revisiting Audio-Visual Segmentation with Vision-Centric ...

Figure 1 from AVSegFormer: Audio-Visual Segmentation with Transformer ...
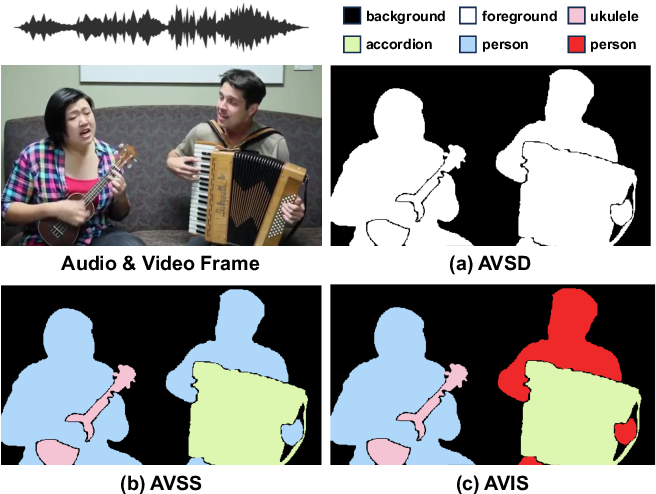
Figure 1 from Audio-Visual Instance Segmentation | Semantic Scholar
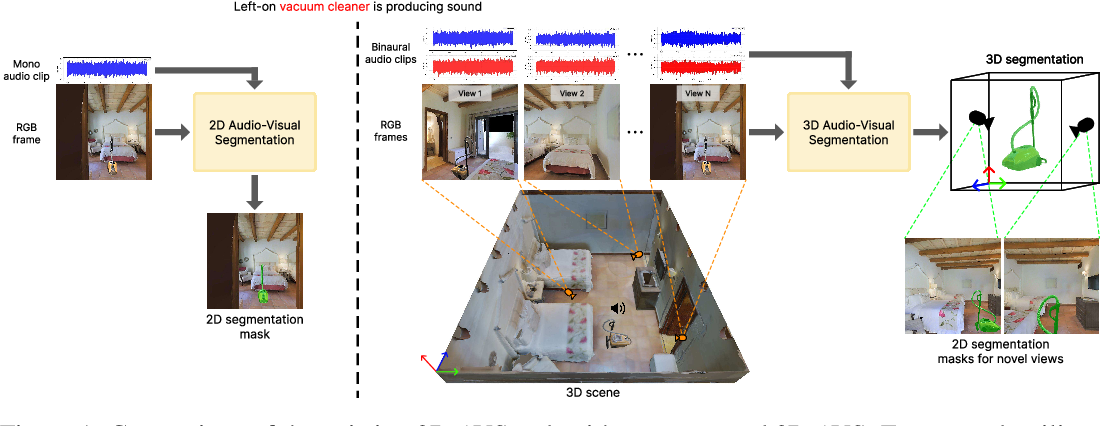
Figure 1 from 3D Audio-Visual Segmentation | Semantic Scholar
Advertisement Space (300x250)
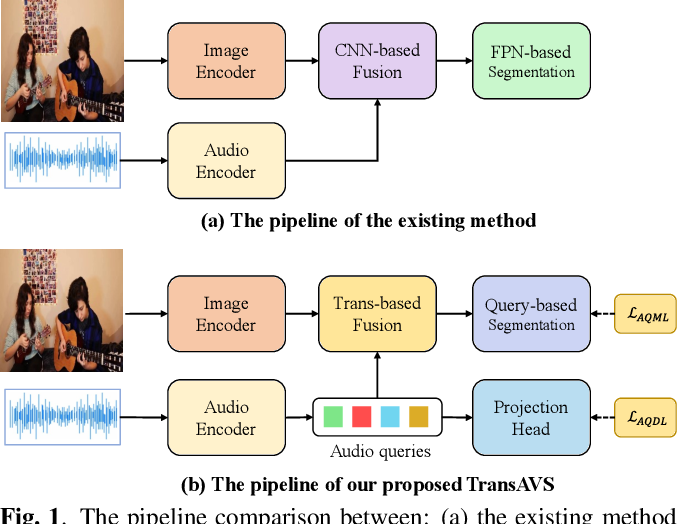
Figure 1 from TransAVS: End-to-End Audio-Visual Segmentation with ...

Figure 1 from Visual Semantic Segmentation Based on Few/Zero-Shot ...

Figure 1 from Improving Audio-Visual Segmentation with Bidirectional ...

Figure 1 from Improving Audio-Visual Segmentation with Bidirectional ...
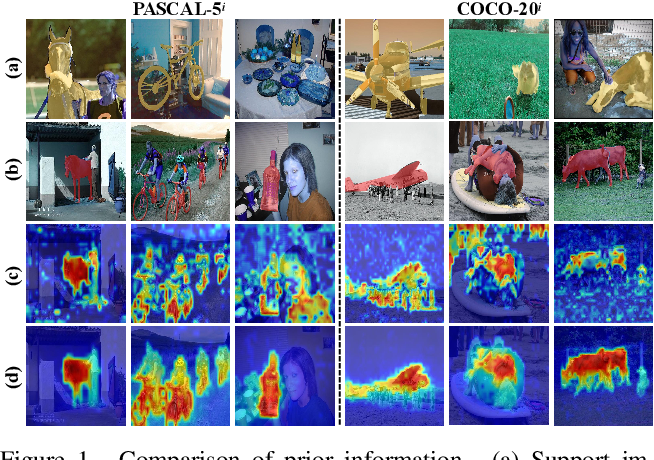
Figure 1 from Rethinking Prior Information Generation with CLIP for Few ...

Rethinking Audiovisual Segmentation with Semantic Quantization and ...

Figure 1 from Weakly-Supervised Audio-Visual Segmentation | Semantic ...
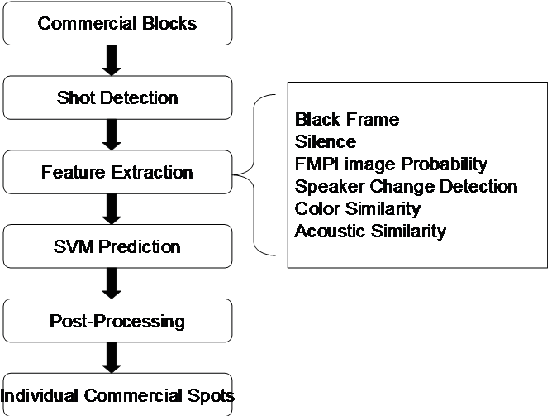
Figure 1 from TV commercial segmentation using audiovisual features and ...

Figure 1 from Rethinking Saliency-Guided Weakly-Supervised Semantic ...

Figure 3 from Audio-Visual Segmentation with Semantics | Semantic Scholar
Advertisement Space (336x280)

Rethinking Audiovisual Segmentation with Semantic Quantization and ...

Figure 1 from Open-Vocabulary Audio-Visual Semantic Segmentation ...
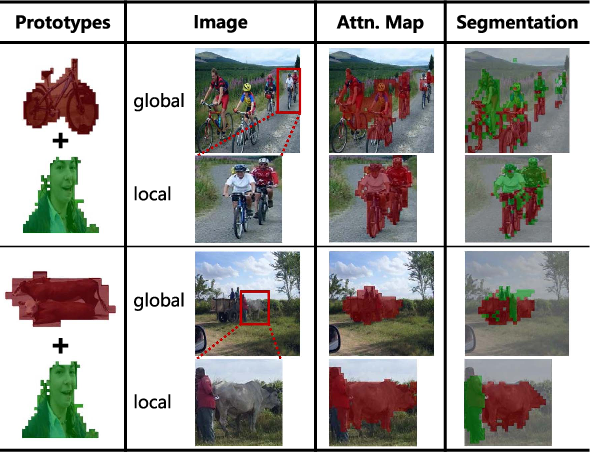
Figure 3 from Rethinking Self-Supervised Semantic Segmentation ...
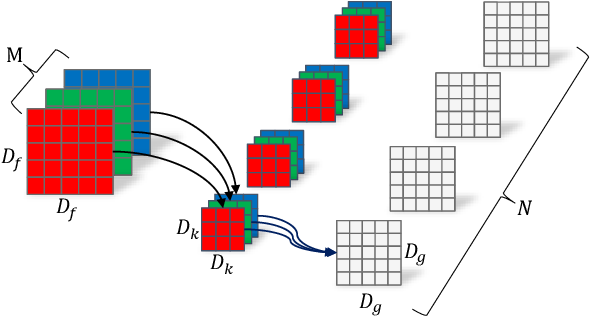
Figure 1 from Rethinking Mobilevitv2 for Real-Time Semantic ...

Figure 1 from Video Semantic Segmentation leveraging Dense Optical Flow ...
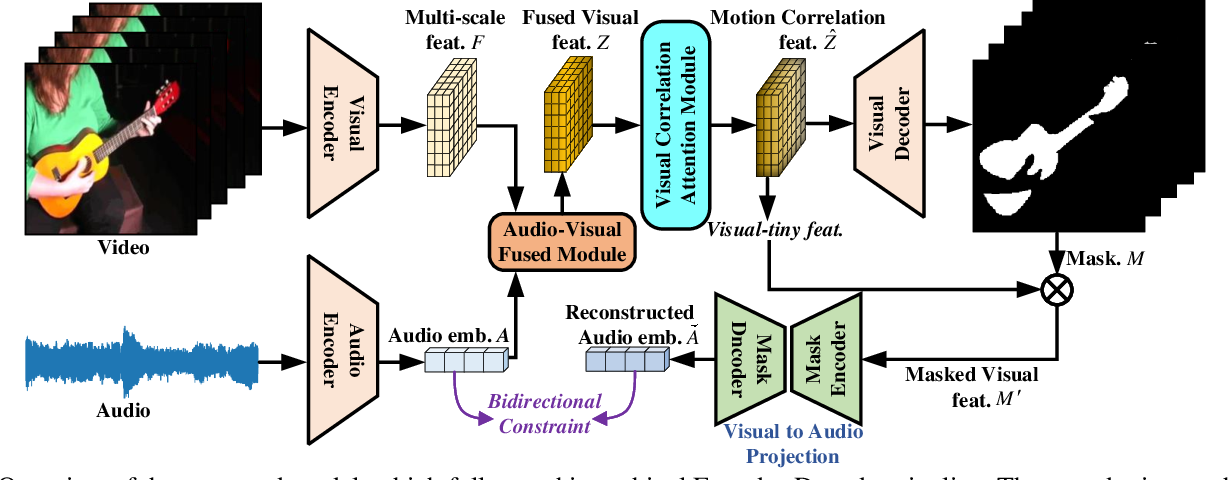
Figure 1 from Improving Audio-Visual Segmentation with Bidirectional ...

Figure 2 from Rethinking Interactive Image Segmentation with Low ...

Figure 1 from Rethinking Dilated Convolution for Real-time Semantic ...
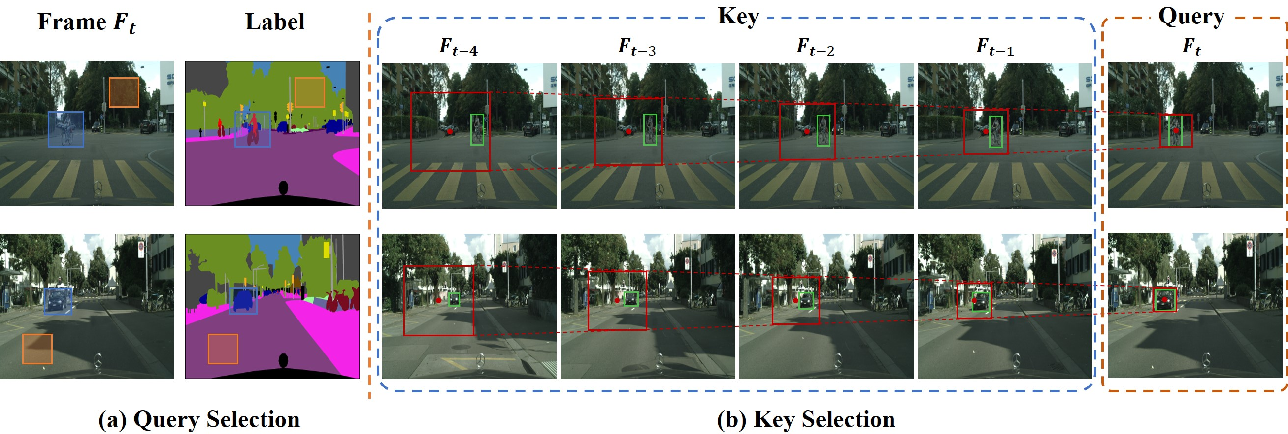
Figure 1 from Video Semantic Segmentation via Sparse Temporal ...

Figure 1 from Unsupervised Audio-Visual Segmentation with Modality ...
Advertisement Space (336x280)
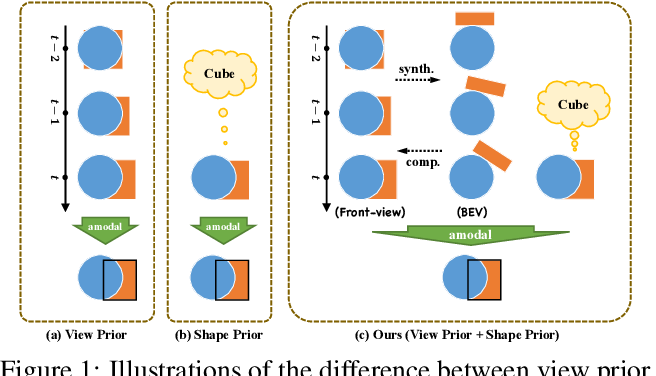
Figure 1 from Rethinking Amodal Video Segmentation from Learning ...

Figure 1 from Rethinking Scanning Strategies with Vision Mamba in ...

Figure 1 from Rethinking Amodal Video Segmentation from Learning ...

Figure 1 from Rethinking local and global feature representation for ...

Figure 1 from Audio Visual Segmentation Through Text Embeddings ...
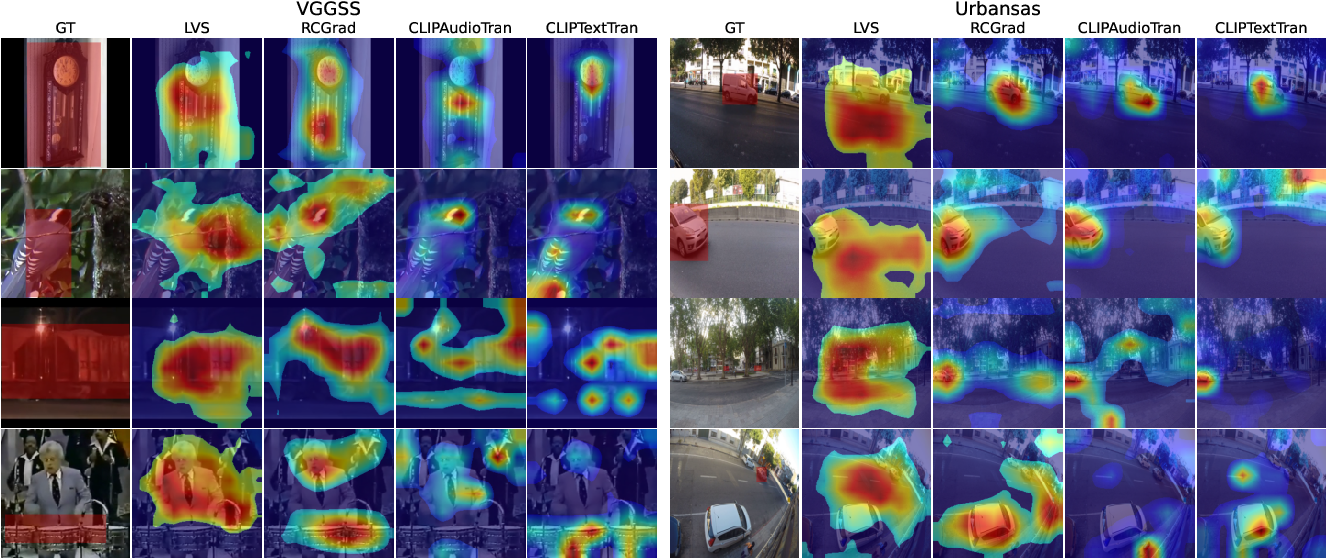
Figure 1 from How to Listen? Rethinking Visual Sound Localization ...