
Figure 1 From Self Supervised Pretraining Vision Transformer With

Figure 1 from Self-Supervised Pretraining Vision Transformer With ...
Figure 1 from Self-Supervised Pretraining Vision Transformer With ...

Figure 1 from MAT-VIT:A Vision Transformer with MAE-Based Self ...

Figure 1 from Pretraining the Vision Transformer using self-supervised ...

Figure 1 from RePre: Improving Self-Supervised Vision Transformer with ...
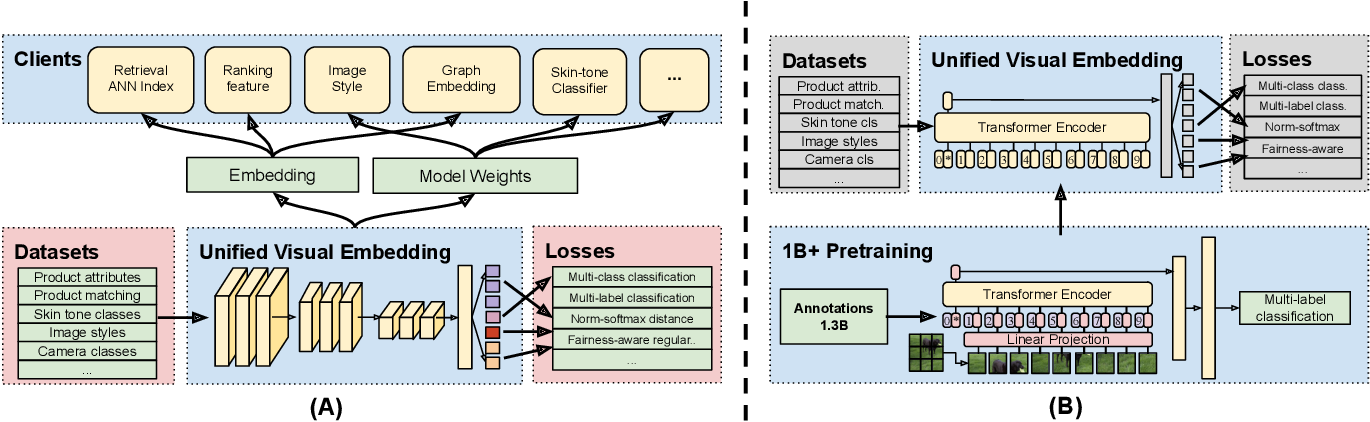
Figure 1 from Billion-Scale Pretraining with Vision Transformers for ...
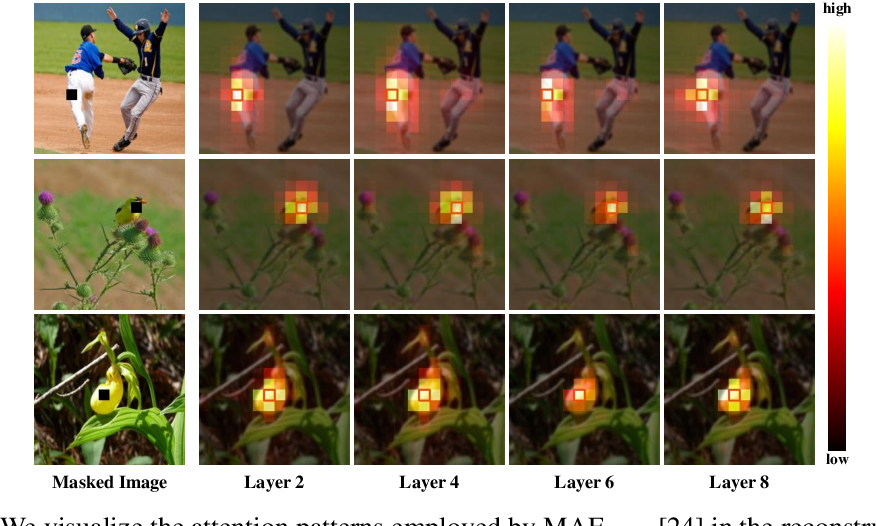
Figure 1 from Efficient Self-supervised Vision Pretraining with Local ...

Figure 1 from Transfer Learning with Self-Supervised Vision Transformer ...

Figure 2 from Self-Supervised Pretraining Vision Transformer With ...

Figure 1 from Positional Label for Self-Supervised Vision Transformer ...
Advertisement Space (300x250)

Figure 1 from SiT: Self-supervised vIsion Transformer | Semantic Scholar
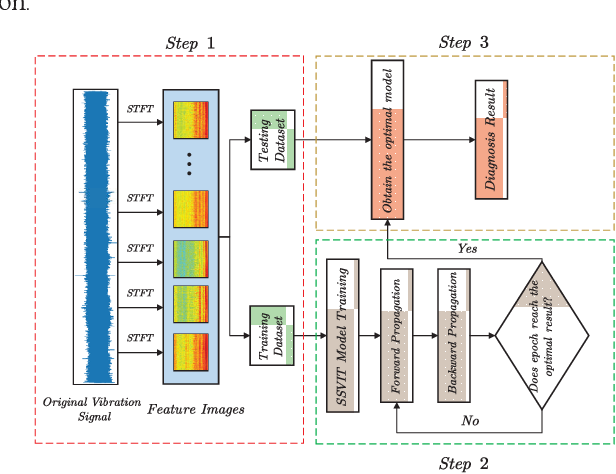
Figure 1 from Self-Supervised Vision Transformer for Intelligent Fault ...

Figure 1 from Cross-Shaped Windows Transformer with Self-supervised ...

Figure 1 from Self-Supervised Pretraining via Multimodality Images With ...

Figure 1 from A Study on Self-Supervised Pretraining for Vision ...

Figure 1 from Cross-Shaped Windows Transformer with Self-supervised ...
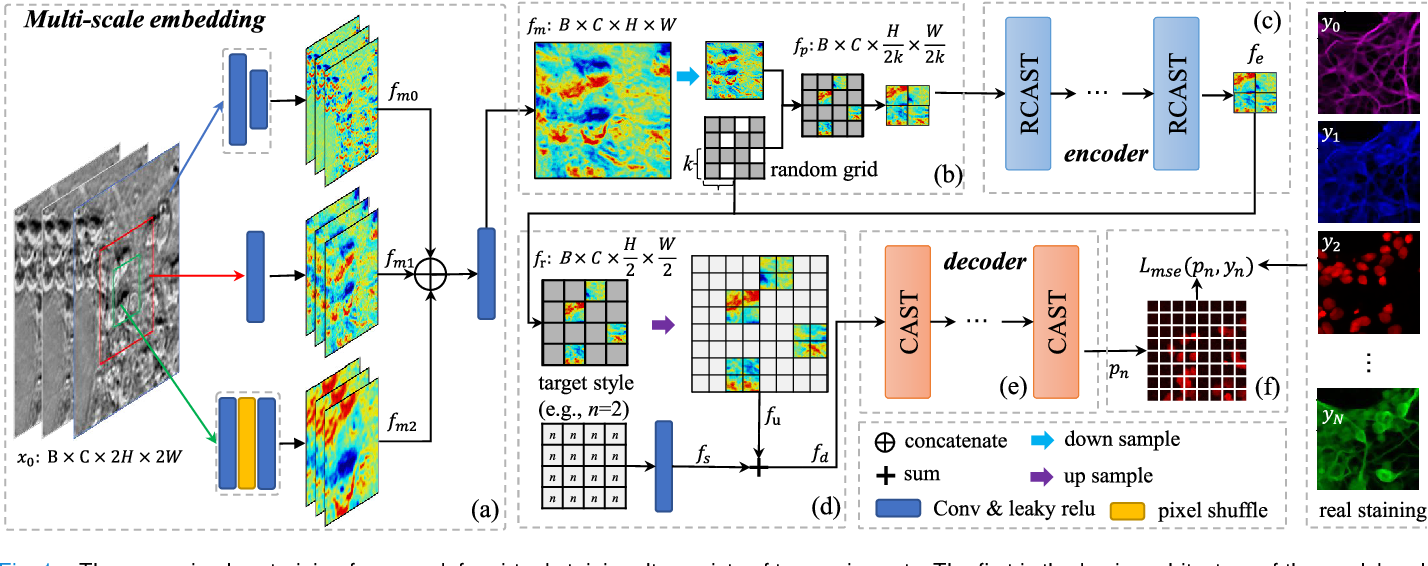
Figure 1 from Efficient Supervised Pretraining of Swin-Transformer for ...
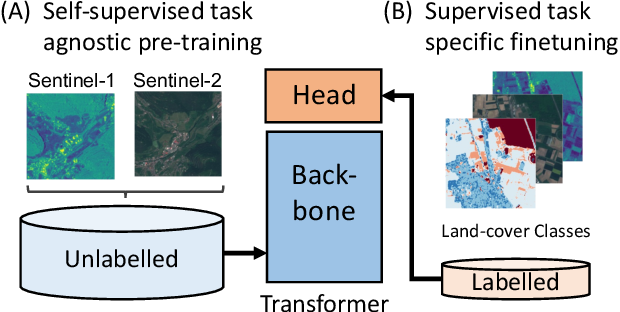
Figure 1 from Self-supervised Vision Transformers for Land-cover ...

Figure 1 from Self-Supervised Pre-training with Transformers for Object ...

Figure 1 from Exploring Self-Supervised Vision Transformers for Gait ...
Advertisement Space (336x280)

Figure 1 from Adapting Self-Supervised Vision Transformers by Probing ...

Figure 1 from Jointly Optimal Incremental Learning with Self-Supervised ...

Figure 1 from Self-Supervised Vision Transformers Are Efficient ...

Figure 1 from Rethinking Hierarchies in Pre-trained Plain Vision ...

Figure 1 from Leveraging Self-Supervised Vision Transformers for Neural ...

Figure 1 from Self-supervised Vision Transformers for Land-cover ...

Figure 1 from Self-supervised Video Transformer | Semantic Scholar
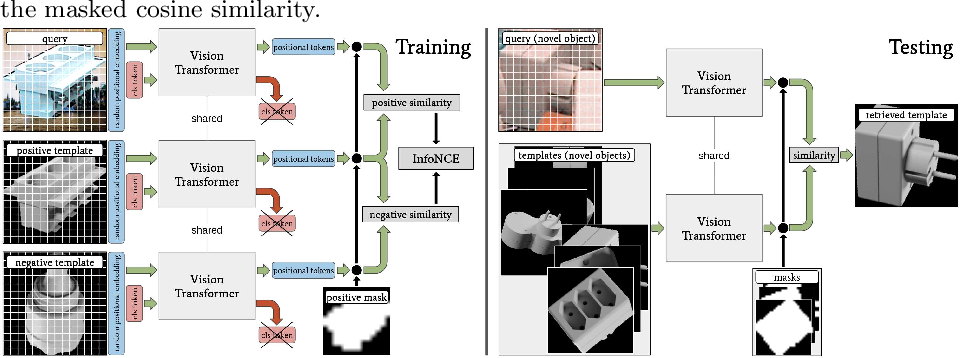
Figure 1 from Self-supervised Vision Transformers for 3D Pose ...

Figure 1 from Self-Supervised Vision Transformers for Malware Detection ...

Figure 1 from Hybrid Transformer Network for Change Detection Under ...
Advertisement Space (336x280)
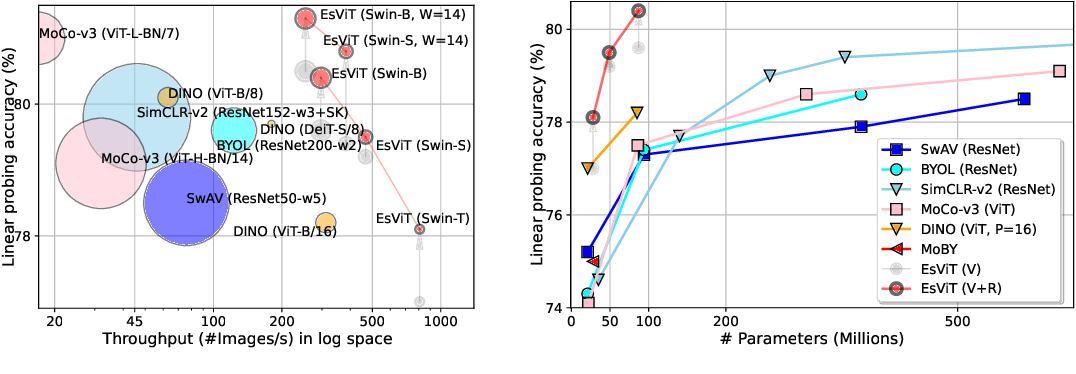
Figure 1 from Efficient Self-supervised Vision Transformers for ...

Figure 1 from FactoFormer: Factorized Hyperspectral Transformers With ...

Figure 1 from Self-Supervised Vision Transformers Learn Visual Concepts ...
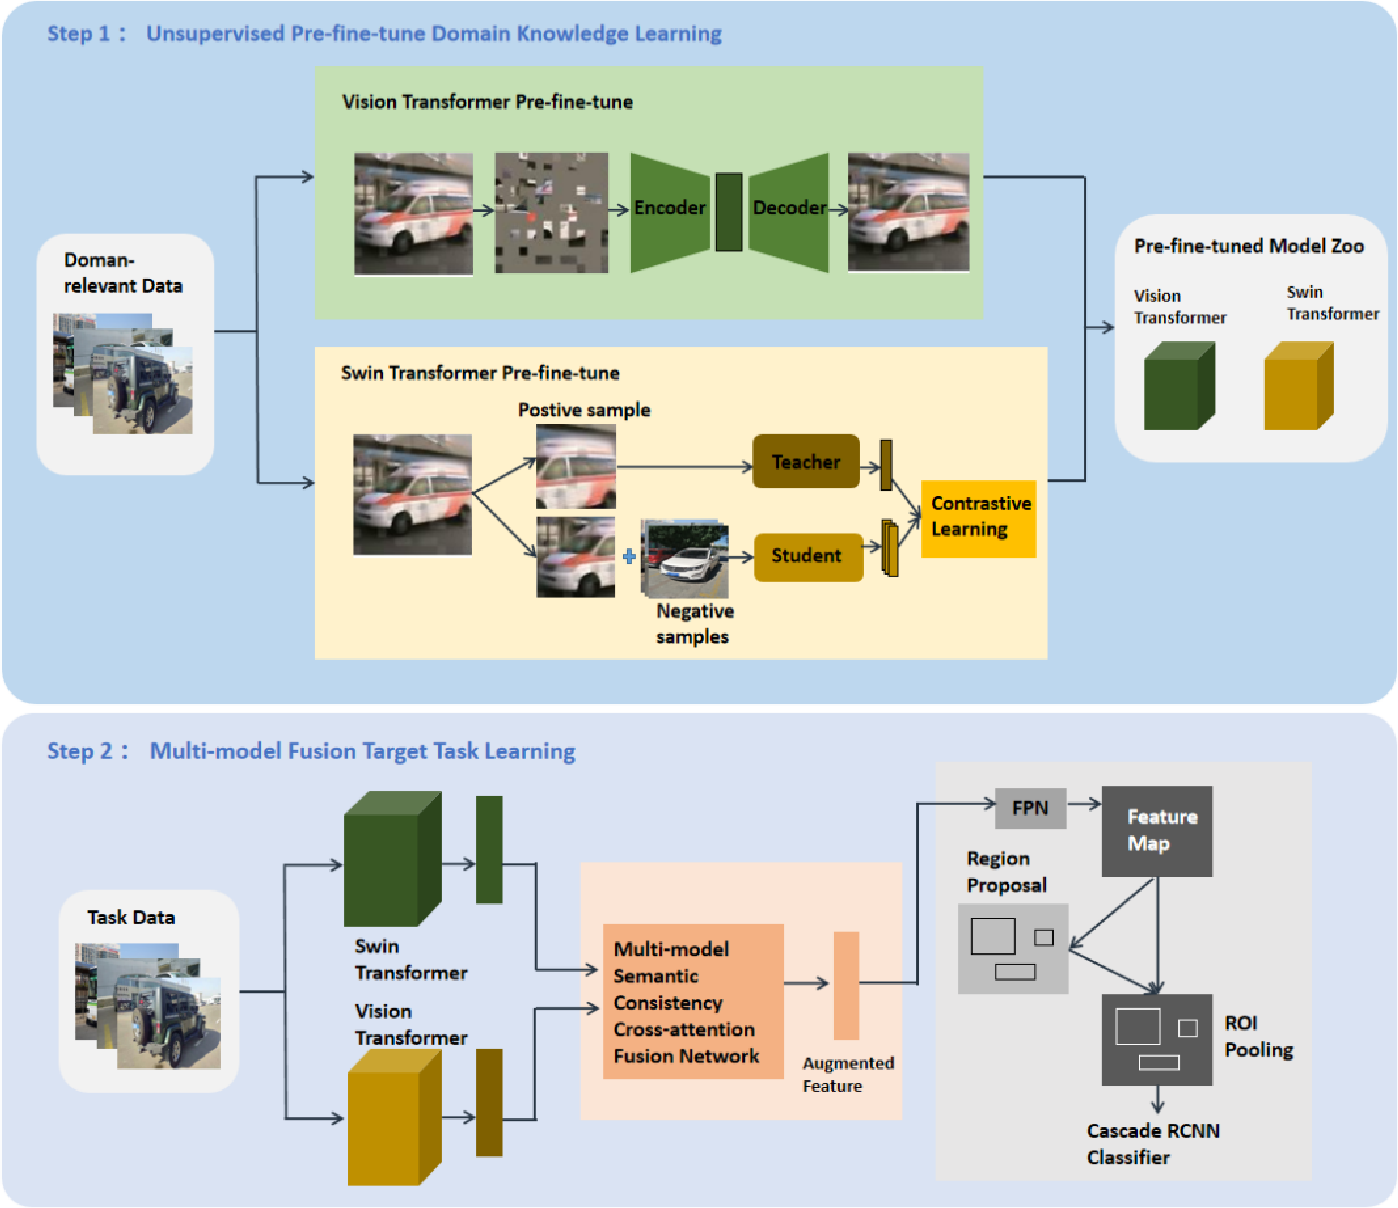
Figure 1 from Multi Self-supervised Pre-fine-tuned Transformer Fusion ...

Figure 2 from How to Train Vision Transformer on Small-scale Datasets ...

Figure 1 from Semi-supervised Vision Transformers at Scale | Semantic ...