
Figure 1 From Semantic Maximum Relevance And Modal Alignment For Cross

Figure 1 from Semantic Maximum Relevance and Modal Alignment for Cross ...

Figure 1 from CA_DeepSC: Cross-Modal Alignment for Multi-Modal Semantic ...

Figure 1 from Cross-Modal Translation and Alignment for Survival ...

Figure 1 from Memory-Based Cross-Modal Semantic Alignment Network for ...

Figure 1 from Cross-Modal and Uni-Modal Soft-Label Alignment for Image ...

Figure 1 from Discrete Joint Semantic Alignment Hashing for Cross-Modal ...
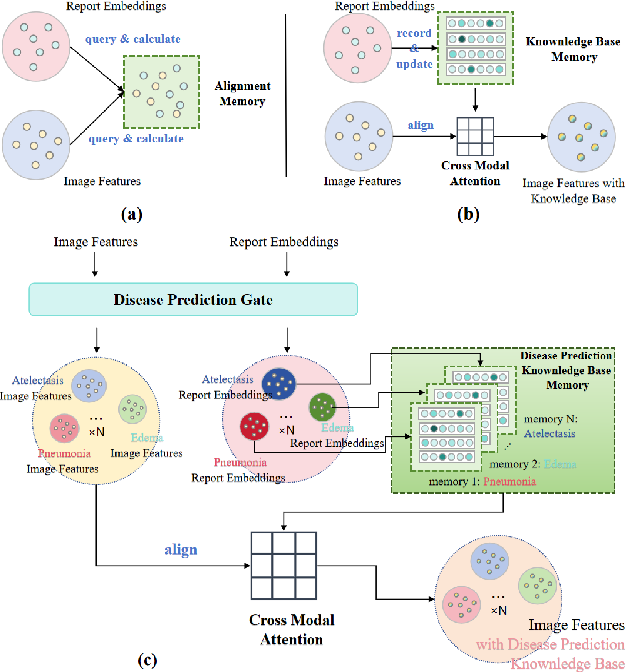
Figure 1 from Adaptive Semantic Alignment for Automated Radiology ...
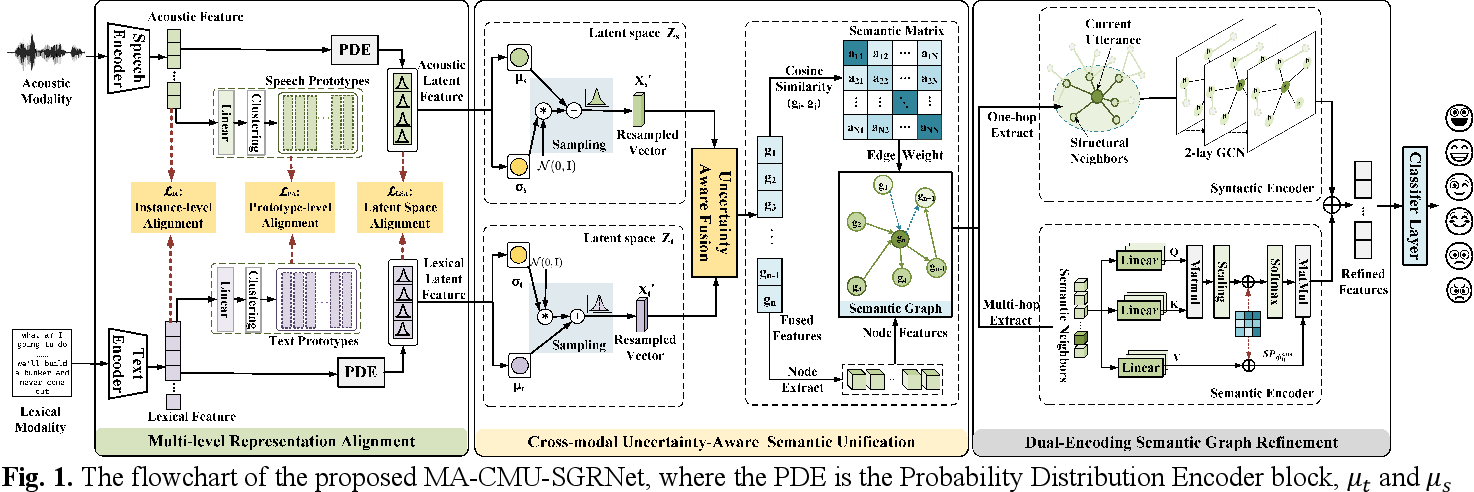
Figure 1 from A Multi-Level Alignment and Cross-Modal Unified Semantic ...

Figure 1 from Cross-modal Feature Alignment and Fusion for Composed ...

Figure 1 from CA_DeepSC: Cross-Modal Alignment for Multi-Modal Semantic ...
Advertisement Space (300x250)

Figure 1 from Cross-Modal and Uni-Modal Soft-Label Alignment for Image ...

Figure 1 from Multilevel Semantic Interaction Alignment for Video–Text ...

Figure 1 from Semantic Disentanglement Adversarial Hashing for Cross ...

Figure 1 from Cross-Modal and Uni-Modal Soft-Label Alignment for Image ...

Figure 1 from A Deep Semantic Alignment Network for the Cross-Modal ...

Figure 1 from Multilevel Semantic Interaction Alignment for Video–Text ...
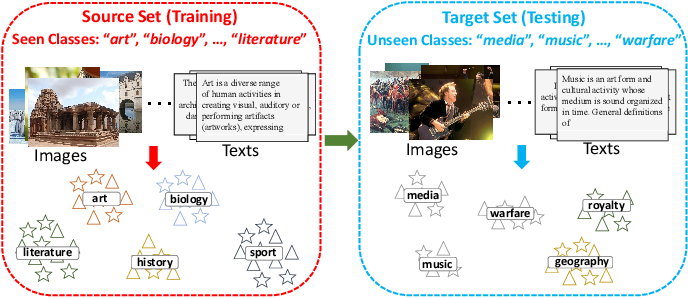
Figure 1 from Correlated Features Synthesis and Alignment for Zero-shot ...

Figure 1 from Aligning Images and Text with Semantic Role Labels for ...
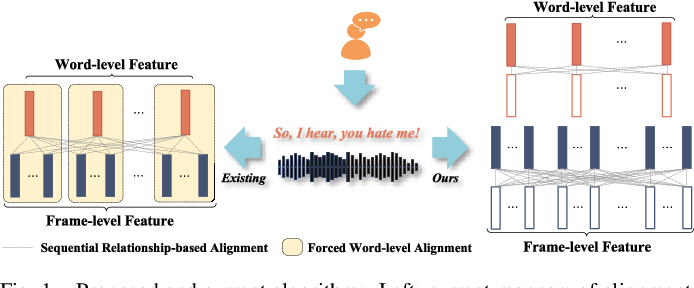
Figure 1 from Semantic Alignment Network for Multi-Modal Emotion ...
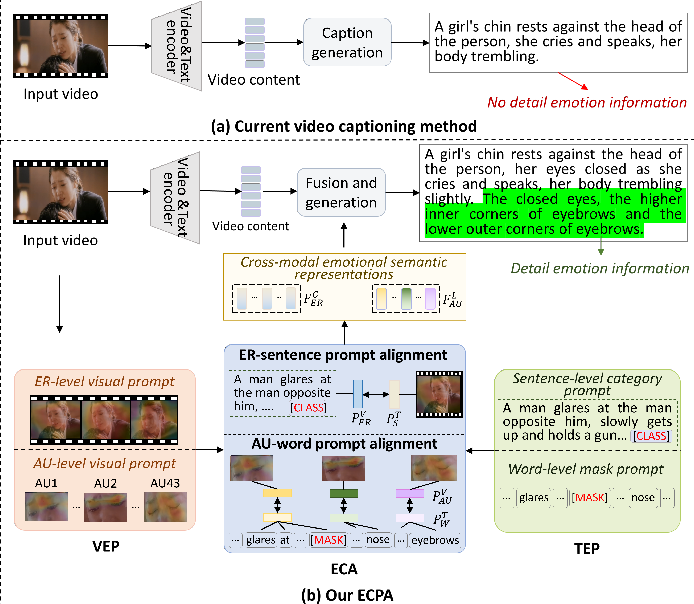
Figure 1 from Emotion-Oriented Cross-Modal Prompting and Alignment for ...
Advertisement Space (336x280)

Figure 1 from Cross-Modal Feature Alignment and MMD Improve Robustness ...

Figure 1 from Cross-Modal Cross-Domain Moment Alignment Network for ...

Figure 1 from Improving Cross-modal Alignment for Text-Guided Image ...

Figure 1 from Cross-Modal Learning for Domain Adaptation in 3D Semantic ...

Figure 1 from Cross-Modal Cross-Domain Dual Alignment Network for RGB ...

Figure 4 from Multi-level Alignment Network for Domain Adaptive Cross ...

Figure 3 from Multi-level Alignment Network for Domain Adaptive Cross ...

Figure 1 from Multi-Modal Cross-Domain Alignment Network for Video ...

Figure 1 from Fine-Grained Alignment for Cross-Modal Recipe Retrieval ...

Figure 1 from Learning Relation Alignment for Calibrated Cross-modal ...
Advertisement Space (336x280)
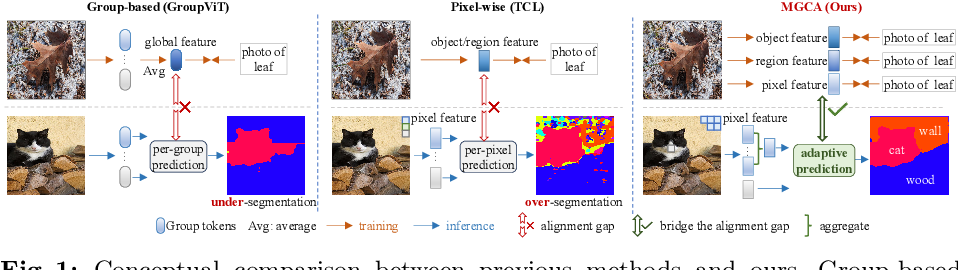
Figure 1 from Multi-Grained Cross-modal Alignment for Learning Open ...

Figure 1 from Cross-Modal Learning for Event-Based Semantic ...

Figure 1 from Cross-modal Semantic Enhanced Interaction for Image ...

Figure 1 from Multi-Prompts Learning with Cross-Modal Alignment for ...

Figure 1 from Semantics-Enriched Cross-Modal Alignment for Complex ...
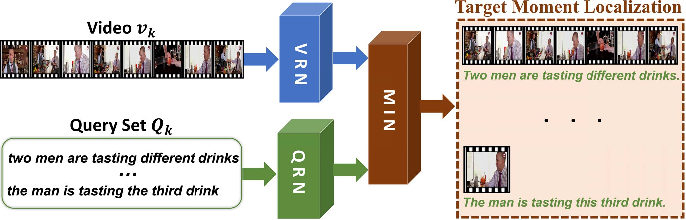
Figure 2 from Coarse-to-Fine Semantic Alignment for Cross-Modal Moment ...