
Figure 1 From Sequential Speaker Embedding And Transfer Learning For
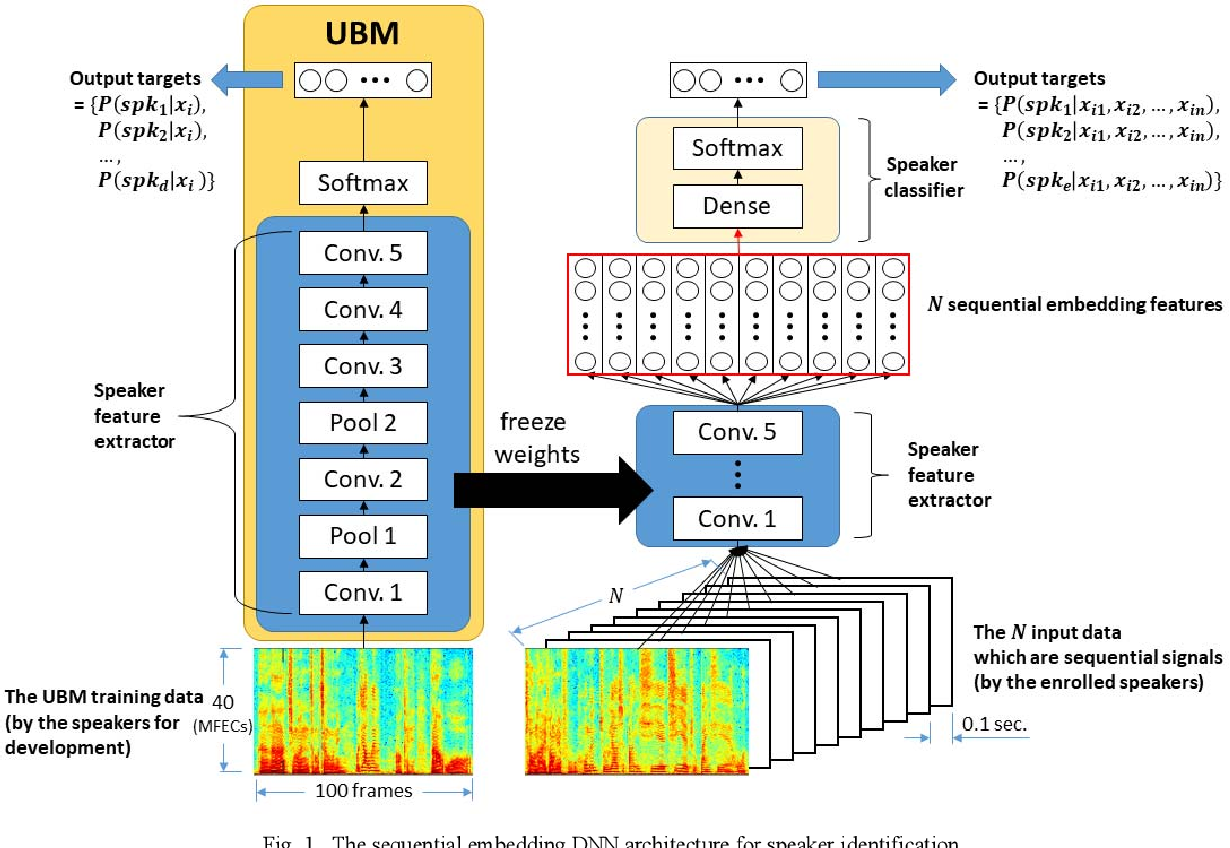
Figure 1 from Sequential Speaker Embedding and Transfer Learning for ...
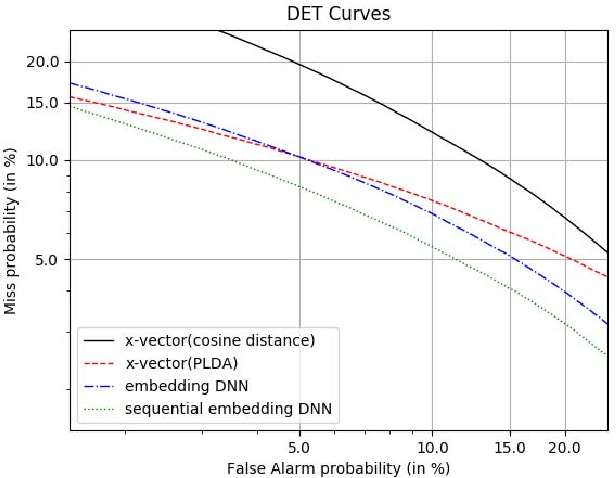
Figure 1 from Sequential Speaker Embedding and Transfer Learning for ...
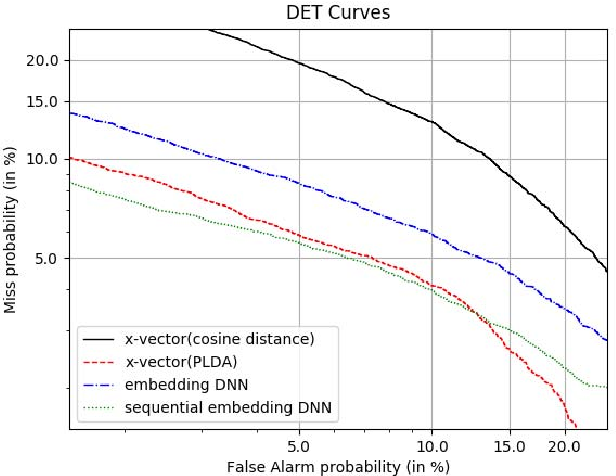
Figure 1 from Sequential Speaker Embedding and Transfer Learning for ...

Figure 1 from Channel Invariant Speaker Embedding Learning with Joint ...
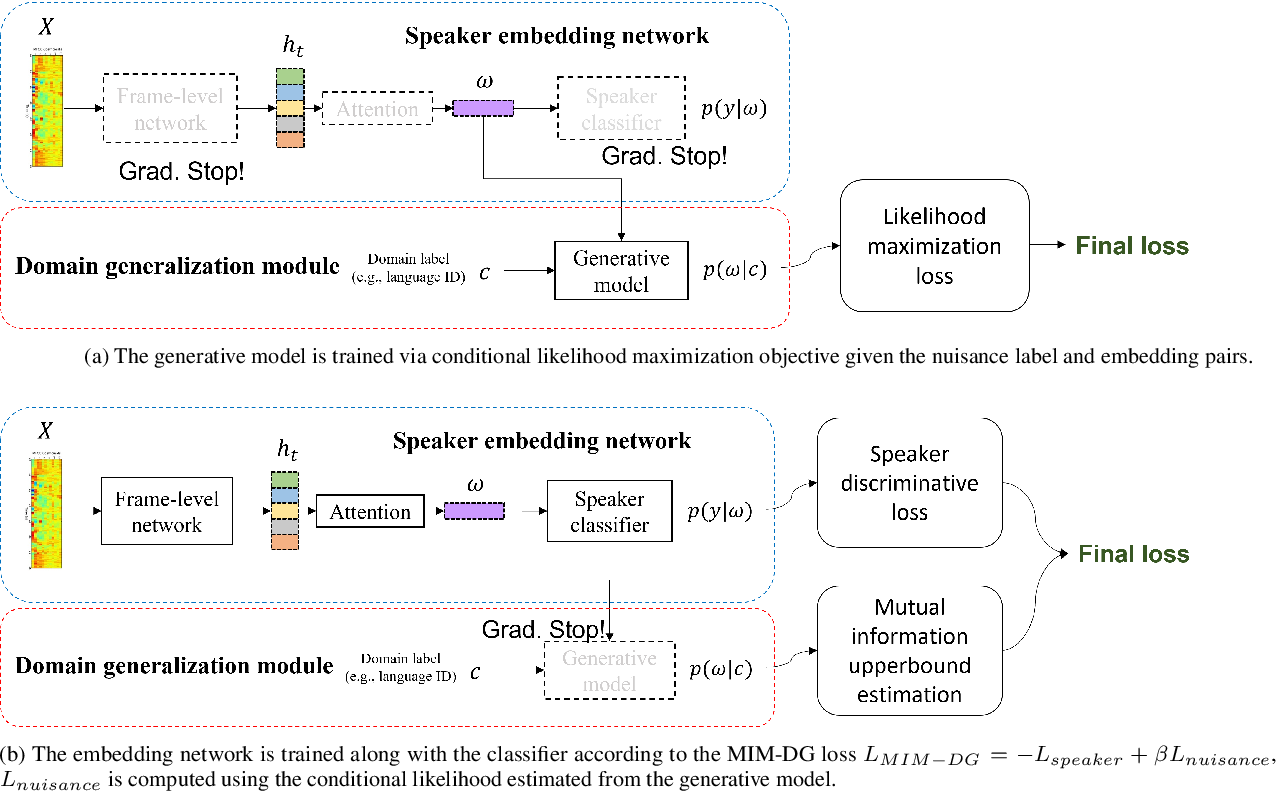
Figure 1 from Domain Generalized Speaker Embedding Learning via Mutual ...
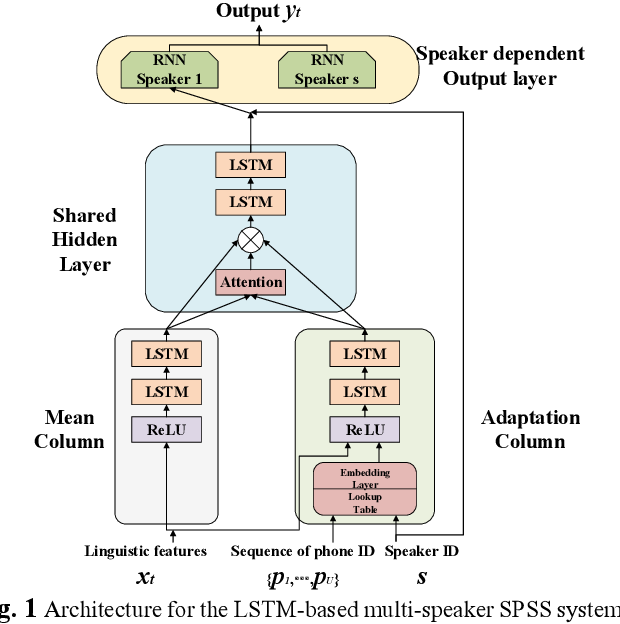
Figure 1 from Phoneme Dependent Speaker Embedding and Model ...

Figure 1 from Towards Interpretable Explanations for Transfer Learning ...

Figure 1 from A Sequence and Network Embedding Method for Bus Arrival ...
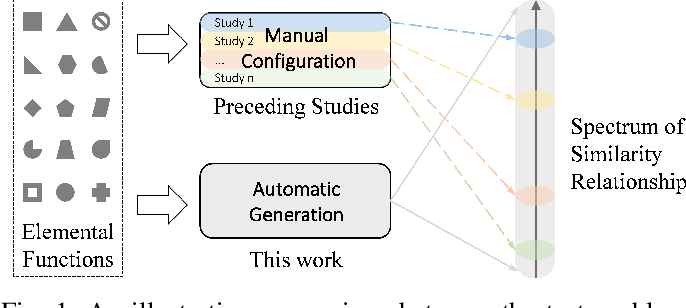
Figure 1 from A Scalable Test Problem Generator for Sequential Transfer ...

Figure 1 from Vision-Guided Speaker Embedding Based Speech Separation ...
Advertisement Space (300x250)

Figure 1 from Contrastive Self-Supervised Speaker Embedding With ...
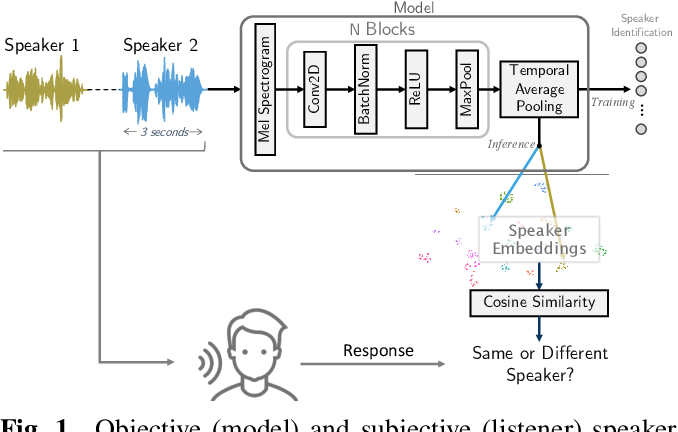
Figure 1 from Perceptual Analysis of Speaker Embeddings for Voice ...

Figure 1 from Cross-Speaker Style Transfer for Text-to-Speech Using ...

Figure 1 from Deeply Fused Speaker Embeddings for Text-Independent ...
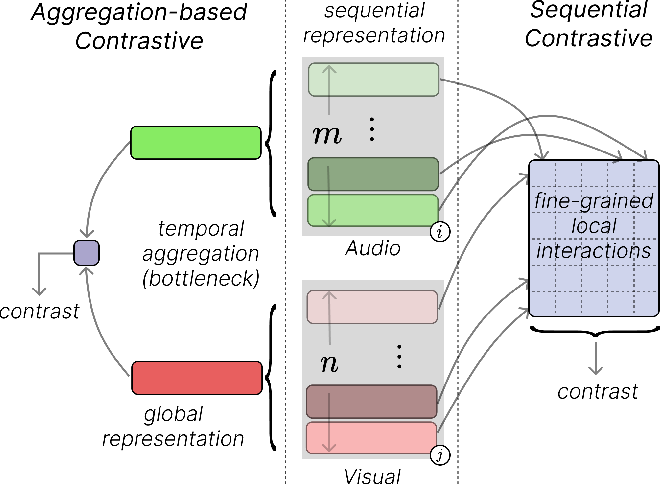
Figure 1 from Sequential Contrastive Audio-Visual Learning | Semantic ...

Figure 1 from Hardware Architectures for Embedded Speaker Recognition ...

Figure 1 from Learning Speaker Representation with Semi-supervised ...

Figure 1 from S-Vectors and TESA: Speaker Embeddings and a Speaker ...

Figure 1 from Target Speaker Extraction with Curriculum Learning ...
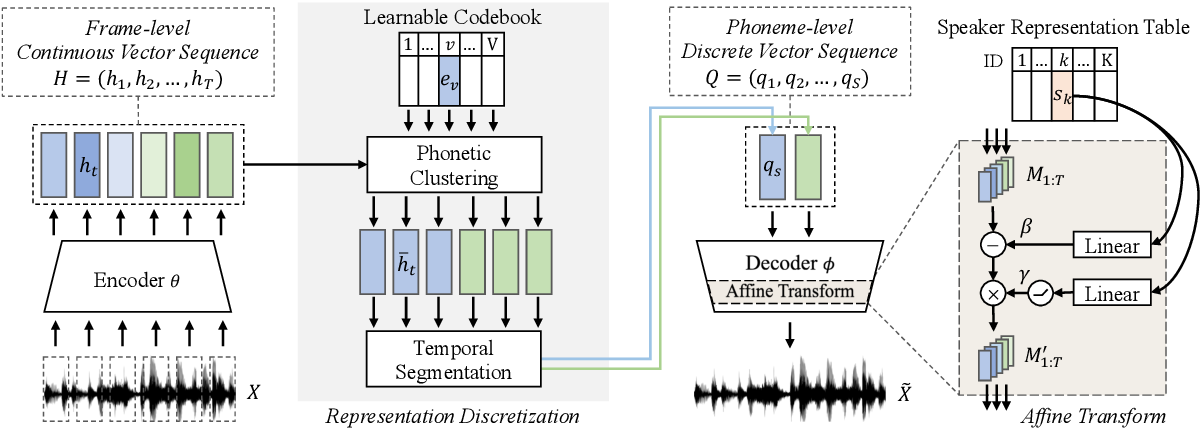
Figure 1 from Semi-supervised Learning for Multi-speaker Text-to-speech ...
Advertisement Space (336x280)
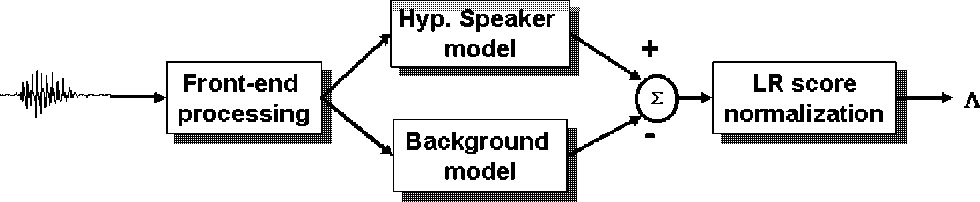
Figure 1 from Approaches to Speaker Detection and Tracking in ...

Figure 1 from MSSRNet: Manipulating Sequential Style Representation for ...
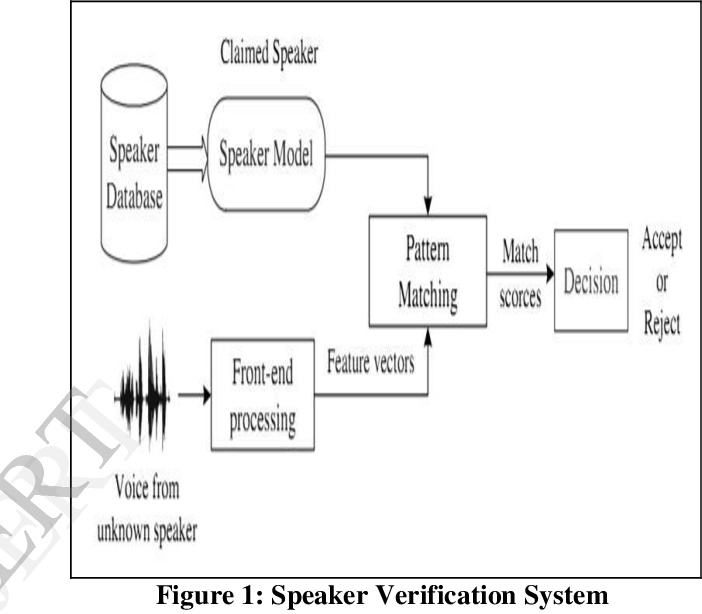
Figure 1 from A Review On Speaker Recognition Approaches And Challenges ...
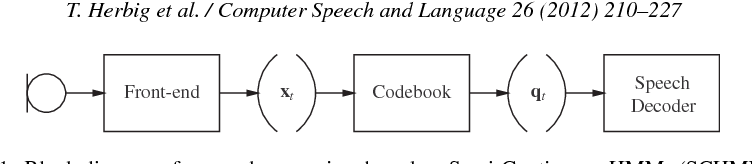
Figure 1 from Self-learning speaker identification for enhanced speech ...

Figure 1 from End-to-End Multi-Speaker Speech Recognition using Speaker ...
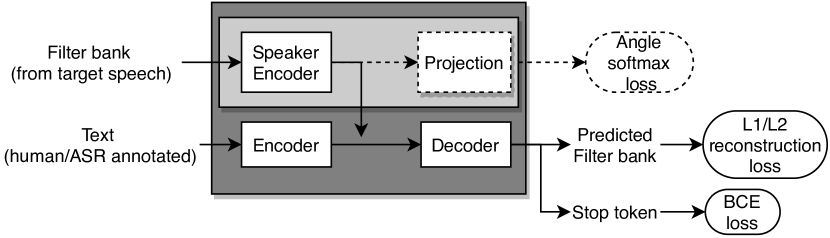
[2010.11221] Learning Speaker Embedding from Text-to-Speech
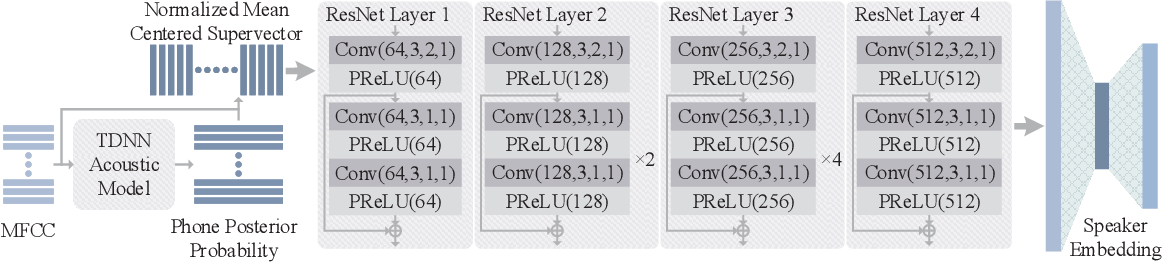
Figure 1 from Deep Speaker Embeddings with Convolutional Neural Network ...

Figure 1 from Few-Shot Sequence Labeling with Label Dependency Transfer ...

Transfer Learning from Speaker Verification to Multispeaker Text-To ...
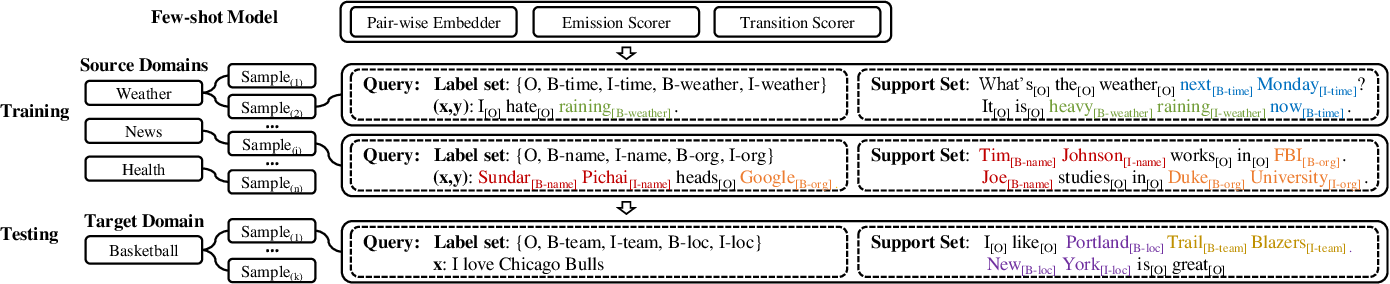
Figure 1 from Few-Shot Sequence Labeling with Label Dependency Transfer ...
Advertisement Space (336x280)

Graph embedding and transfer learning can help predict potential ...
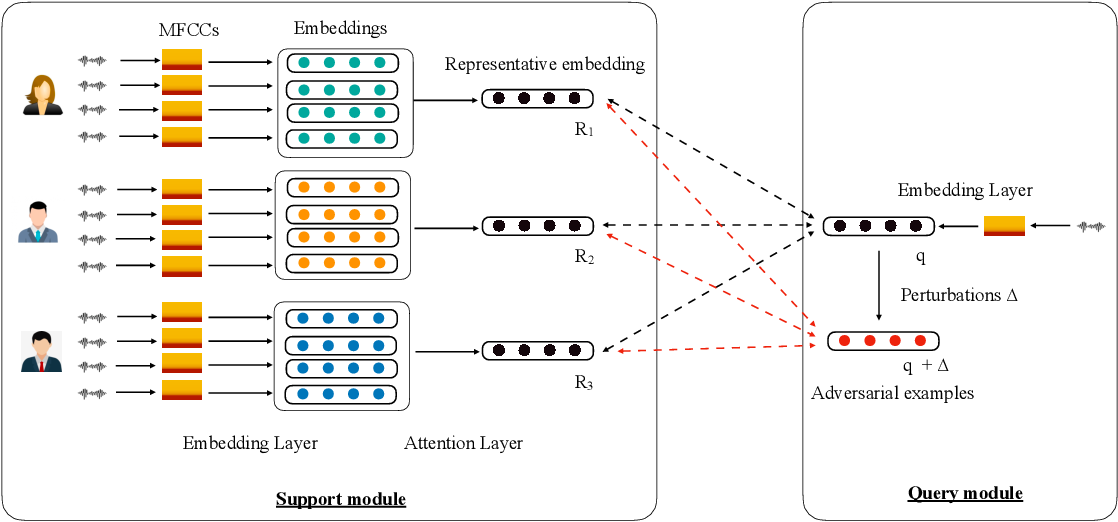
Figure 1 from Automatic Speaker Recognition with Limited Data ...

Figure 1 from Speech Rhythm-Based Speaker Embeddings Extraction from ...
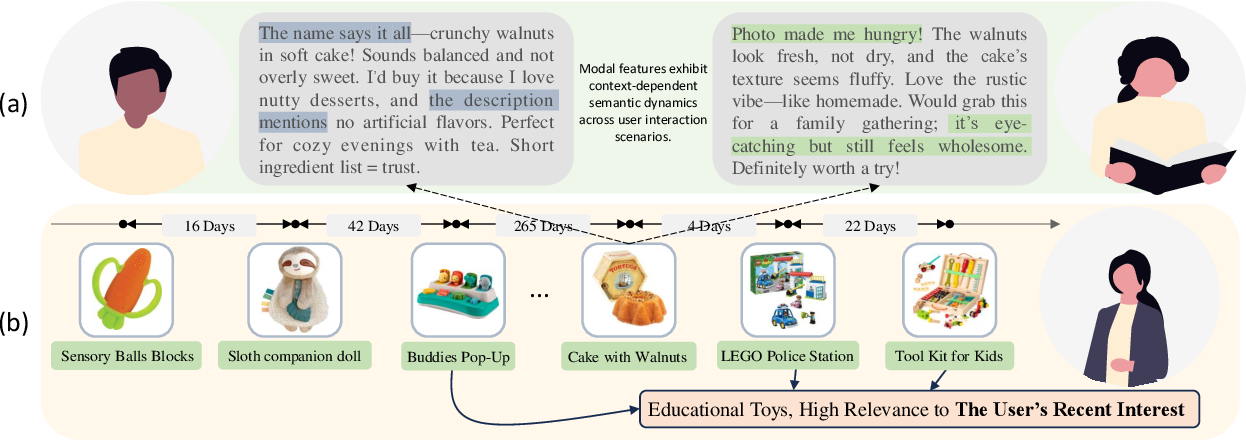
Figure 1 from Towards Transfer-Efficient Multi-modal Sequential ...
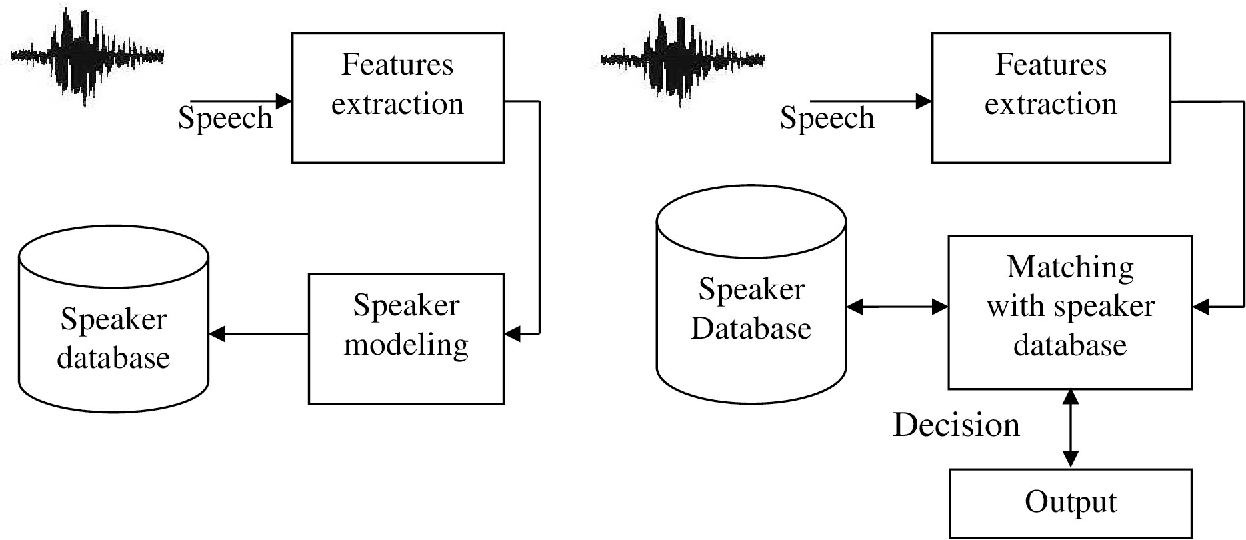
Figure 1 from Enhancing speaker identification through reverberation ...
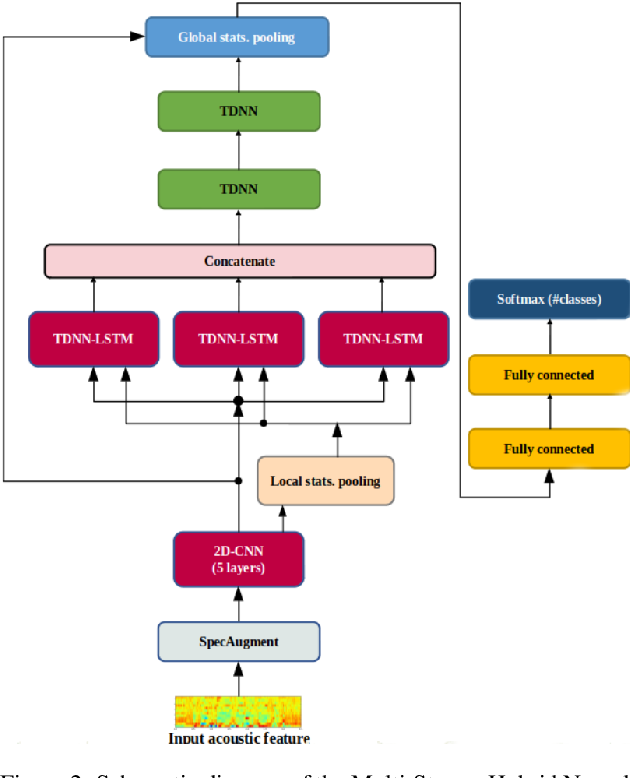
Figure 2 from Investigation on Deep Speaker Embedding Extraction ...