
Figure 1 From Strapper Preference Based Reinforcement Learning Via

Figure 1 from STRAPPER: Preference-based Reinforcement Learning via ...

Figure 1 from Model-Based Reinforcement Learning via Proximal Policy ...
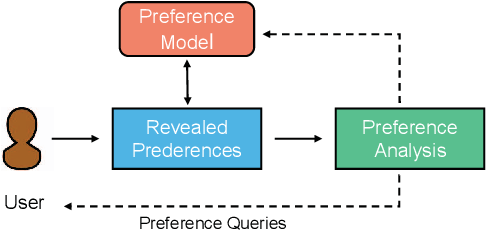
Figure 1 from A Two-Stage Preference Learning Method based on Graph ...

Figure 1 from PREFERENCE-BASED REINFORCEMENT LEARNING | Semantic Scholar

Figure 1 from A Survey of Preference-Based Reinforcement Learning ...

Figure 1 from A Preference-based Reinforcement Learning Approach Using ...
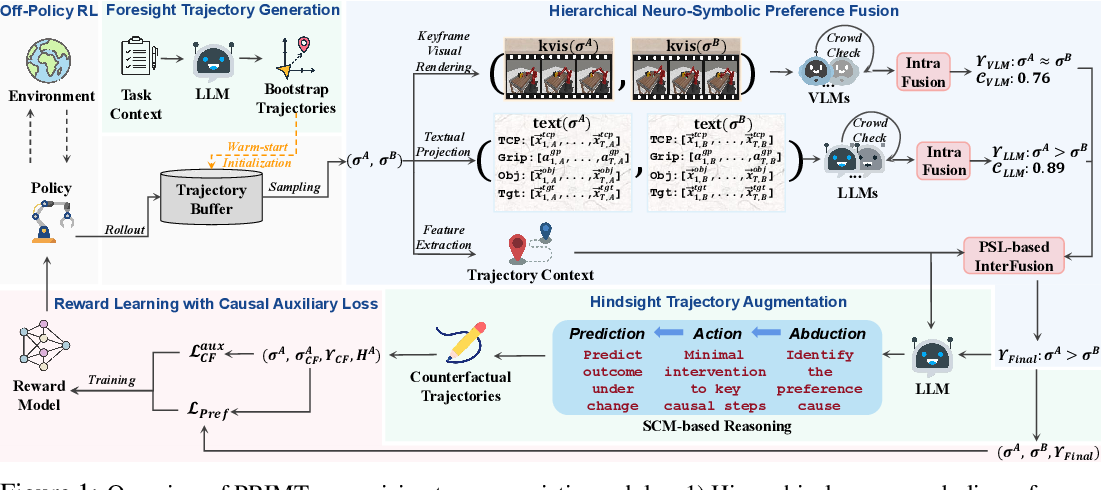
Figure 1 from PRIMT: Preference-based Reinforcement Learning with ...

Figure 1 from Sample-Efficient Preference-based Reinforcement Learning ...

Figure 1 from Interpretable Preference-based Reinforcement Learning ...

Figure 1 from PRIMT: Preference-based Reinforcement Learning with ...
Advertisement Space (300x250)
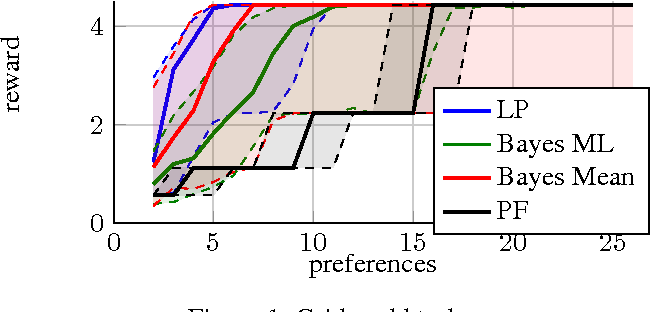
Figure 1 from Model-Free Preference-Based Reinforcement Learning ...

Figure 1 from PRIMT: Preference-based Reinforcement Learning with ...

Figure 1 from Subject-driven Text-to-Image Generation via Preference ...
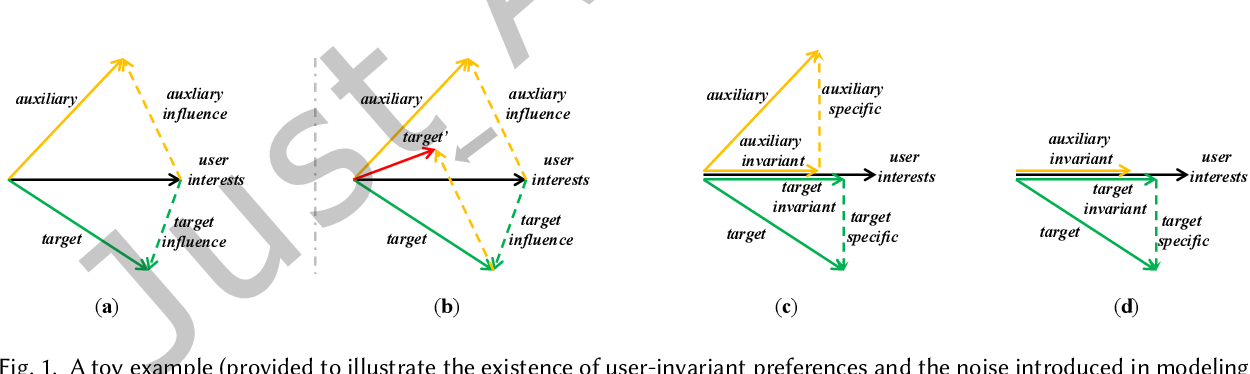
Figure 1 from User Invariant Preference Learning for Multi-Behavior ...

Figure 1 from Fairness in Preference-based Reinforcement Learning ...
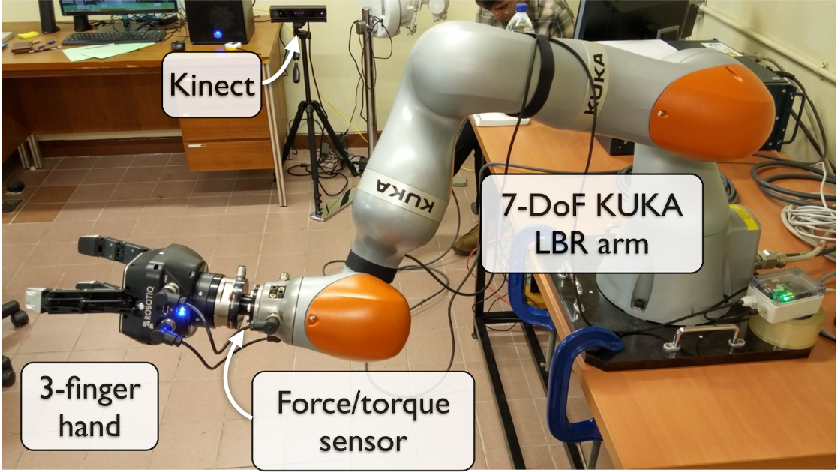
Figure 1 from A Survey of Preference-Based Reinforcement Learning ...
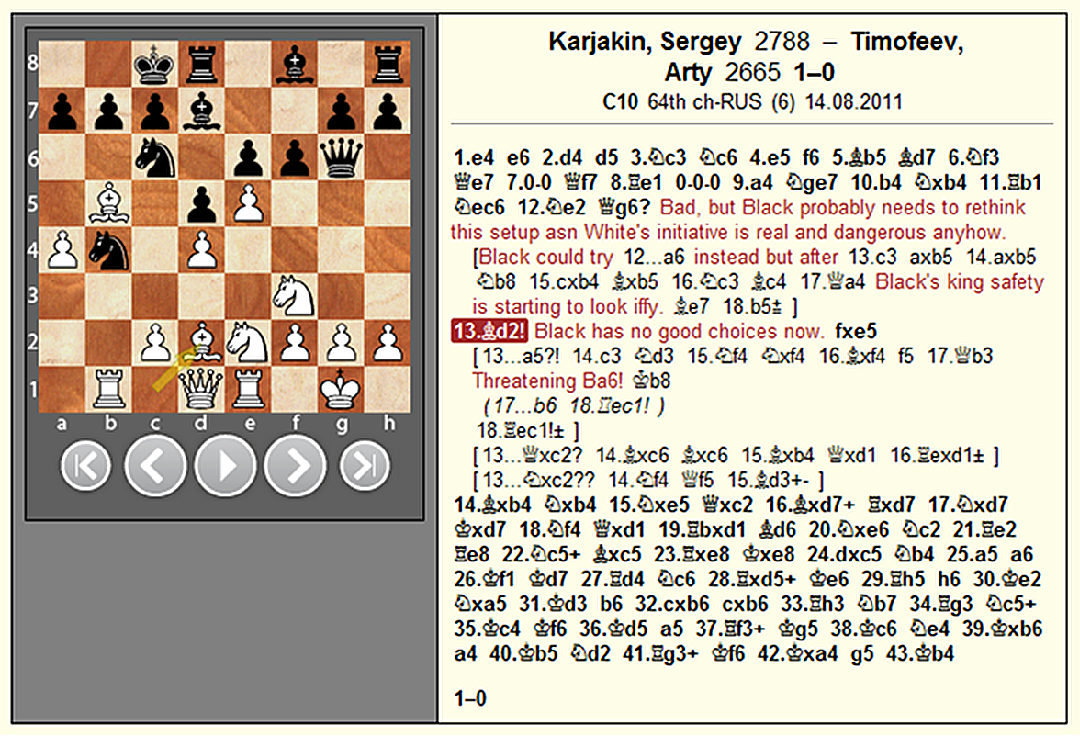
Figure 1 from A Survey of Preference-Based Reinforcement Learning ...
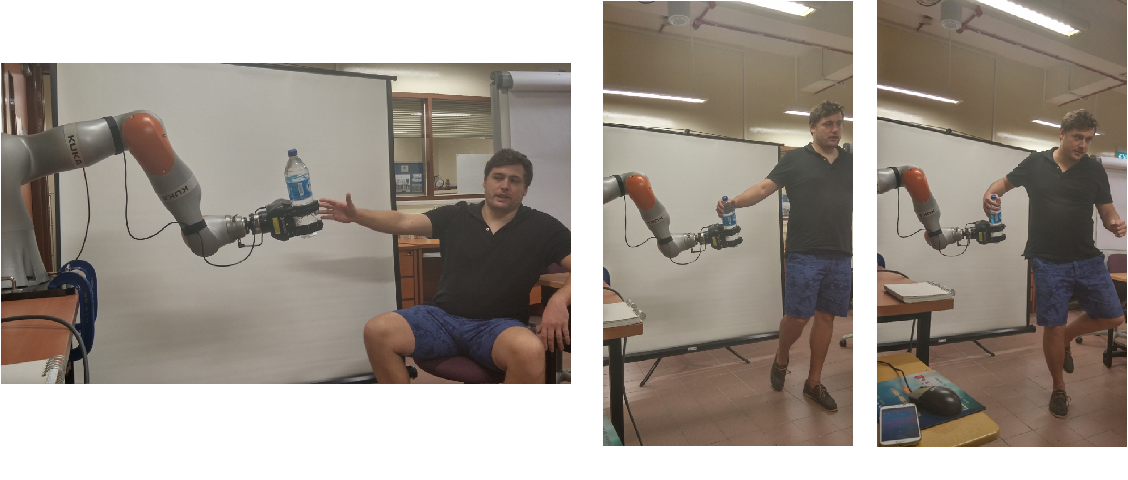
Figure 1 from A Survey of Preference-Based Reinforcement Learning ...
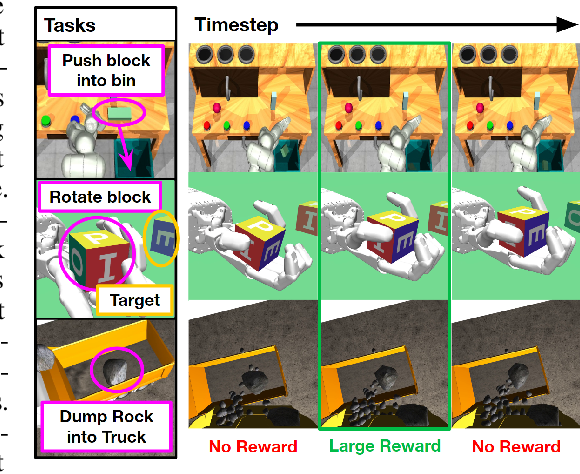
Figure 1 from DreamSmooth: Improving Model-based Reinforcement Learning ...

Figure 2 from Zero-shot Preference Learning for Offline RL via Optimal ...
Advertisement Space (336x280)

Figure 1 from SURF: Semi-supervised Reward Learning with Data ...
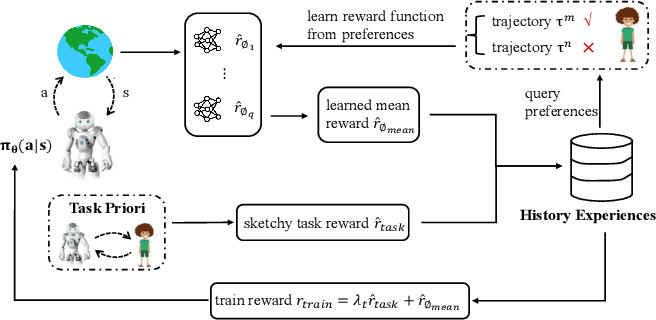
Figure 1 from Task Decoupling in Preference-based Reinforcement ...

Figure 1 from Human-in-the-Loop Policy Optimization for Preference ...
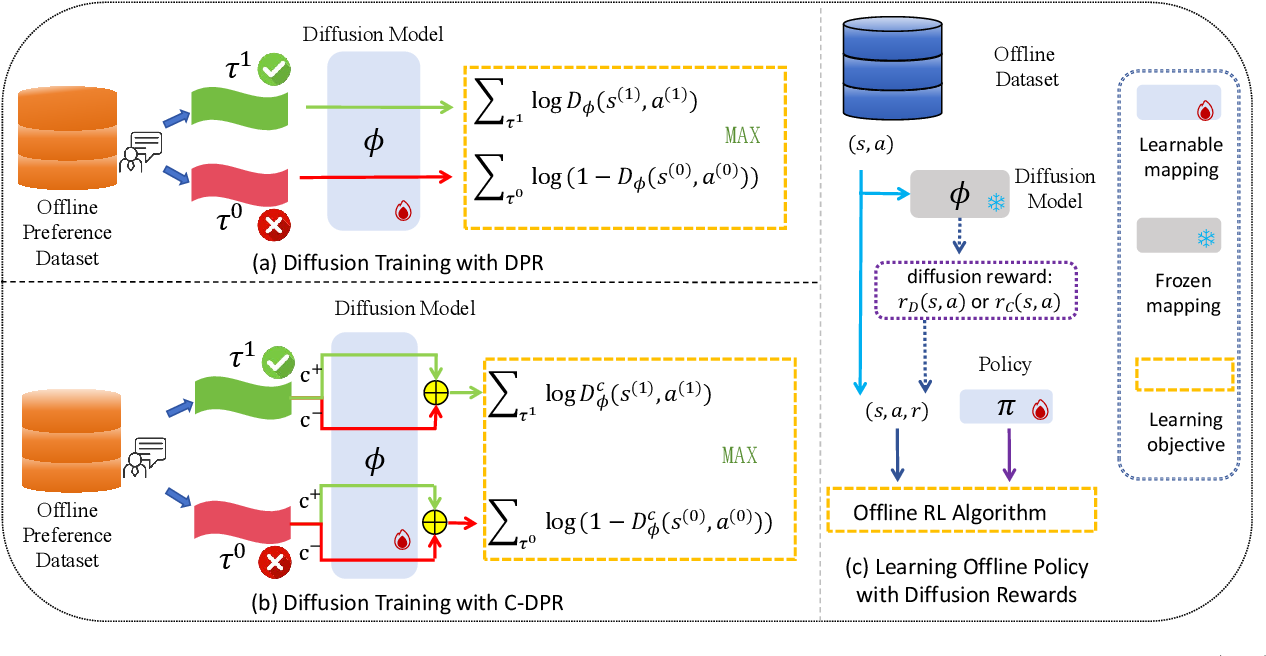
Figure 1 from Diffusion Classifier-Driven Reward for Offline Preference ...

Figure 1 from Hindsight PRIORs for Reward Learning from Human ...

Figure 1 from Learning to Draw Through A Multi-Stage Environment Model ...

Efficient Reinforcement Learning from Human Feedback via Bayesian ...
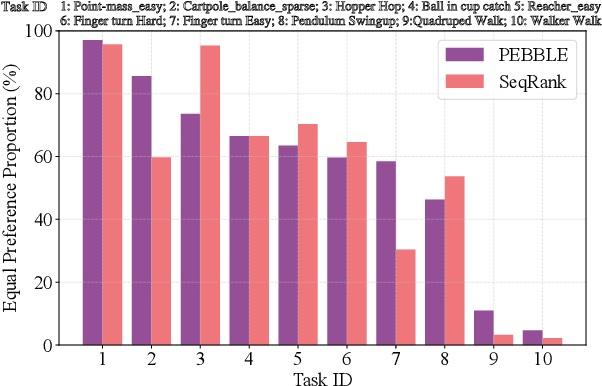
Figure 1 from Multi-Type Preference Learning: Empowering Preference ...

Figure 1 from Preference Alignment with Flow Matching | Semantic Scholar
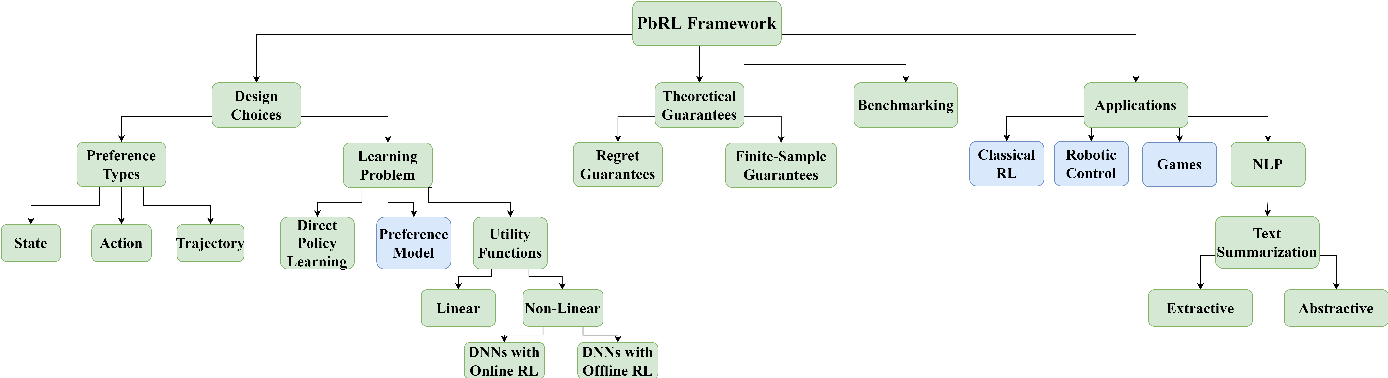
Figure 1 from Advances in Preference-based Reinforcement Learning: A ...
Advertisement Space (336x280)

Multi-turn Reinforcement Learning from Preference Human Feedback | AI ...
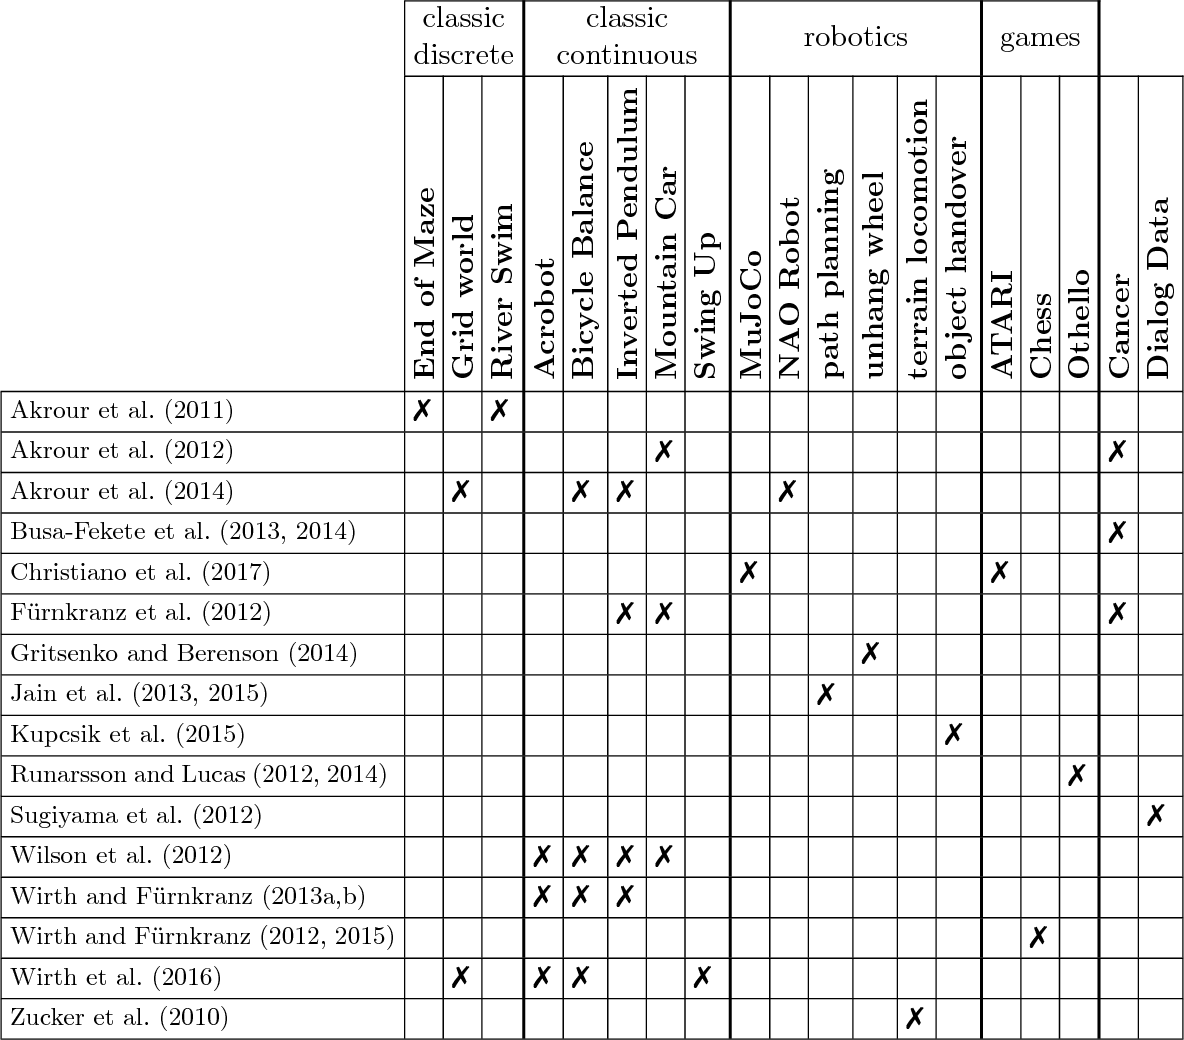
Table 1 from A Survey of Preference-Based Reinforcement Learning ...
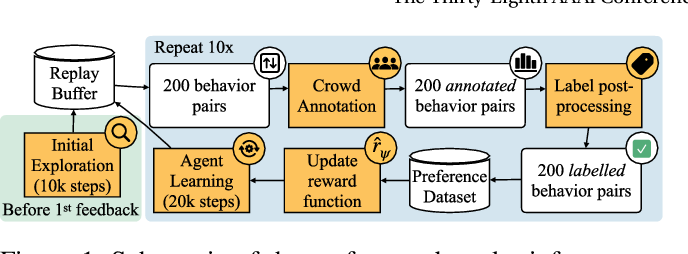
Figure 1 from Can You Rely on Synthetic Labellers in Preference-Based ...

Efficient Preference-based Reinforcement Learning via Aligned ...

Figure 1 from Meta-Reward-Net: Implicitly Differentiable Reward ...
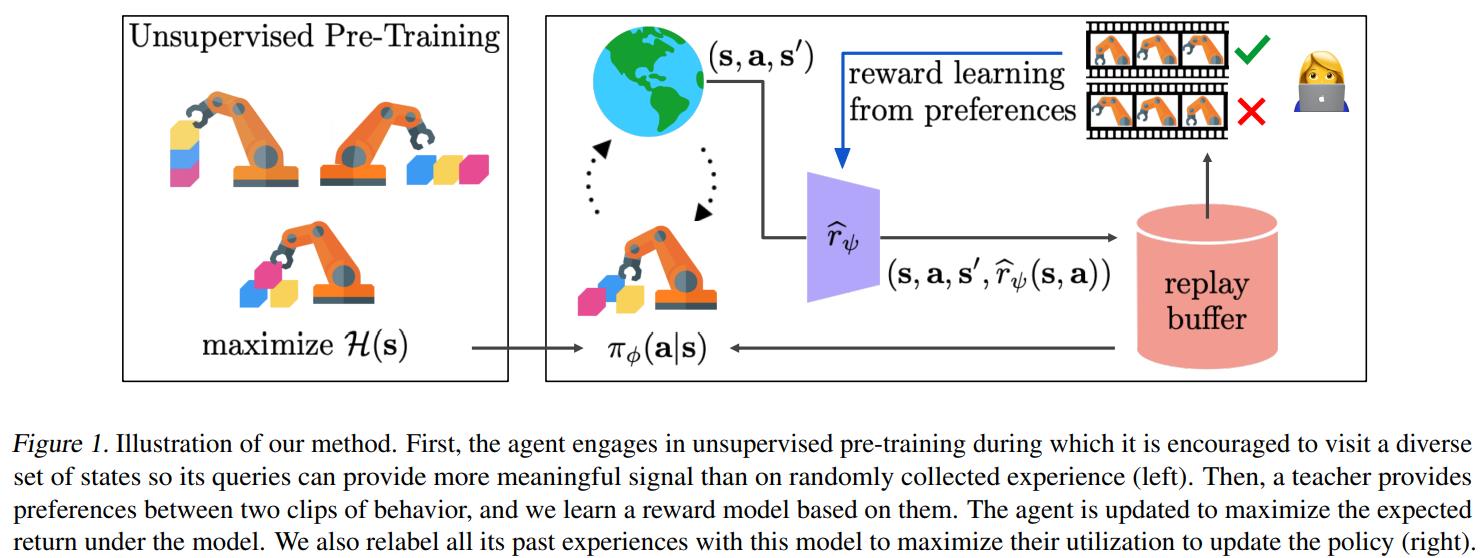
Module 7: Human-in-the-loop autonomy - Preference Based Reinforcement ...