
Figure 1 From View Invariant Learning For Vision Language Navigation In

Figure 1 from View Invariant Learning for Vision-Language Navigation in ...

Figure 1 from Learning View and Target Invariant Visual Servoing for ...
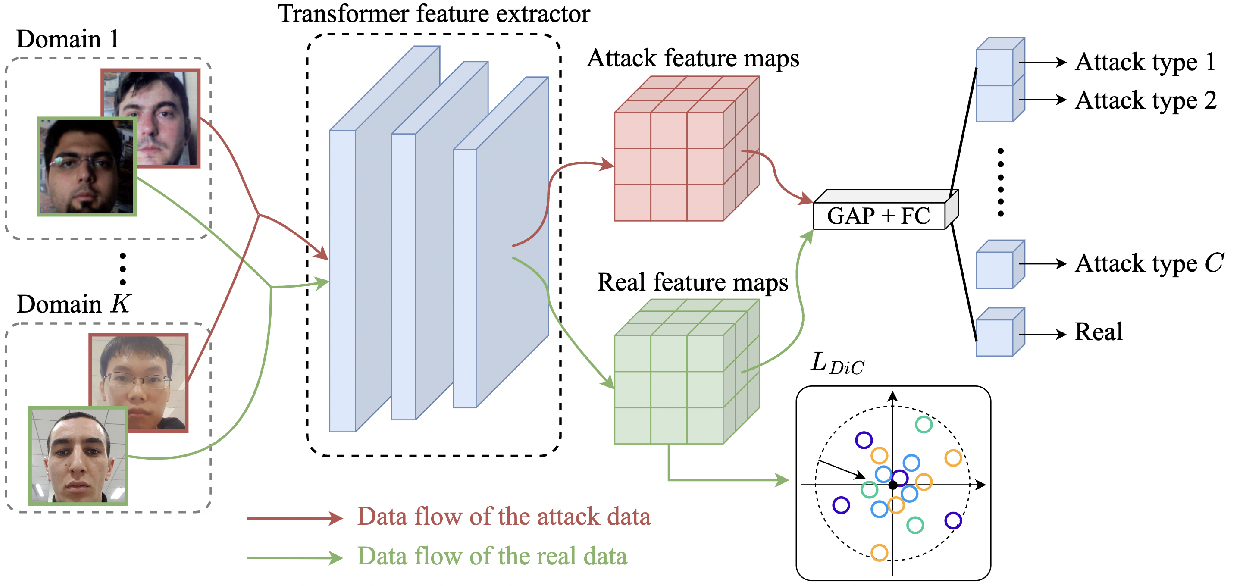
Figure 1 from Domain Invariant Vision Transformer Learning for Face ...

Figure 1 from Learning View and Target Invariant Visual Servoing for ...

View Invariant Learning for Vision-Language Navigation in Continuous ...

Figure 1 from Learning Invariant Object and Spatial View ...
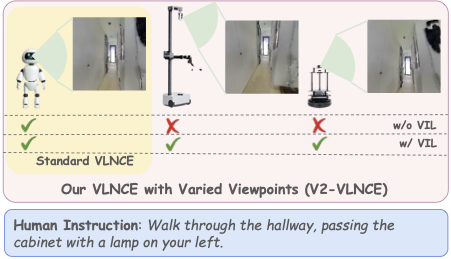
View Invariant Learning for Vision-Language Navigation in Continuous ...
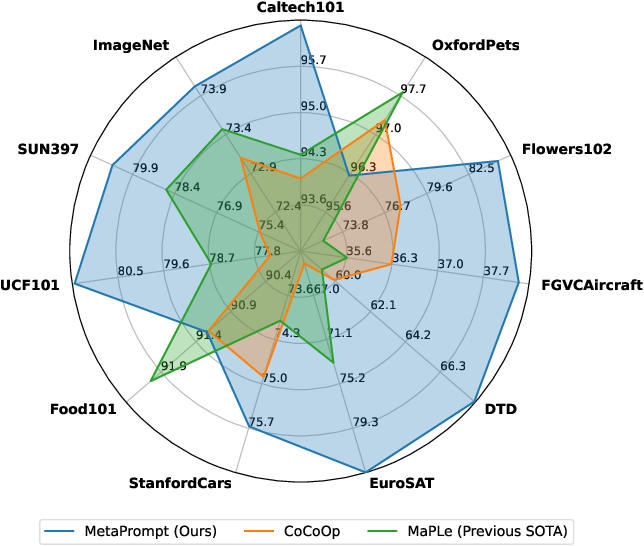
Figure 1 from Learning Domain Invariant Prompt for Vision-Language ...

Figure 2 from Learning View and Target Invariant Visual Servoing for ...

Figure 1 from Learning Domain Invariant Prompt for Vision-Language ...
Advertisement Space (300x250)
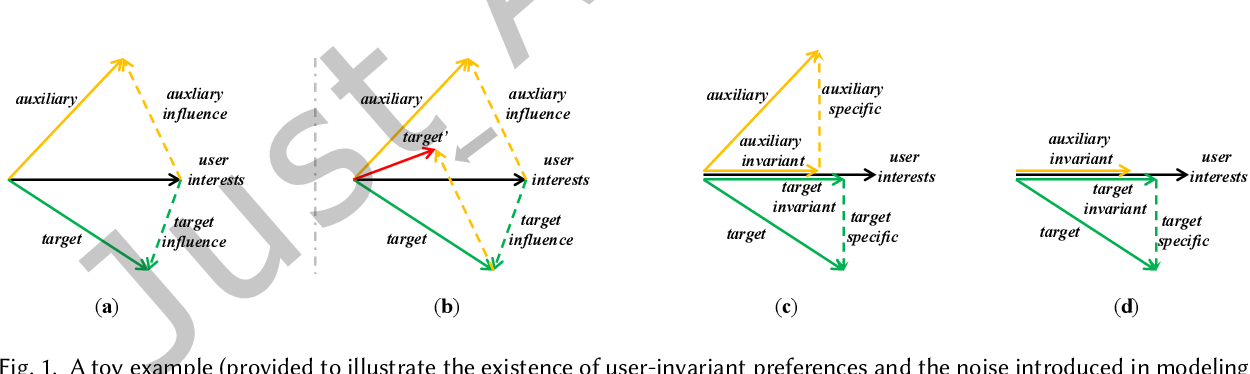
Figure 1 from User Invariant Preference Learning for Multi-Behavior ...

Figure 1 from Domain-Wise Invariant Learning for Panoptic Scene Graph ...
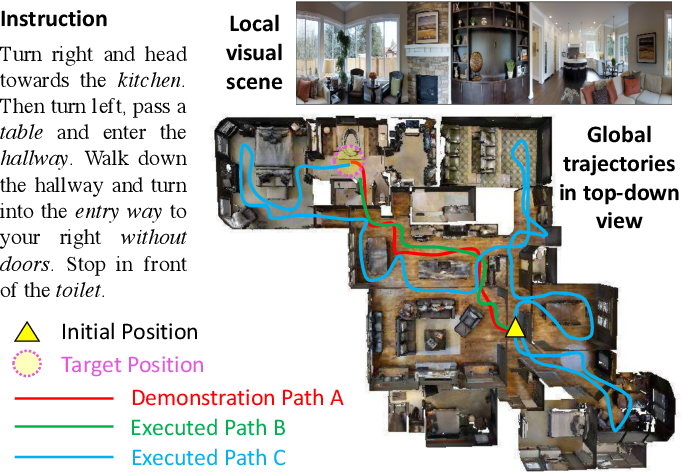
Figure 1 from Vision-Language Navigation Policy Learning and Adaptation ...

Figure 1 from Vision-Language Navigation with Continual Learning ...
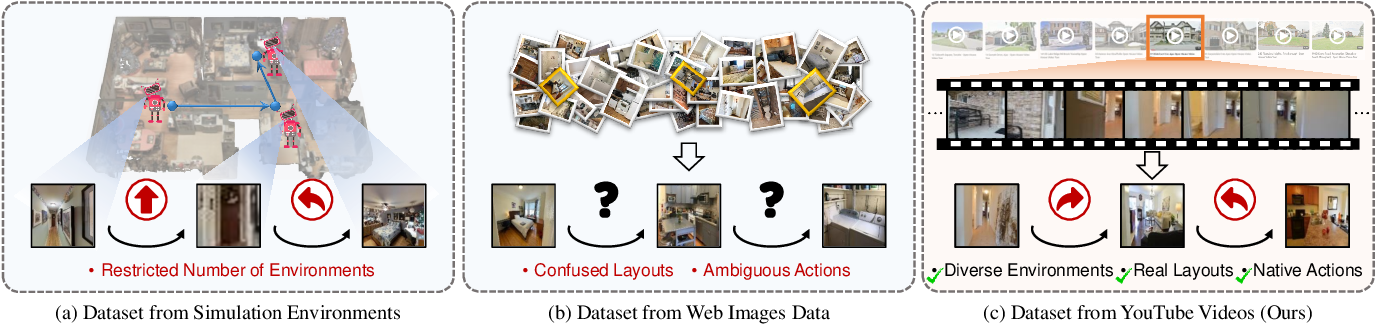
Figure 1 from Learning Vision-and-Language Navigation from YouTube ...
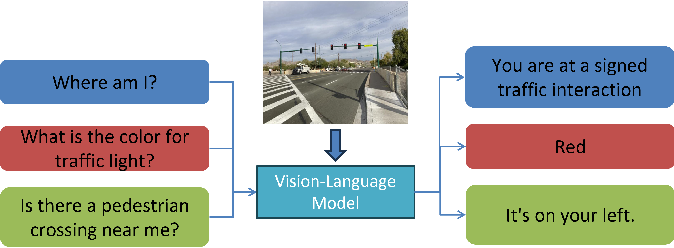
Figure 1 from Fine-Tuning Vision-Language Models for Visual Navigation ...
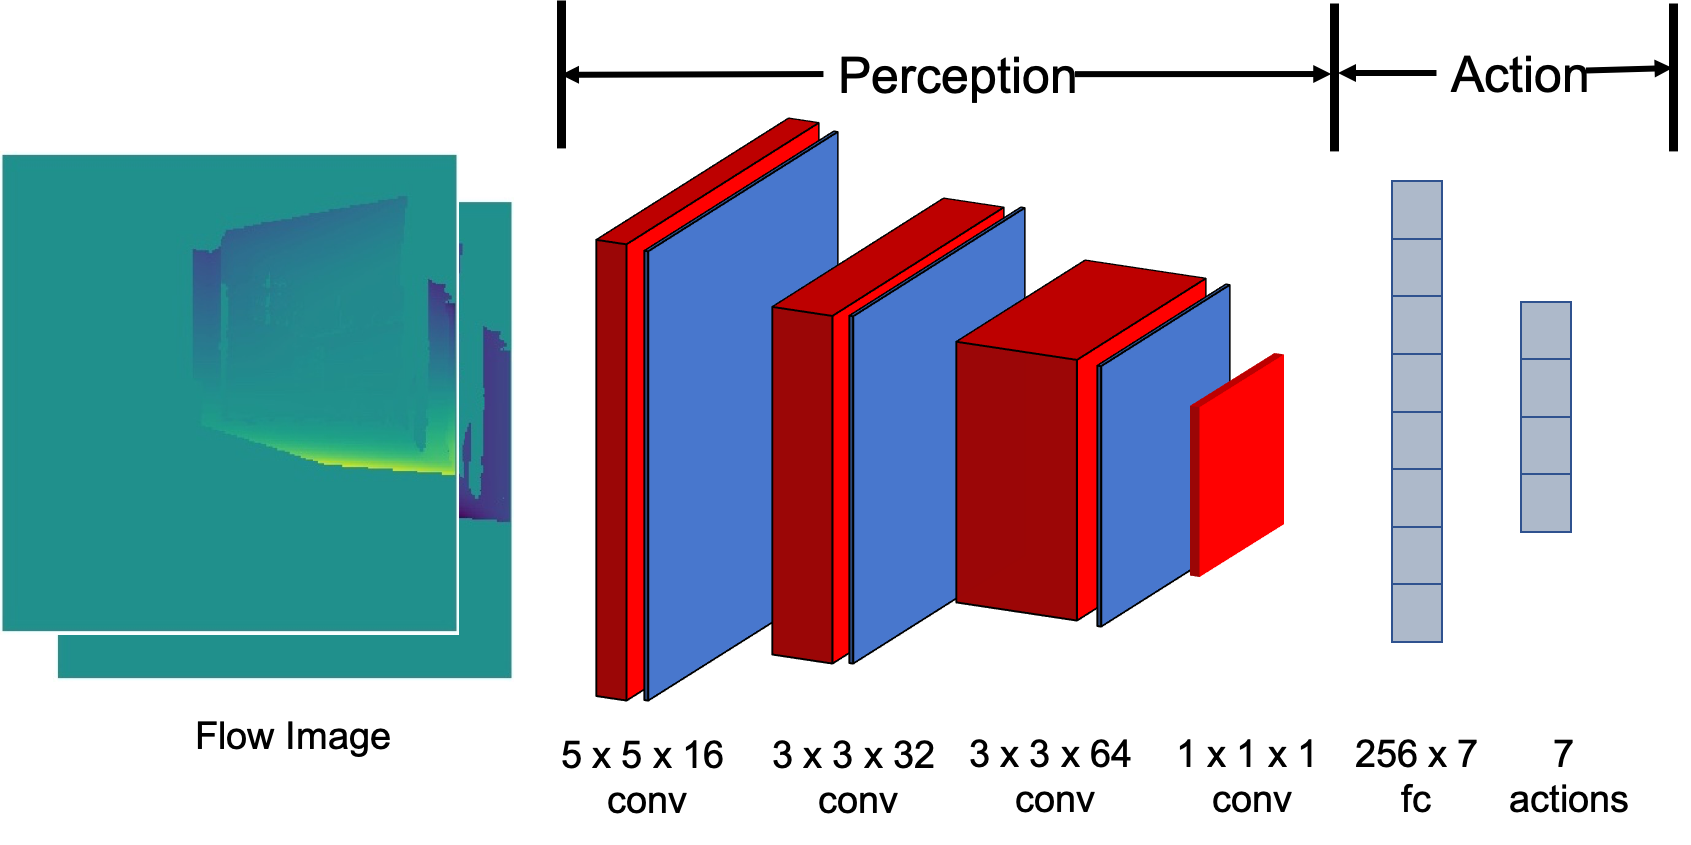
Learning View and Target Invariant Visual Servoing for Navigation

(PDF) Learning View and Target Invariant Visual Servoing for Navigation

Figure 1 from Sim2Real View Invariant Visual Servoing by Recurrent ...

Learning View and Target Invariant Visual Servoing for Navigation
Advertisement Space (336x280)
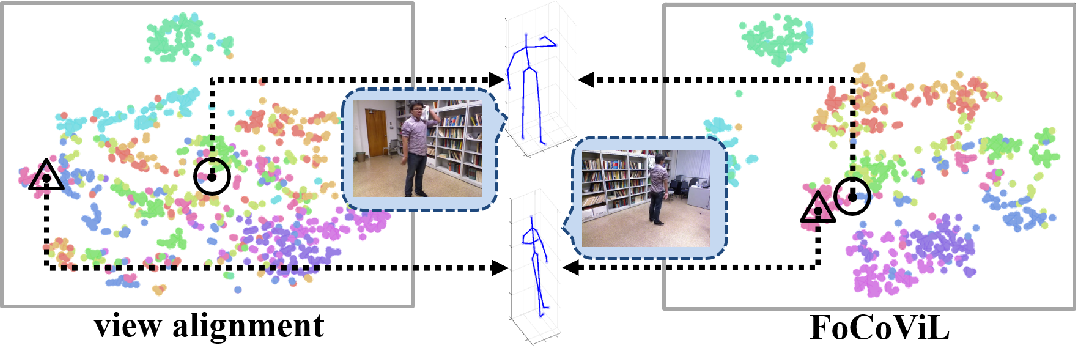
Figure 1 from Focalized Contrastive View-invariant Learning for Self ...
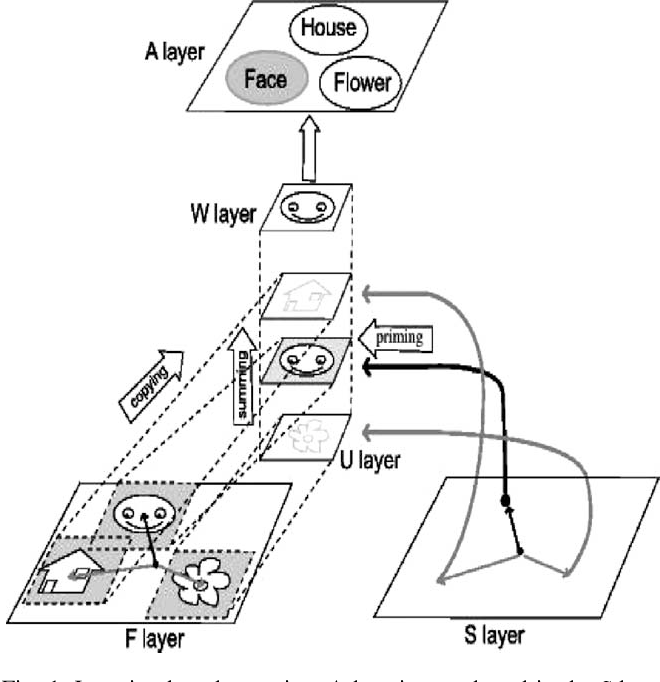
Figure 1 from An integrated network for invariant visual detection and ...
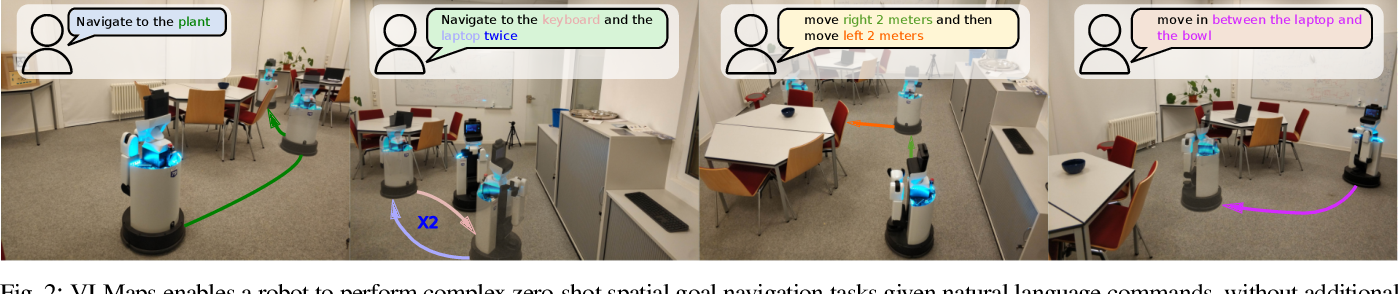
Figure 2 from Visual Language Maps for Robot Navigation | Semantic Scholar

Figure 1 from Viewpoint invariant sign language recognition | Semantic ...
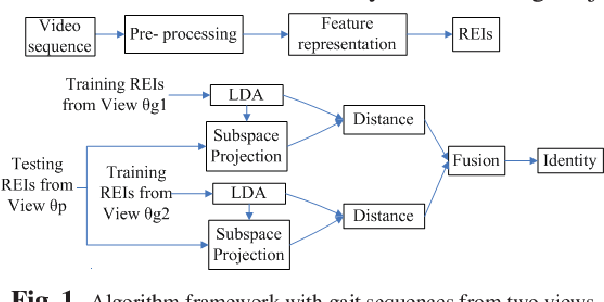
Figure 1 from View invariant gait recognition | Semantic Scholar
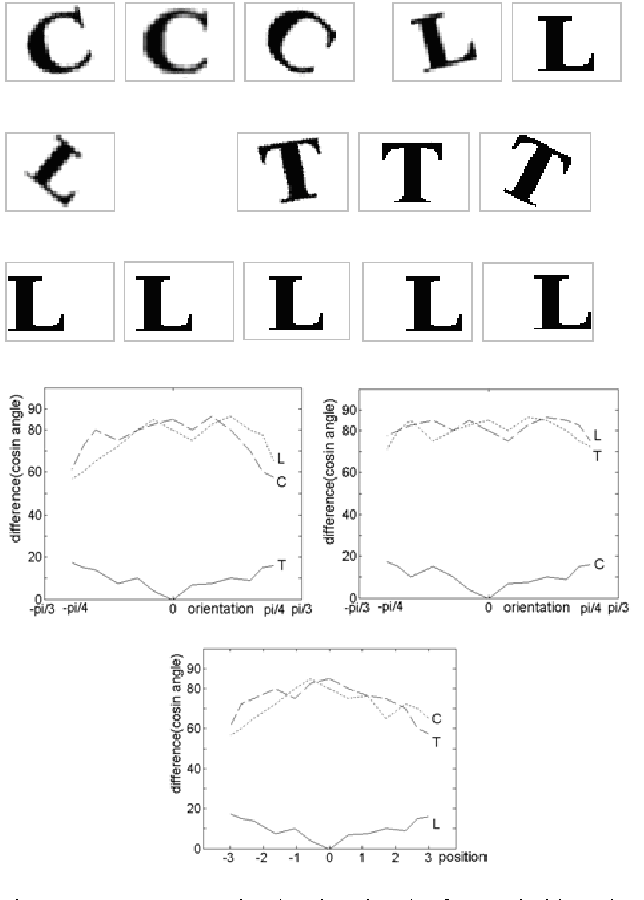
Figure 1 from Learning invariant feature toward recognition modeling ...

Figure 1 from Accurate Robot Navigation Using Visual Invariant Features ...
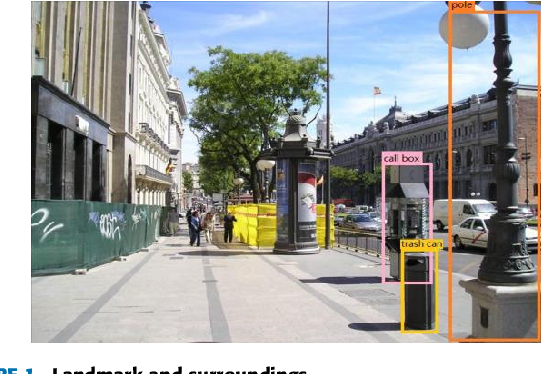
Figure 1 from Visual Navigation Based on Language Assistance and Memory ...
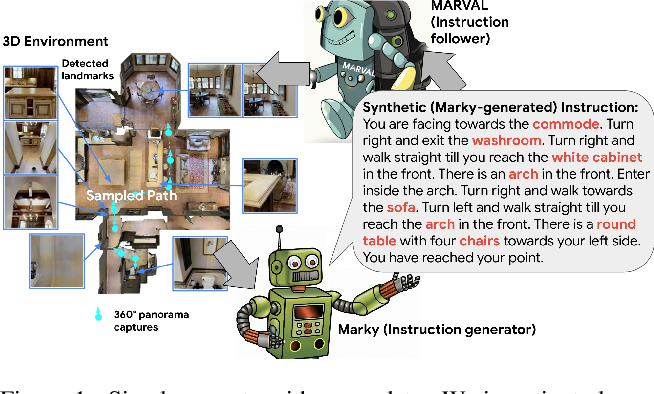
Figure 1 from A New Path: Scaling Vision-and-Language Navigation with ...
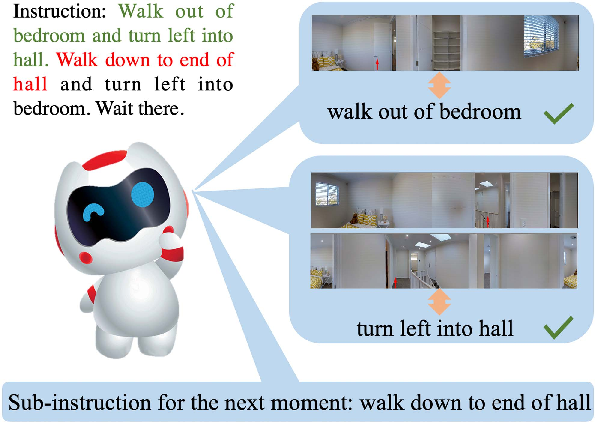
Figure 1 from Vision-and-Language Navigation via Latent Semantic ...
Advertisement Space (336x280)

Figure 1 from Bio-inspired unsupervised learning of visual features ...
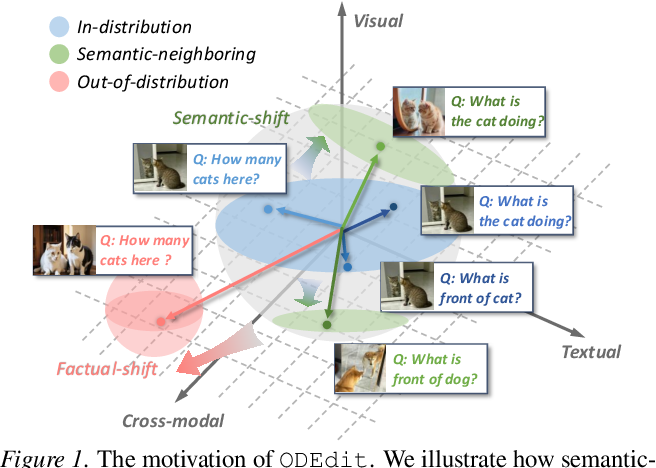
Figure 1 from Generalizable Multimodal Large Language Model Editing via ...

(PDF) UAV-VLN: End-to-End Vision Language guided Navigation for UAVs

Figure 1 from Mapping Natural Language Intents to User Interfaces ...

Figure 1 from Viewpoint Invariant Change Captioning | Semantic Scholar

[Literature Review] Learning Invariant Causal Mechanism from Vision ...