
Figure 1 From Vision And Text Transformer For Predicting Answerability

Figure 1 from Vision And Text Transformer For Predicting Answerability ...

Figure 1 from Vision And Text Transformer For Predicting Answerability ...
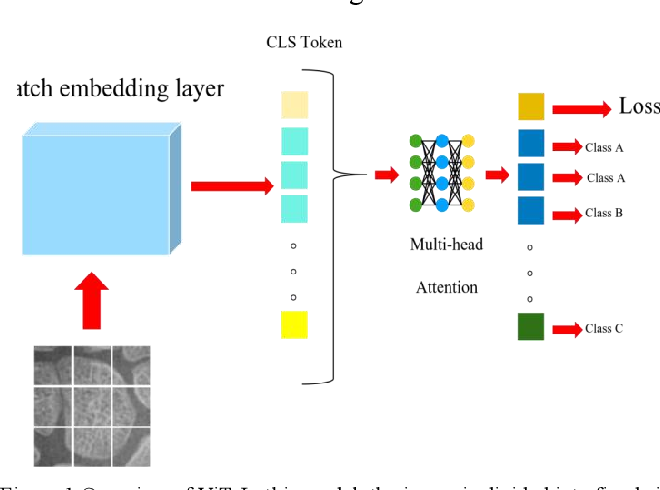
Figure 1 from A method for predicting bone age using Vision Transformer ...

Vision And Text Transformer For Predicting Answerability On Visual ...

VISION AND TEXT TRANSFORMER FOR PREDICTING ANSWERABILITY \\ON VISUAL ...
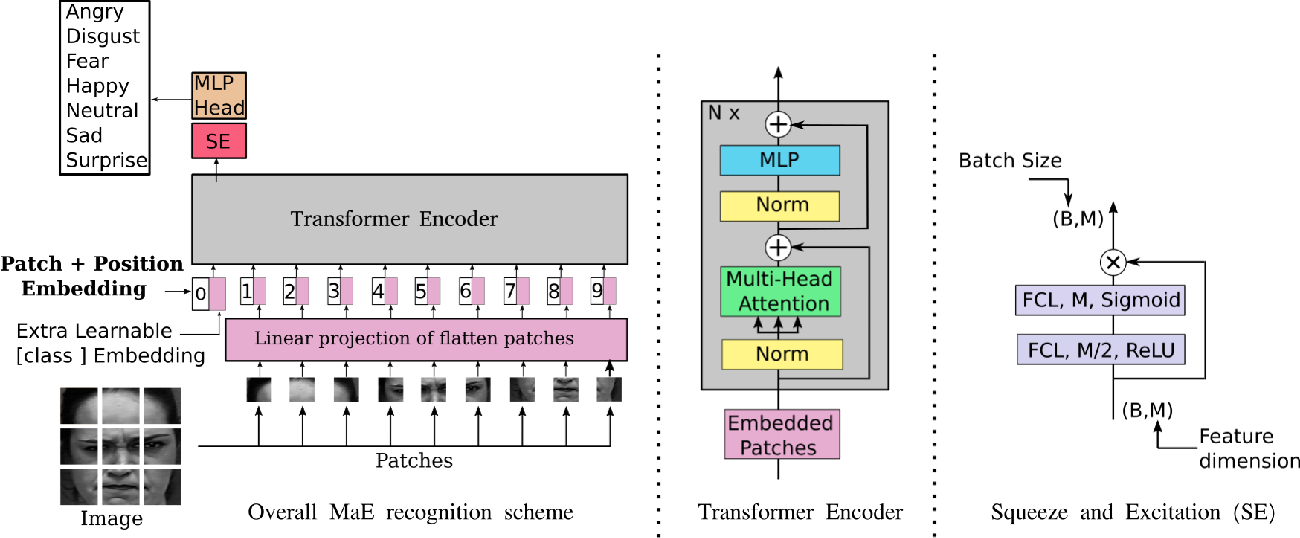
Figure 1 from Learning Vision Transformer with Squeeze and Excitation ...

Figure 1 from Vision-Language Transformer and Query Generation for ...
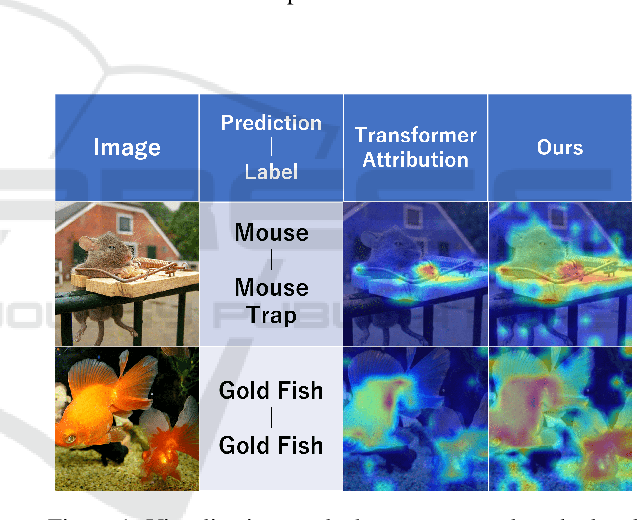
Figure 1 from Vision Transformer Interpretability via Prediction of ...

Figure 1 from Unifying Vision, Text, and Layout for Universal Document ...

Figure 1 from Predicting Token Impact Towards Efficient Vision ...
Advertisement Space (300x250)
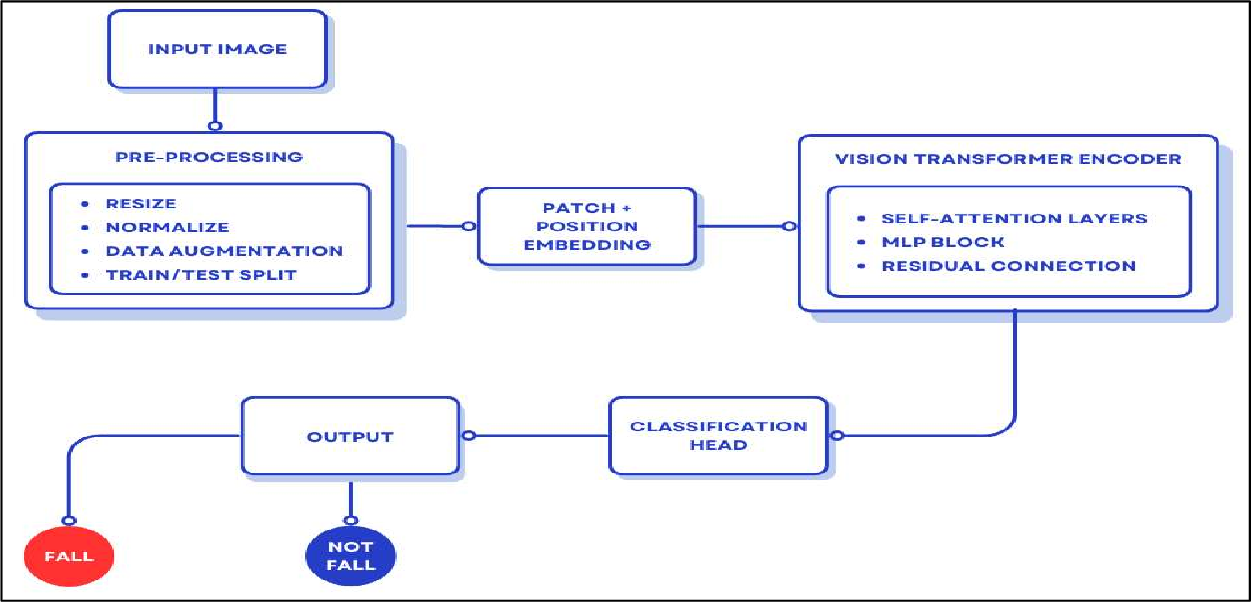
Figure 1 from Fall Detection Using Vision Transformer | Semantic Scholar
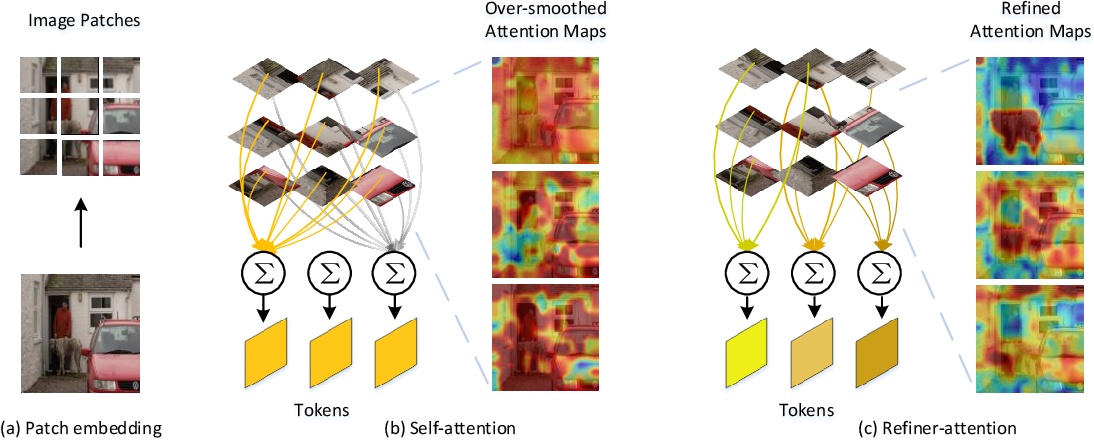
Figure 1 from Refiner: Refining Self-attention for Vision Transformers ...
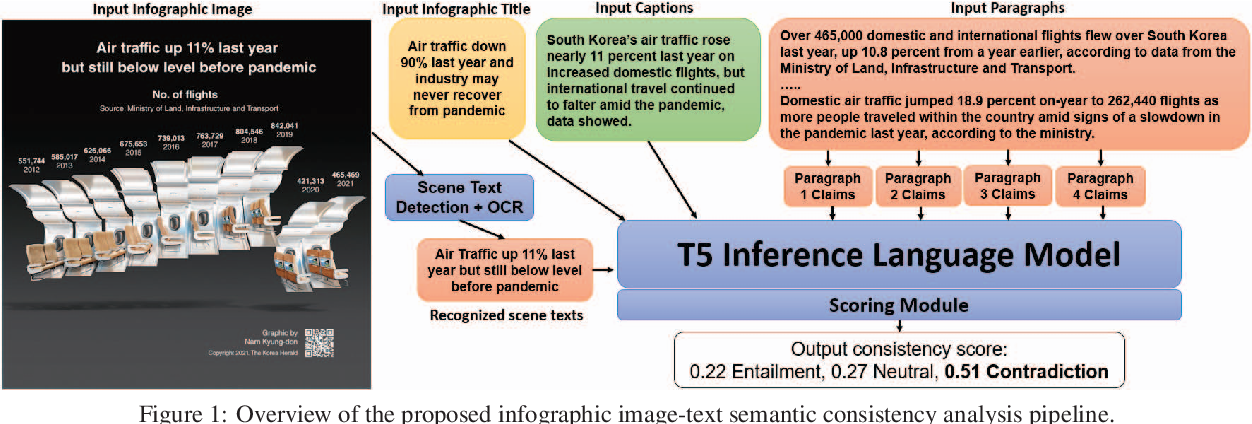
Figure 1 from Transformer Based Image-Text Consistency Analysis for ...

Figure 1 from Slide-Transformer: Hierarchical Vision Transformer with ...

Figure 1 from Use of a Multiscale Vision Transformer to Predict Nursing ...

Figure 1 from A Comprehensive Study of Vision Transformers on Dense ...

Figure 1 from Title-and-Tag Contrastive Vision-and-Language Transformer ...
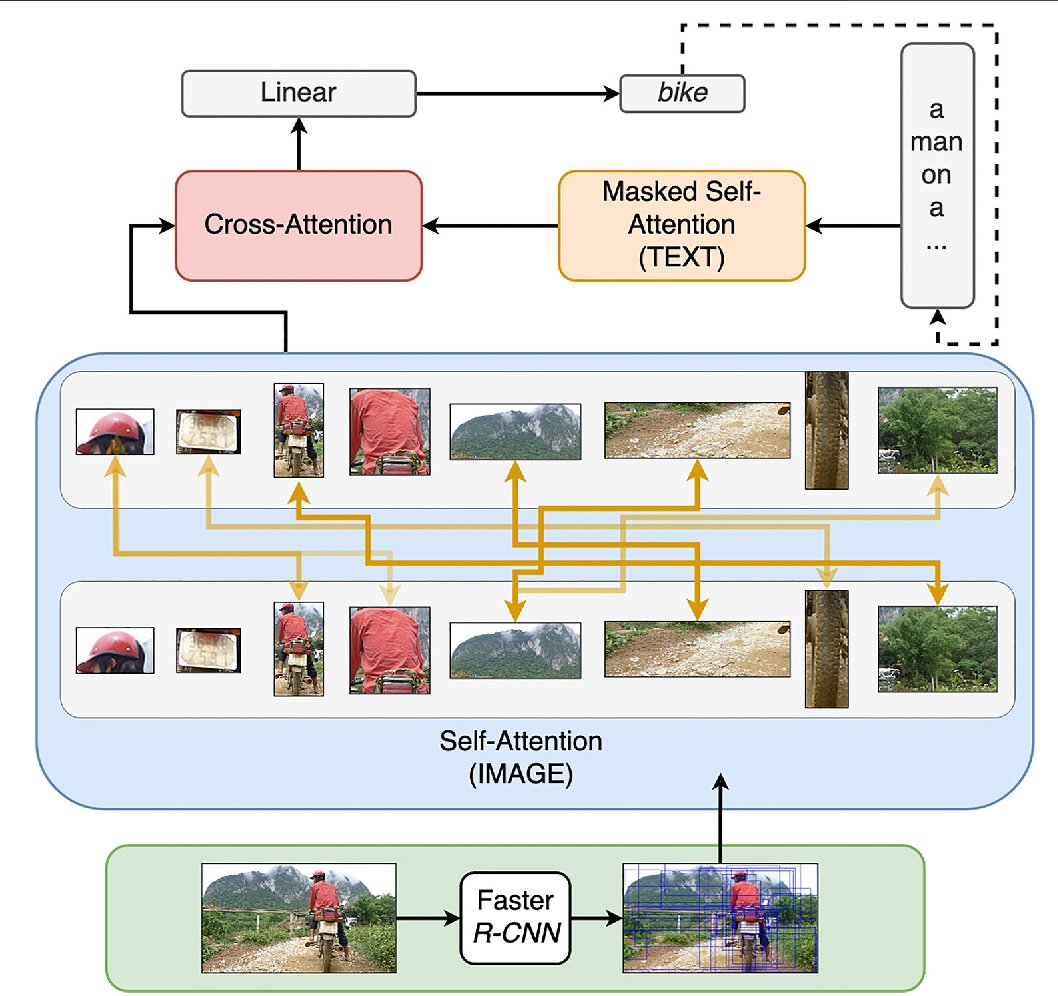
Figure 1 from What Does a Language-And-Vision Transformer See: The ...

Vision Transformer Customized for Environment Detection and Collision ...

Figure 1 from Answer-Type Prediction for Visual Question Answering ...
Advertisement Space (336x280)
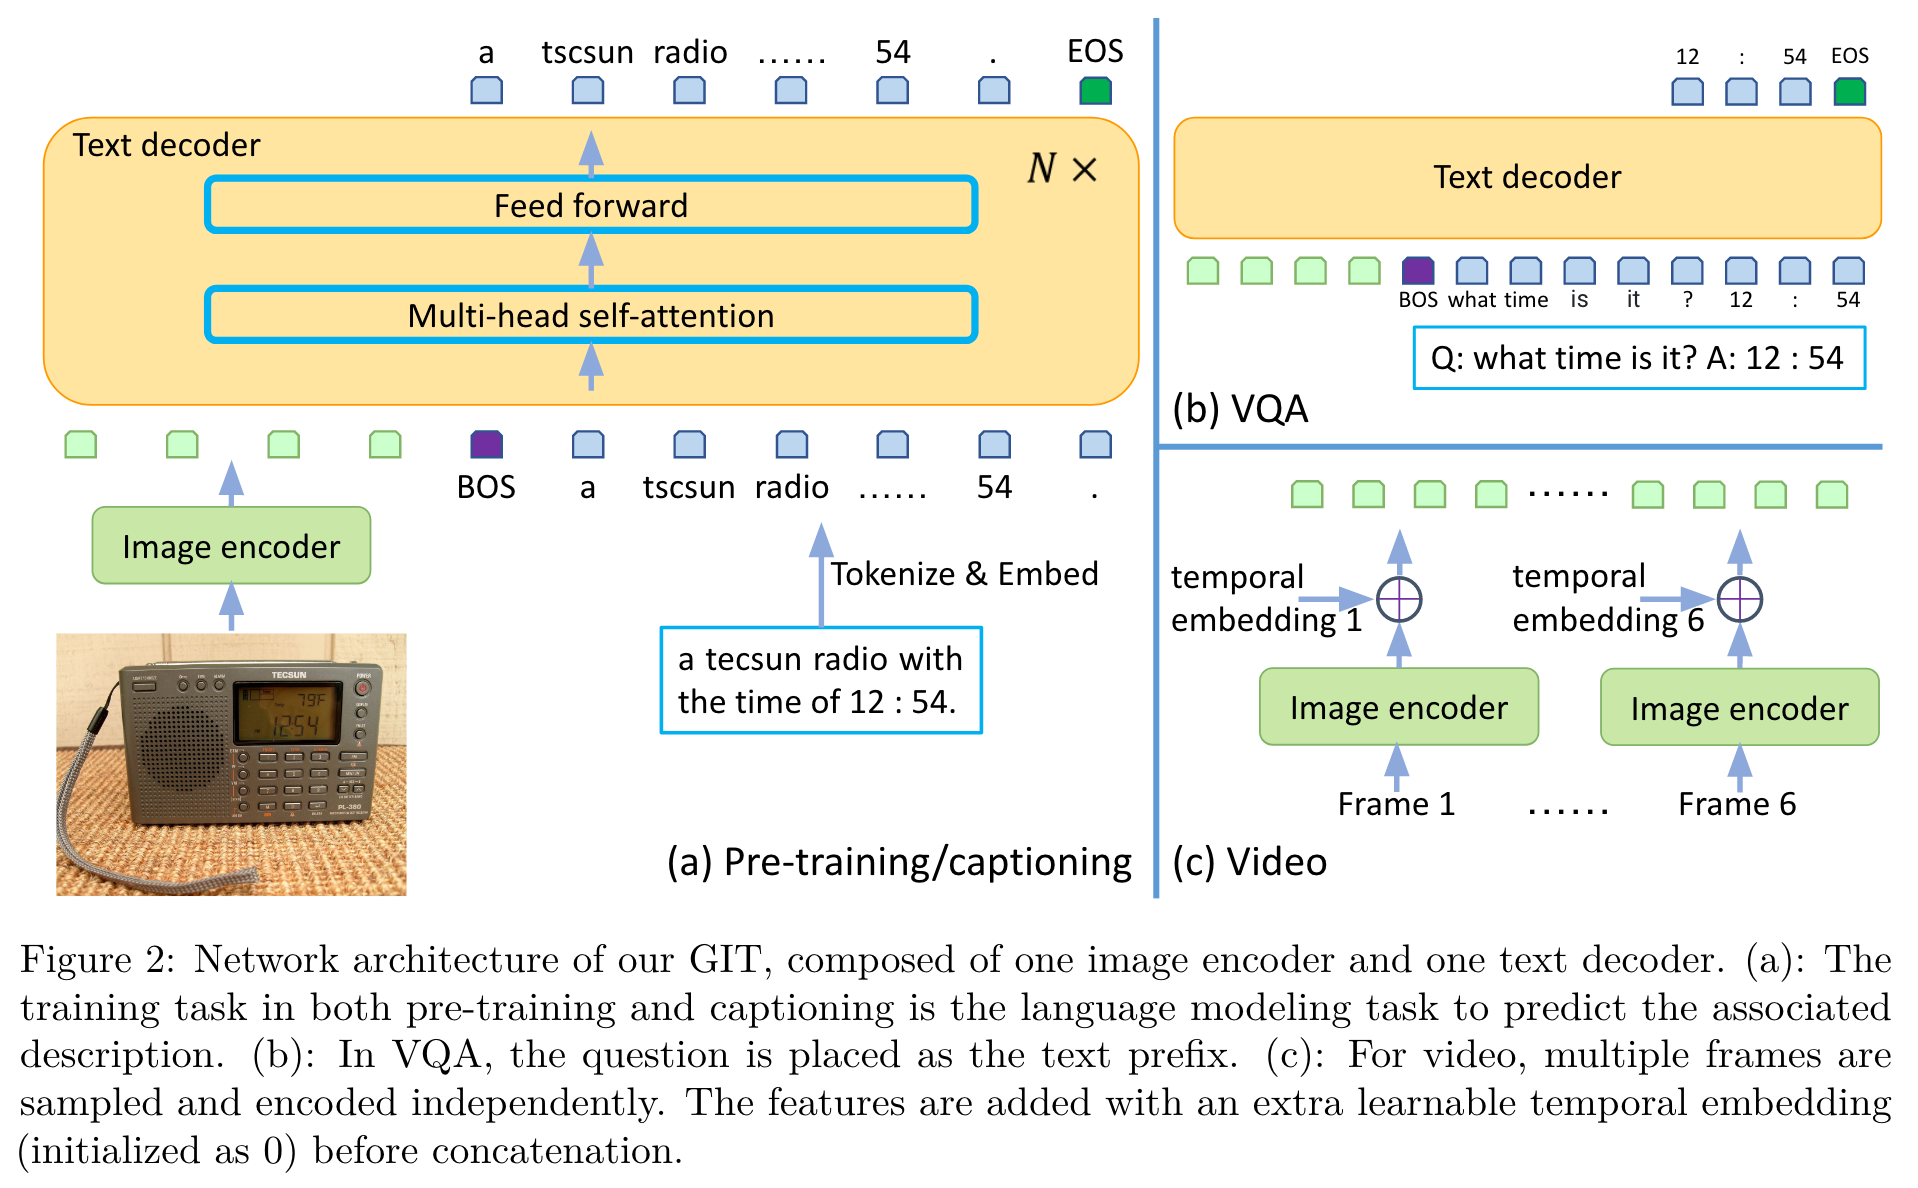
GIT A Generative Image-to-text Transformer for Vision and Language ...

Figure 1 from Design and Development of Visual Question Answering model ...

Figure 1 from Are Vision-Language Transformers Learning Multimodal ...

Figure 1 from Iterative Answer Prediction With Pointer-Augmented ...
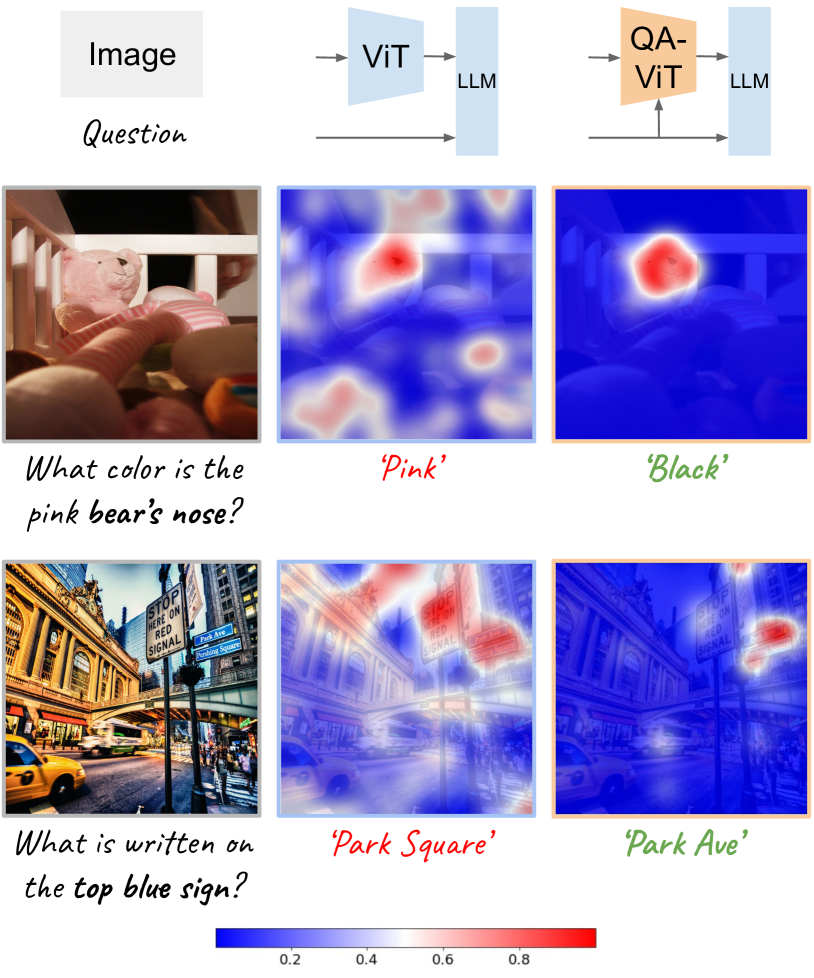
[2402.05472] Question Aware Vision Transformer for Multimodal Reasoning
Vision Transformer — papers and benchmarks | Papers with Code

A Hybrid LSTM–Vision Transformer Architecture for Predicting HRRR ...

Novel Advance Image Caption Generation Utilizing Vision Transformer and ...

A basic transformer model for sign to text translation, showing the ...

Figure 3 from Predicting High-Resolution Maps of Atmospheric ...
Advertisement Space (336x280)

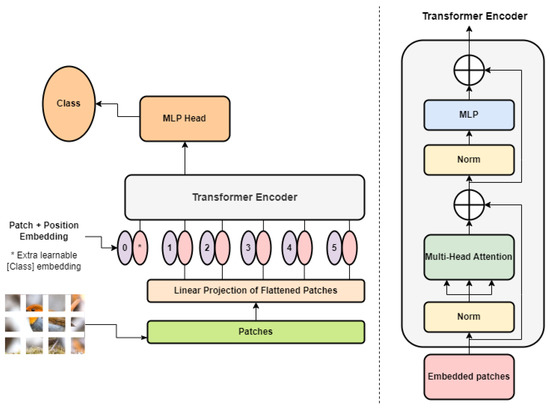
Vision Transformer for classification. | Download Scientific Diagram

Overview of the Vision Transformer architecture (Adapted from [12 ...
Overview of Vision Transformer Neural Network V. VITAL FRAMEWORK Figure ...

Integrating Local Learning Algorithms and Vision Transformers for ...

| The left side of the figure is the original vision transformer ...
Comparing Vision Transformers and Convolutional Neural Networks for ...