
Figure 2 From Bottleneck Transformers For Visual Recognition Semantic
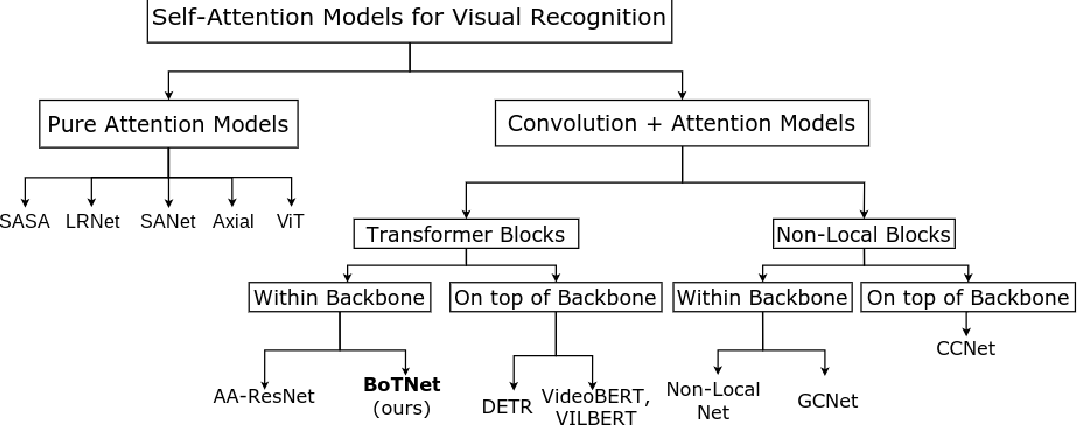
Figure 2 from Bottleneck Transformers for Visual Recognition | Semantic ...

Figure 2 from Bottleneck Transformers for Visual Recognition | Semantic ...

Figure 2 from BTranspose: Bottleneck Transformers for Human Pose ...

Bottleneck Transformers for Visual Recognition
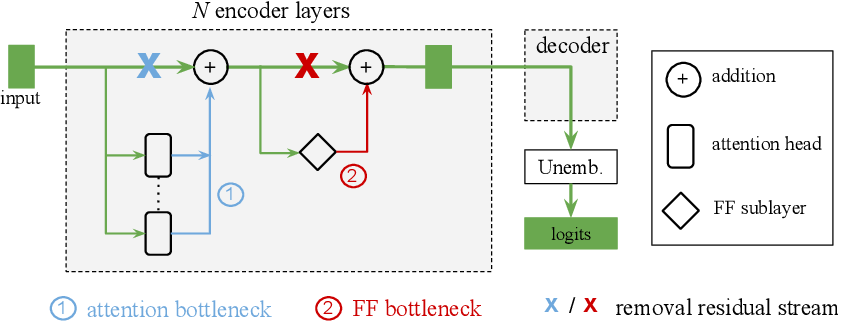
Figure 2 from Interpretability for Time Series Transformers using A ...
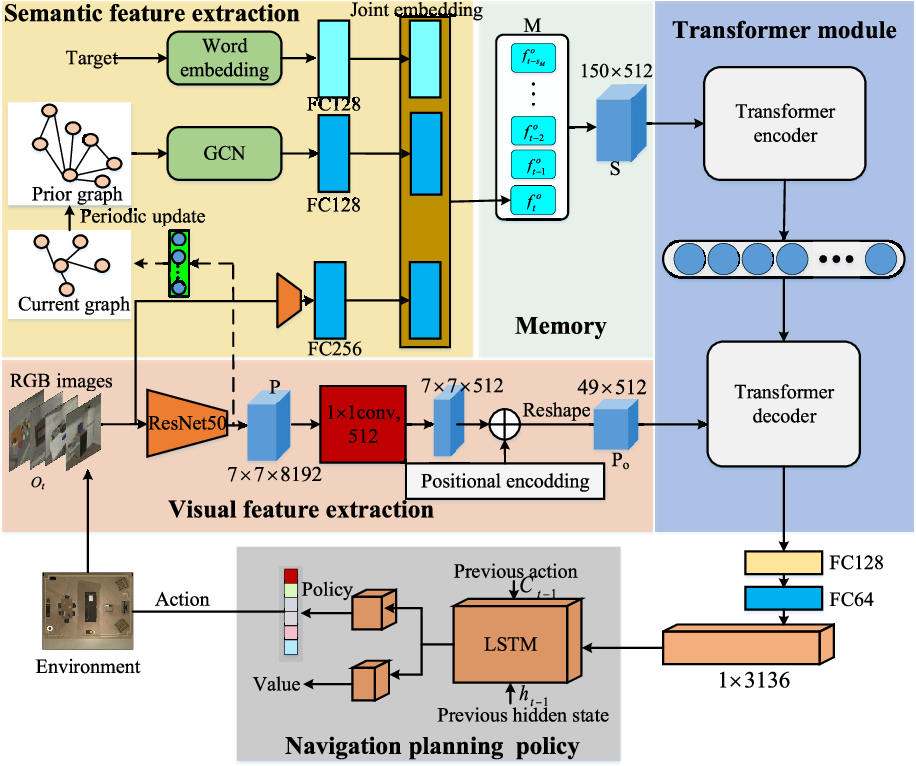
Figure 2 from Goal-Oriented Visual Semantic Navigation Using Semantic ...
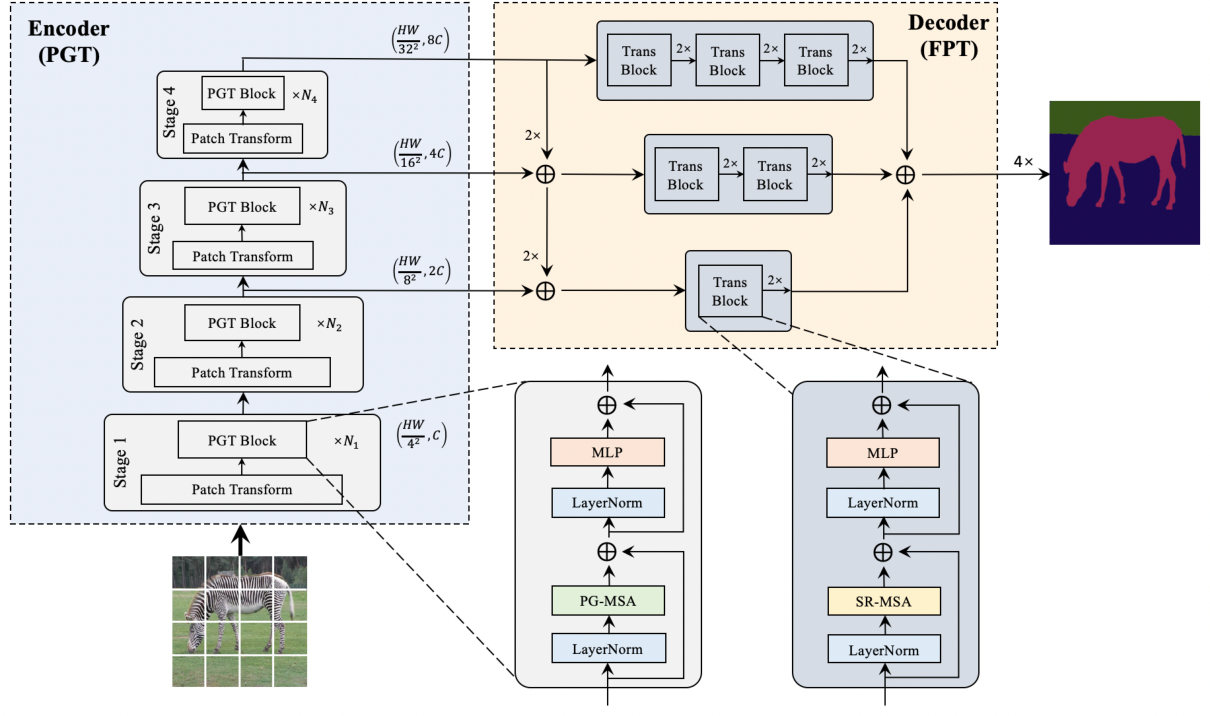
Figure 2 from Fully Transformer Networks for Semantic Image ...

[2101.11605] Bottleneck Transformers For Visual Recognition – ZKRJU

Figure 2 from Visual-Semantic Transformer for Scene Text Recognition ...

Bottleneck Transformers for Visual Recognition
Advertisement Space (300x250)

Paper page - Bottleneck Transformers for Visual Recognition

Bottleneck Transformers for Visual Recognition / bottleneck ...

Bottleneck Transformers for Visual Recognition
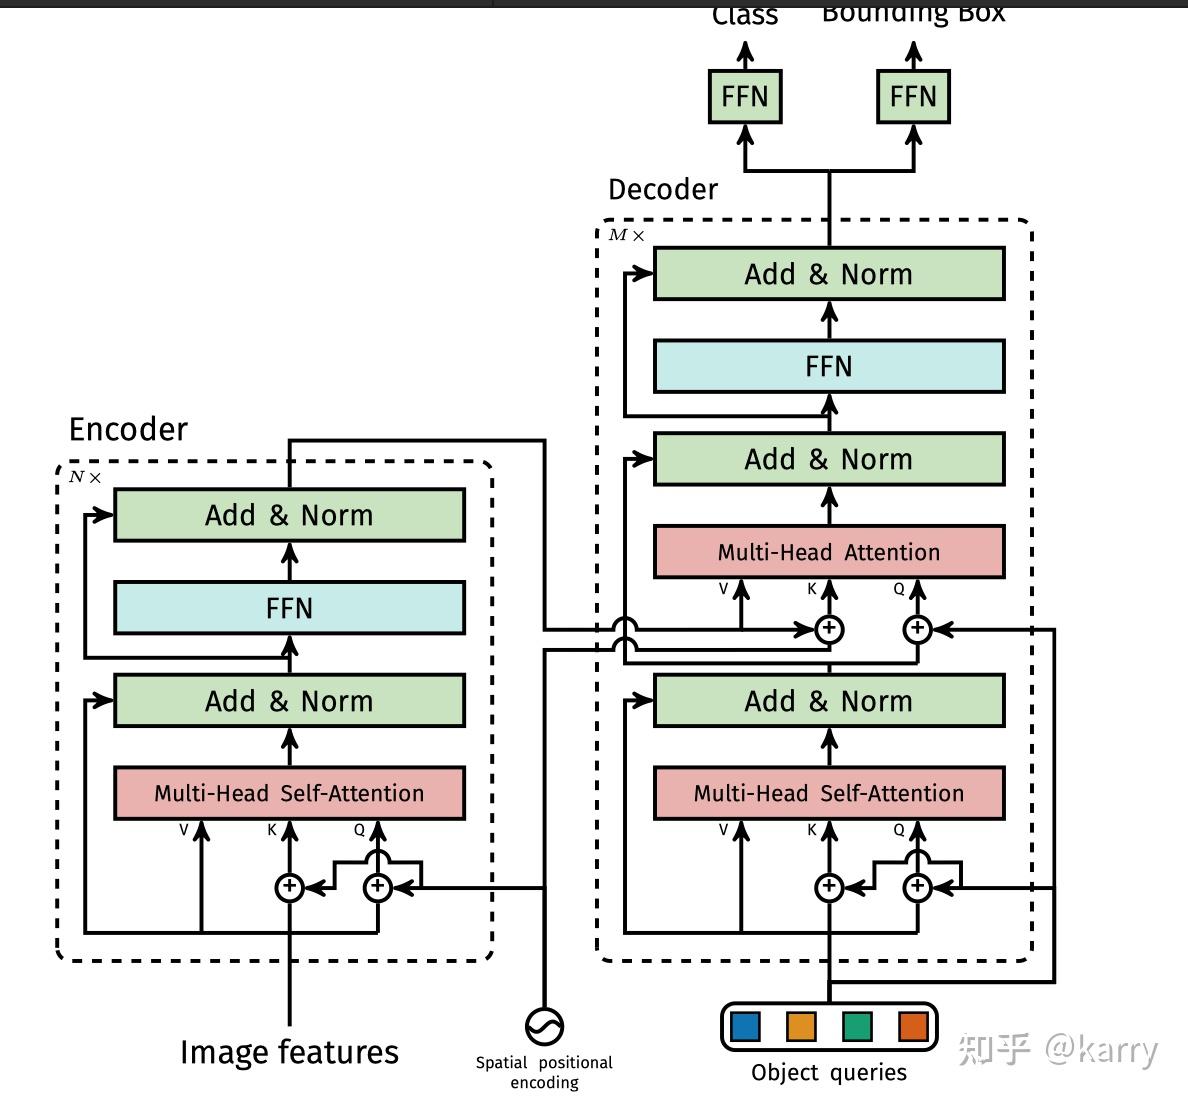
Bottleneck Transformers for Visual Recognition 阅读 - 知乎

Bottleneck Transformers for Visual Recognition 阅读 - 知乎

Figure 2 from Incremental Residual Concept Bottleneck Models | Semantic ...

[2101.11605] Bottleneck Transformers For Visual Recognition – ZKRJU

Figure 2 from A Variational AutoEncoder for Transformers with ...

Bottleneck Transformers for Visual Recognition · Issue #64 ...

Figure 2 from Emotion Recognition with Pre-Trained Transformers Using ...
Advertisement Space (336x280)
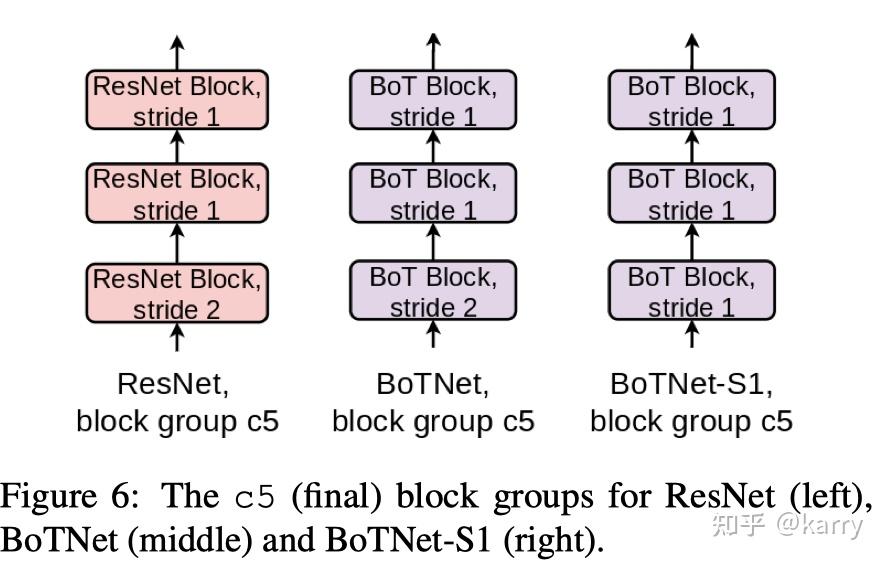
Bottleneck Transformers for Visual Recognition 阅读 - 知乎
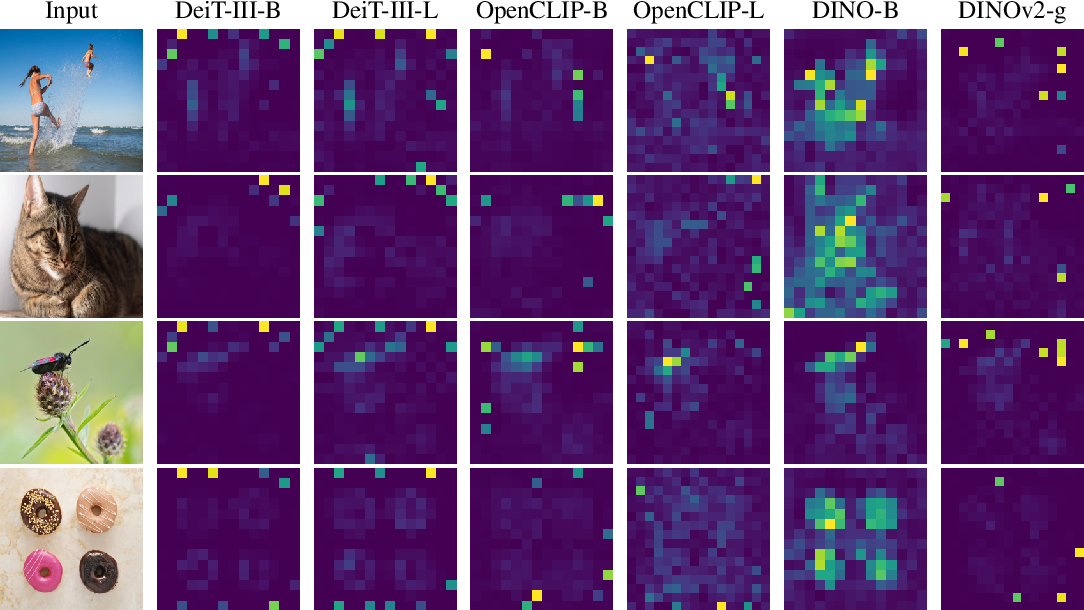
Figure 2 from Vision Transformers Need Registers | Semantic Scholar
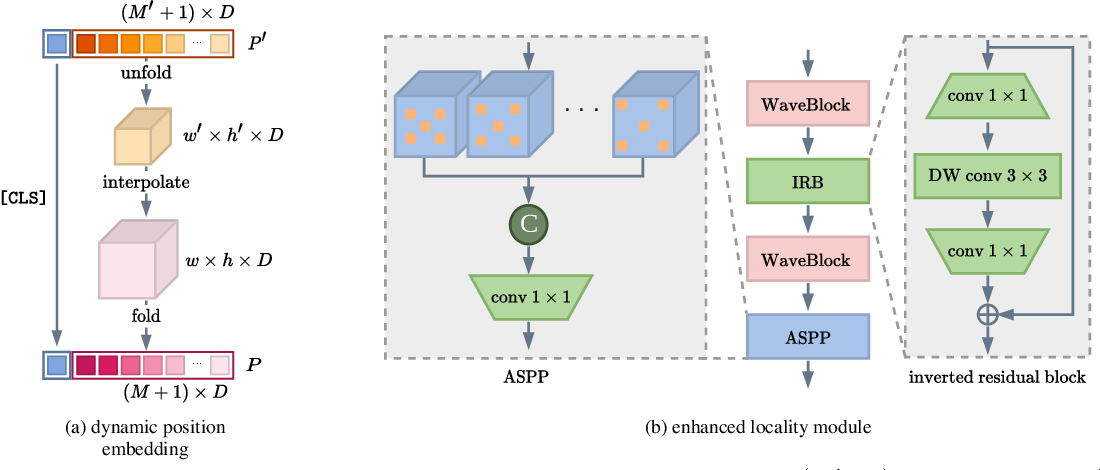
Figure 2 from Boosting vision transformers for image retrieval ...

Bottleneck Transformers for Visual Recognition | DeepAI
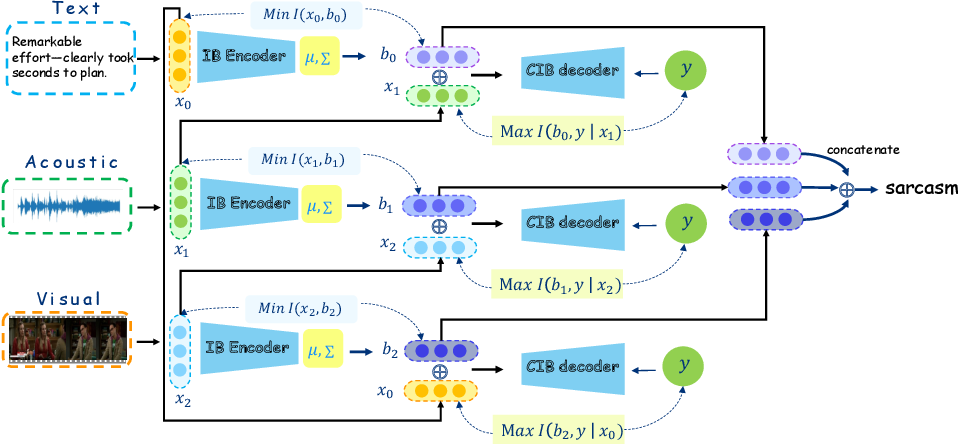
Figure 2 from Conditional Information Bottleneck for Multimodal Fusion ...

Figure 2 from Differentiable Information Bottleneck for Deterministic ...
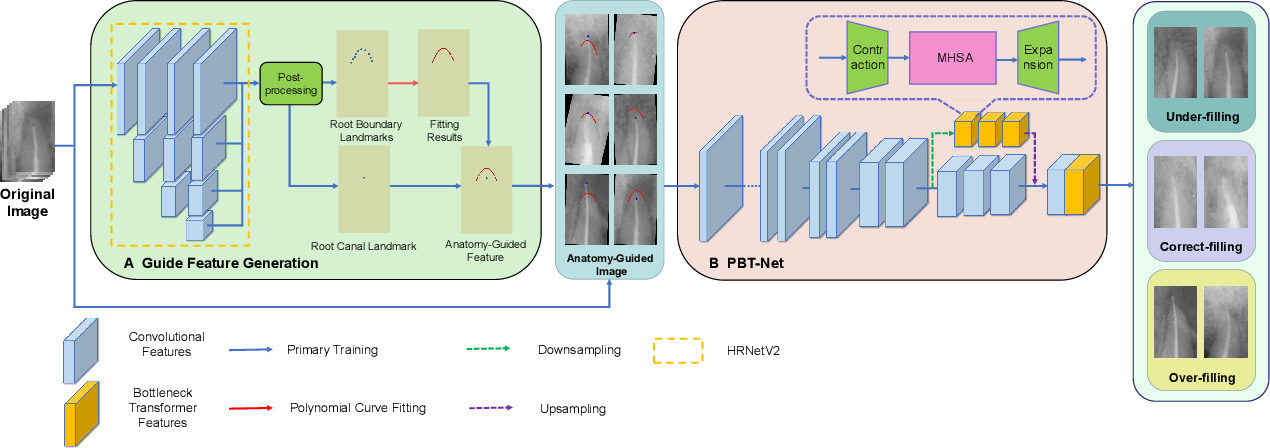
Figure 2 from Anatomy-Guided Parallel Bottleneck Transformer Network ...

Figure 2 from Pedestrian Multi-Object Tracking with Bottleneck ...
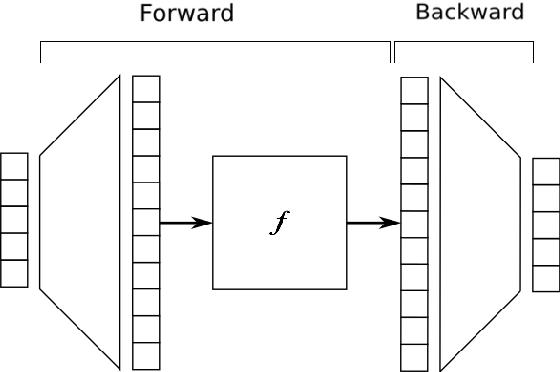
Figure 2 from Exploring the sequence length bottleneck in the ...
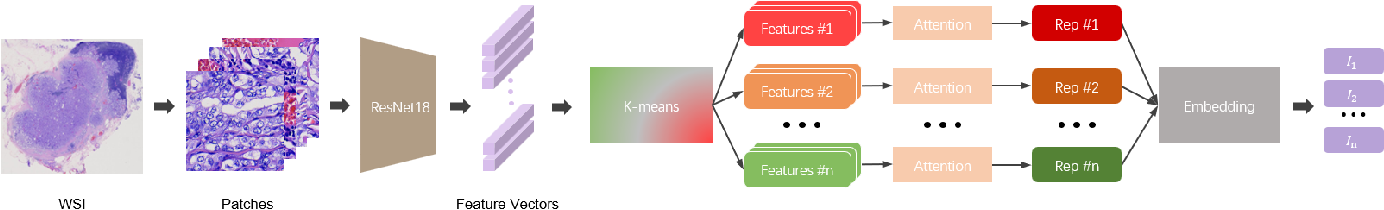
Figure 2 from Shared-Specific Feature Learning With Bottleneck Fusion ...
Advertisement Space (336x280)

BottleneckTransformers:Bottleneck Transformers for Visual Recognition ...
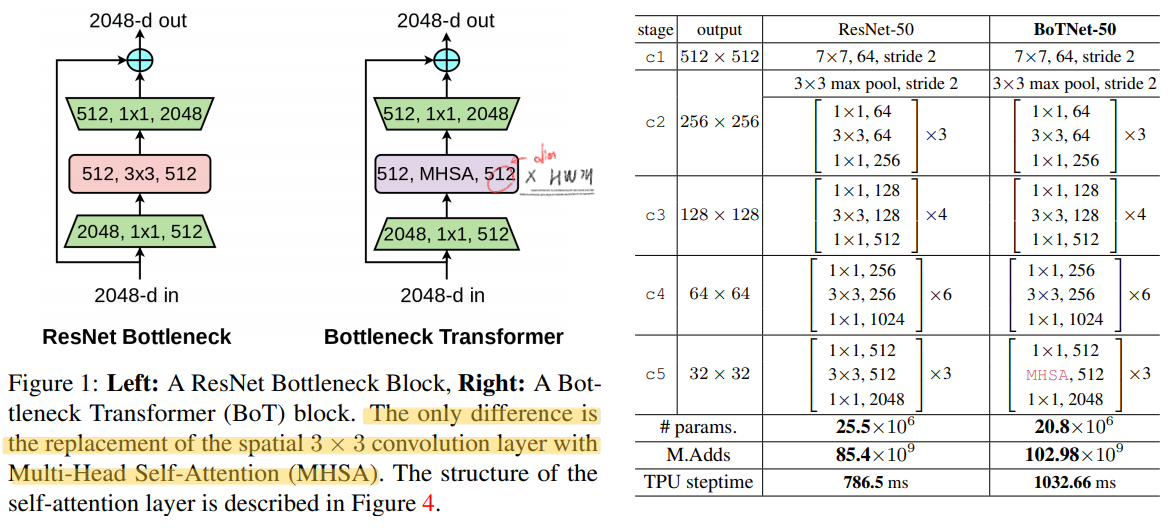
【Detection】Bottleneck Transformers for Visual Recognition | Just Do It ...

BoTNet:Bottleneck Transformers for Visual Recognition - 知乎

视觉Transformer>>2021:Bottleneck Transformers for Visual Recognition ...

Bottleneck Transformers for Visual Recognition阅读笔记_rh和rw分别表示高度和宽度不同位置的 ...

Figure 1 from Visual-Semantic Transformer for Scene Text Recognition ...