
Figure 2 From Combining Visual And Textual Features For Semantic

Figure 2 from Combining Visual and Textual Features for Semantic ...

Table 2 from Combining Visual and Textual Features for Semantic ...

Figure 1 from Combining Visual and Textual Features for Semantic ...

Figure 1 from Combining Visual and Textual Features for Semantic ...
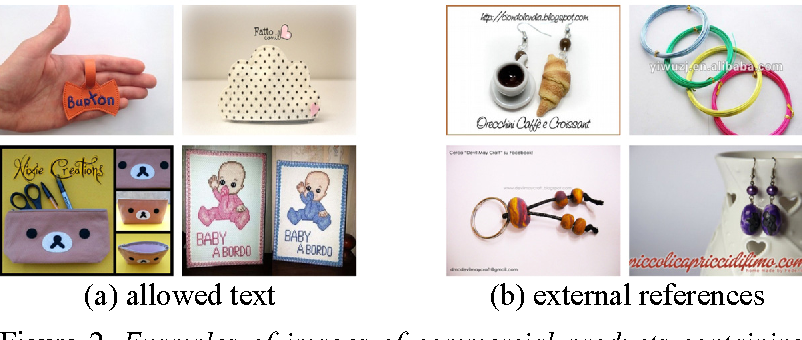
Figure 2 from Combining Textual and Visual Features to Identify ...

Figure 2 from Harmonizing Visual and Textual Embeddings for Zero-Shot ...
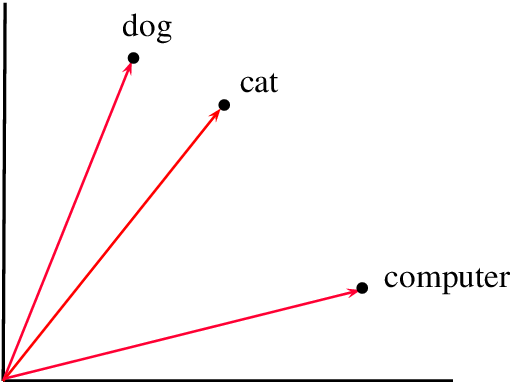
Figure 2.1 from Multimodal Fusion for Combining Textual and Visual ...

(PDF) Combining Visual and Textual Features for Semantic Segmentation ...

Figure 1 from Combining Textual and Visual Representations for ...
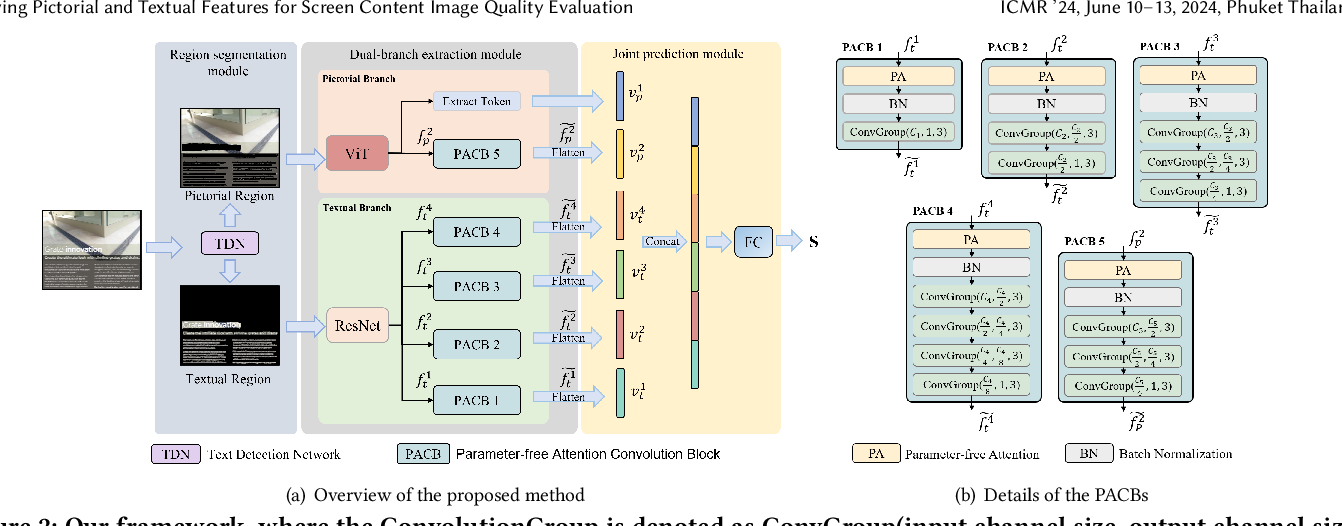
Figure 2 from Unifying Pictorial and Textual Features for Screen ...
Advertisement Space (300x250)
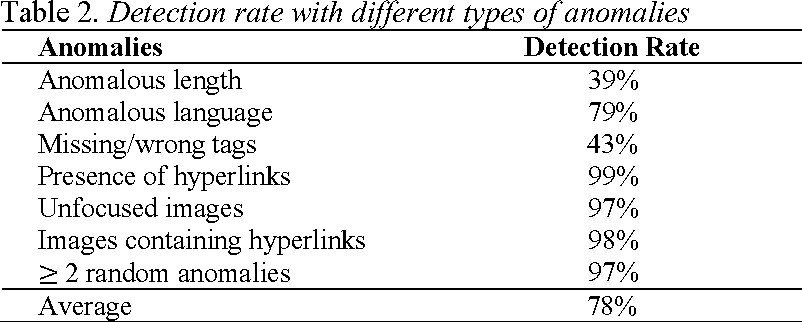
Table 2 from Combining Textual and Visual Features to Identify ...
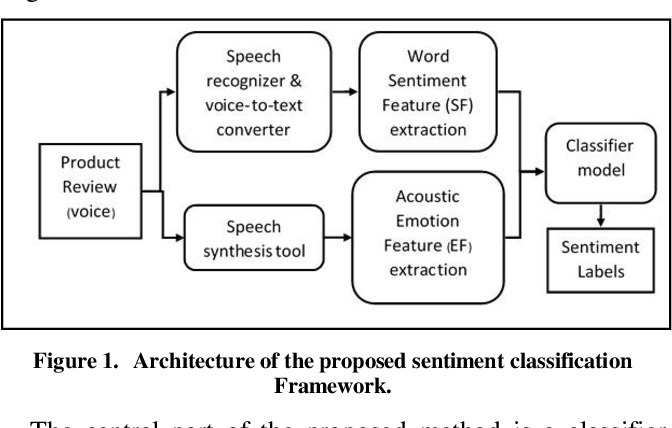
Figure 1 from A Framework for Combining Acoustic and Textual Features ...

Figure 6 from Combining Semantic and Visual Image Graphs for Efficient ...
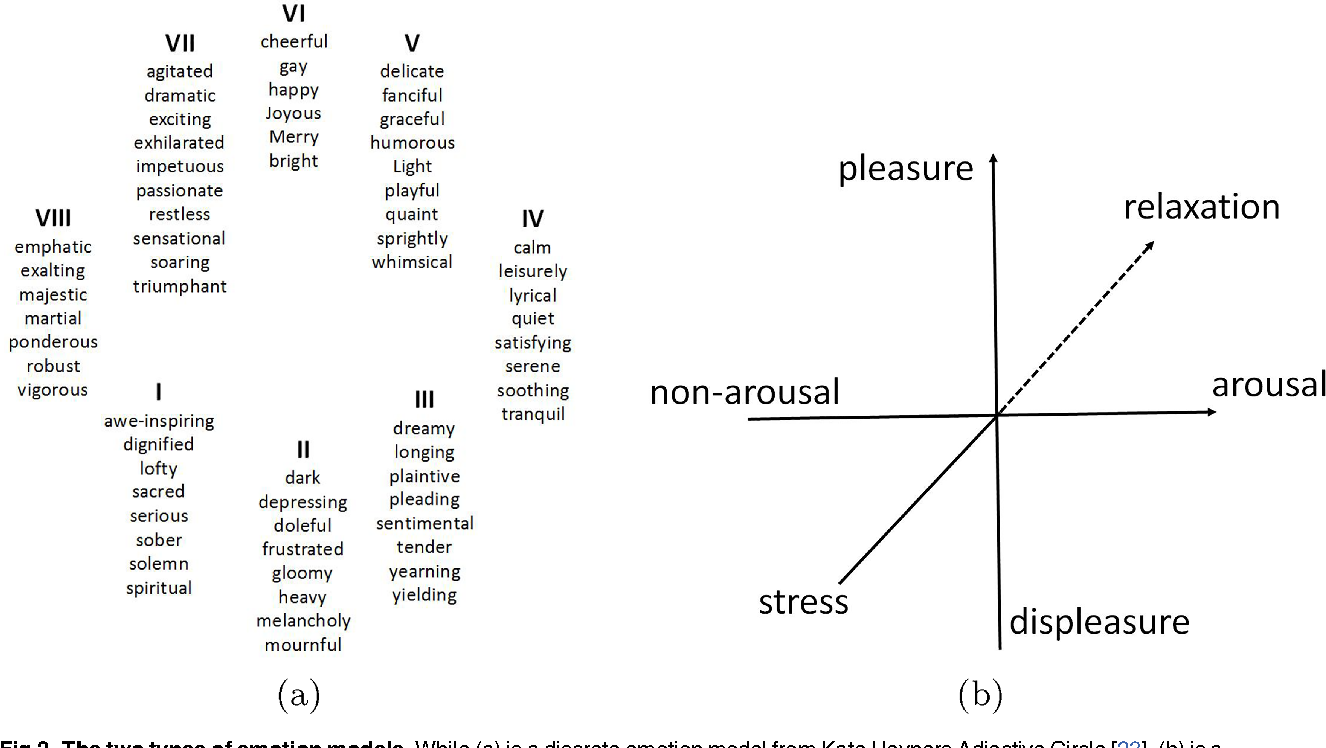
Figure 2 from Visual affective classification by combining visual and ...
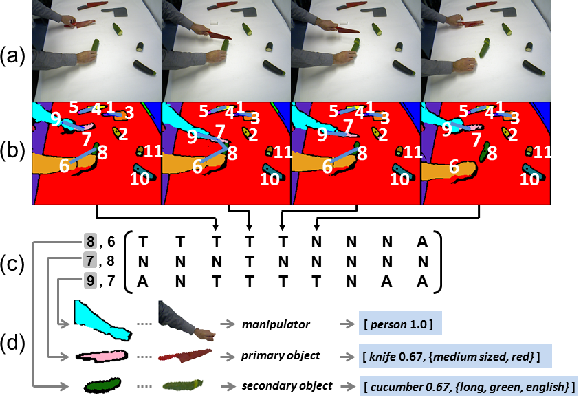
Figure 2 from Unsupervised Linking of Visual Features to Textual ...
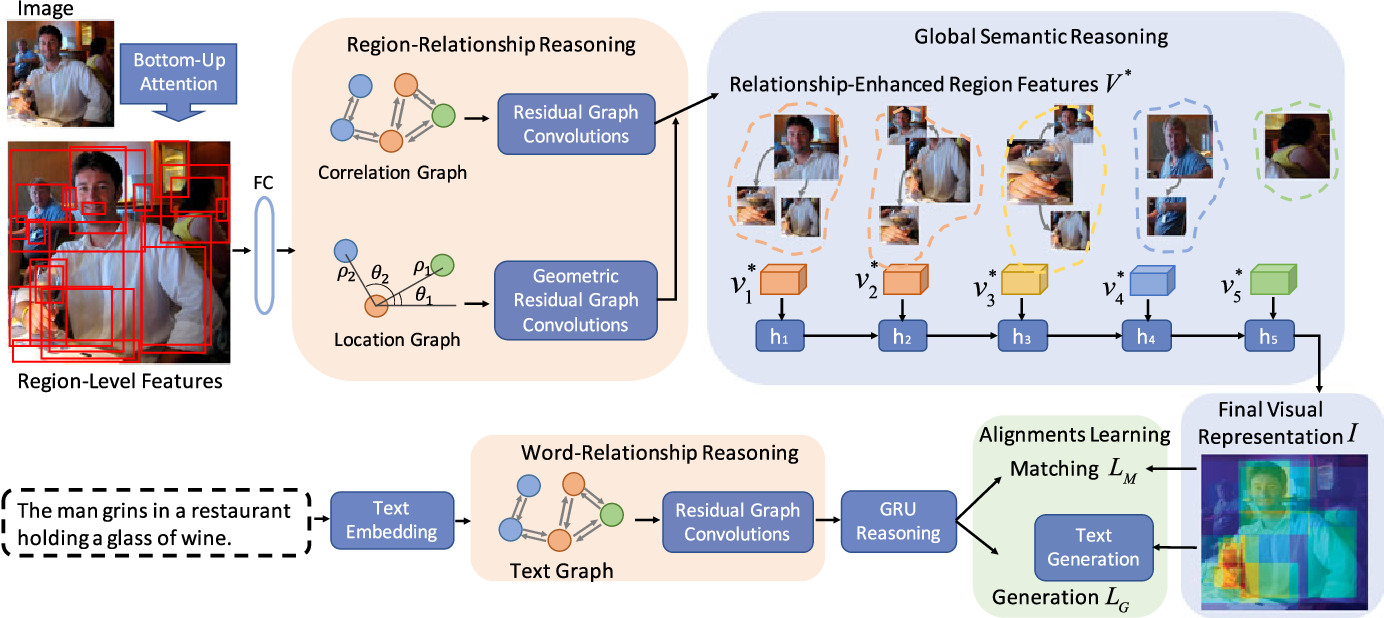
Figure 2 from Image-Text Embedding Learning via Visual and Textual ...

Figure 1 from Are All Combinations Equal? Combining Textual and Visual ...

(PDF) Combining Textual and Visual Features for Image Retrieval

Figure 1 from Mismatch Quest: Visual and Textual Feedback for Image ...

Figure 1 from Combining visual features with semantics for a more ...
Advertisement Space (336x280)
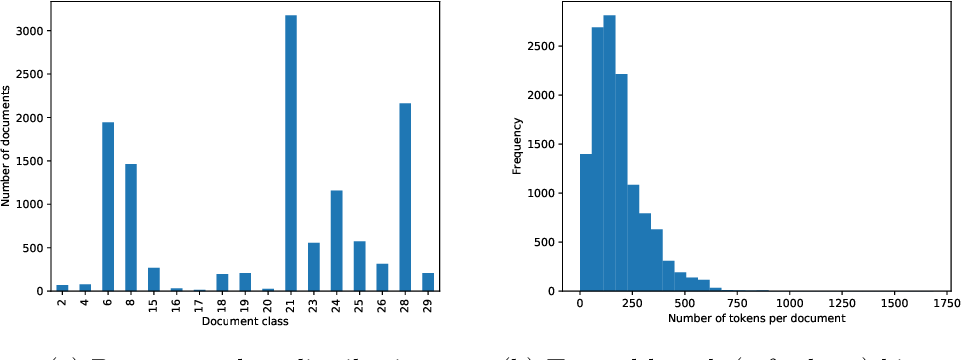
Figure 2 from Classifying Documents using both Textual and Visual ...

Figure 1 from Predicting Visual Features From Text for Image and Video ...
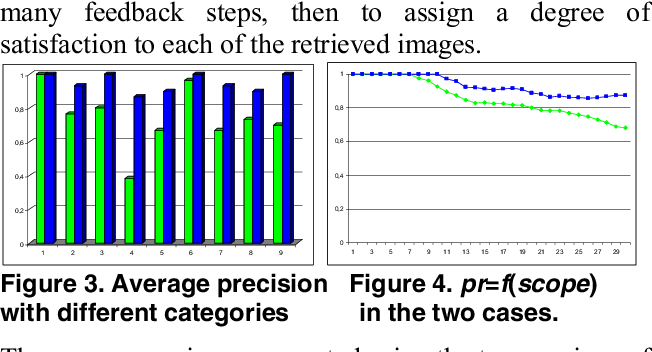
Figure 3 from Combining visual features with semantics for a more ...

Figure 1 from A semantic similarity metric combining features and ...

Figure 6 from A Mutually Textual and Visual Refinement Network for ...
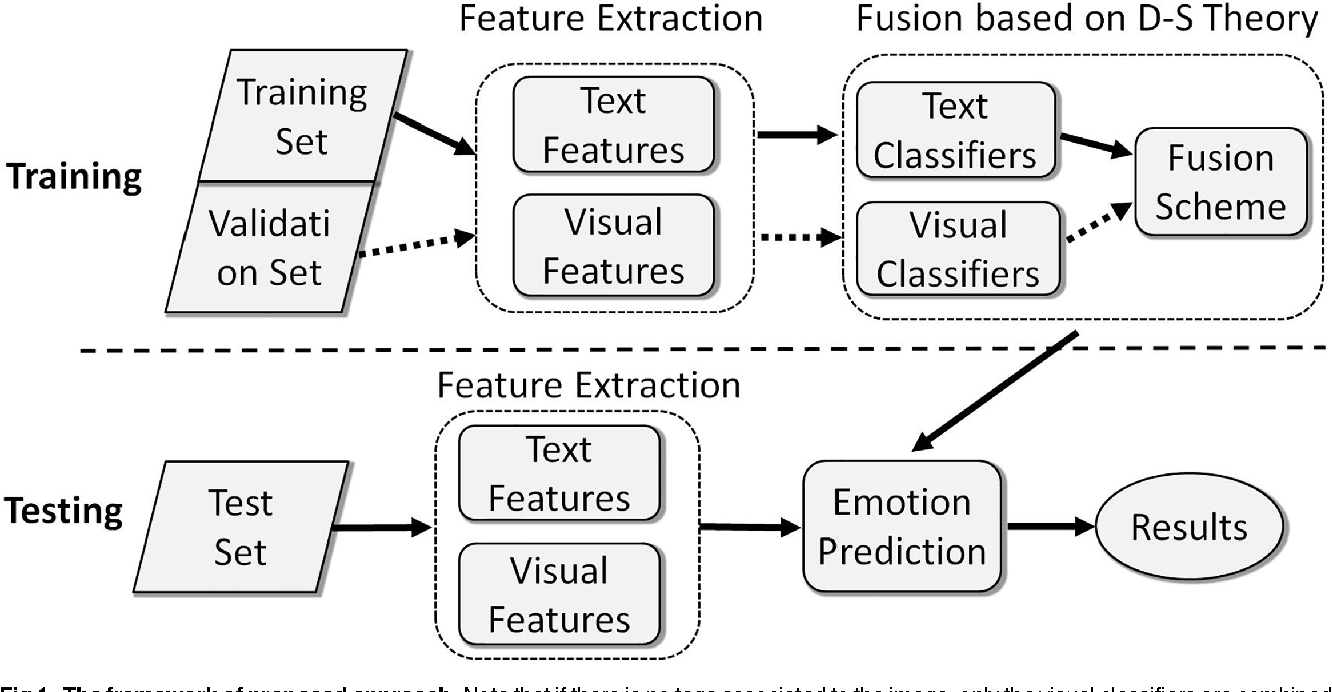
Figure 1 from Visual affective classification by combining visual and ...
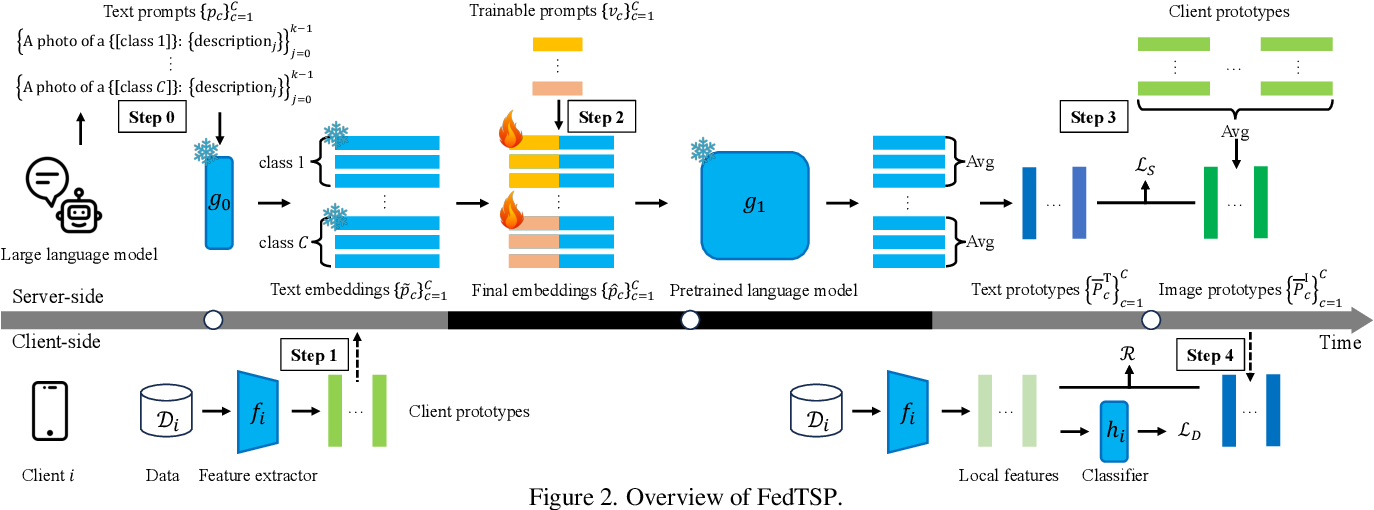
Figure 2 from Enhancing Visual Representation with Textual Semantics ...

Figure 2 from Semantic Embedding Guided Attention with Explicit Visual ...

A basic model design for VQA. Visual and textual features are extracted ...

Combining Semantic and Visual Image Graphs for Efficient Search and ...
Advertisement Space (336x280)
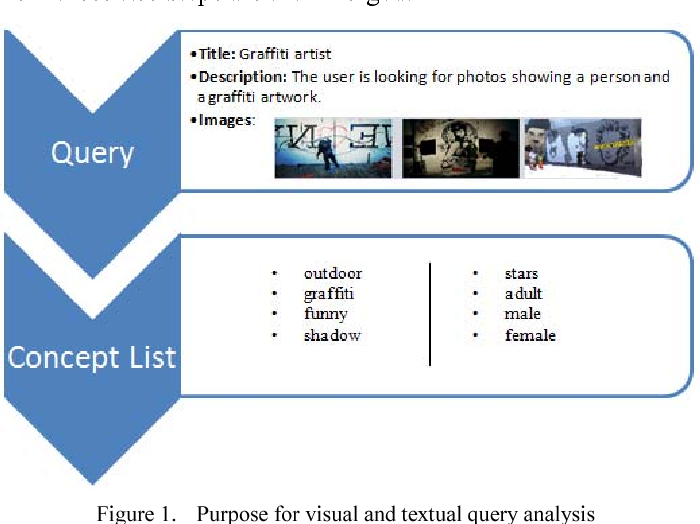
Figure 1 from Enhancing query interpretation by combining textual and ...

Figure 1 from Multiview Semantic Representation for Visual Recognition ...

(PDF) Combining visual features and text data for medical image ...

Figure 1 from Visual Semantic Reasoning for Image-Text Matching ...

Figure 1 from Deep Textual Searching for Visual Semantics of Personal ...

Figure 1 from Joint Semantic and Spatial Feature Learning for Audio ...