
Figure 2 From Image Caption Generation Using Vision Transformer And Gpt

Figure 2 from Image Caption Generation using Vision Transformer and GPT ...

Figure 2 from Image Caption Generation using Vision Transformer and GPT ...

Table 1 from Image Caption Generation using Vision Transformer and GPT ...

Image Caption Generation using Vision Transformer and GPT Architecture ...

Figure 2 from Image Caption Generation Using Multi-Level Semantic ...

Figure 2 from Image Caption Generation With Adaptive Transformer ...

Figure 2 from Image Caption Generation and Comprehensive Comparison of ...

Novel Advance Image Caption Generation Utilizing Vision Transformer and ...

Novel Advance Image Caption Generation Utilizing Vision Transformer and ...

Figure 2 from GRIT: Faster and Better Image captioning Transformer ...
Advertisement Space (300x250)

Figure 1 from Image Caption Generation using Deep Neural Networks ...

Image caption generation using transformer learning methods: a case ...

(PDF) Image caption generation using Visual Attention Prediction and ...

Image Caption Generation using Convolutional Neural Network and LSTM | PPTX

Video Caption Generation using ViT and Transformers | PDF | Machine ...
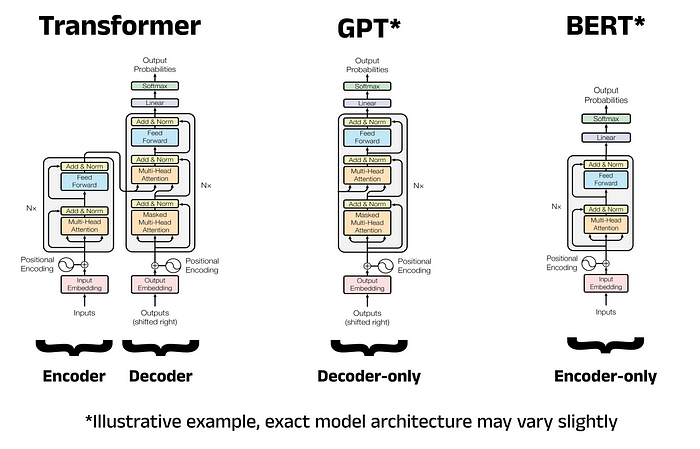
Image Classification using Vision Transformer (ViT) | by Sanjay Dutta ...

(PDF) Novel Advance Image Caption Generation Utilizing Vision ...

A vision explainability method for image captioning using transformer ...

Figure 2 from Vision-Language Transformer for Interpretable Pathology ...

Figure 3 from An Overview of Vision Transformers for Image Processing ...
Advertisement Space (336x280)

Figure 1 from Vision Language Model-based Caption Evaluation Method ...
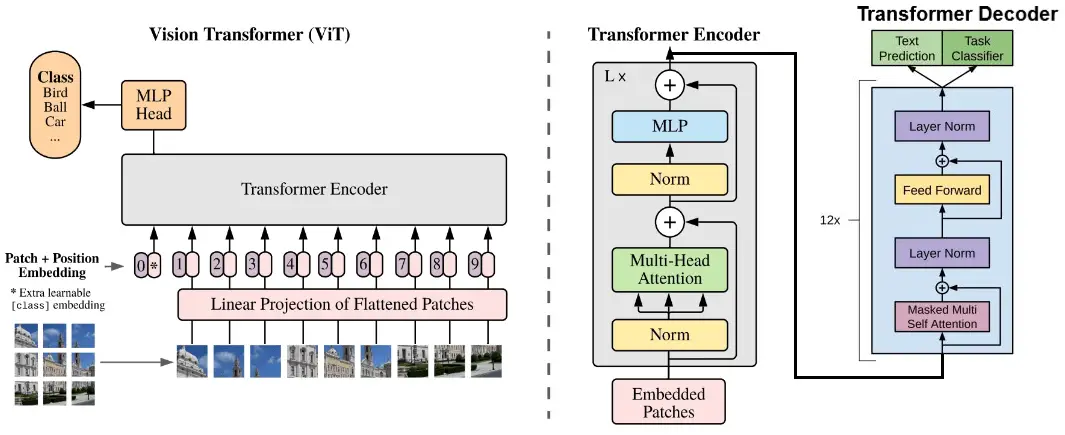
Image Captioning using PyTorch and Transformers in Python - The Python Code

VL-GPT: A Generative Pre-trained Transformer for Vision and Language ...

Generation of Semantic and Contextual Captions to the Images Using ViT ...

Flowchart of caption generation using GPT-2. MHA denotes multi-head ...

Efficient Image Captioning Based on Vision Transformer Models

Figure 1 from Hybrid Attention Vision Transformer-based Deep Learning ...

(PDF) Efficient Image Captioning Based on Vision Transformer Models
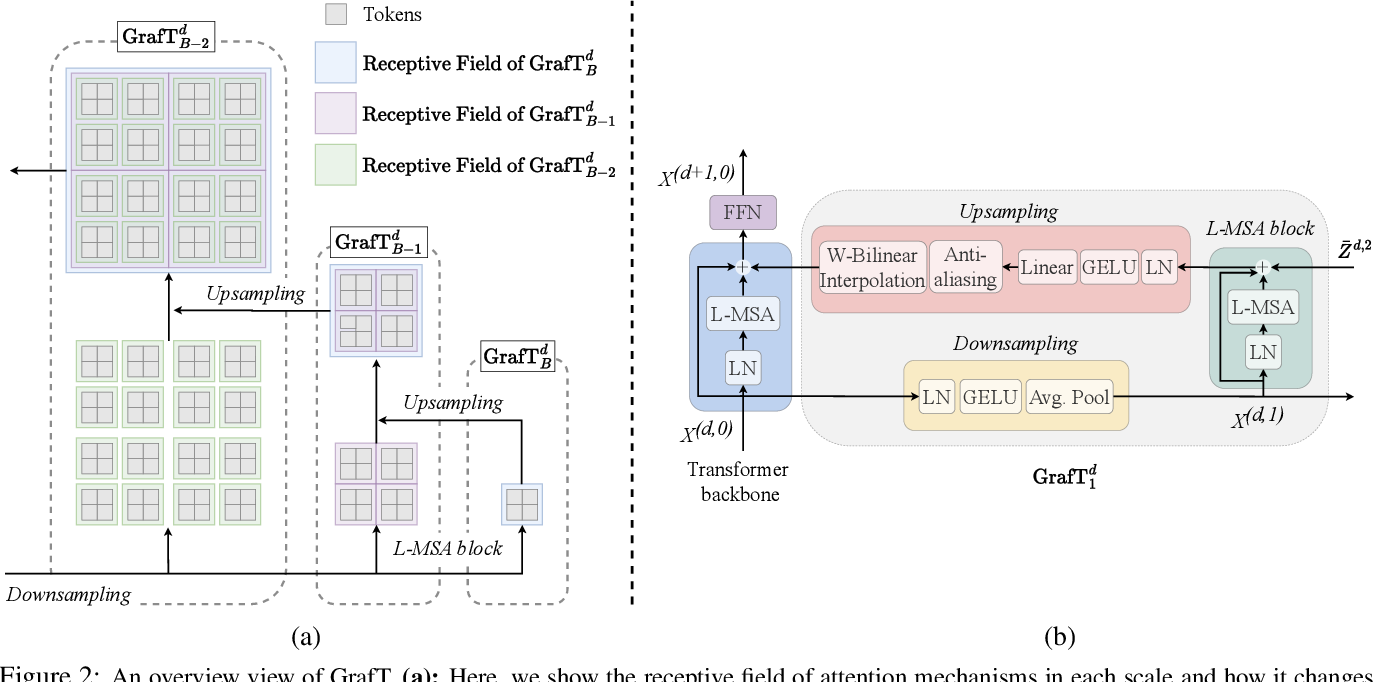
Figure 1 from Grafting Vision Transformers | Semantic Scholar

The architecture of Vision Transformer Model for image classification ...
Advertisement Space (336x280)

Image Captioning Using ViT and BERT Models | Springer Nature Link

Vision Transformer encoding. The image is split into fixed-size ...

Image caption generation model | Download Scientific Diagram

Enhanced transformer model for video caption generation | Request PDF

[논문 리뷰] Vision Transformer - An image is worth 16x16 words

Figure 3 from Research on Image Captioning Based on Vision-language Pre ...