
Figure 2 From Ml Bench Evaluating Large Language Models And Agents For

Figure 2 from ML-Bench: Evaluating Large Language Models and Agents for ...

Figure 1 from ML-Bench: Evaluating Large Language Models and Agents for ...
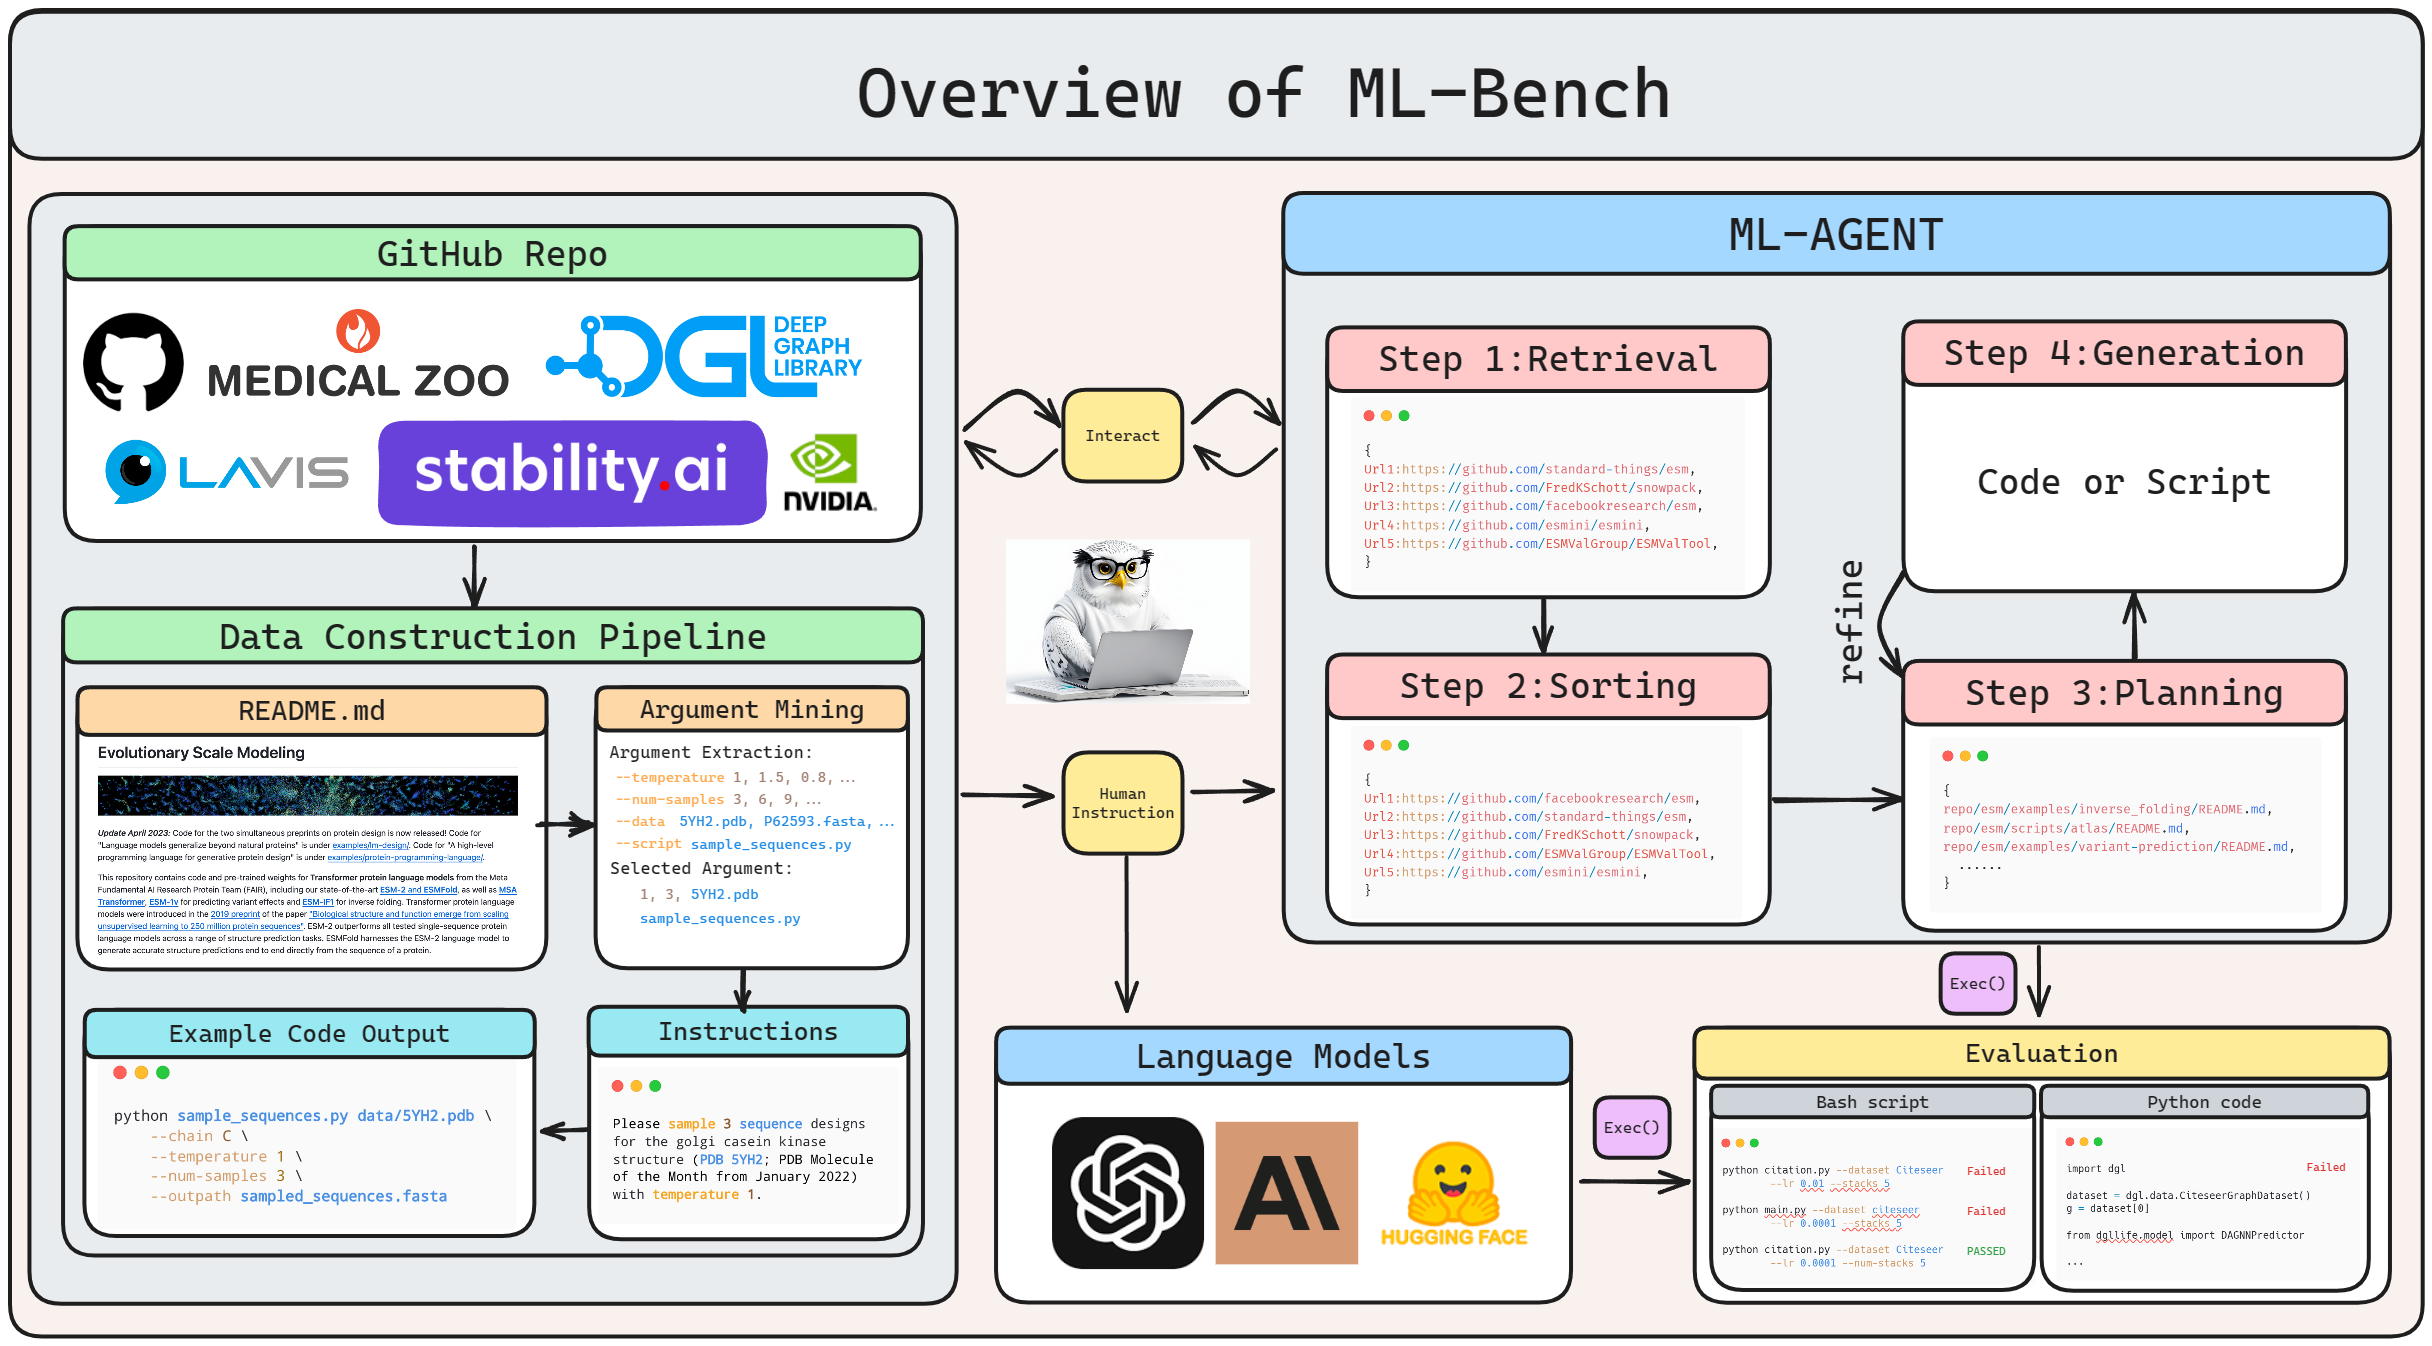
ML-Bench: Evaluating Large Language Models and Agents for Machine ...
ML-Bench: Evaluating Large Language Models and Agents for Machine ...

Figure 1 from Evaluating Large Language Models for RDF Knowledge Graph ...

Figure 2 from MLAgentBench: Evaluating Language Agents on Machine ...

Table 1 from Evaluating Large Language Models for RDF Knowledge Graph ...

Figure 2 from RoTBench: A Multi-Level Benchmark for Evaluating the ...
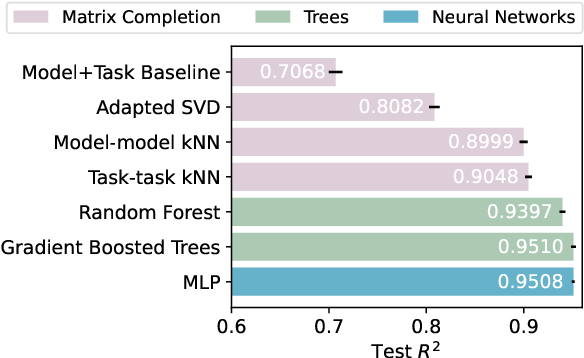
Figure 2 from How Predictable Are Large Language Model Capabilities? A ...

[論文レビュー] IDE-Bench: Evaluating Large Language Models as IDE Agents on ...
Advertisement Space (300x250)

[PDF] Evaluating Large Language Models for RDF Knowledge Graph Related ...
Figure 2 from Exploring Autonomous Agents through the Lens of Large ...

(PDF) RealFactBench: A Benchmark for Evaluating Large Language Models ...

Figure 2 from MLE-bench: Evaluating Machine Learning Agents on Machine ...

Large Language Models as User-Agents for Evaluating Task-Oriented ...

Figure 1 from Exploring Large Language Model based Intelligent Agents ...

MedCalc-Bench: Evaluating Large Language Models for Medical Calculations

[論文レビュー] BarrierBench : Evaluating Large Language Models for Safety ...

ML-Bench: Large Language Models Leverage Open-source Libraries for ...

From single large language model to collaborative LLM agents | Download ...
Advertisement Space (336x280)

QCBench: Evaluating Large Language Models on Domain-Specific ...

Understanding Large Language Models and Their Retrieval Capabilities

CLR-Bench: Evaluating Large Language Models in College-level Reasoning
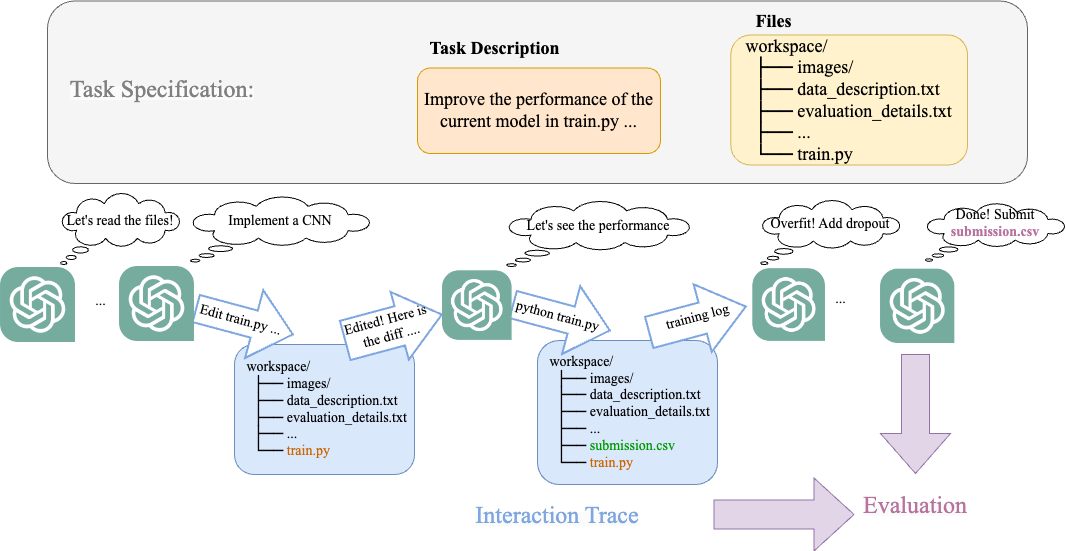
[2310.03302] Benchmarking Large Language Models as AI Research Agents

OPOR-Bench: Evaluating Large Language Models on Online Public Opinion ...

PromptBench: Towards Evaluating the Robustness of Large Language Models ...

LongICLBench Benchmark: Evaluating Large Language Models on Long In ...

A Comprehensive Guide to Large Language Models Agents

[논문 리뷰] LTD-Bench: Evaluating Large Language Models by Letting Them Draw

Evaluating Large Language Models – NextBigFuture.com
Advertisement Space (336x280)

(PDF) CLR-Bench: Evaluating Large Language Models in College-level ...

Large Language Model Agents for Biomedicine: A Comprehensive Review of ...

[PDF] Large Language Model-Based Agents for Software Engineering: A ...
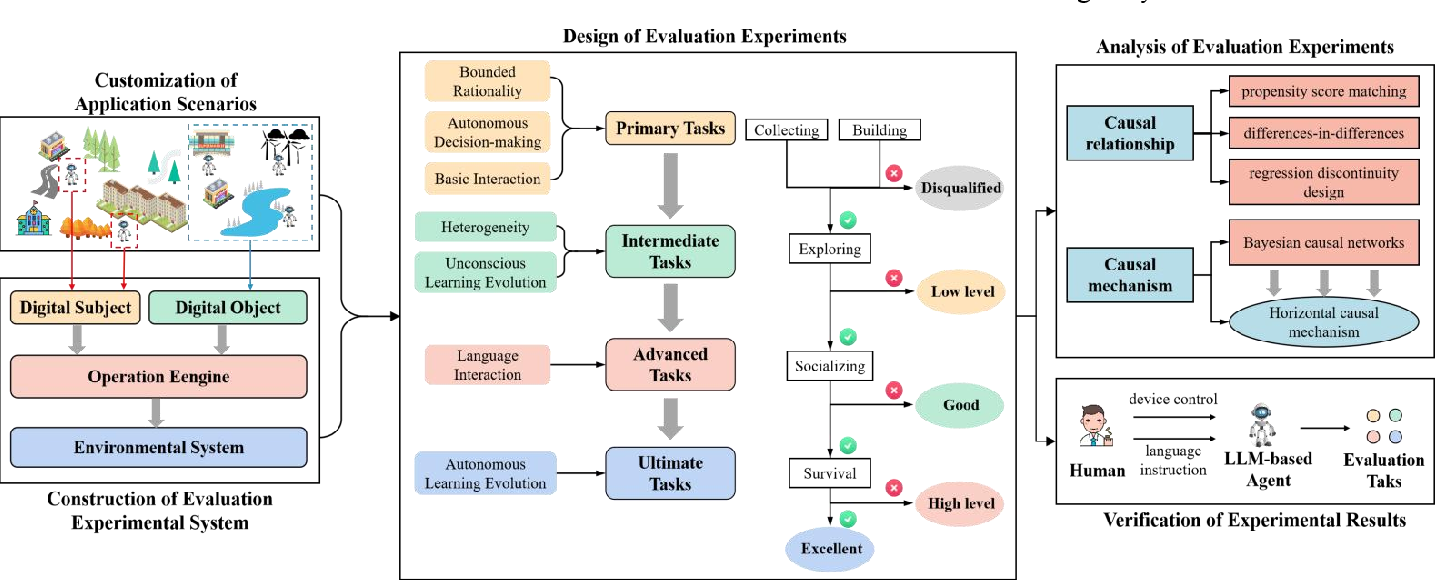
Figure 10 from Computational Experiments Meet Large Language Model ...
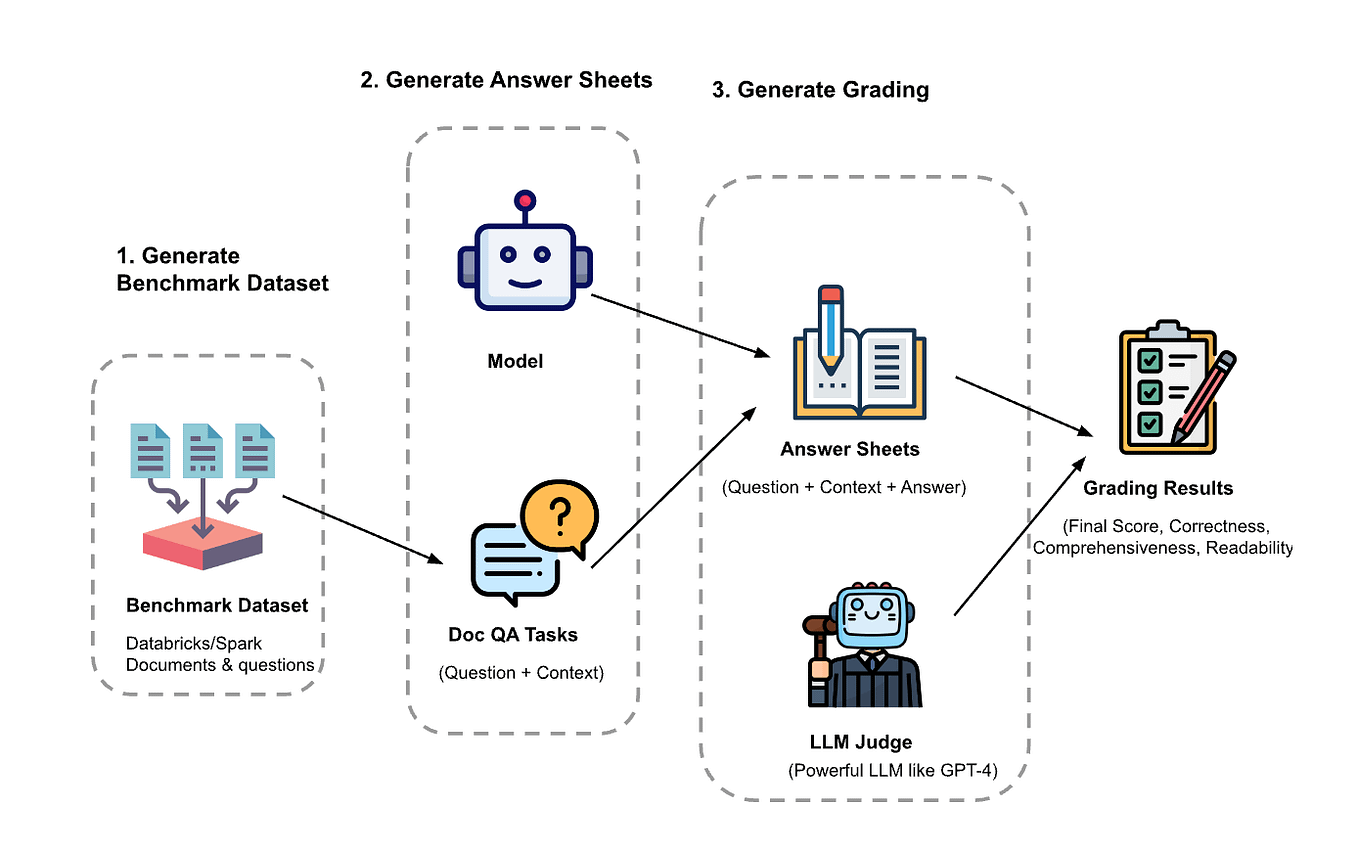
Evaluating GenAI Large Language Models (LLMs) Responses: Metrics ...
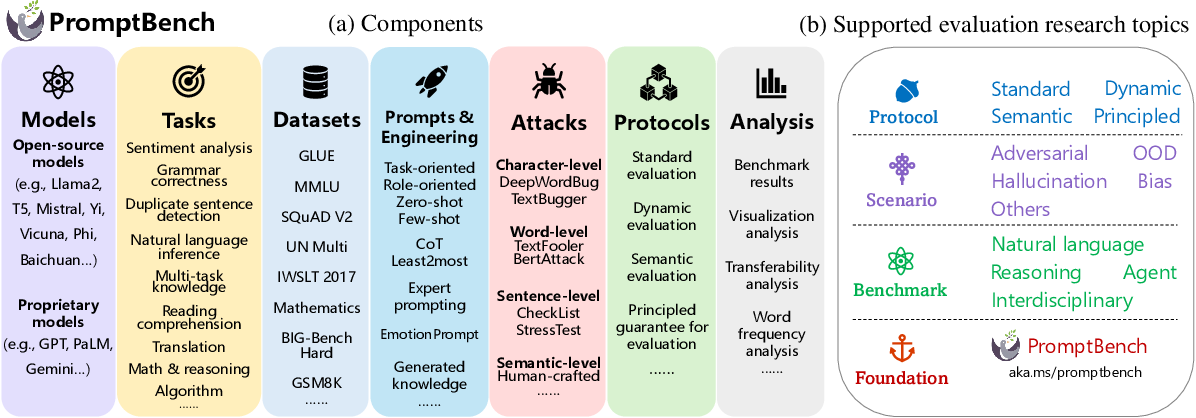
Figure 1 from PromptBench: A Unified Library for Evaluation of Large ...