
Figure 2 From Multi Feature Vision Transformer Via Self Supervised

Figure 2 from Multi-Feature Vision Transformer via Self-Supervised ...

Figure 2 from A Novel Vision Transformer with Residual in Self ...

Figure 2 from Positional Label for Self-Supervised Vision Transformer ...

Figure 2 from Self-Supervised Vision Transformer for Intelligent Fault ...

Figure 2 from A Self-Supervised Transformer With Feature Fusion for SAR ...

Figure 2 from Self-Supervised Pretraining Vision Transformer With ...

Figure 1 from MAT-VIT:A Vision Transformer with MAE-Based Self ...

Figure 2 from Cross-Attention Based Multi-Scale Feature Fusion Vision ...

Figure 2 from Dual Vision Transformer | Semantic Scholar

Figure 2 from Self-supervised Vision Transformers for Land-cover ...
Advertisement Space (300x250)
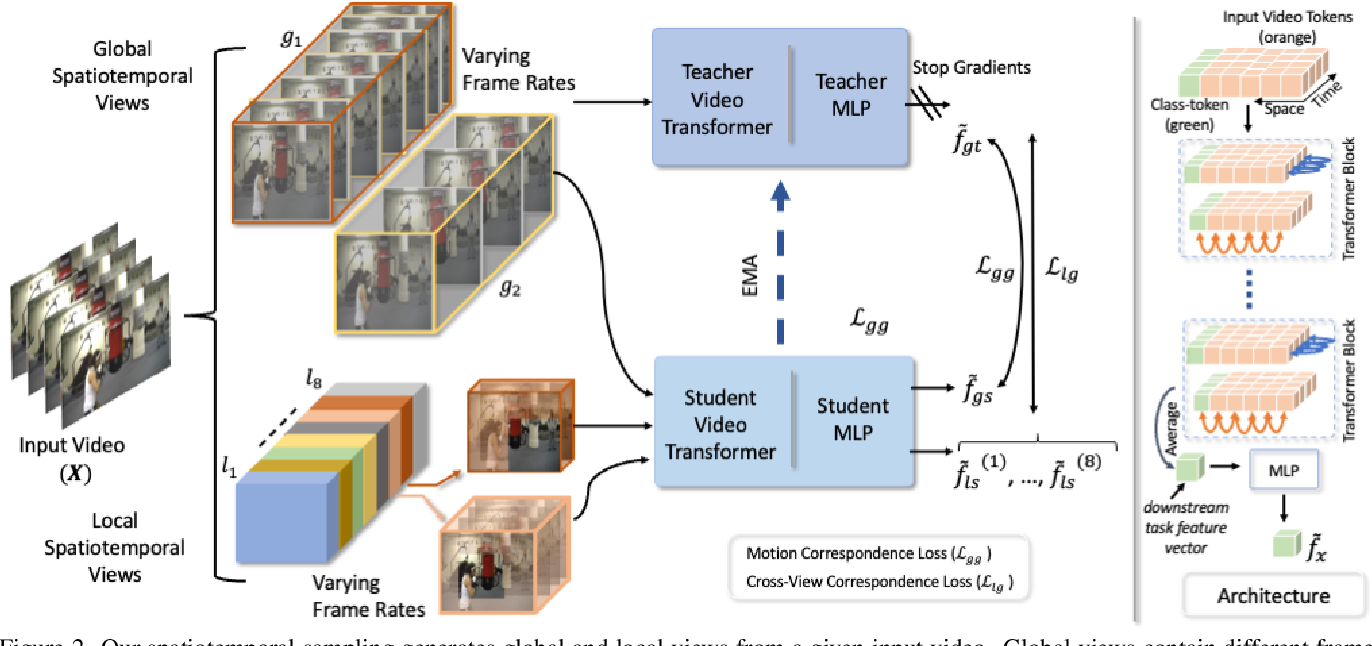
Figure 2 from Self-supervised Video Transformer | Semantic Scholar
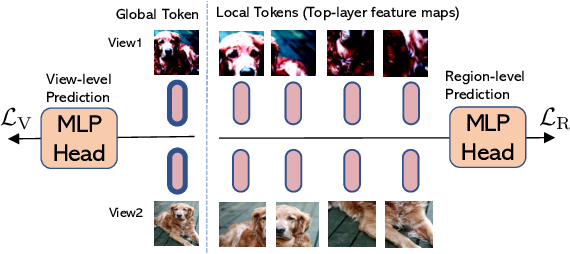
Figure 2 from Efficient Self-supervised Vision Transformers for ...

Figure 1 from Positional Label for Self-Supervised Vision Transformer ...
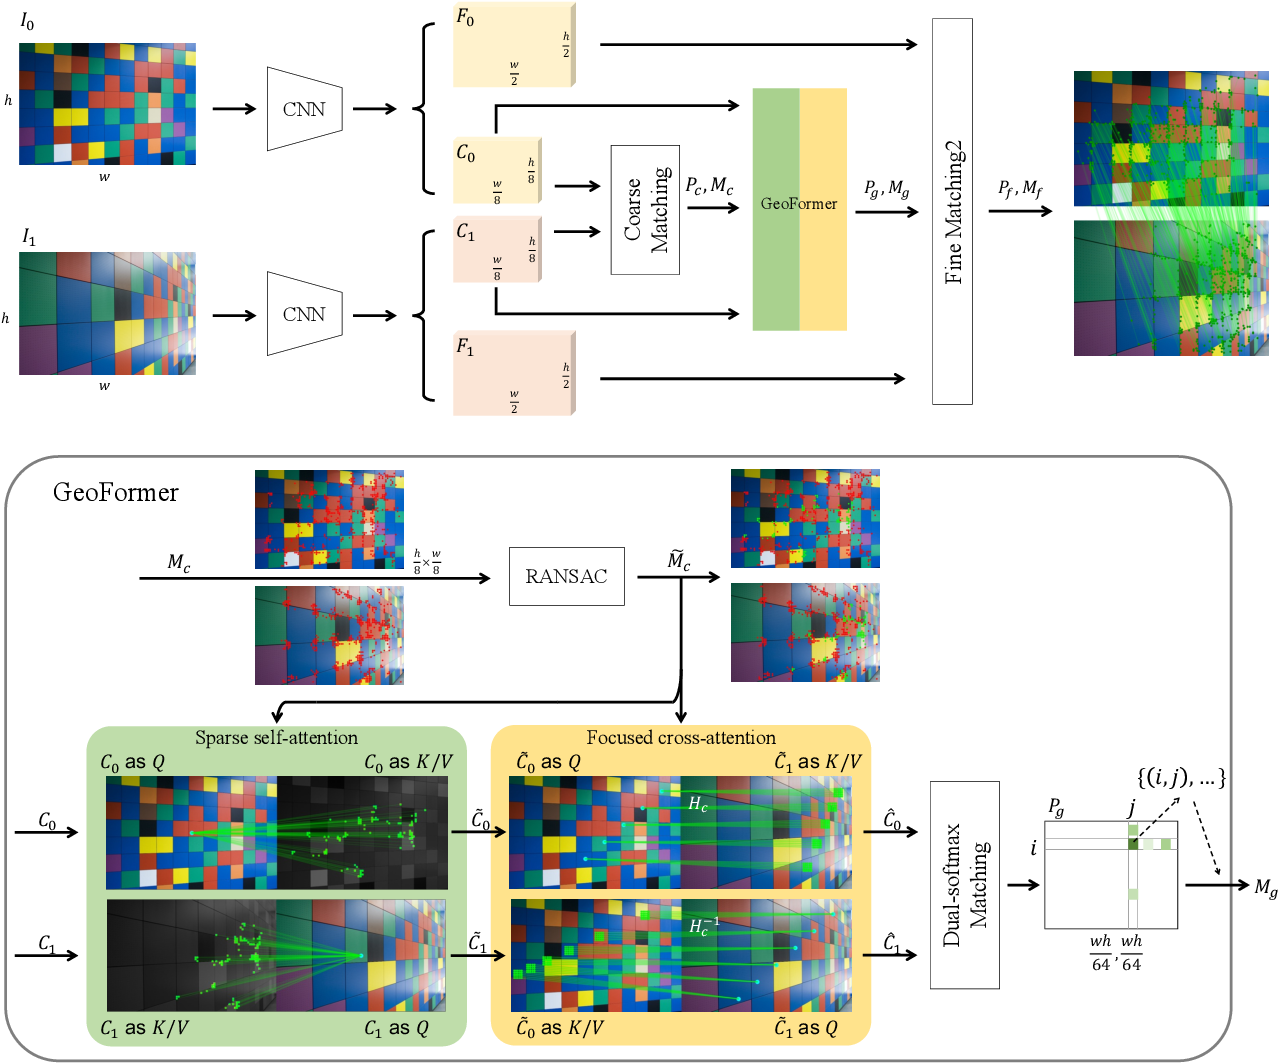
Figure 2 from Geometrized Transformer for Self-Supervised Homography ...

Figure 2 from Efficient Sedimentary Facies Recognition Using Vision ...

Figure 1 from SiT: Self-supervised vIsion Transformer | Semantic Scholar

Figure 1 from RePre: Improving Self-Supervised Vision Transformer with ...

Figure 2 from Exploring Self-Supervised Vision Transformers for Gait ...

Figure 1 from Pretraining the Vision Transformer using self-supervised ...

Figure 2 from What Do Self-Supervised Vision Transformers Learn ...
Advertisement Space (336x280)

Figure 2 from Self-Supervised Pretraining via Multimodality Images With ...

Figure 3 from A Lightweight Convolution and Vision Transformer ...

Table 1 from Multi-Feature Vision Transformer via Self-Supervised ...

Figure 1 from Self-Supervised Pretraining Vision Transformer With ...

Figure 1 from A Self-Supervised Transformer With Feature Fusion for SAR ...

Figure 2 from Self-supervised Vision Transformers for 3D Pose ...
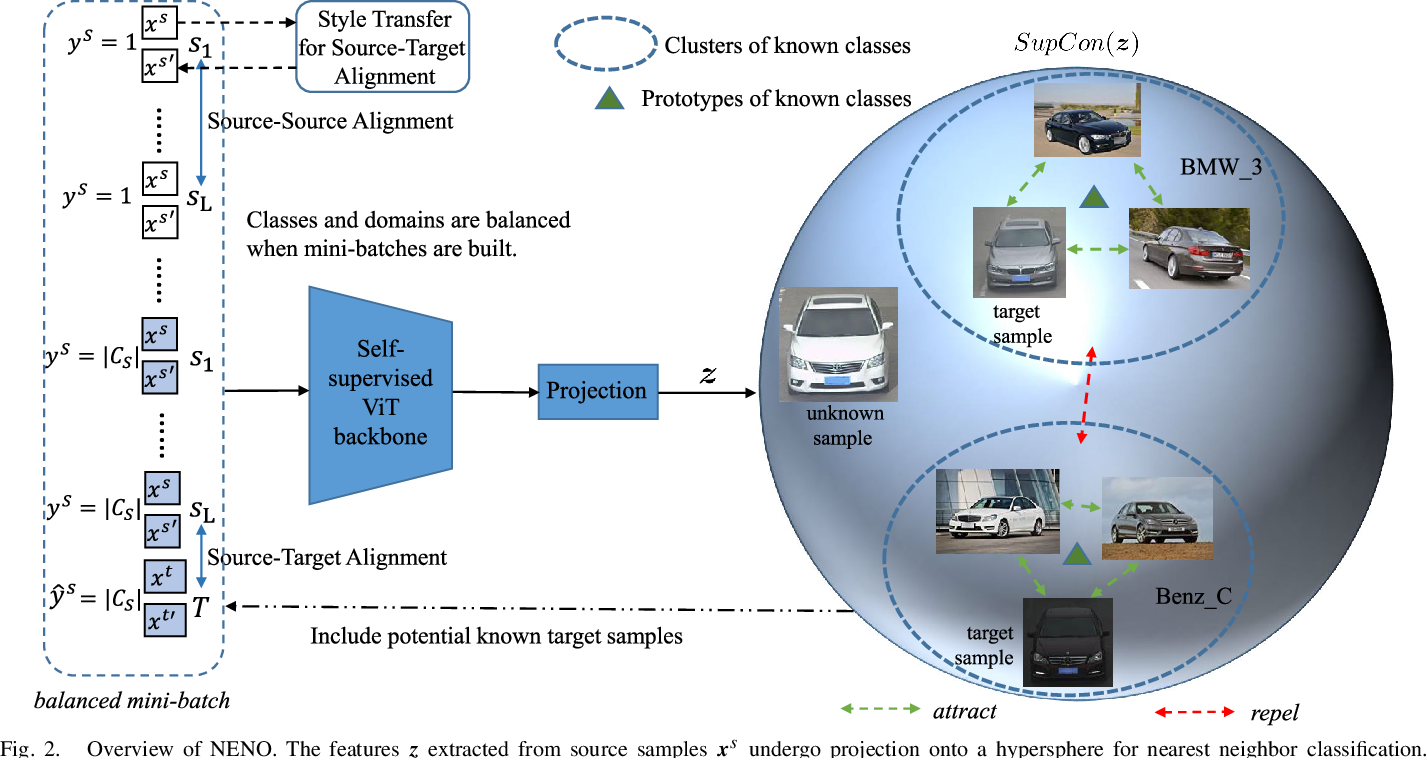
Figure 2 from Enhancing Multi-Source Open-Set Domain Adaptation Through ...

Illustration of the vision transformer (ViT) and multi self-attention ...

Figure 1 from Using Vision Transformers in 3-D Medical Image ...
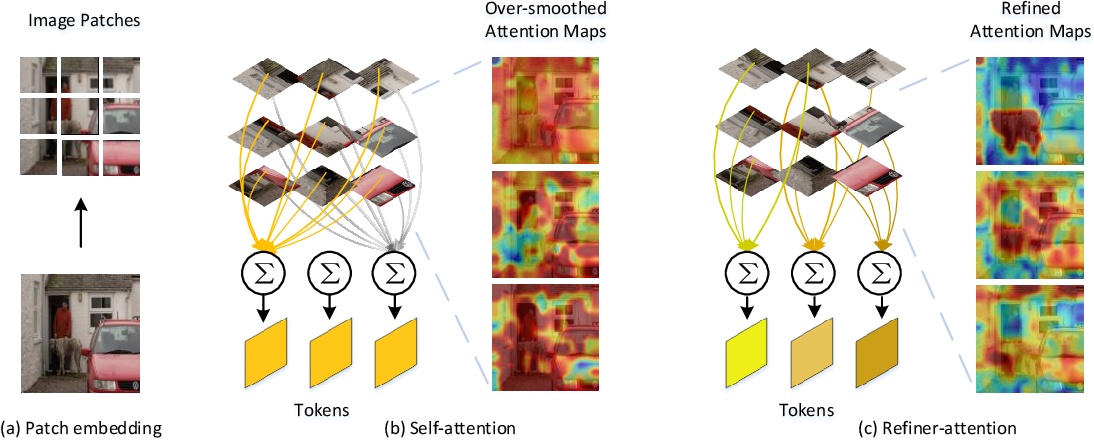
Figure 1 from Refiner: Refining Self-attention for Vision Transformers ...
Advertisement Space (336x280)

Multi-Feature Vision Transformer via Self-Supervised Representation ...

Scaling Vision Transformers To Gigapixel Images Via Hierarchical Self ...

Figure 3 from Self-Supervised Pretraining via Multimodality Images With ...
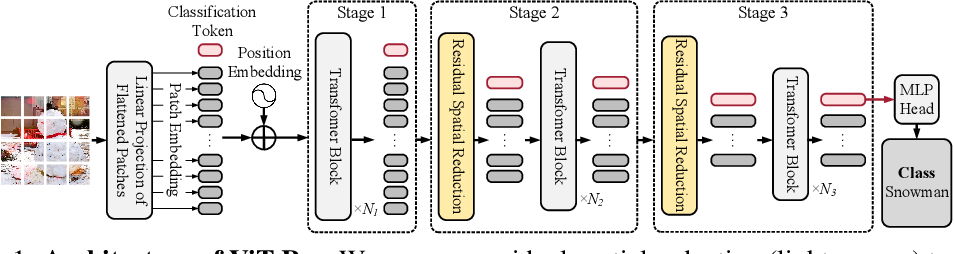
Figure 1 from Searching for Efficient Multi-Stage Vision Transformers ...

Figure 1 from Attention Distillation: self-supervised vision ...
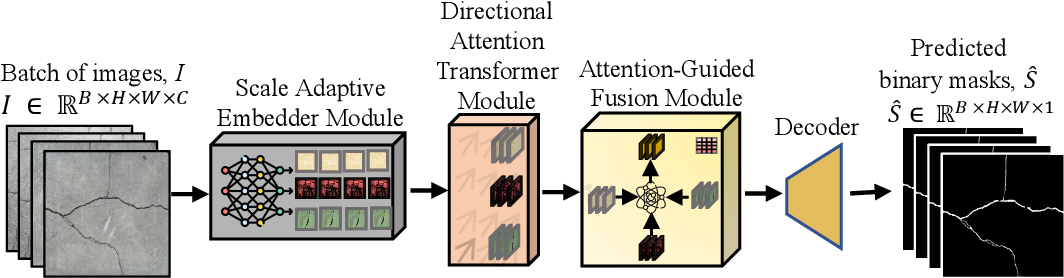
Figure 1 from Self-Supervised Multi-Scale Transformer with Attention ...