
Figure 2 From Multi View Transformer For 3d Visual Grounding Semantic

Figure 2 from Multi-View Transformer for 3D Visual Grounding | Semantic ...

Figure 3 from Multi-View Transformer for 3D Visual Grounding | Semantic ...
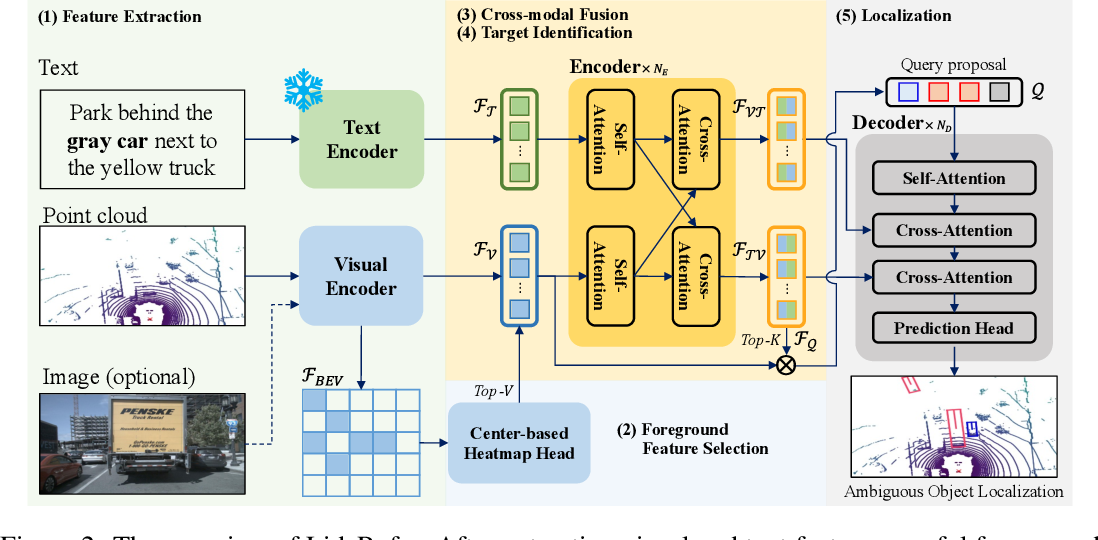
Figure 2 from LidaRefer: Outdoor 3D Visual Grounding for Autonomous ...

Figure 2 from A Unified Framework for 3D Point Cloud Visual Grounding ...

Figure 2 from Multimodal Incremental Transformer with Visual Grounding ...

Figure 2 from ViewInfer3D: 3D Visual Grounding Based on Embodied ...
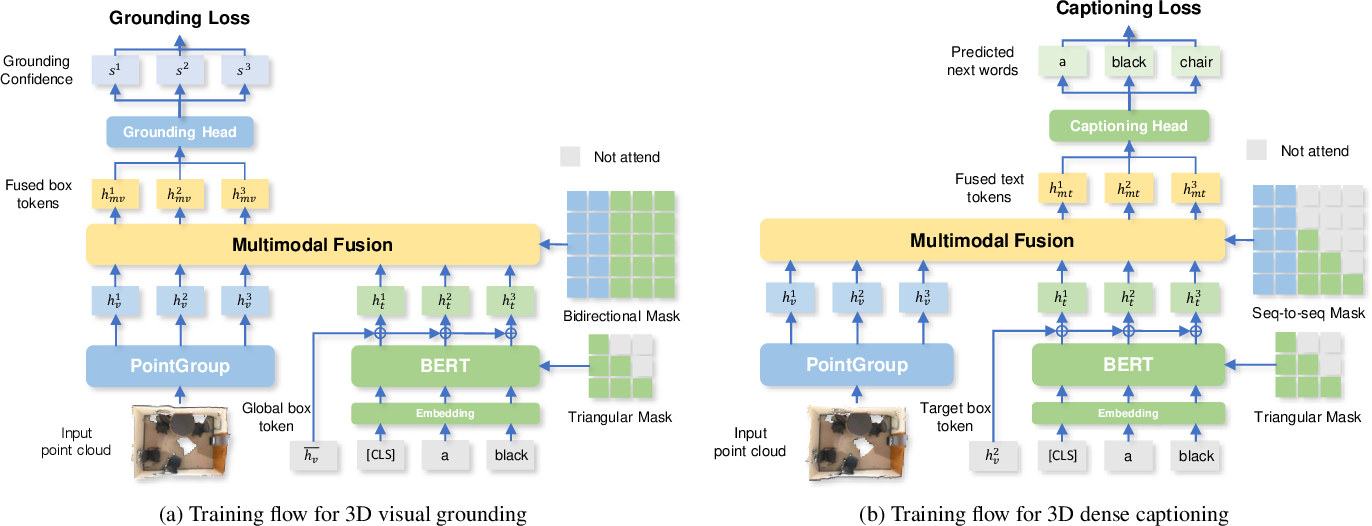
Figure 2 from UniT3D: A Unified Transformer for 3D Dense Captioning and ...

Figure 2 from Free-form Description Guided 3D Visual Graph Network for ...
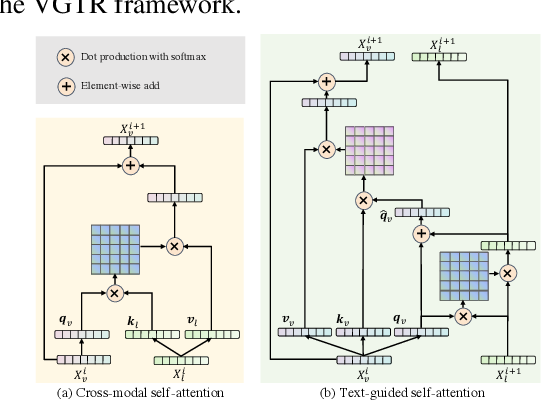
Figure 2 from Visual Grounding with Transformers | Semantic Scholar
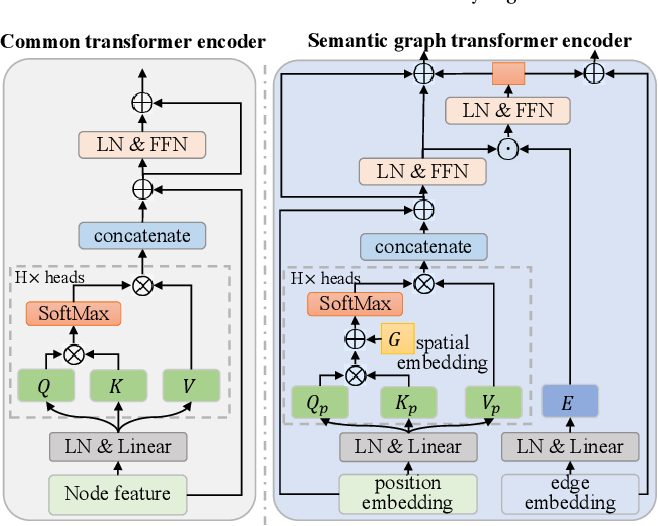
Figure 1 from Deep Semantic Graph Transformer for Multi-View 3D Human ...
Advertisement Space (300x250)

Figure 3 from A Transformer-based Framework for Visual Grounding on 3D ...

Figure 2 from Rethinking 3D Dense Caption and Visual Grounding in A ...

Figure 1 from LidaRefer: Outdoor 3D Visual Grounding for Autonomous ...
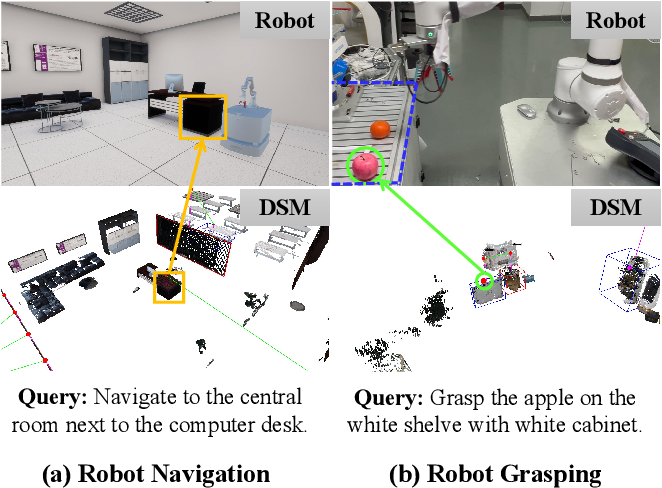
Figure 5 from DSM: Constructing a Diverse Semantic Map for 3D Visual ...
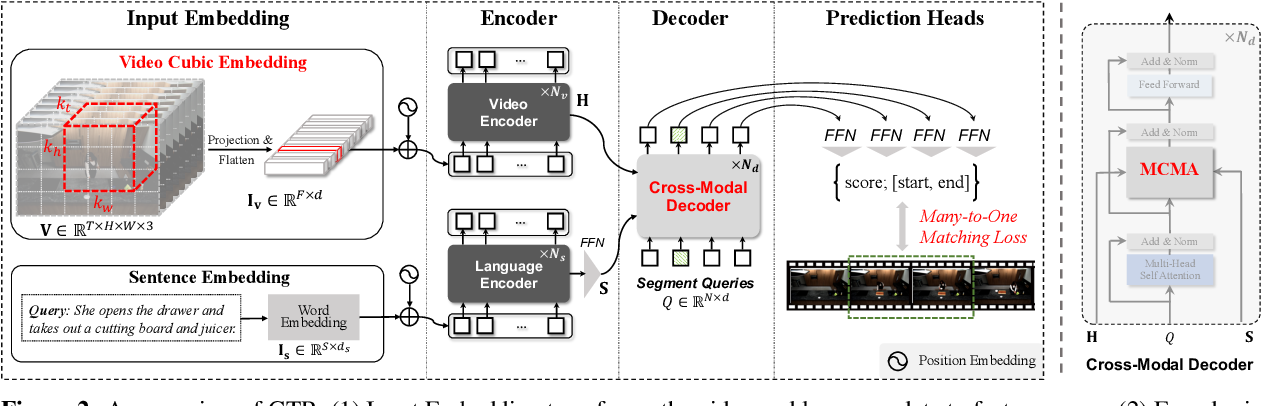
Figure 2 from On Pursuit of Designing Multi-modal Transformer for Video ...

Figure 2 from MVT: Chinese NER Using Multi-View Transformer | Semantic ...

Figure 1 from ViewRefer: Grasp the Multi-view Knowledge for 3D Visual ...

Multi-View Transformer for 3D Visual Grounding | DeepAI

[2504.08307] DSM: Building A Diverse Semantic Map for 3D Visual Grounding

Figure 1 from Multi-Modal Dynamic Graph Transformer for Visual ...
Advertisement Space (336x280)

Figure 1 from Group Multi-View Transformer for 3D Shape Analysis With ...

Figure 1 from AugRefer: Advancing 3D Visual Grounding via Cross-Modal ...

Figure 4 from Weakly-Supervised 3D Visual Grounding based on Visual ...

Figure 2 from Multi3DRefer: Grounding Text Description to Multiple 3D ...

Figure 1 from Visual Grounding with Transformers | Semantic Scholar

Figure 2 from Dual Vision Transformer | Semantic Scholar

Figure 1 from Cross3DVG: Cross-Dataset 3D Visual Grounding on Different ...

Figure 1 from Rethinking 3D Dense Caption and Visual Grounding in A ...
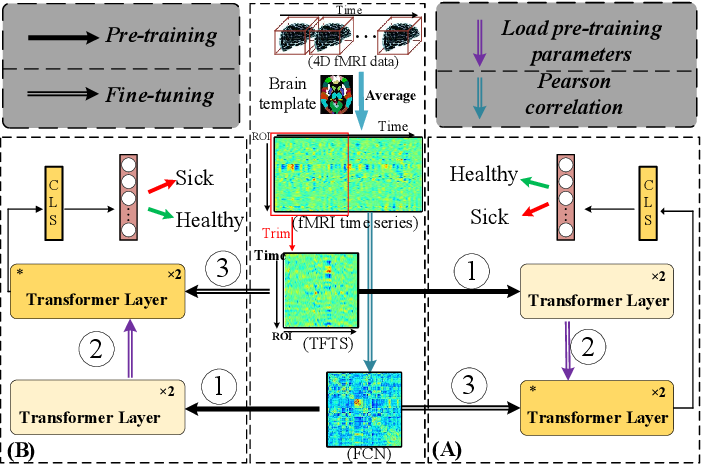
Figure 2 from Transformer Based Multi-view Learning for Integrating ...

Figure 1 from SeCG: Semantic-Enhanced 3D Visual Grounding via Cross ...
Advertisement Space (336x280)
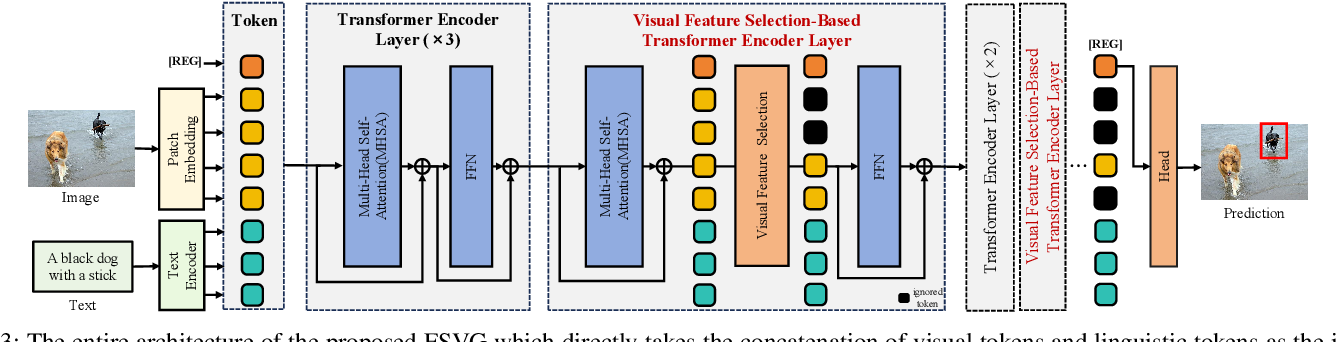
Figure 3 from A Simple and Better Baseline for Visual Grounding ...
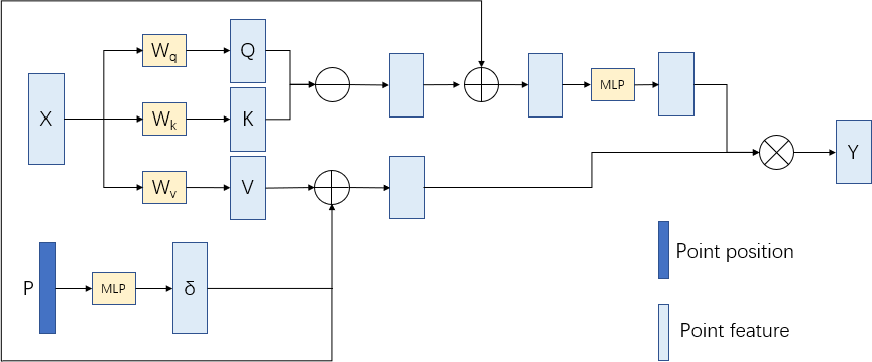
Figure 2 from Multi-view Network with Transformer for Point Cloud ...

Figure 1 from Weakly-Supervised 3D Visual Grounding based on Visual ...

Figure 3 from LLM-Grounder: Open-Vocabulary 3D Visual Grounding with ...
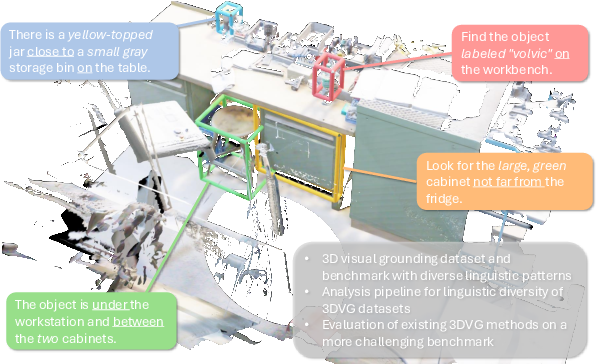
Figure 1 from ViGiL3D: A Linguistically Diverse Dataset for 3D Visual ...
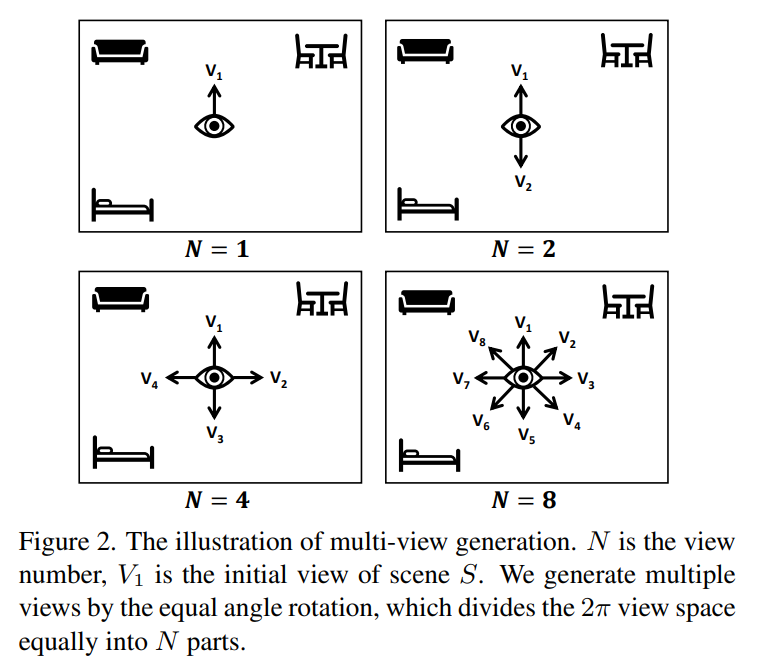
[1] Multi-View Transformer for 3D Visual Grounding 论文精读 - 爱和九九 - 博客园