
Figure 2 From Multipath Vit Ocr A Lightweight Visual Transformer Based

Figure 2 from MultiPath ViT OCR: A Lightweight Visual Transformer-based ...

Figure 1 from MultiPath ViT OCR: A Lightweight Visual Transformer-based ...

Table I from MultiPath ViT OCR: A Lightweight Visual Transformer-based ...

Figure 2 from ViT-ReciproCAM: Gradient and Attention-Free Visual ...

ICCKE22-MultiPath ViT OCR A Lightweight License Plate Optical Character ...

Figure 2 from A free lunch from ViT: adaptive attention multi-scale ...

ViT - Visual Transformer Intro | PDF
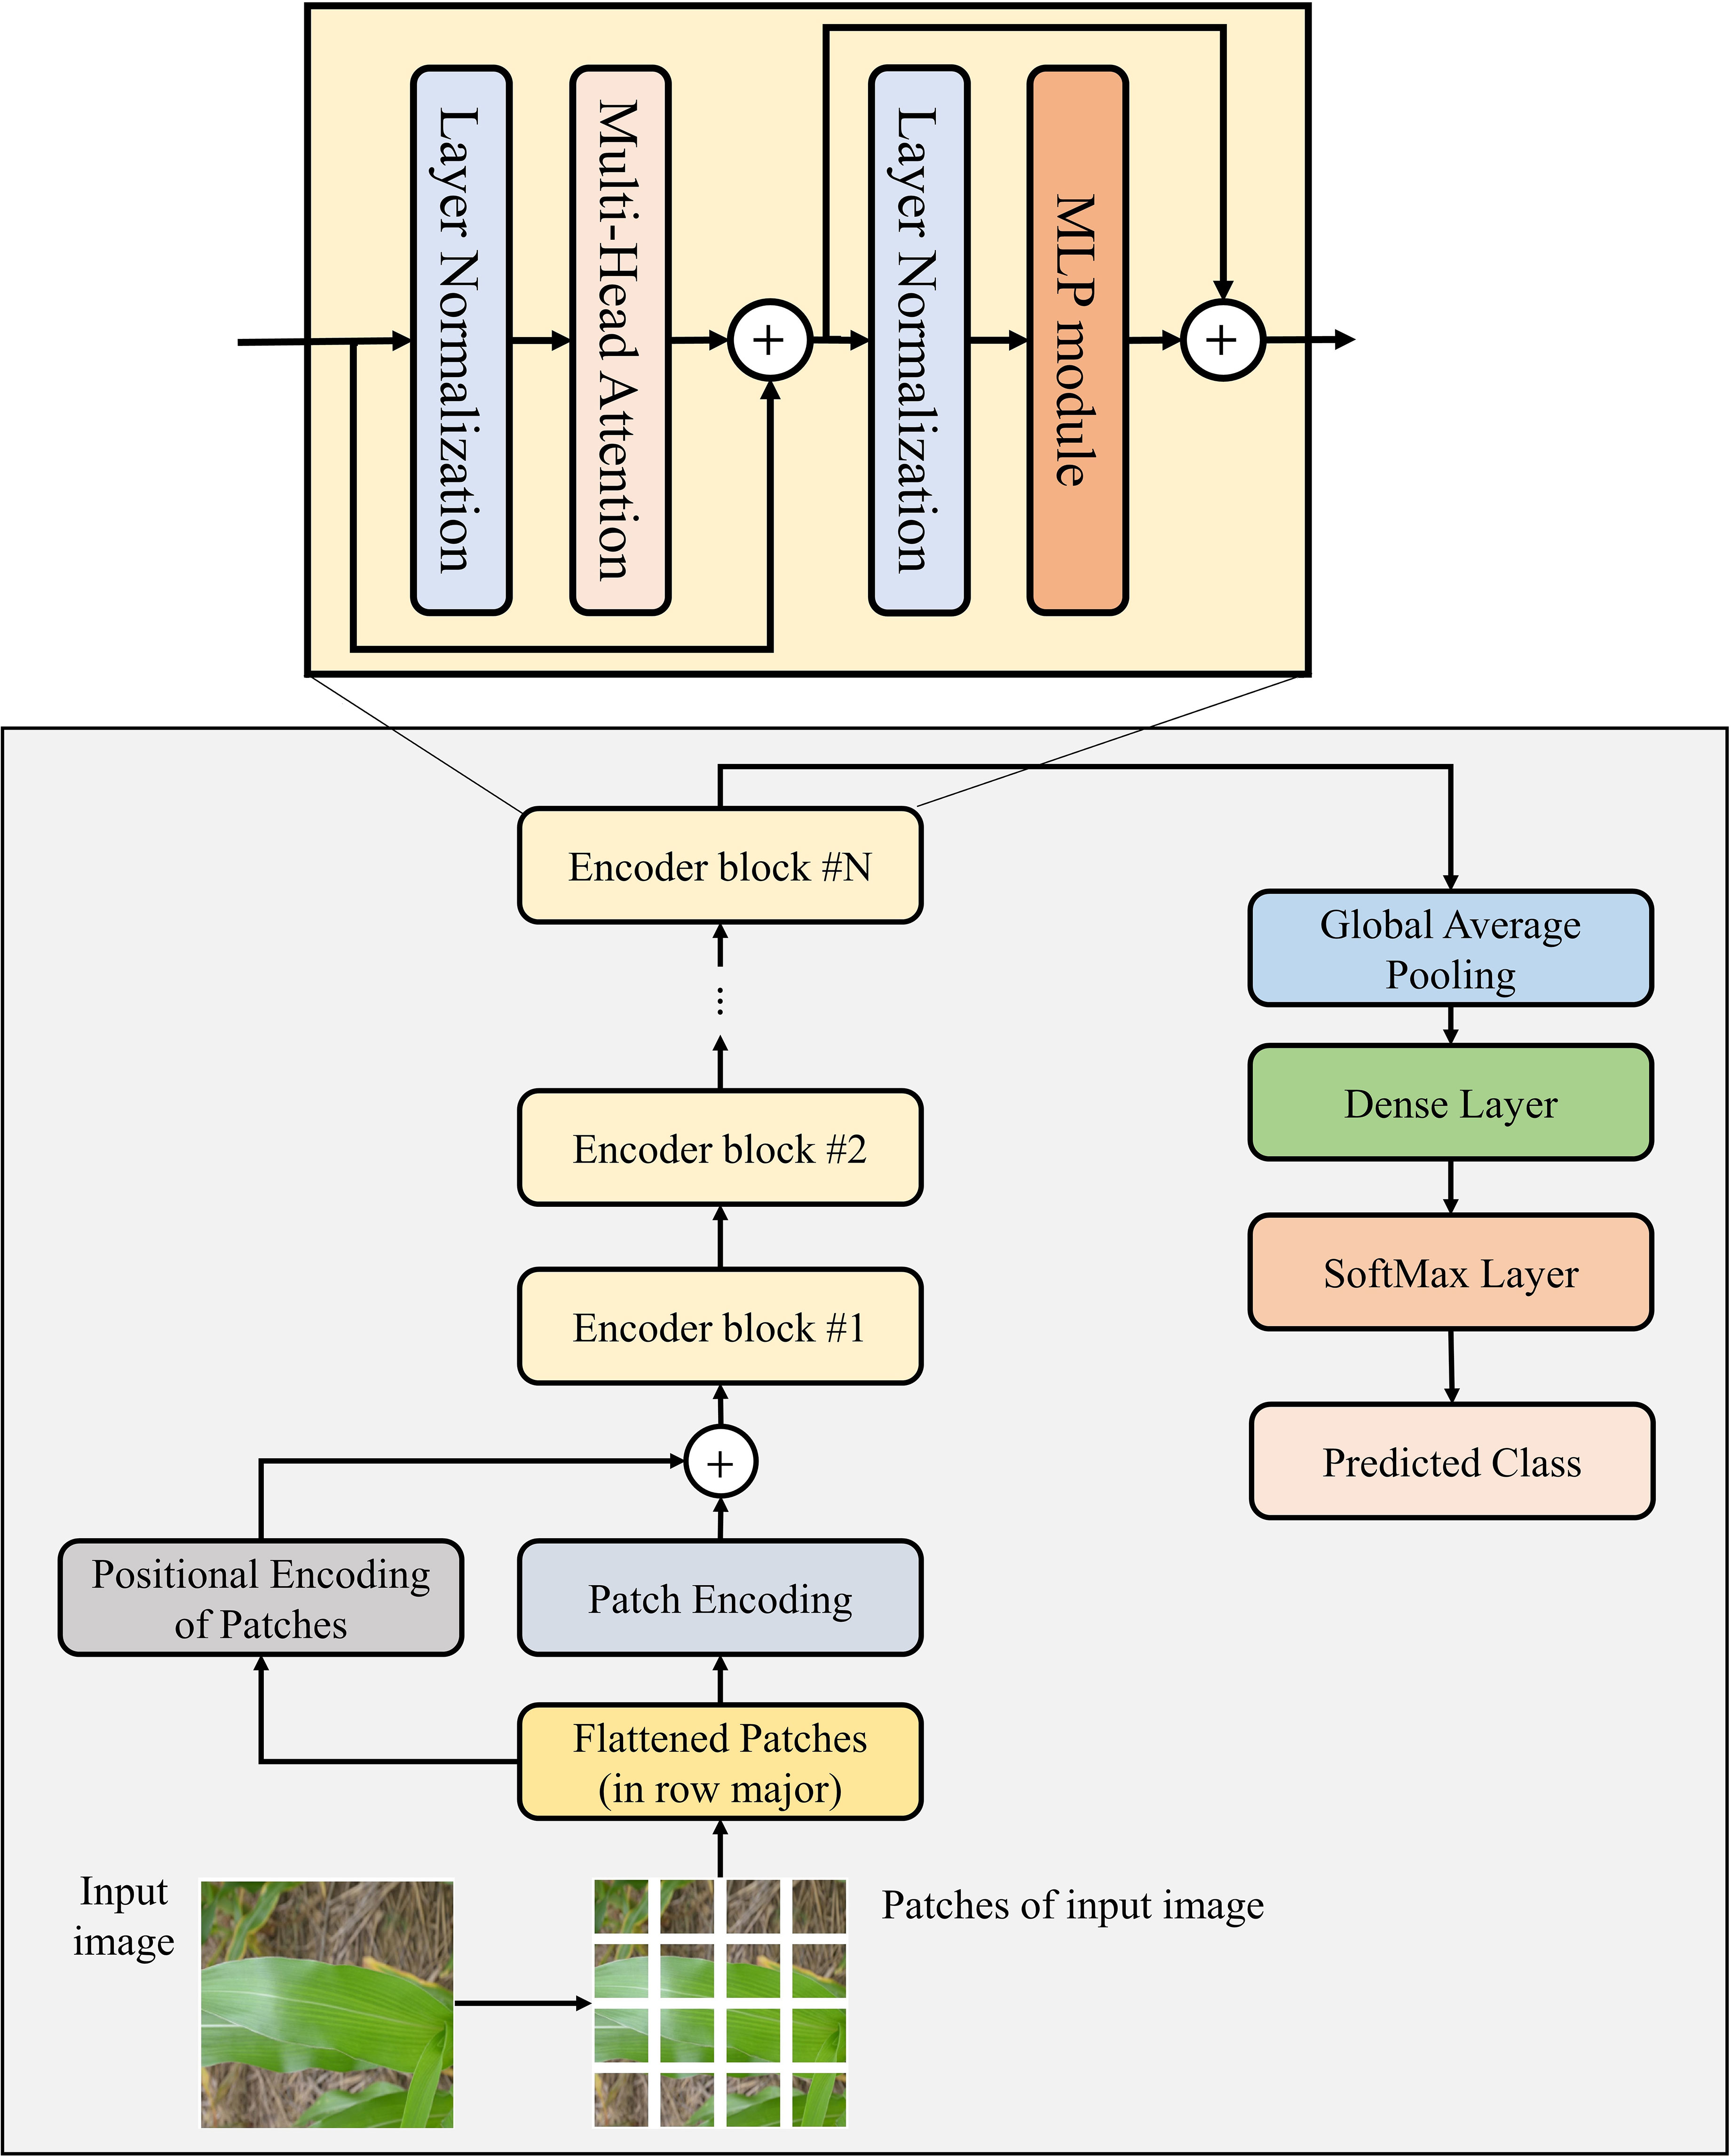
Frontiers | TrIncNet: a lightweight vision transformer network for ...

SpectroFusion-ViT: A Lightweight Transformer for Speech Emotion ...

Figure 2 from Automated Handwriting Pattern Recognition for Multi-Level ...
Advertisement Space (300x250)
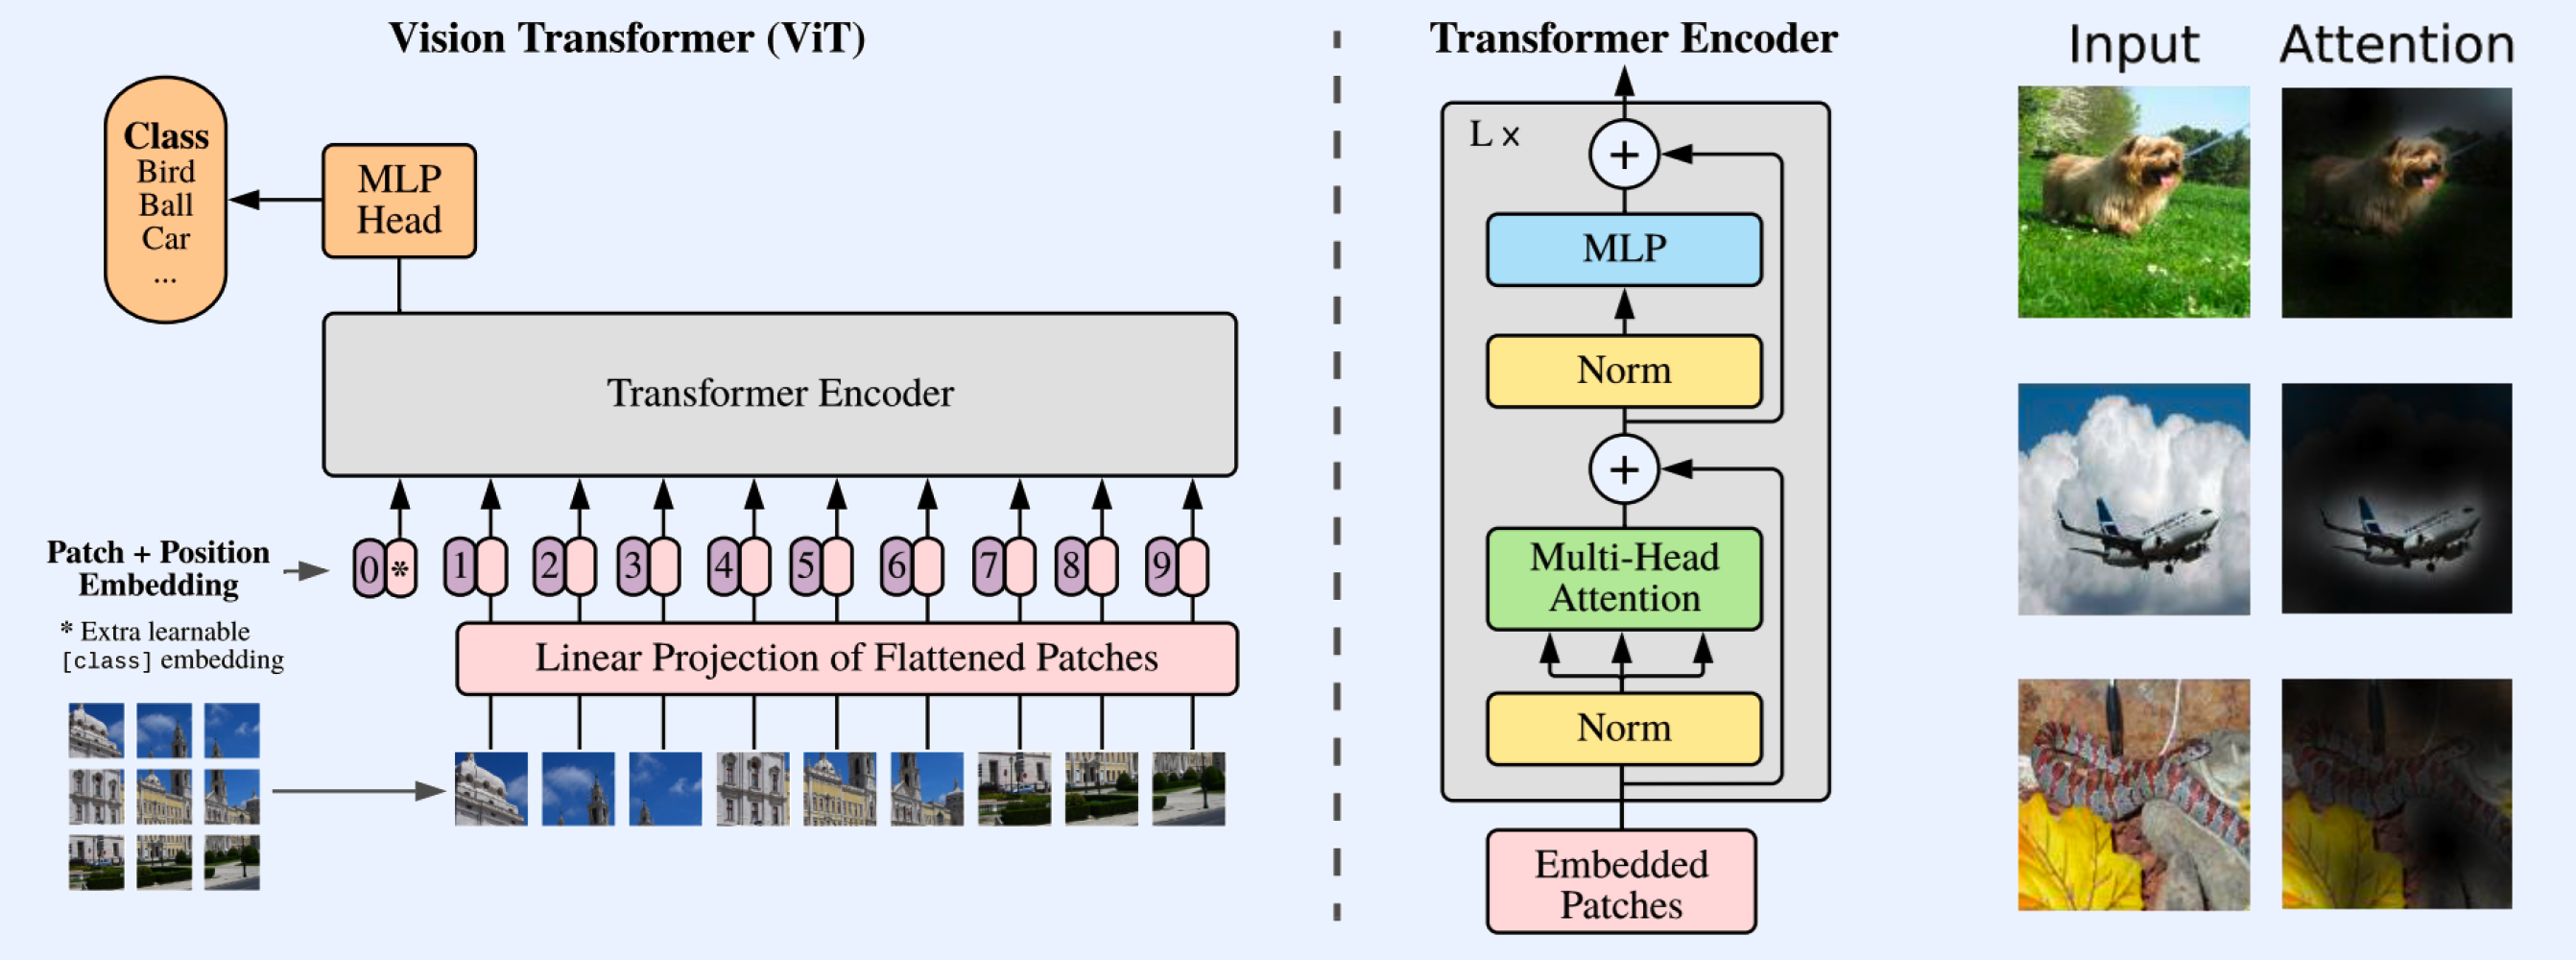
Context Understanding - Visual Transformer - AAA (All About AI)
Vision Transformer ViT model overall architecture | Download Scientific ...

VIT Adapter【Vision Transformer Adapter for Dense Predictions】论文笔记-CSDN博客

Visual Transformer (ViT)模型详解-CSDN博客

(PDF) ViT-Core: Lightweight Anomaly Detection Model using Transformer ...

ViT | Vision Transformer | Vision Transformer (ViT) Architecture ...

Lightweight Visual Transformers Outperform Convolutional Neural ...
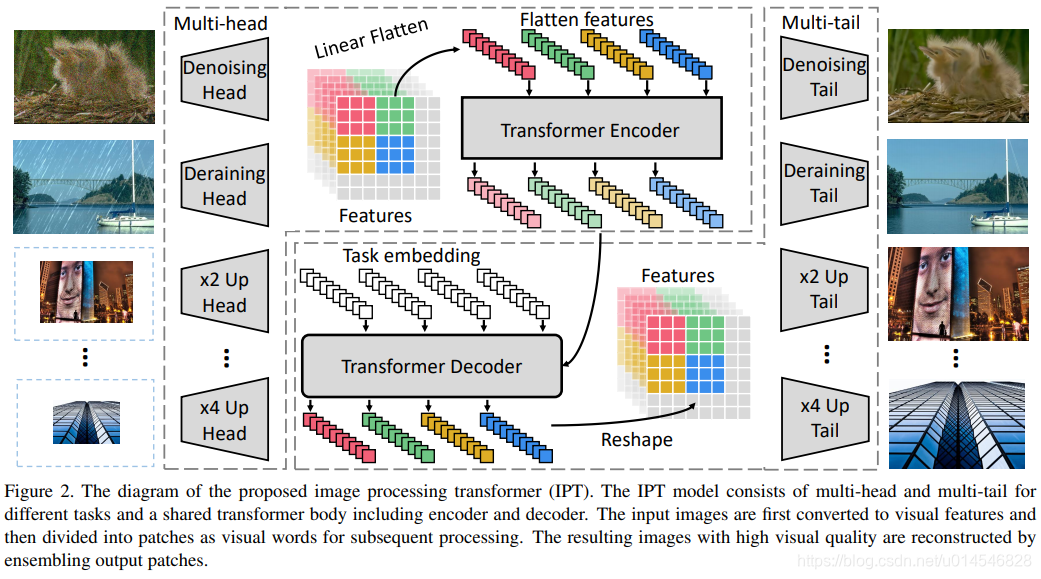
CVPR 2021 Visual Transformer 论文合集(附20篇推荐必读ViT论文)_vit提出以来的论文数量-CSDN博客

LW-ViT: The Lightweight Vision Transformer Model Applied in Offline ...
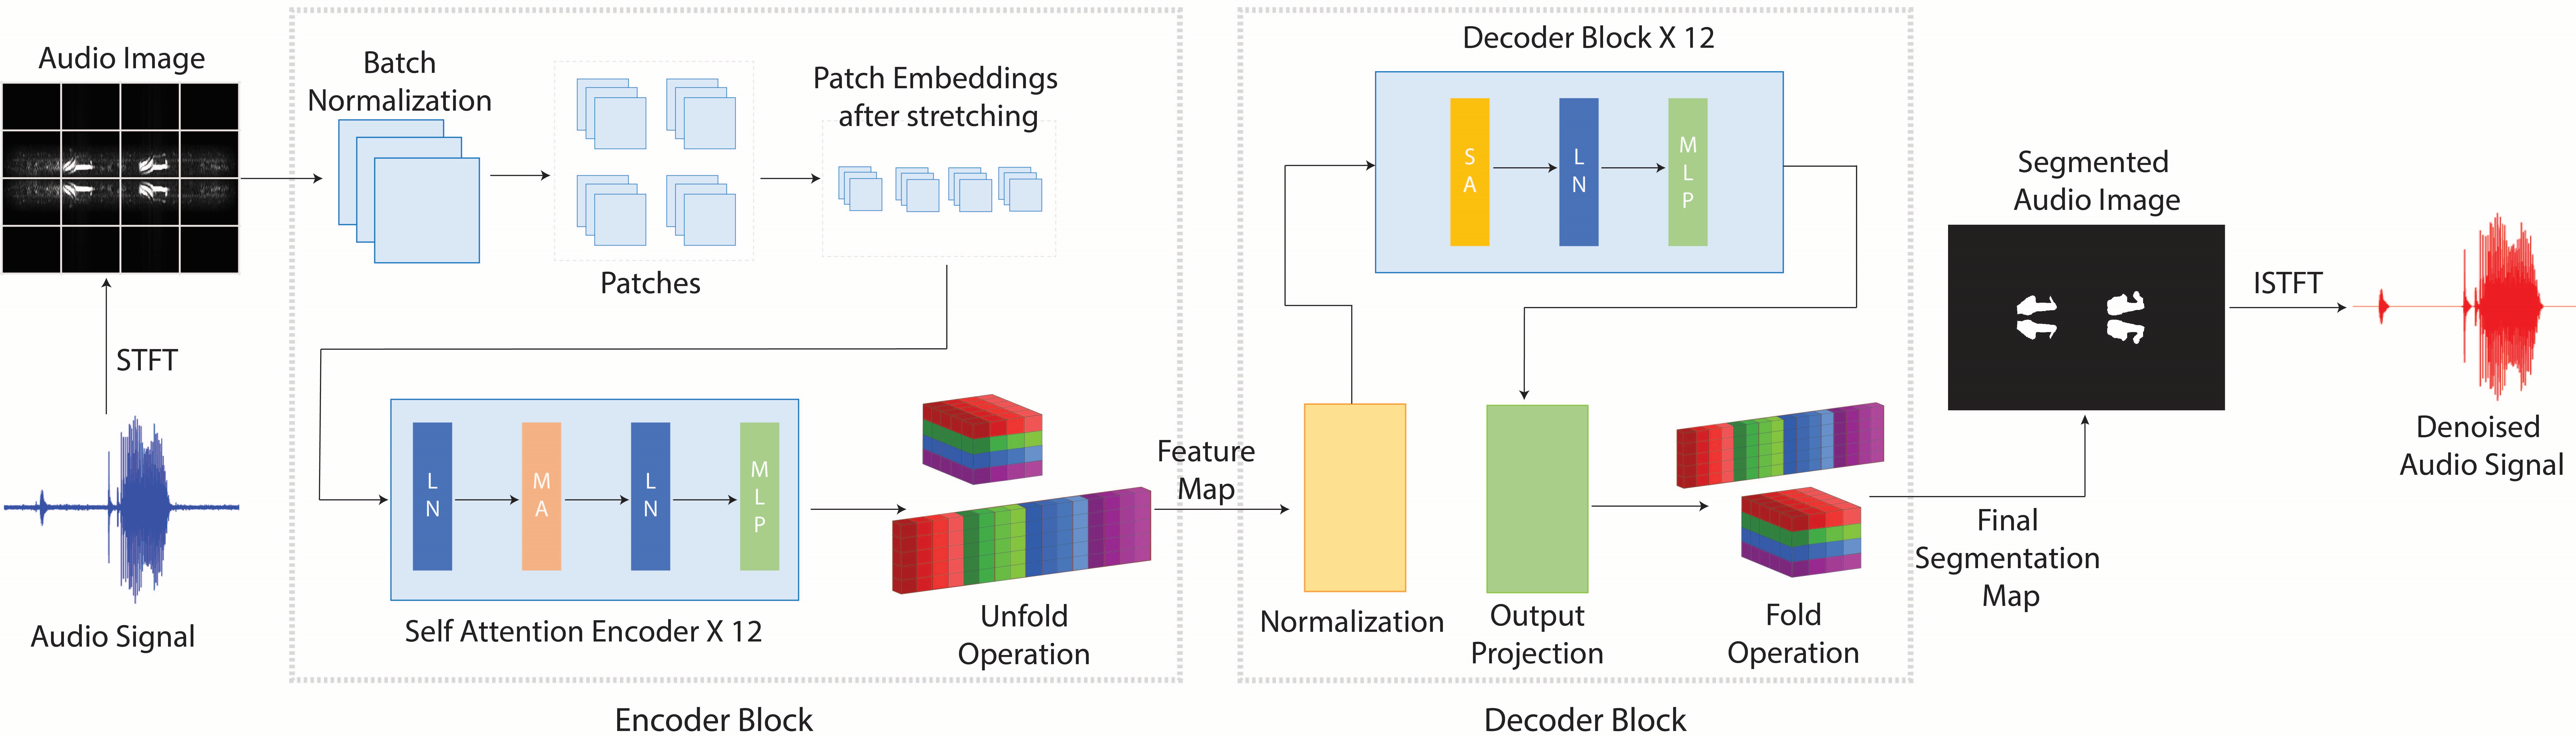
[2406.09167] Vision Transformer Segmentation for Visual Bird Sound ...
Advertisement Space (336x280)

CVPR 2021 Visual Transformer 论文合集(附20篇推荐必读ViT论文)_vit提出以来的论文数量-CSDN博客

A Vision Transformer with Adaptive Cross-Image and Cross-Resolution ...

computer vision transformers: ViT does not have a decoder? - Data ...

CVPR 2021 Visual Transformer 论文合集(附20篇推荐必读ViT论文)_vit提出以来的论文数量-CSDN博客

Visual Transformer (ViT) — image segmentation prompt documentation

Visual Transformer (ViT) — Documentation image segmentation prompt

(PDF) Compact DINO-ViT: Feature Reduction for Visual Transformer

(PDF) LW-ViT: The Lightweight Vision Transformer Model Applied in ...

Visual Transformer (ViT)模型详解-CSDN博客

Lightweight Visual Transformers Outperform Convolutional Neural ...
Advertisement Space (336x280)

LW-ViT: The Lightweight Vision Transformer Model Applied in Offline ...

When Vision Fails: Text Attacks Against ViT and OCR | Proceedings of ...
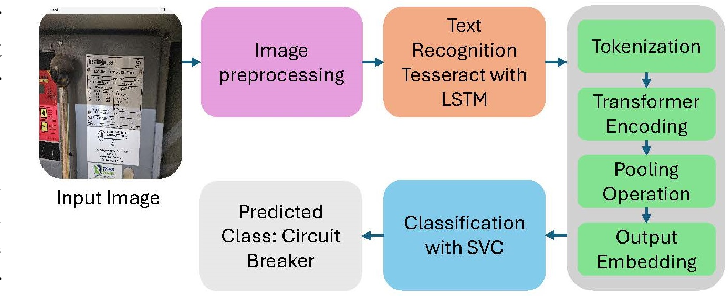
Figure 1 from Enhancing Power System Component Classification with ...
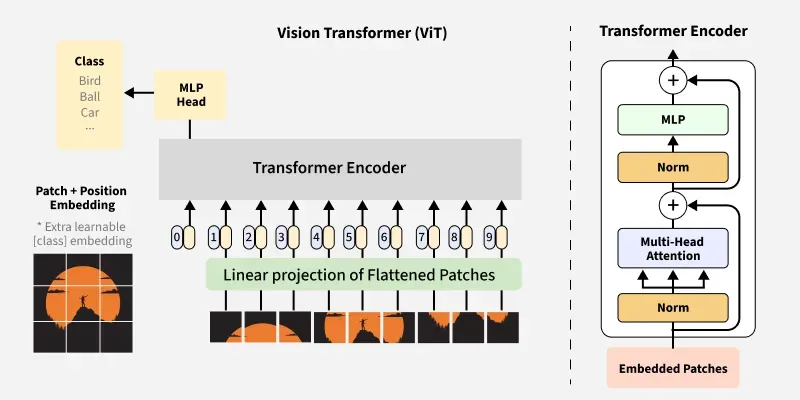
Vision Transformer (ViT) Architecture - GeeksforGeeks

【CVPR2022】MPViT : Multi-Path Vision Transformer for Dense Prediction - 知乎

[VIT] Visual Transformer-CSDN博客