
Figure 2 From Predicting Visual Futures With Image Captioning And Pre
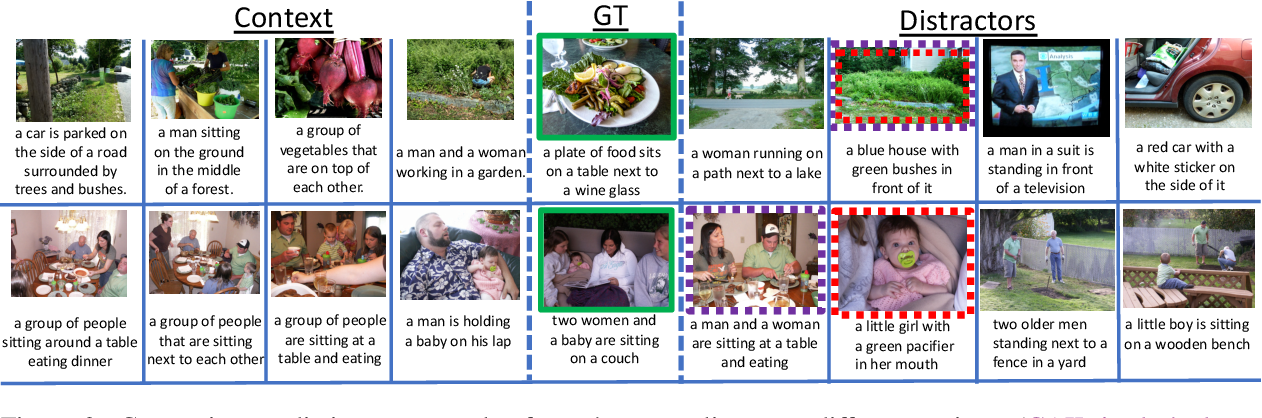
Figure 2 from Predicting Visual Futures with Image Captioning and Pre ...
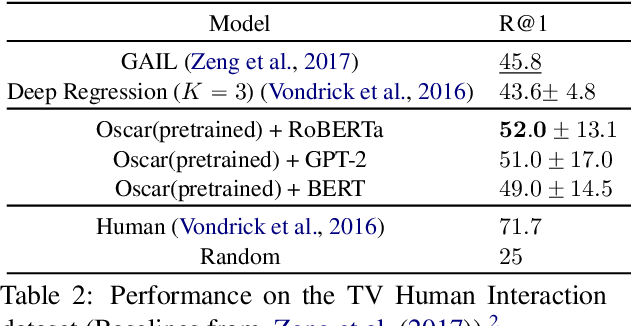
Table 2 from Predicting Visual Futures with Image Captioning and Pre ...

Figure 1 from Predicting Visual Futures with Image Captioning and Pre ...

Figure 3 from Predicting Visual Futures with Image Captioning and Pre ...
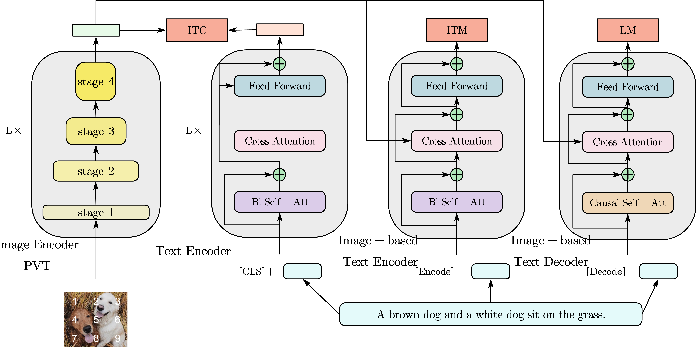
Figure 2 from Research on Image Captioning Based on Vision-language Pre ...

Figure 2 from Visual Captioning at Will: Describing Images and Videos ...

Figure 2 from Improving Image Captioning via Predicting Structured ...

Figure 2 from Visual Analytics for Efficient Image Exploration and User ...

Figure 2 from Improving Image Captioning via Predicting Structured ...

Figure 2 from Explore and Tell: Embodied Visual Captioning in 3D ...
Advertisement Space (300x250)

Figure 2 from Towards Local Visual Modeling for Image Captioning ...

Figure 1 from Improving Image Captioning through Visual and Semantic ...

Figure 2 from Semantic Embedding Guided Attention with Explicit Visual ...

Predicting Visual Features from Text for Image and Video Caption Retrieval

Figure 2 from Differentiate Visual Features with Guidance Signals for ...

Predicting Visual Features from Text for Image and Video Caption Retrieval

Predicting Visual Features from Text for Image and Video Caption Retrieval

(PDF) Predicting Visual Features From Text for Image and Video Caption ...

Predicting Visual Features from Text for Image and Video Caption Retrieval

Figure 3 from Research on Image Captioning Based on Vision-language Pre ...
Advertisement Space (336x280)

Figure 4 from Improving Image Captioning via Predicting Structured ...

Figure 1 from Towards Local Visual Modeling for Image Captioning ...

Figure 3 from GRIT: Faster and Better Image captioning Transformer ...

Table 2 from GRIT: Faster and Better Image captioning Transformer Using ...
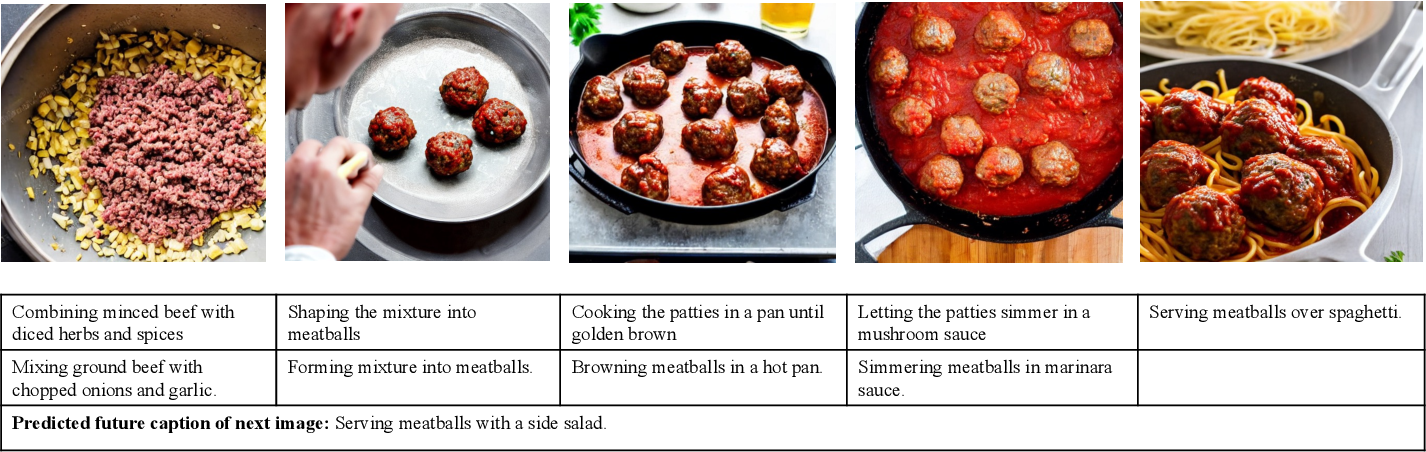
Figure 2 from A Two-Stage Vision-Language Model for Image Captioning ...

Figure 1 from Affective Image Captioning for Visual Artworks Using ...
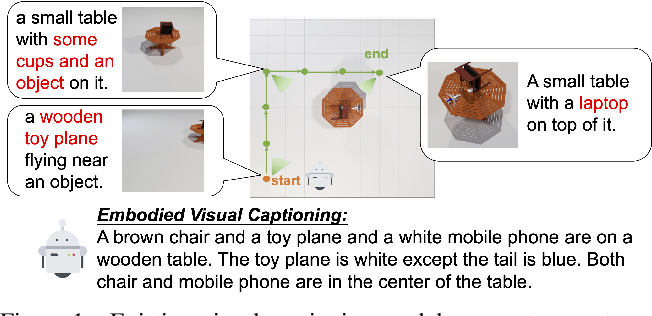
Figure 1 from Explore and Tell: Embodied Visual Captioning in 3D ...
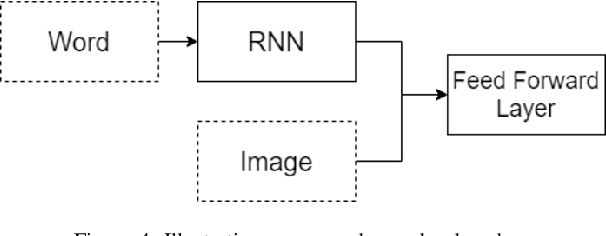
Figure 2 from The Role of Transformer-based Image Captioning for Indoor ...

Figure 1 from GRIT: Faster and Better Image captioning Transformer ...

Figure 1 from Unified Vision-Language Pre-Training for Image Captioning ...
Advertisement Space (336x280)

(PDF) A Concise and Varied Visual Features-Based Image Captioning Model ...

Figure 2 from Towards Knowledge-Aware Video Captioning via Transitive ...

Figure 1 from Improving Remote Sensing Image Captioning by Combining ...
Average R 2 scores when predicting future visual acuity from all ...

Figure 3 from Video Captioning using Pre-Trained CNN and LSTM ...

Figure 1 from Exploration of Visual Features and their weighted ...