
Figure 2 From Pretraining The Vision Transformer Using Self Supervised

Figure 2 from Pretraining the Vision Transformer using self-supervised ...

Figure 2 from Self-Supervised Pretraining Vision Transformer With ...

Figure 2 from How to Train Vision Transformer on Small-scale Datasets ...

Figure 2 from Self-Supervised Vision Transformer for Intelligent Fault ...

Figure 2 from Positional Label for Self-Supervised Vision Transformer ...

(PDF) Pretraining the Vision Transformer Using Self-Supervised Methods ...

Pretraining the Vision Transformer using self-supervised methods for ...
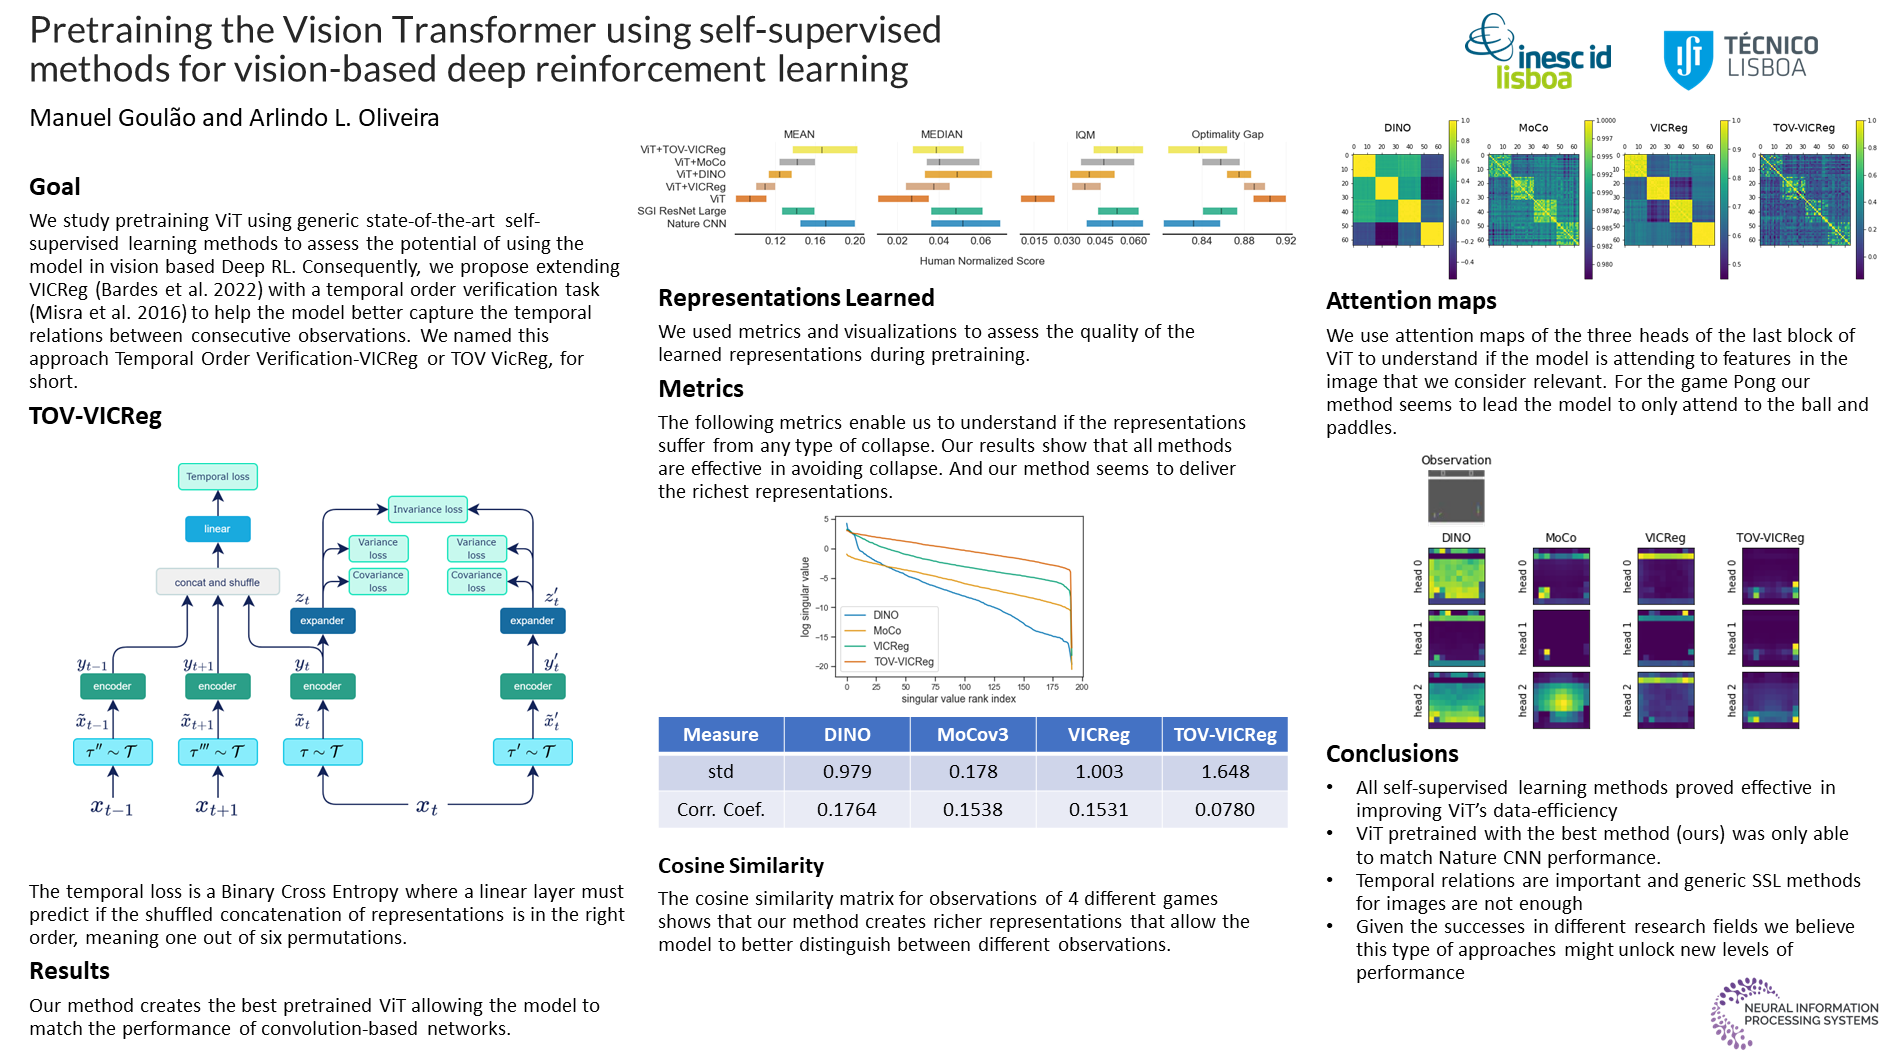
NeurIPS Pretraining the Vision Transformer using self-supervised ...

(PDF) Pretraining the Vision Transformer using self-supervised methods ...

Figure 1 from Self-Supervised Pretraining Vision Transformer With ...
Advertisement Space (300x250)

Figure 5 from Self-Supervised Pretraining Vision Transformer With ...

Figure 2 from A Simple Vision Transformer for Weakly Semi-supervised 3D ...
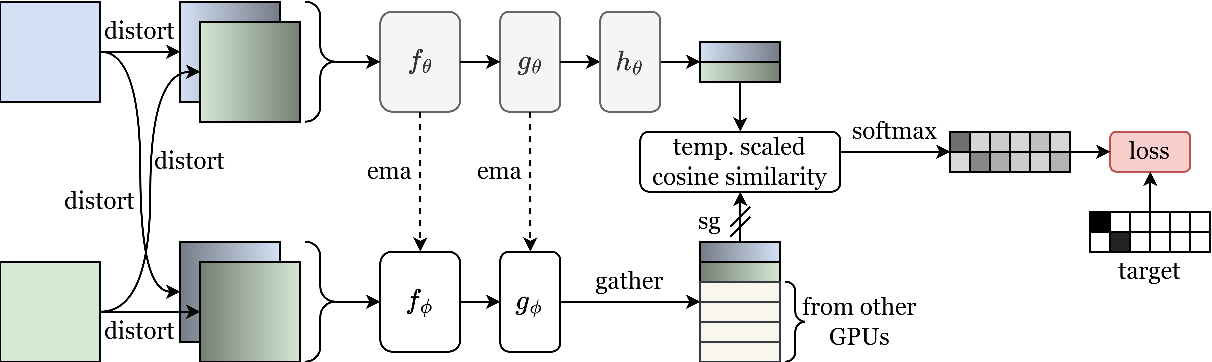
Figure 2 from A Study on Self-Supervised Pretraining for Vision ...

Figure 3 from Self-Supervised Pretraining Vision Transformer With ...

Figure 2 from Self-supervised Vision Transformers for Land-cover ...
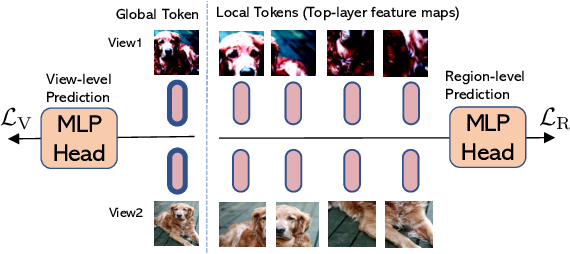
Figure 2 from Efficient Self-supervised Vision Transformers for ...

Figure 2 from Self-Supervised Pretraining via Multimodality Images With ...

Figure 2 from On Self-Supervised Learning and Prompt Tuning of Vision ...
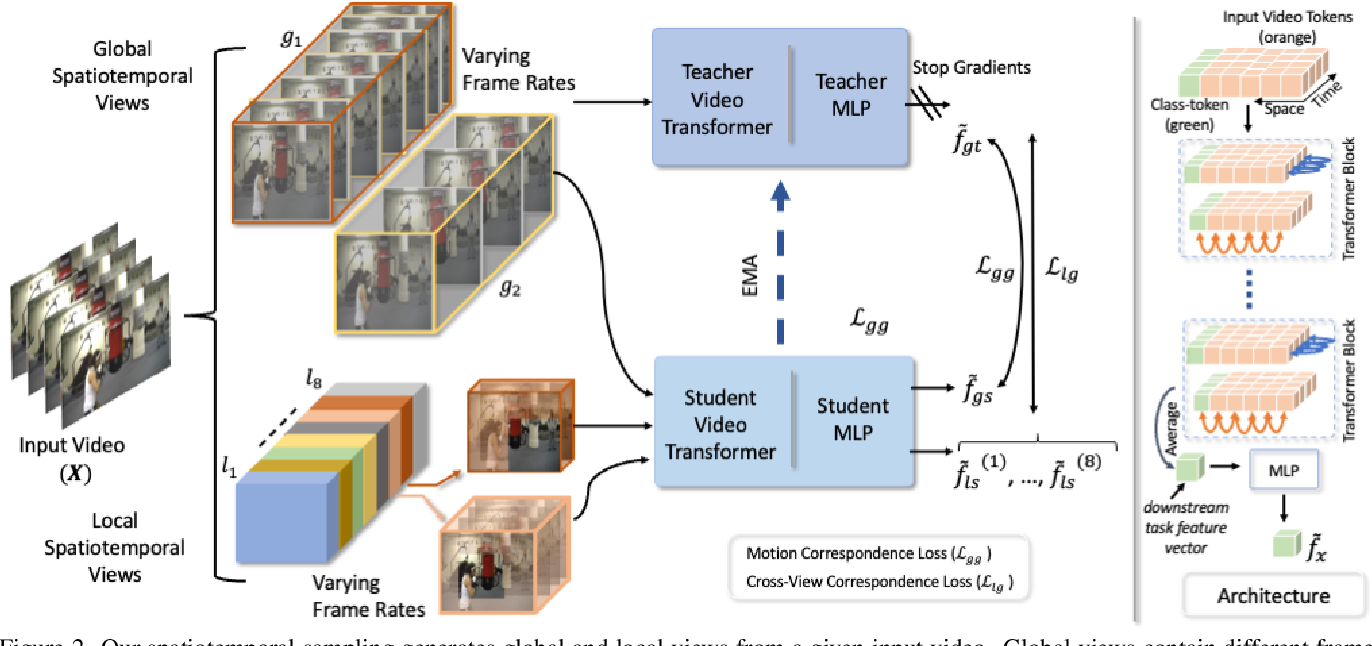
Figure 2 from Self-supervised Video Transformer | Semantic Scholar

Figure 2 from Exploring Self-Supervised Vision Transformers for Gait ...
Advertisement Space (336x280)

Figure 1 from Positional Label for Self-Supervised Vision Transformer ...

Figure 1 from SiT: Self-supervised vIsion Transformer | Semantic Scholar

Figure 1 from RePre: Improving Self-Supervised Vision Transformer with ...

Figure 1 from Using Vision Transformers in 3-D Medical Image ...

Figure 2 from What Do Self-Supervised Vision Transformers Learn ...
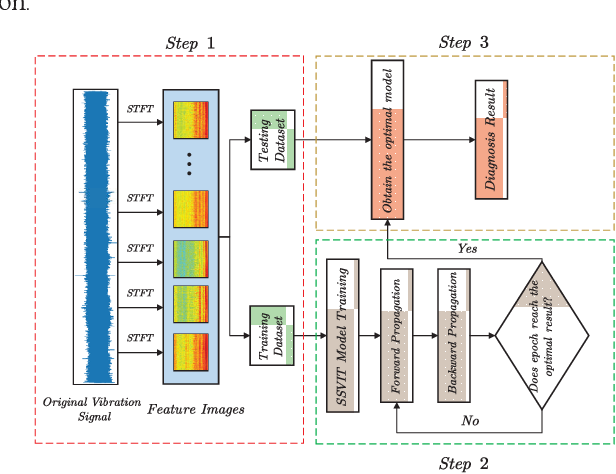
Figure 1 from Self-Supervised Vision Transformer for Intelligent Fault ...

Figure 2 from Semi-supervised Vision Transformers at Scale | Semantic ...

Figure 2 from Self-supervised Vision Transformers for 3D Pose ...

Illustration of the vision transformer (ViT) and multi self-attention ...

Figure 1 from Adapting Self-Supervised Vision Transformers by Probing ...
Advertisement Space (336x280)
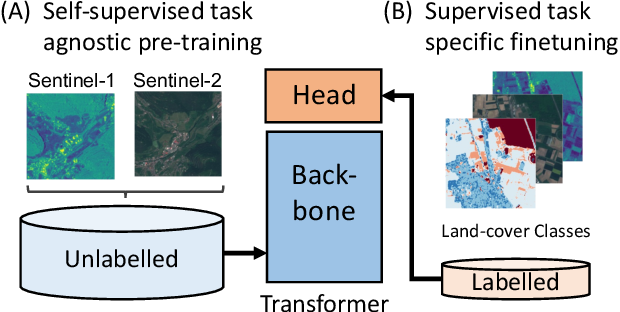
Figure 1 from Self-supervised Vision Transformers for Land-cover ...

Figure 6 from Distilling Self-Supervised Vision Transformers for Weakly ...

Figure 1 from Self-Supervised Vision Transformers Are Efficient ...
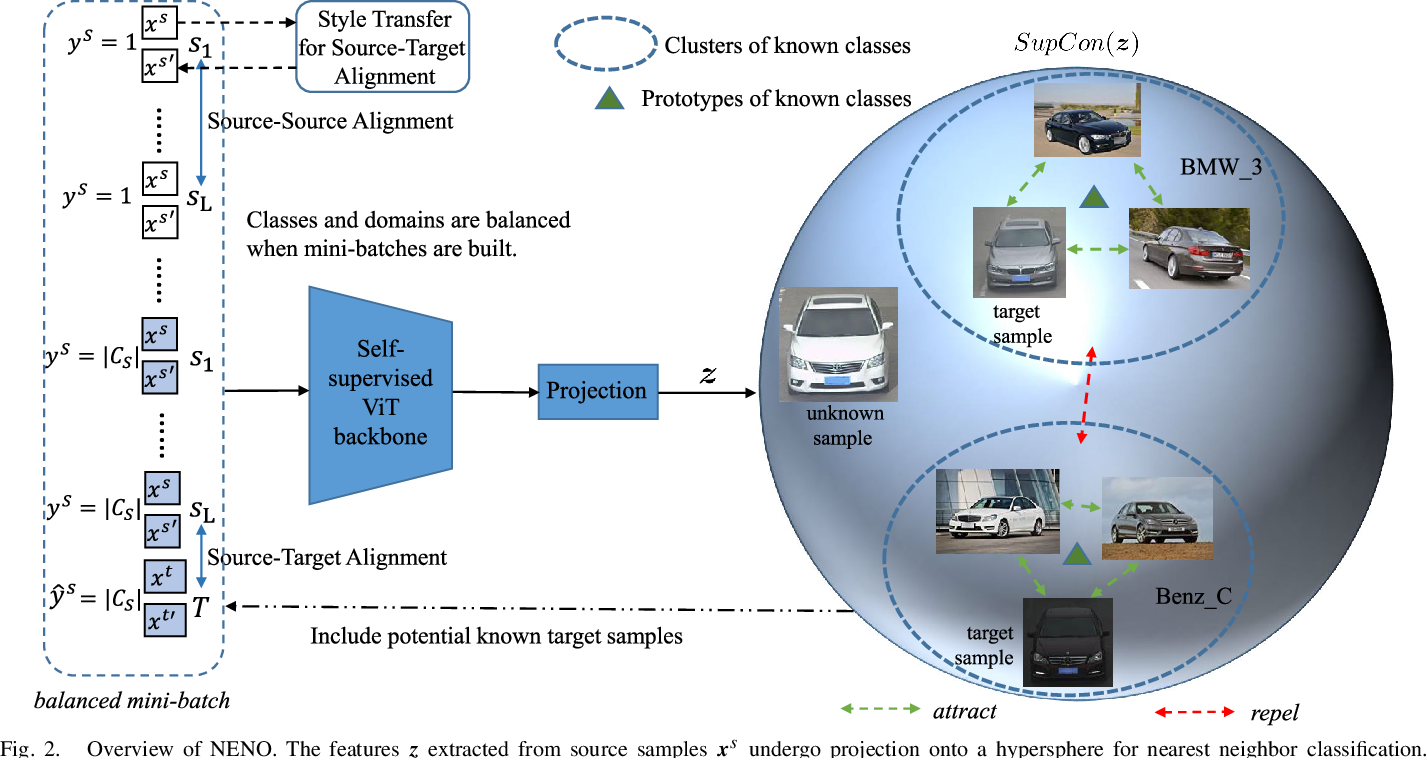
Figure 2 from Enhancing Multi-Source Open-Set Domain Adaptation Through ...

(PDF) Pattern Integration and Enhancement Vision Transformer for Self ...
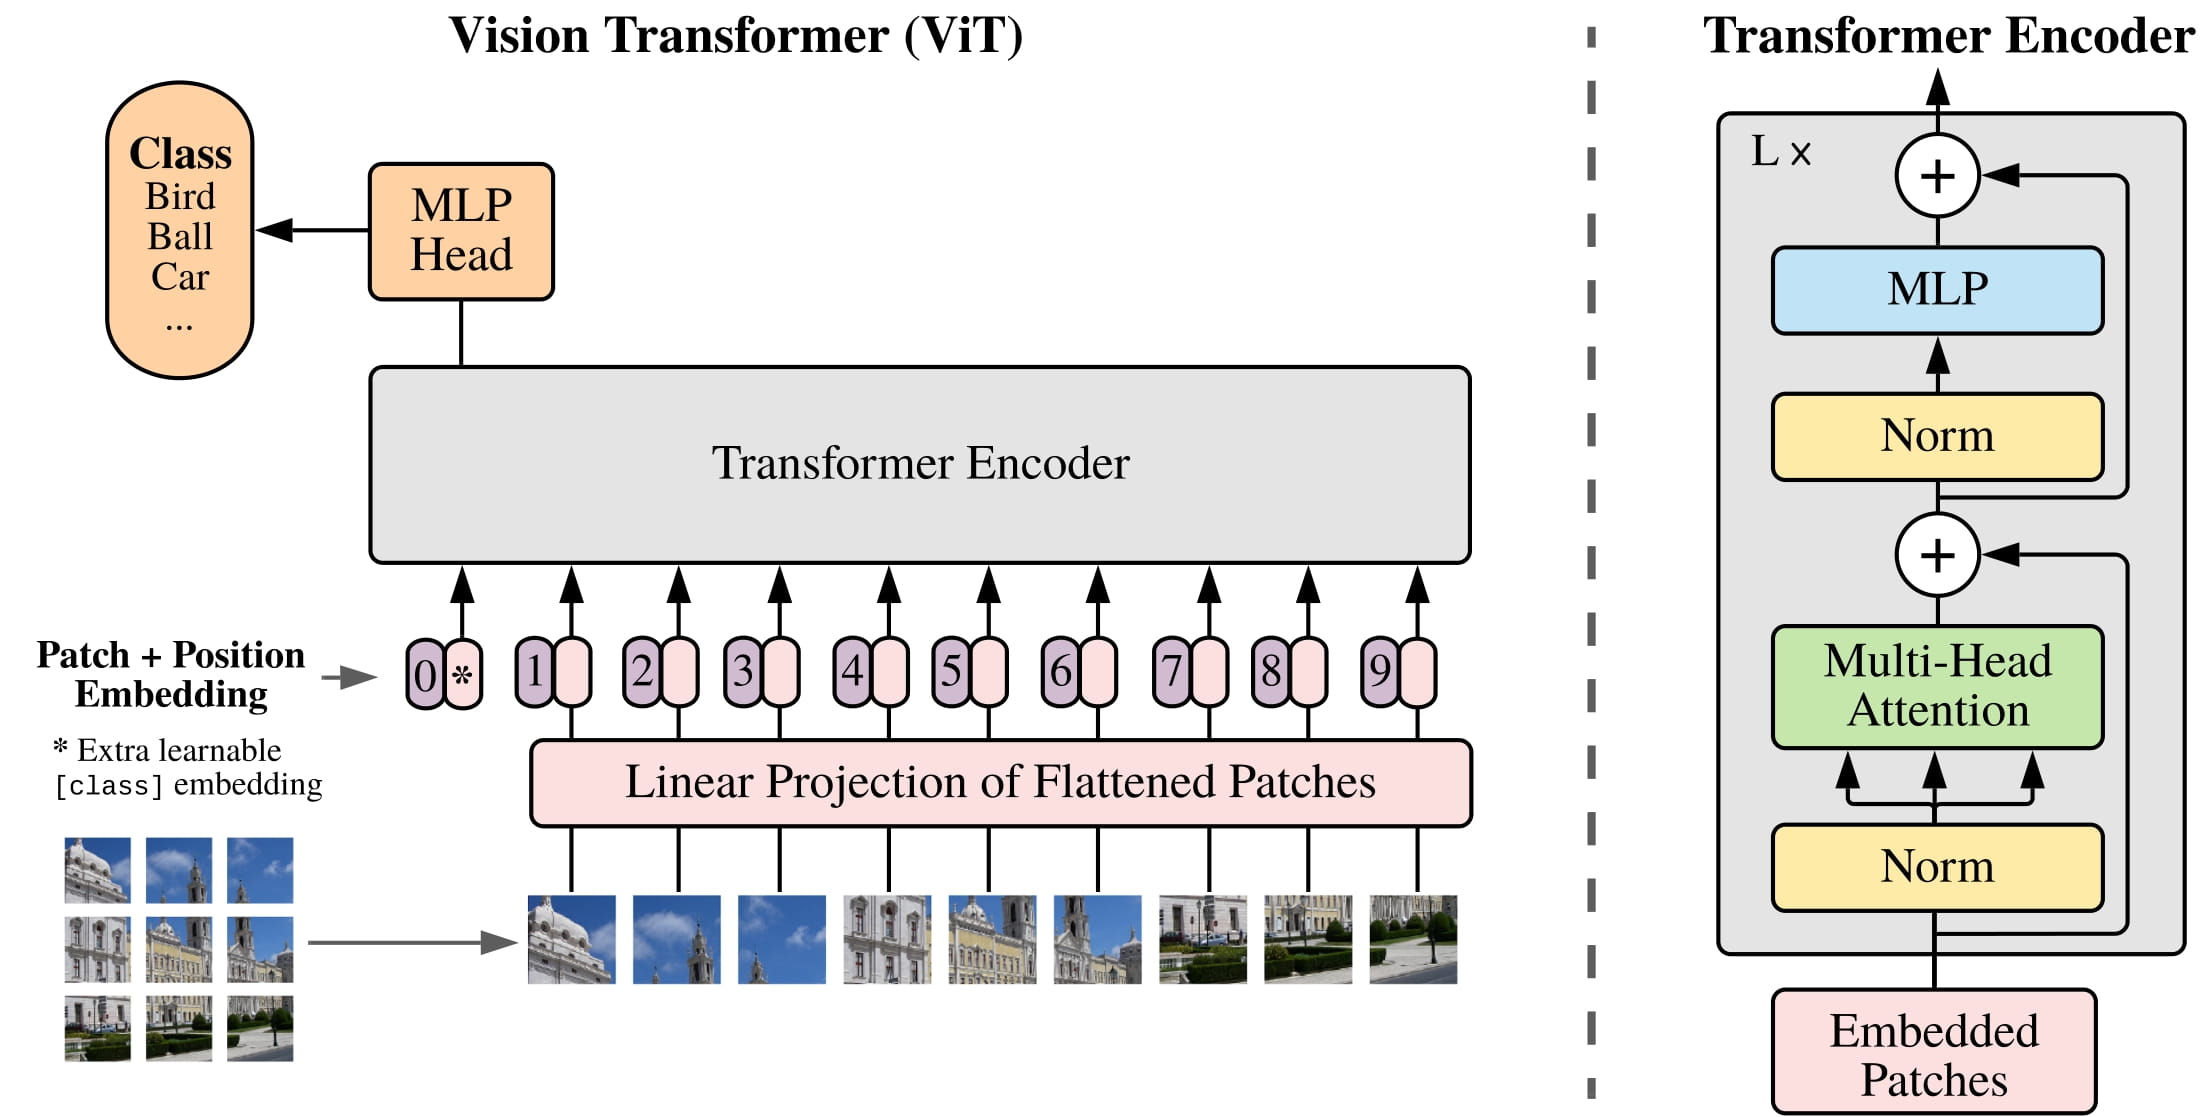
Vision Transformer (ViT)