
Figure 2 From Self Augmented Multi Modal Feature Embedding Semantic

Figure 2 from Self-Augmented Multi-Modal Feature Embedding | Semantic ...
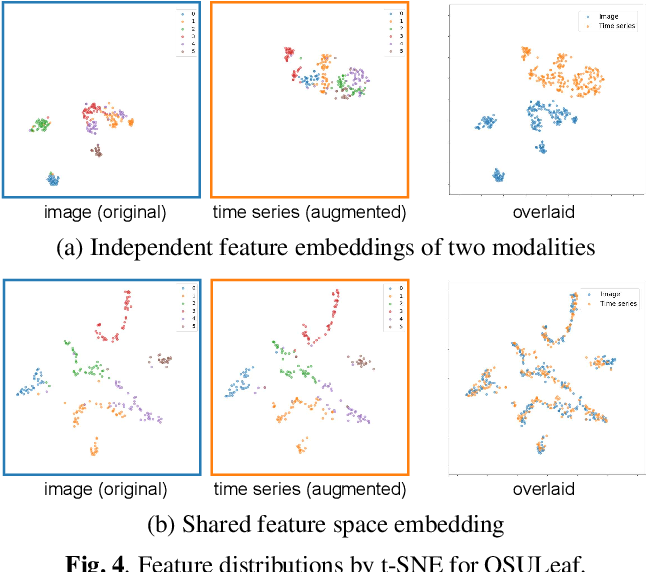
Figure 4 from Self-Augmented Multi-Modal Feature Embedding | Semantic ...

Figure 2 from Multi-modal Feature Fusion 3D Object Detection | Semantic ...
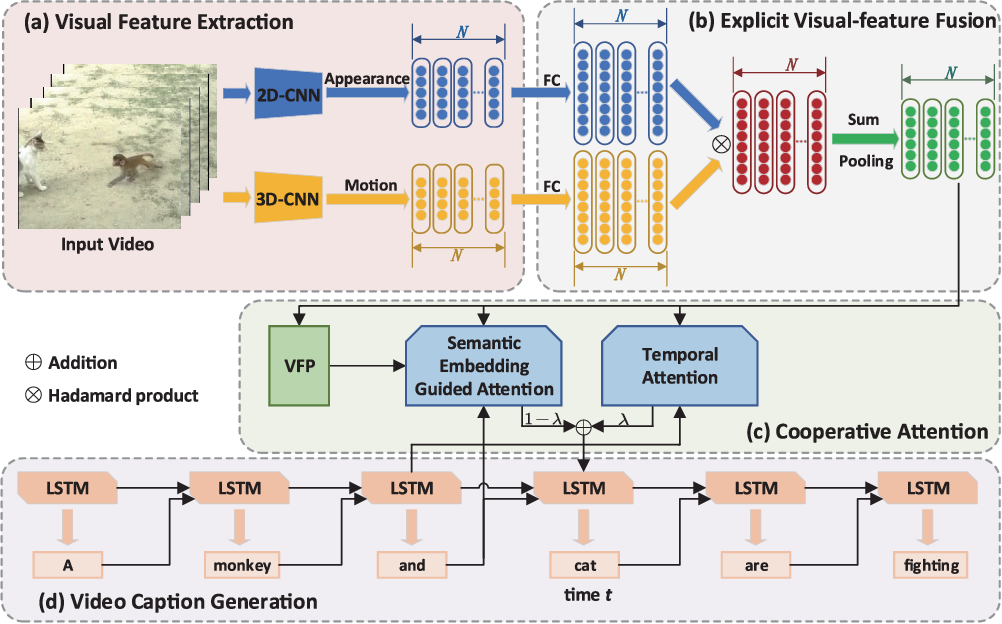
Figure 2 from Semantic Embedding Guided Attention with Explicit Visual ...
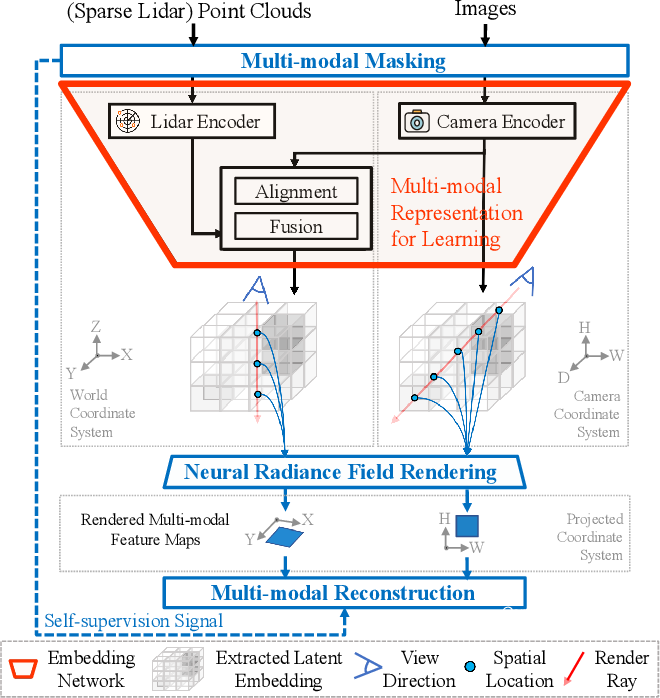
Figure 2 from Unified Self-supervised Representation Learning for Multi ...
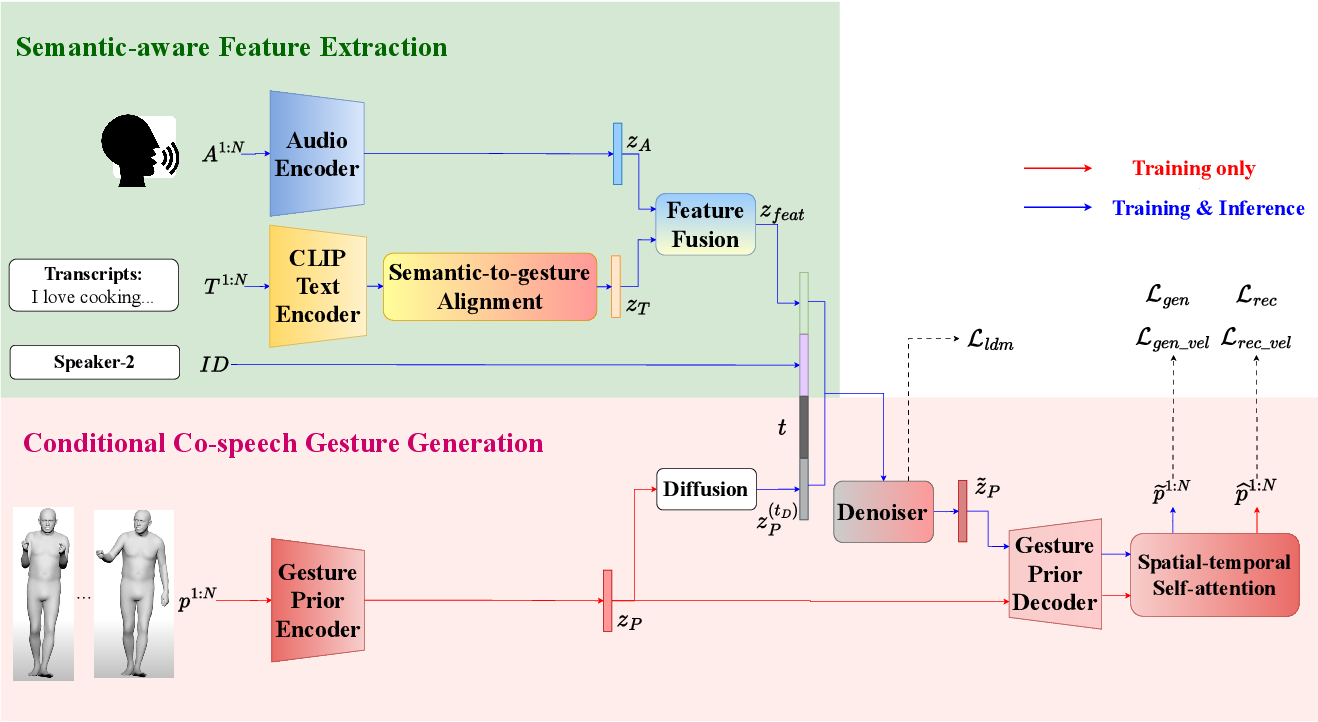
Figure 2 from SemGest: A Multimodal Feature Space Alignment and Fusion ...
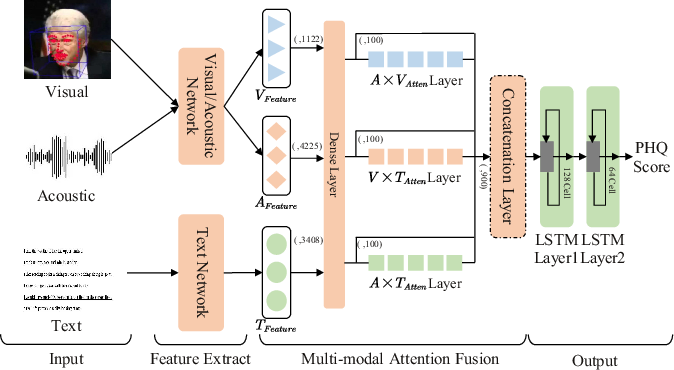
Figure 2 from A Multi-modal Feature Layer Fusion Model for Assessment ...
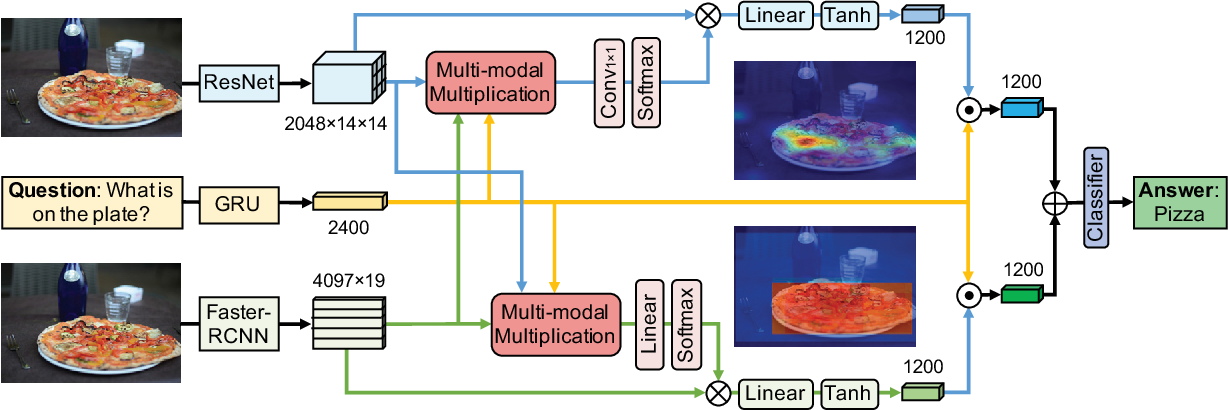
Figure 2 from Co-attending Free-form Regions and Detections with Multi ...
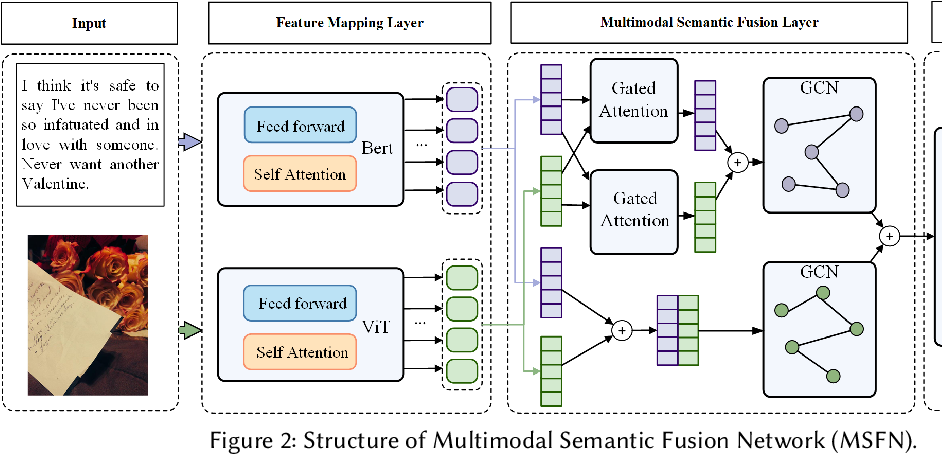
Figure 2 from A Multimodal Semantic Fusion Network with Cross-Modal ...
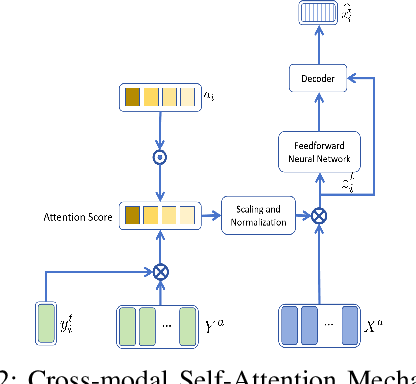
Figure 2 from Hashing-Based Multi-Modal Semantic Communication ...
Advertisement Space (300x250)

Figure 2 from Self-Supervised Multimodal Learning: A Survey | Semantic ...
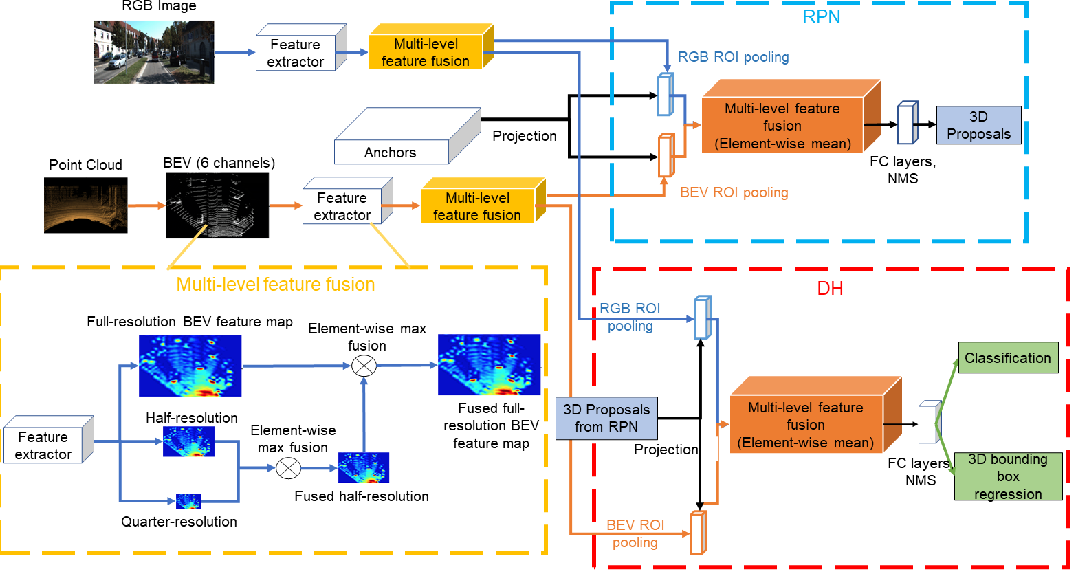
Figure 2 from Multi-level and multi-modal feature fusion for accurate ...

Figure 2 from Prompting Multi-Modal Image Segmentation with Semantic ...

Figure 2 from Prompting Multi-Modal Image Segmentation with Semantic ...

Figure 2 from A multi-modal feature fusion method for pilot expression ...
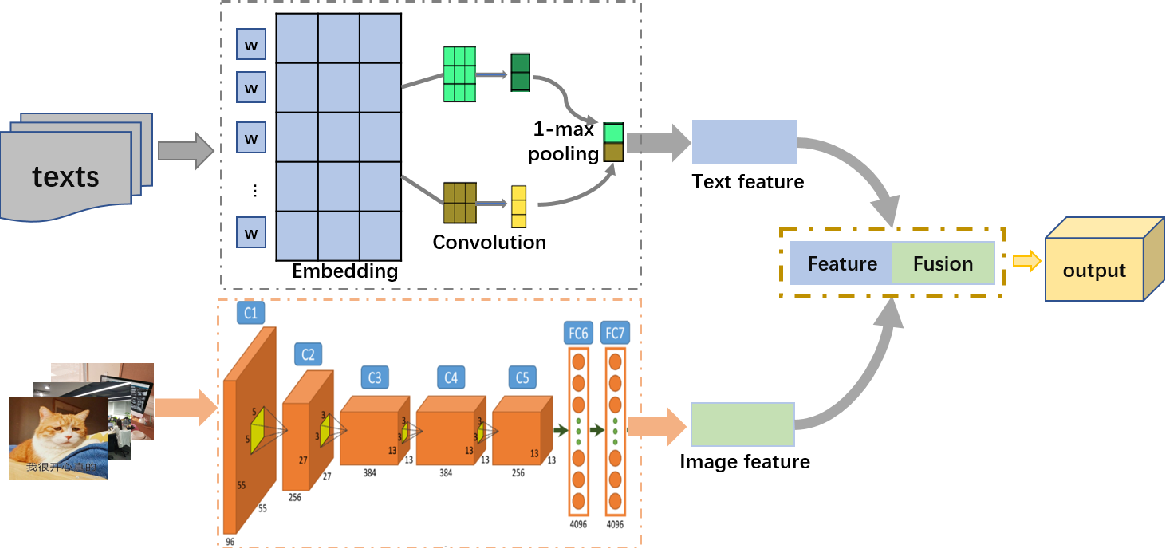
Figure 2 from A Deep Multi-Modal Fusion Approach for Semantic Place ...
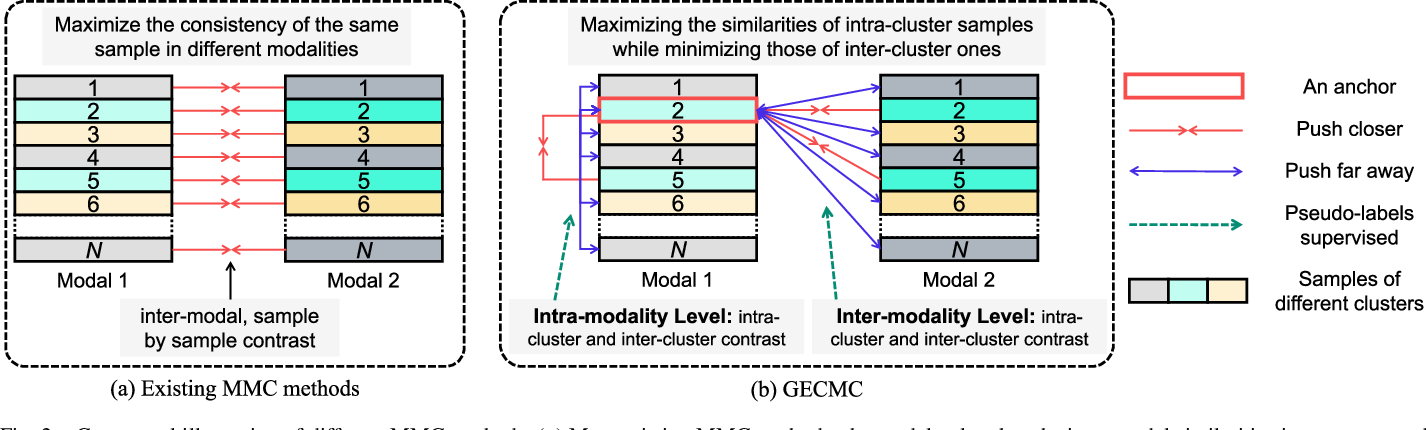
Figure 2 from Graph Embedding Contrastive Multi-Modal Representation ...
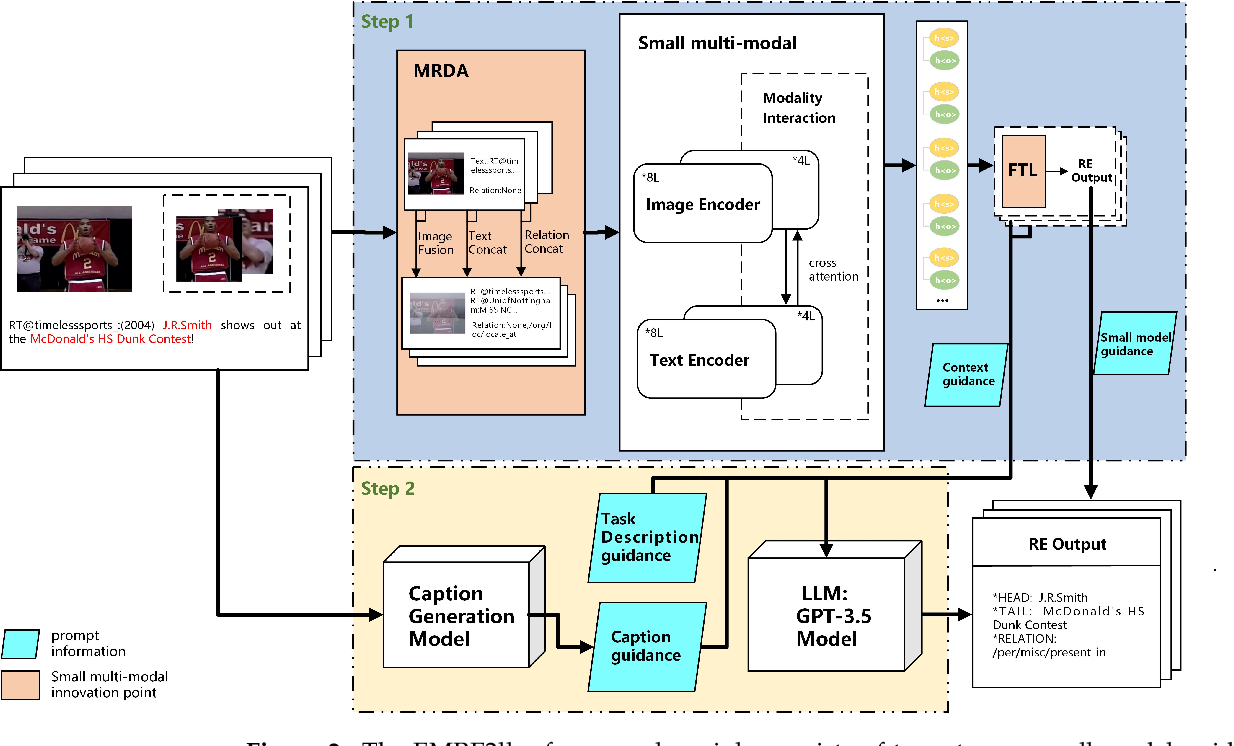
Figure 2 from Using Augmented Small Multimodal Models to Guide Large ...
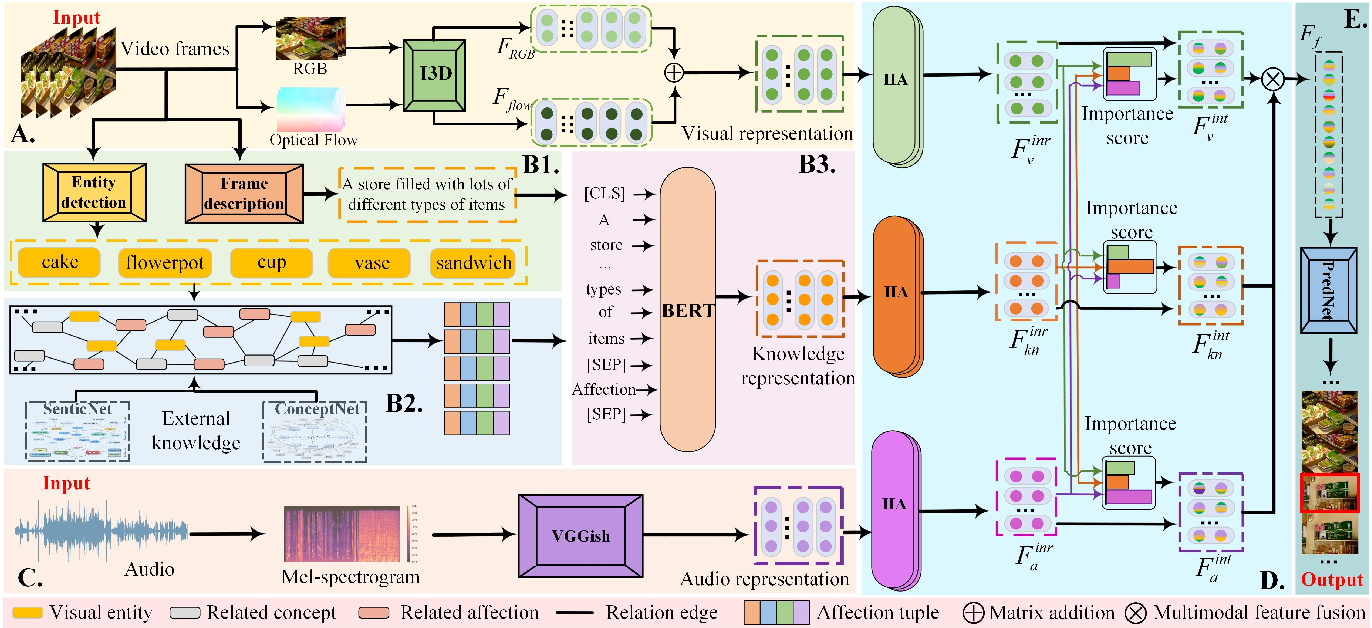
Figure 2 from A Knowledge Augmented and Multimodal-Based Framework for ...

Table 1 from Self-Augmented Multi-Modal Feature Embedding | Semantic ...
Advertisement Space (336x280)
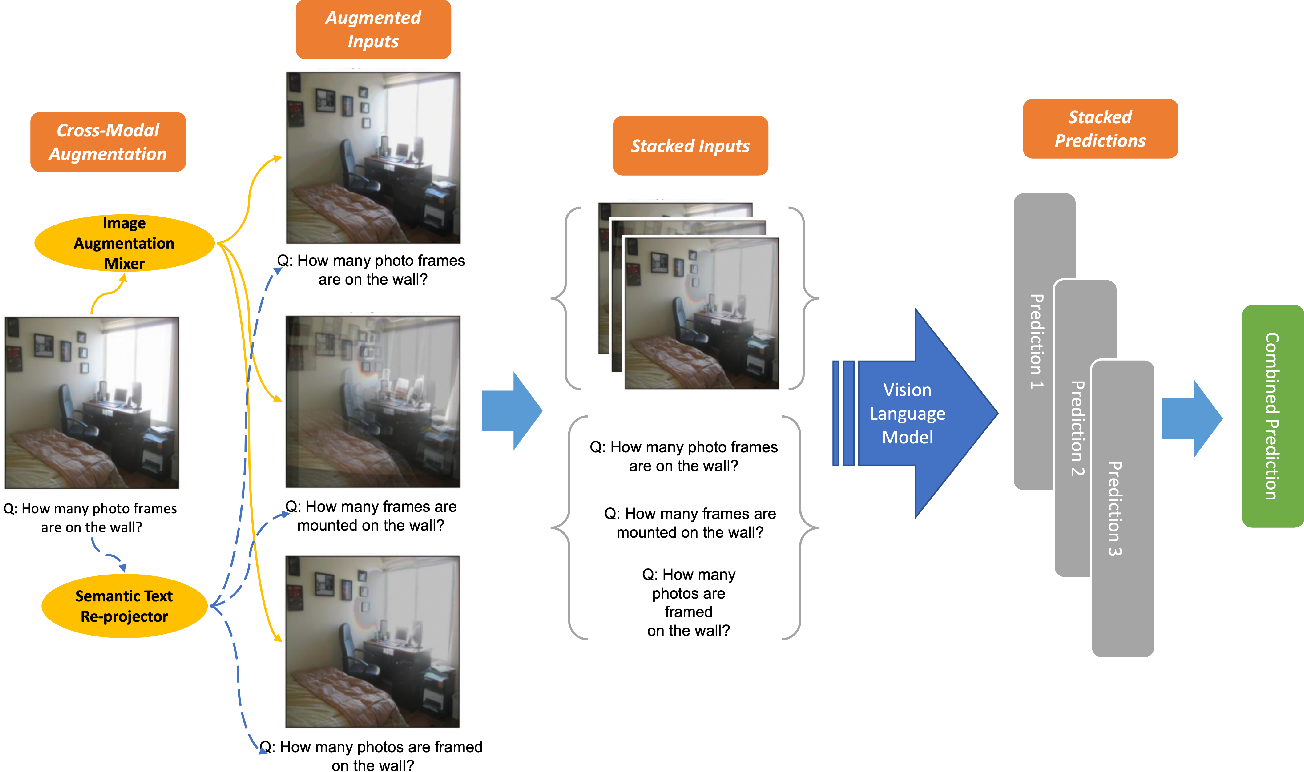
Figure 2 from Semantic multi-modal reprojection for robust visual ...
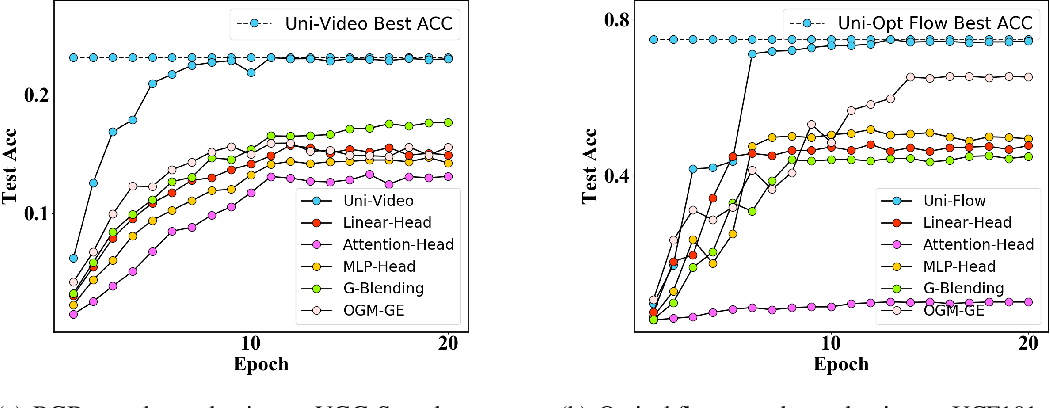
Figure 2 from On Uni-Modal Feature Learning in Supervised Multi-Modal ...
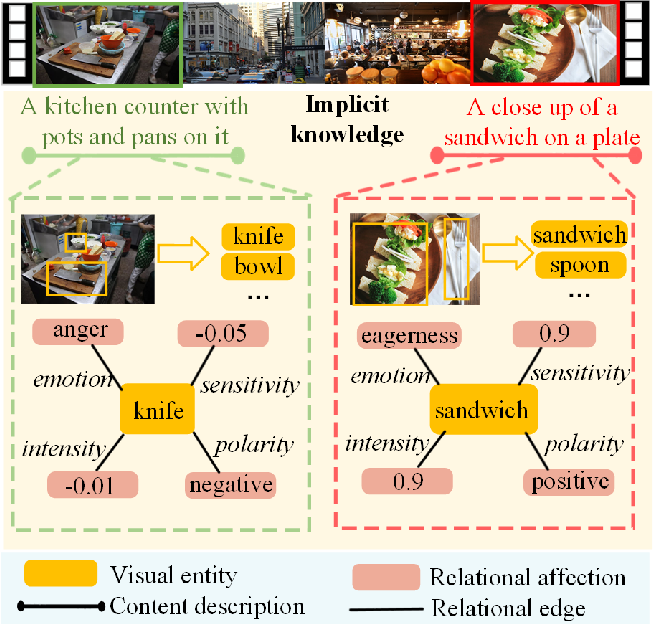
Figure 2 from A Knowledge Augmented and Multimodal-Based Framework for ...

Figure 2 from MARCER: Multimodal Augmented Reality for Composing and ...

Figure 1 from Multi-modal Feature Fusion 3D Object Detection | Semantic ...
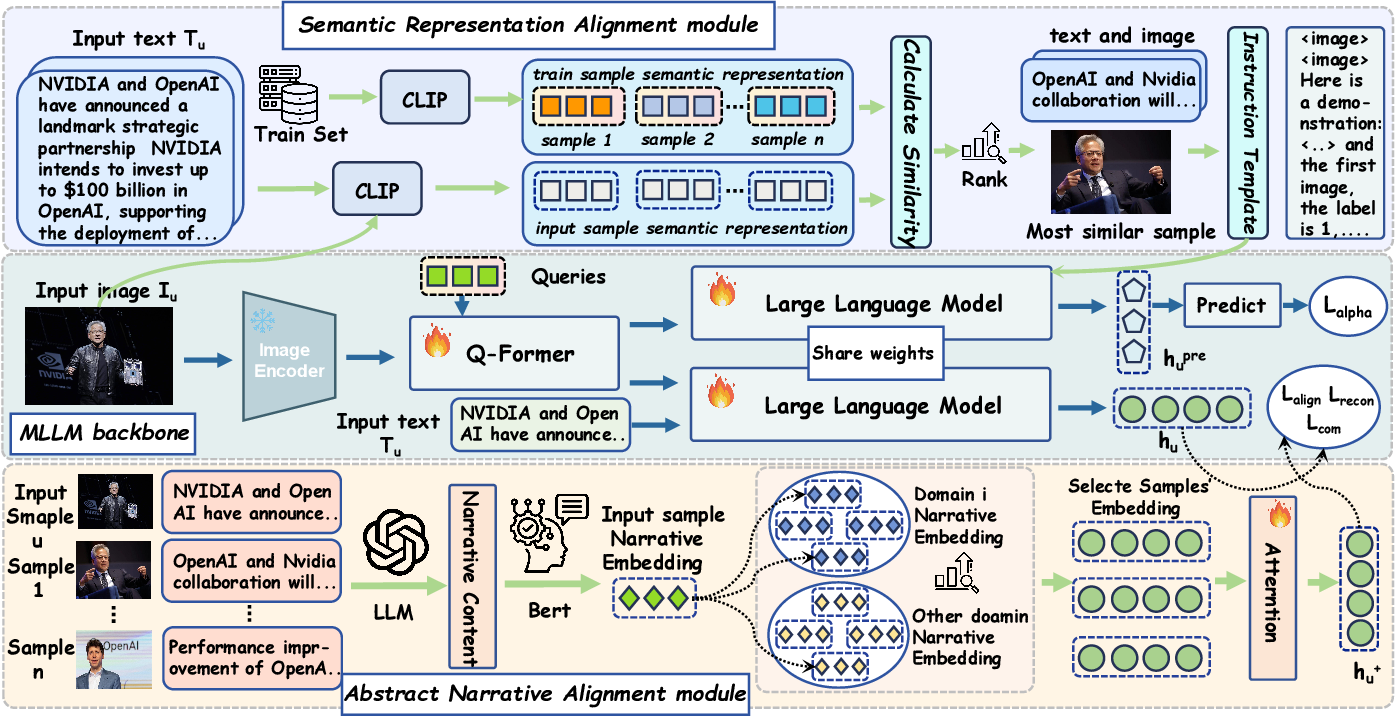
Figure 2 from Retrieval-Augmented Multimodal Model for Fake News ...
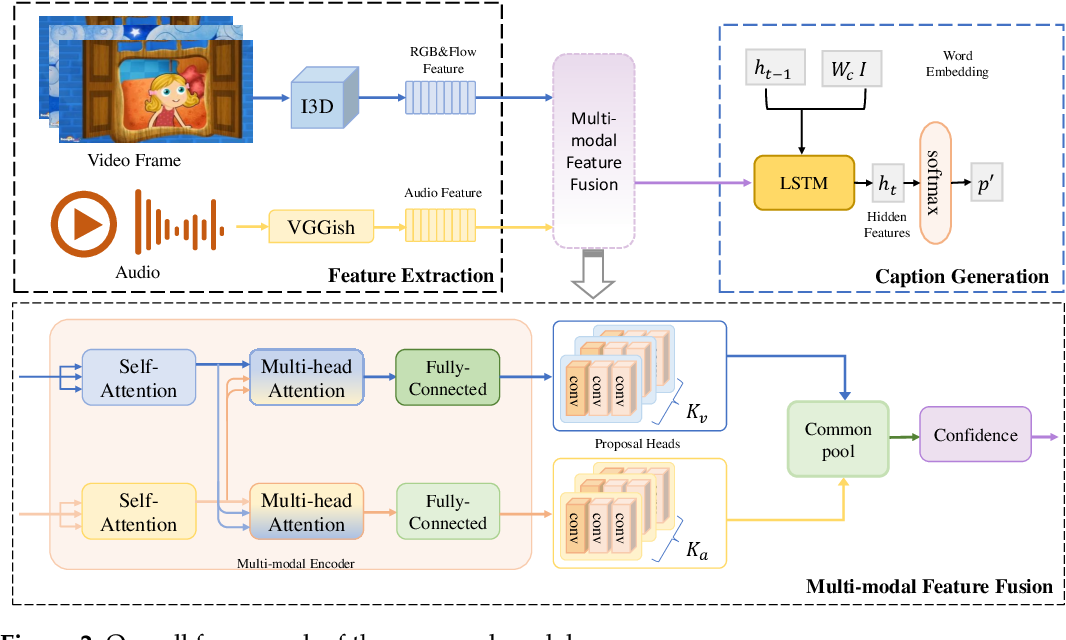
Figure 2 from Fusion of Multi-Modal Features to Enhance Dense Video ...
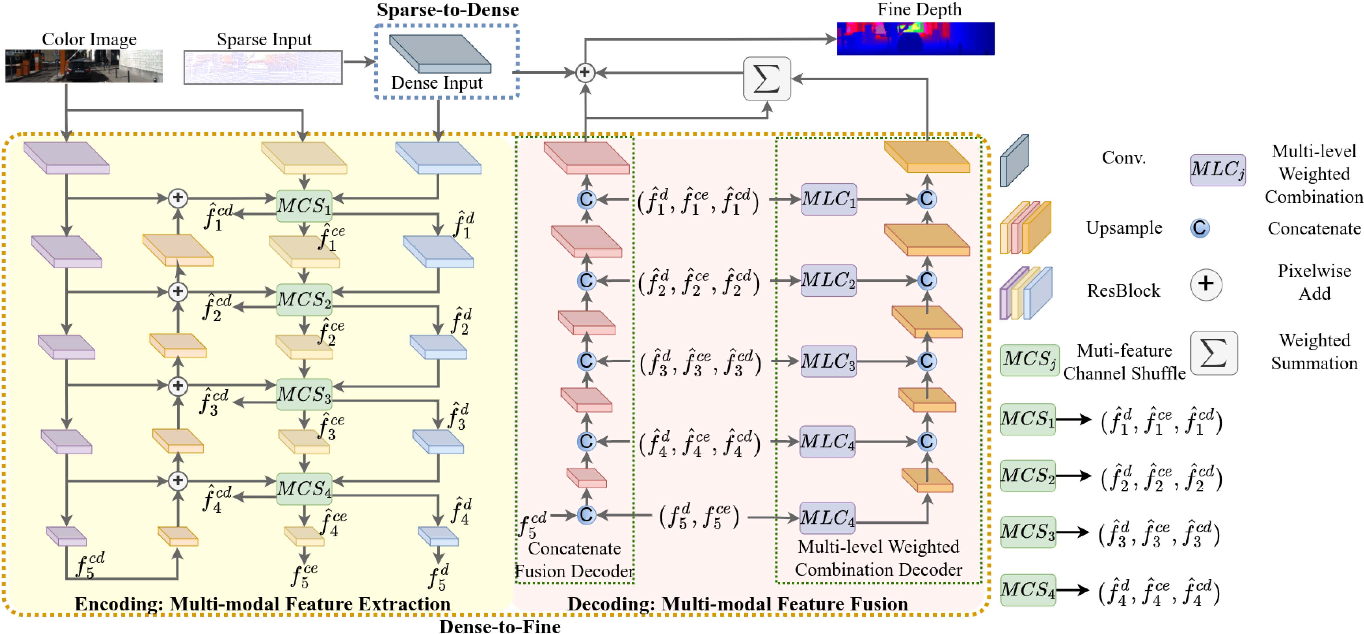
Figure 2 from MFF-Net: Towards Efficient Monocular Depth Completion ...
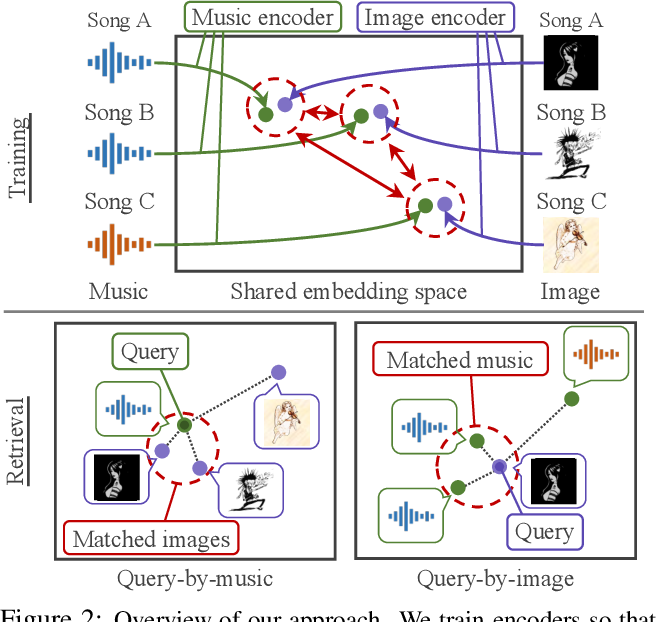
Figure 2 from Content-Based Music-Image Retrieval Using Self- and Cross ...

Figure 2 from Unified Multi-modal Unsupervised Representation Learning ...
Advertisement Space (336x280)
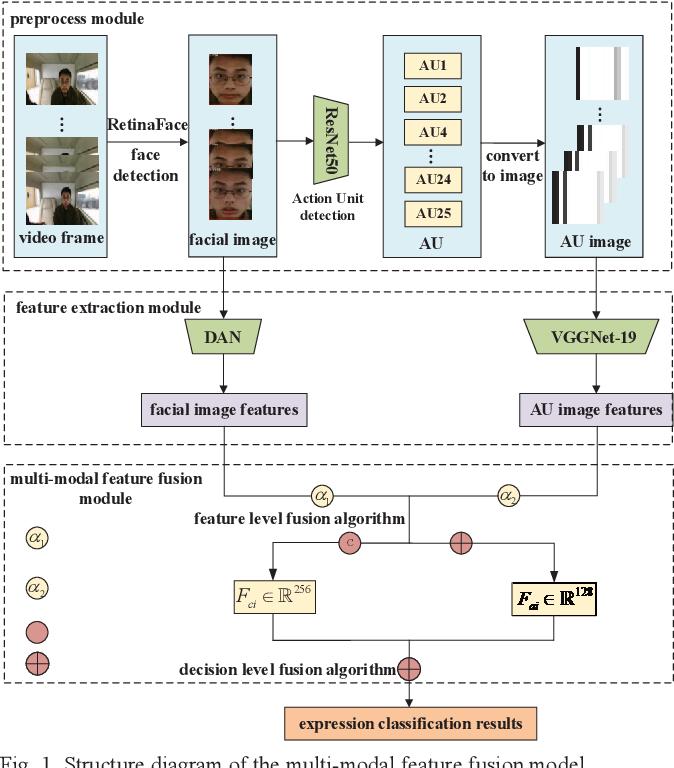
Figure 1 from A multi-modal feature fusion method for pilot expression ...
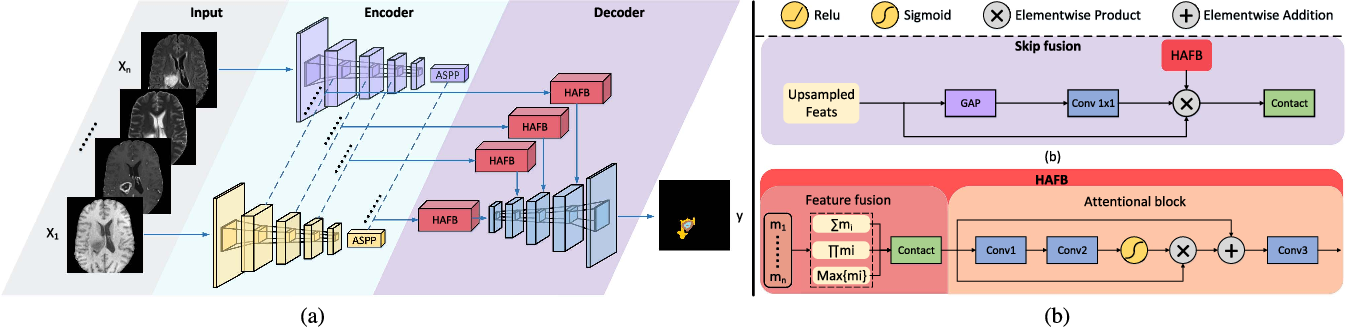
Figure 2 from Self-Supervised Multi-Modal Hybrid Fusion Network for ...
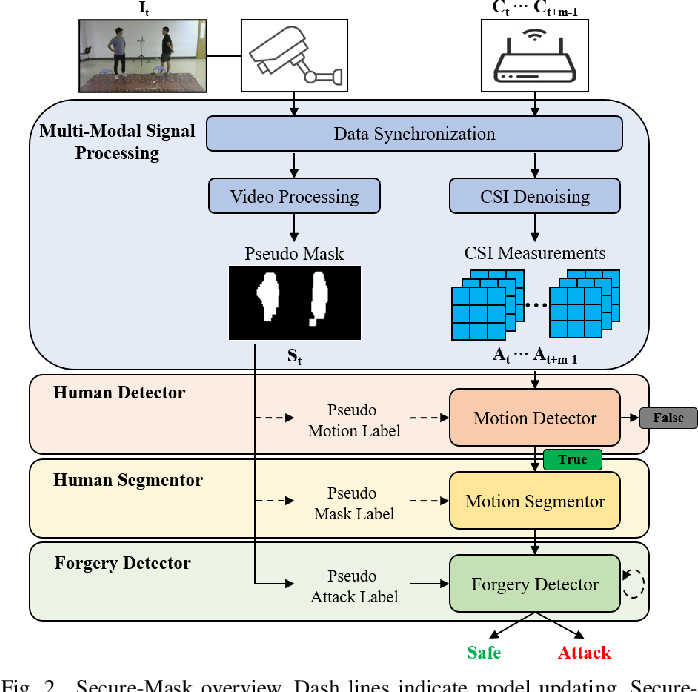
Figure 2 from Self-supervised Multi-Modal Video Forgery Attack ...

Figure 2 from Self-Attentive Feature-Level Fusion for Multimodal ...
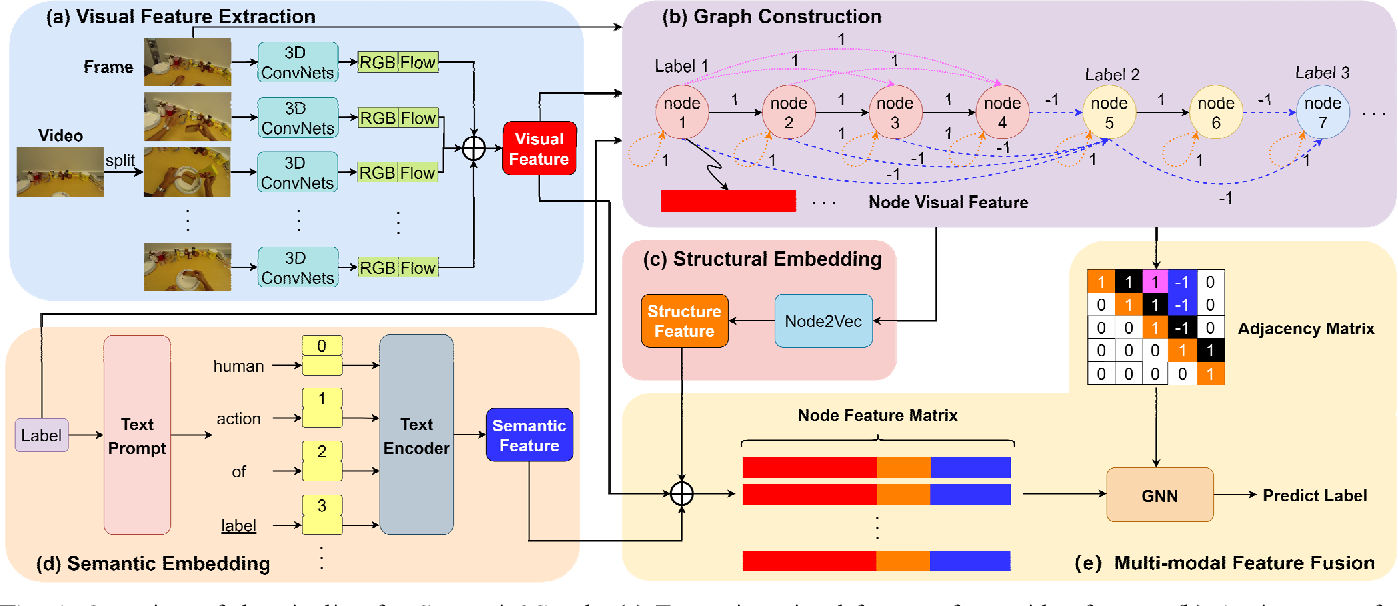
Figure 1 from Semantic2Graph: Graph-based Multi-modal Feature for ...
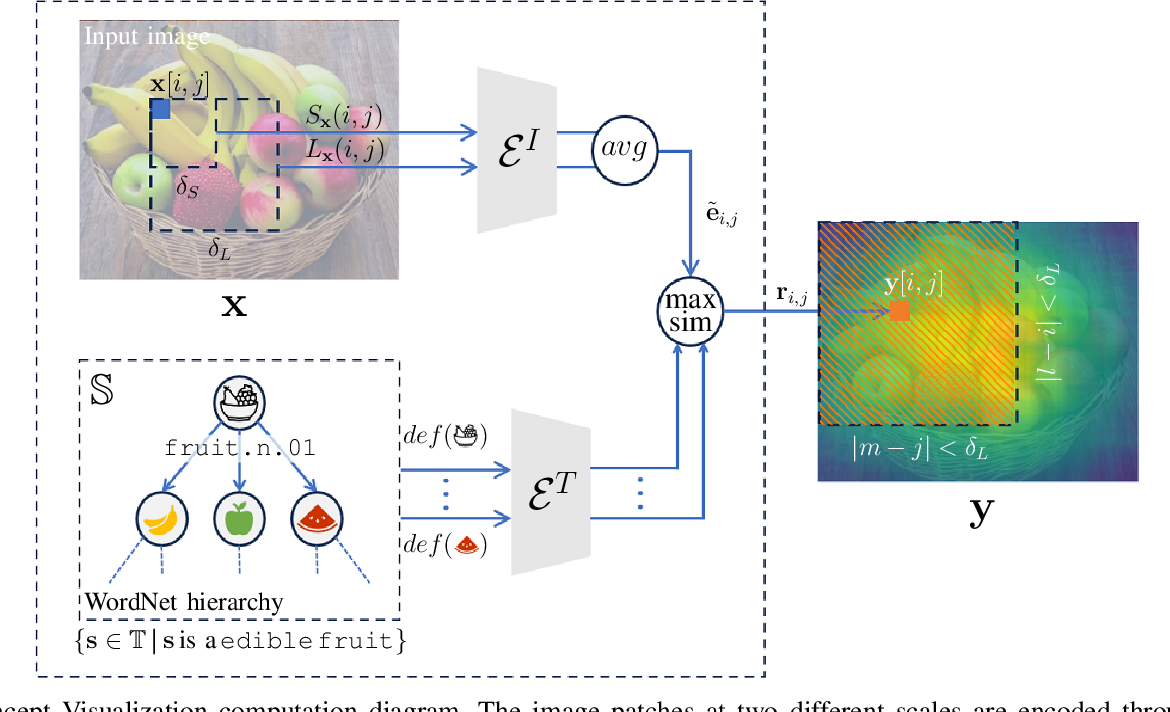
Figure 2 from Concept Visualization: Explaining the CLIP Multi-modal ...