
Figure 2 From Text Image Scene Graph Fusion For Multimodal Named Entity

Figure 2 from Text-Image Scene Graph Fusion for Multimodal Named Entity ...

Figure 1 from Text-Image Scene Graph Fusion for Multimodal Named Entity ...

Figure 2 from Multi-modal Graph Fusion for Named Entity Recognition ...

Figure 2 from Scene Graph based Fusion Network for Image-Text Retrieval ...

Figure 2 from Dynamic Graph Construction Framework for Multimodal Named ...

Figure 2 from Scene Graph based Fusion Network for Image-Text Retrieval ...

Figure 2 from Image and Encoded Text Fusion for Multi-Modal ...

Figure 2 from Graph Fusion Network-Based Multimodal Learning for ...
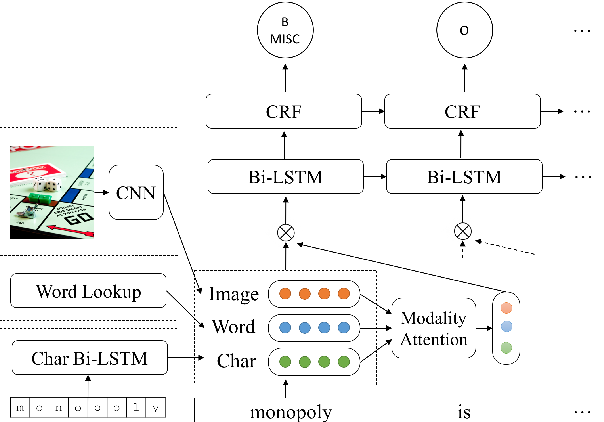
Figure 2 from Multimodal Named Entity Recognition for Short Social ...

Multimodal heterogeneous graph entity-level fusion for named entity ...
Advertisement Space (300x250)

Figure 2 from Improving Multimodal Named Entity Recognition via Entity ...

Figure 2 from Deep Graph Fusion Based Multimodal Evoked Expressions ...

Figure 2 from GraphMFT: A Graph Network based Multimodal Fusion ...

Figure 2 from Cross-Modality Gated Attention Fusion for Multimodal ...

Figure 2 from Deep Graph Fusion Based Multimodal Evoked Expressions ...
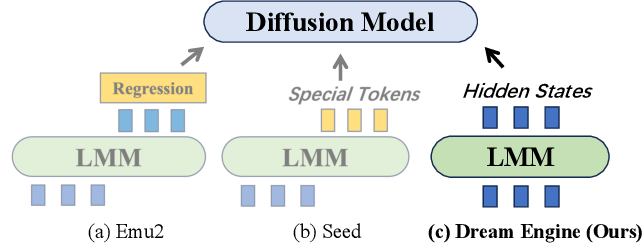
Figure 2 from Multimodal Representation Alignment for Image Generation ...

Multimodal heterogeneous graph entity-level fusion for named entity ...

Figure 2 from Chain-of-Thought Prompt Distillation for Multimodal Named ...

Multimodal heterogeneous graph entity-level fusion for named entity ...

Figure 1 from Attentive Multimodal Fusion for Optical and Scene Flow ...
Advertisement Space (336x280)

Figure 2 from An Effective Span-based Multimodal Named Entity ...

Figure 2 from Named Entity Recognition Model Based on Feature Fusion ...

Figure 2 from Deep Multimodal Fusion Model for Building Structural Type ...

Figure 2 from A Token-wise Graph-based Framework for Multimodal Named ...

Figure 2 from GraphMFT: A Graph Network based Multimodal Fusion ...
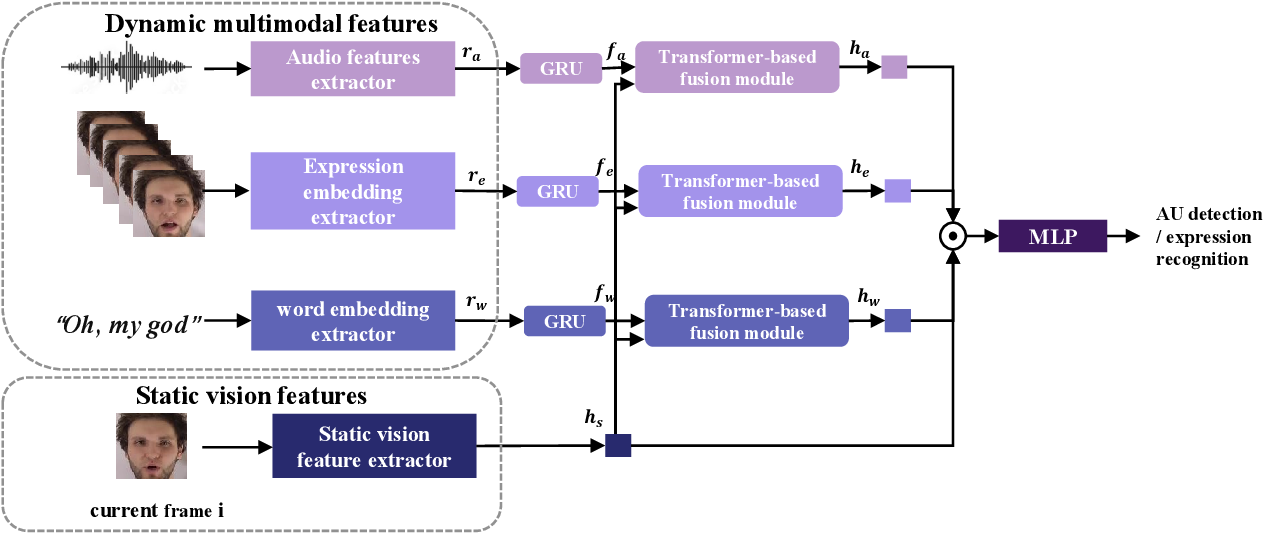
Figure 2 from Transformer-based Multimodal Information Fusion for ...

Figure 2 from Entity-level Interaction via Heterogeneous Graph for ...
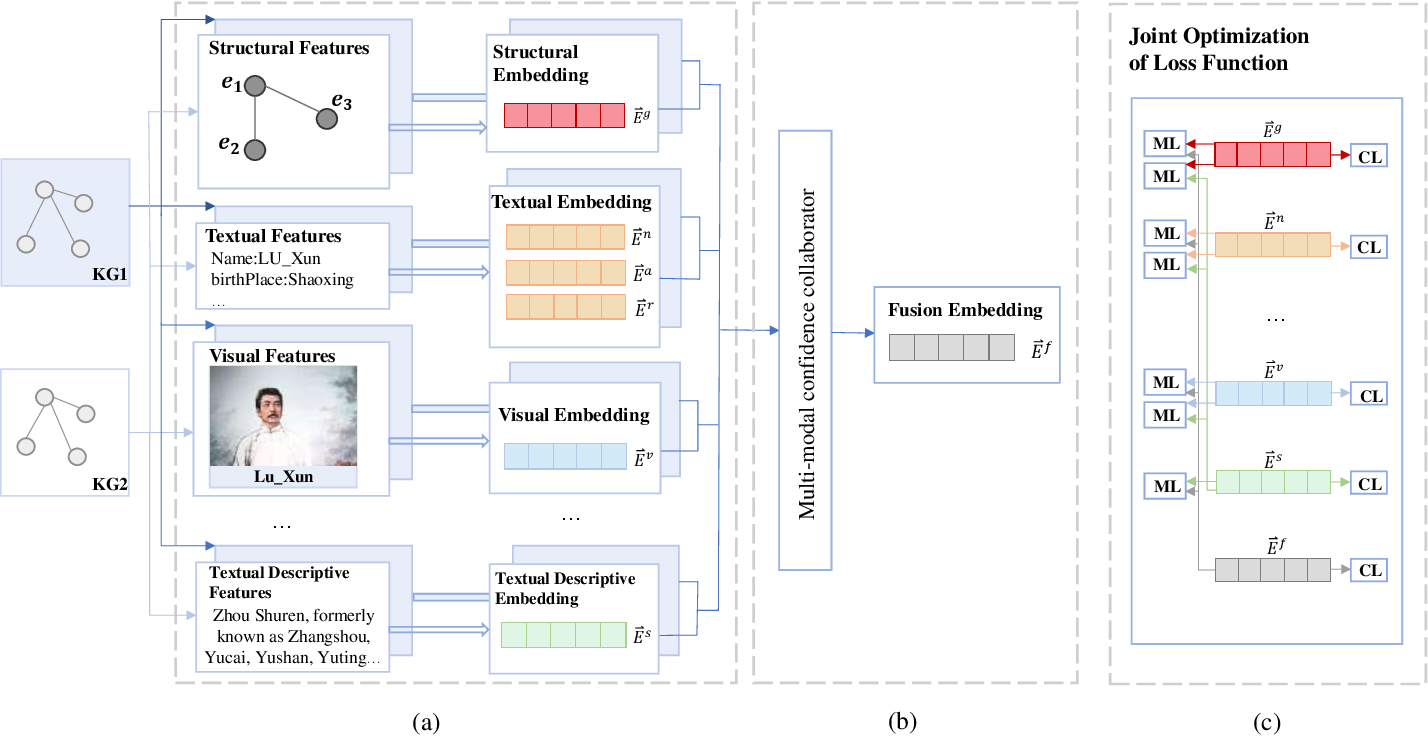
Figure 2 from Fusion-Optimized Multimodal Entity Alignment with Textual ...
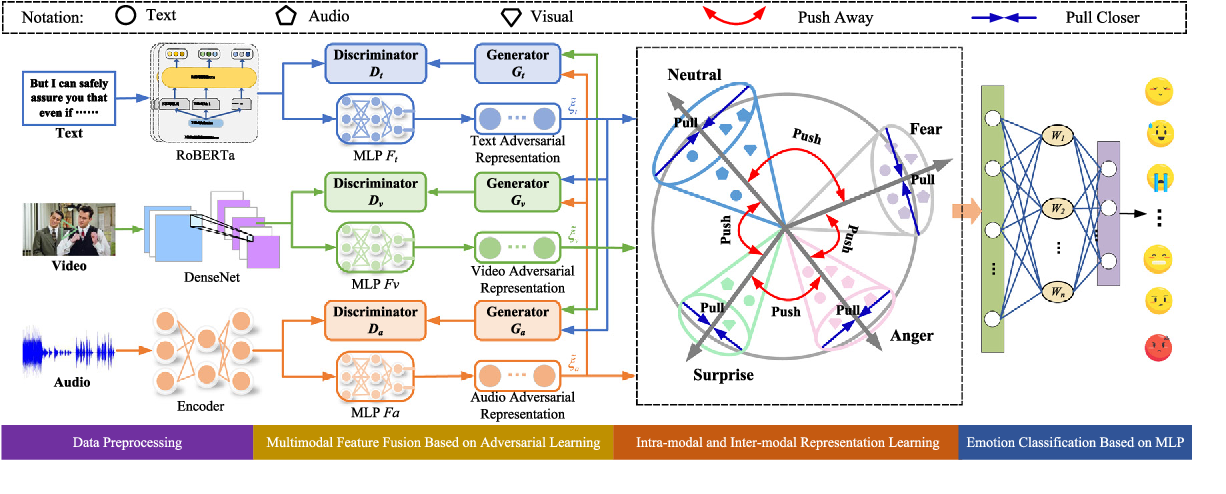
Figure 2 from Adversarial alignment and graph fusion via information ...

Figure 1 from Fusion with Hierarchical Graphs for Multimodal Emotion ...
Advertisement Space (336x280)

Figure 1 from Leveraging Graph Neural Networks and Multimodal Fusion ...

A Graph Interaction Framework on Relevance for Multimodal Named Entity ...

Figure 4 from A Token-wise Graph-based Framework for Multimodal Named ...

Figure 2 from Joyful: Joint Modality Fusion and Graph Contrastive ...

Figure 2 from Video scene segmentation through an early fusion ...
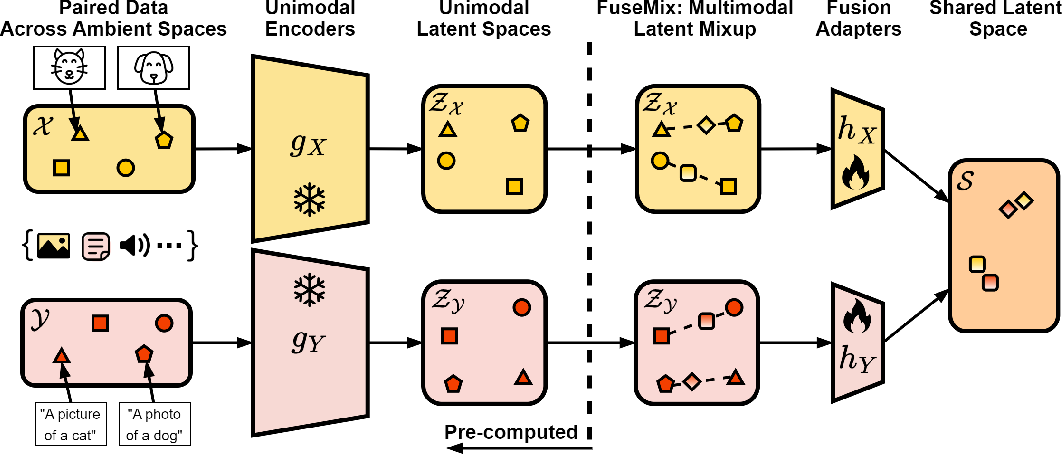
Figure 2 from Data-Efficient Multimodal Fusion on a Single GPU ...