
Figure 2 From Training Free Multimodal Guidance For Video To Audio
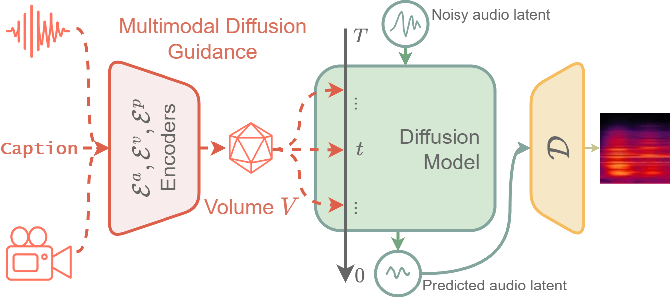
Figure 2 from Training-Free Multimodal Guidance for Video to Audio ...

Table 2 from Training-Free Multimodal Guidance for Video to Audio ...
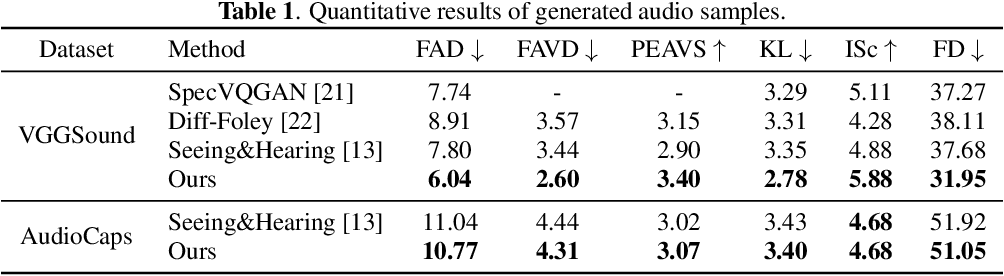
Table 1 from Training-Free Multimodal Guidance for Video to Audio ...

Figure 2 from Tell and Show: A Multimodal Guidance Method for ...

Figure 2 from Localizing Moments in Long Video Via Multimodal Guidance ...
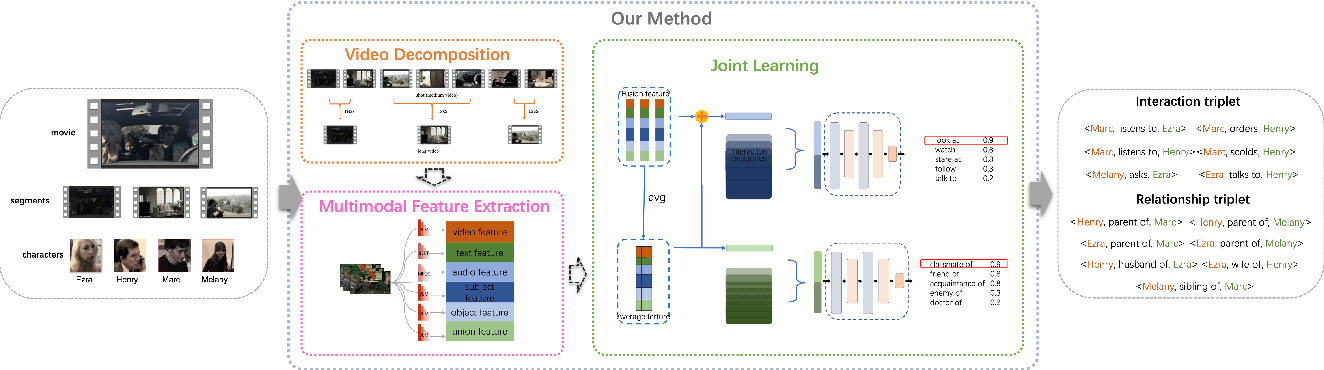
Figure 2 from Multimodal Analysis for Deep Video Understanding with ...

Figure 2 from End-to-End Multimodal Representation Learning for Video ...

[논문 리뷰] Training-Free Multimodal Guidance for Video to Audio Generation
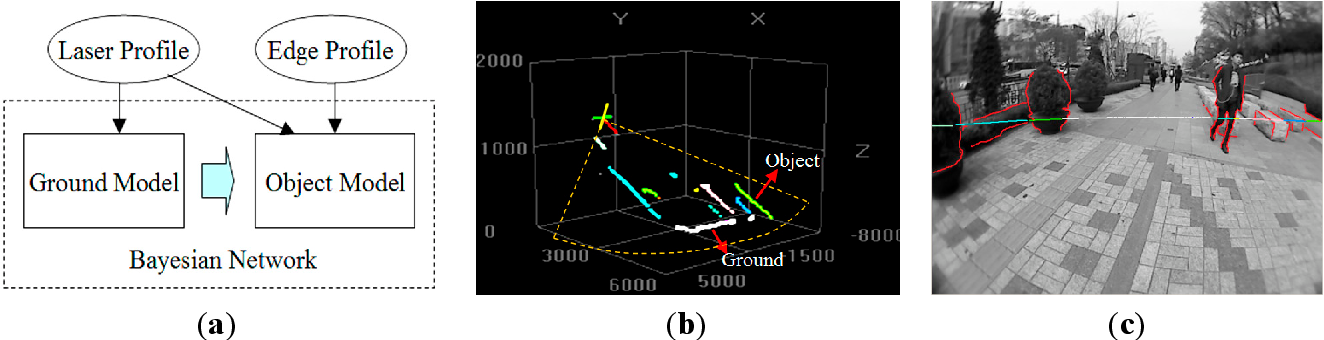
Figure 2 from A Context-Aware-Based Audio Guidance System for Blind ...

Figure 2 from Multimodal Analysis for Deep Video Understanding with ...
Advertisement Space (300x250)
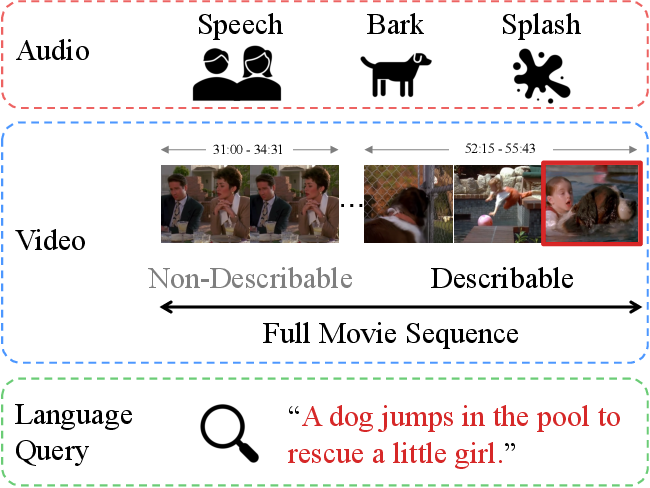
Figure 1 from Localizing Moments in Long Video Via Multimodal Guidance ...
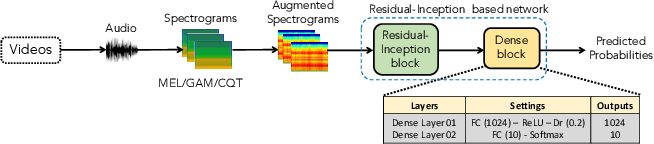
Figure 2 from Deep Learning Based Multimodal with Two-phase Training ...

Figure 3 from Localizing Moments in Long Video Via Multimodal Guidance ...
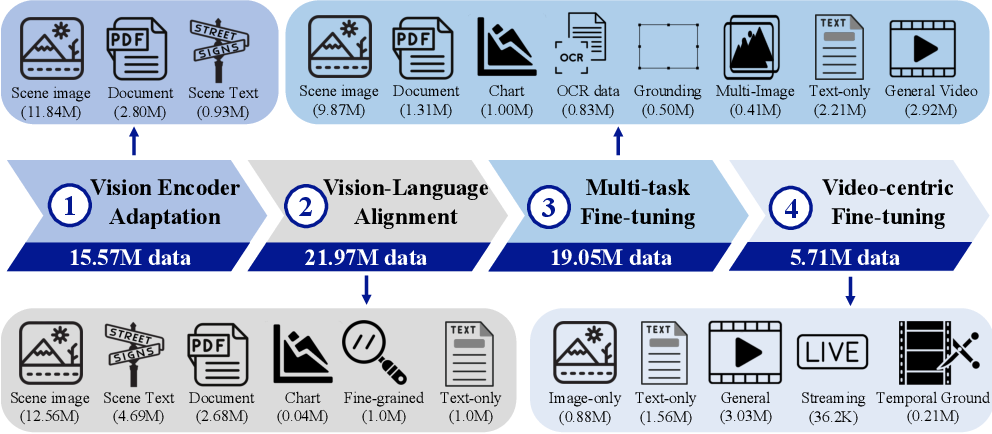
Figure 2 from VideoLLaMA 3: Frontier Multimodal Foundation Models for ...
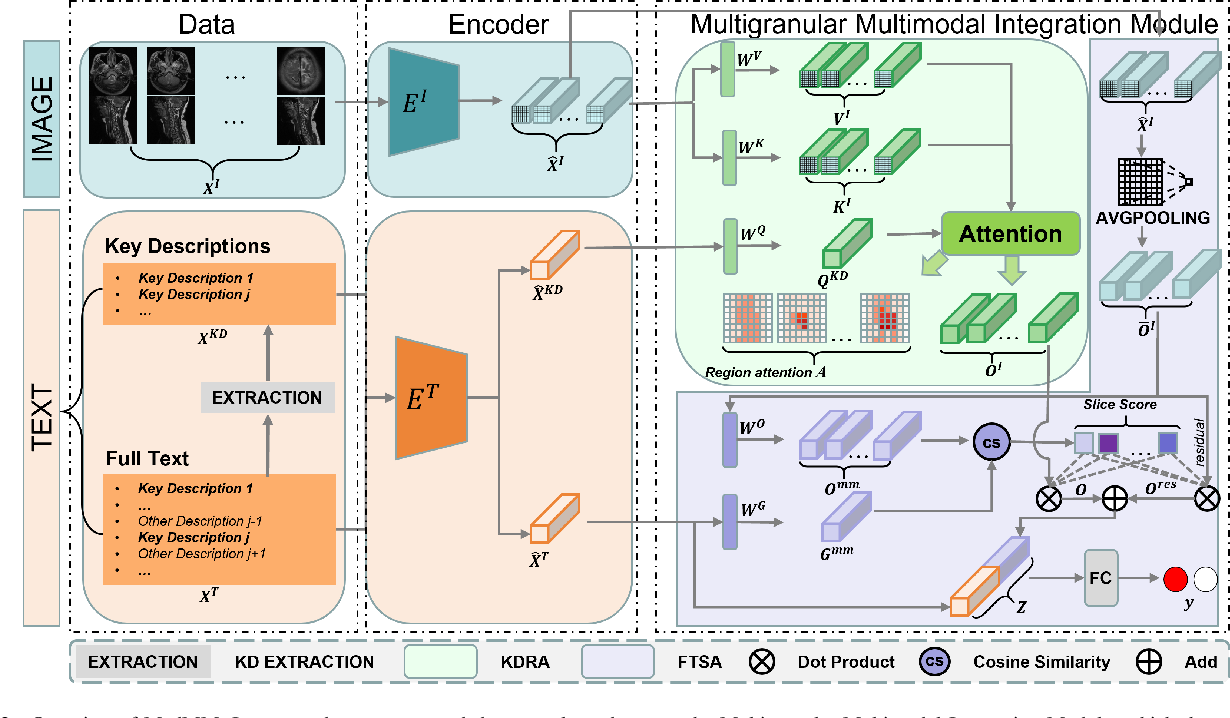
Figure 2 from MedMM: A Multimodal Fusion Framework for 3D Medical Image ...

Figure 2 from LLM supervised Pre-training for Multimodal Emotion ...

Figure 2 from Using Augmented Small Multimodal Models to Guide Large ...
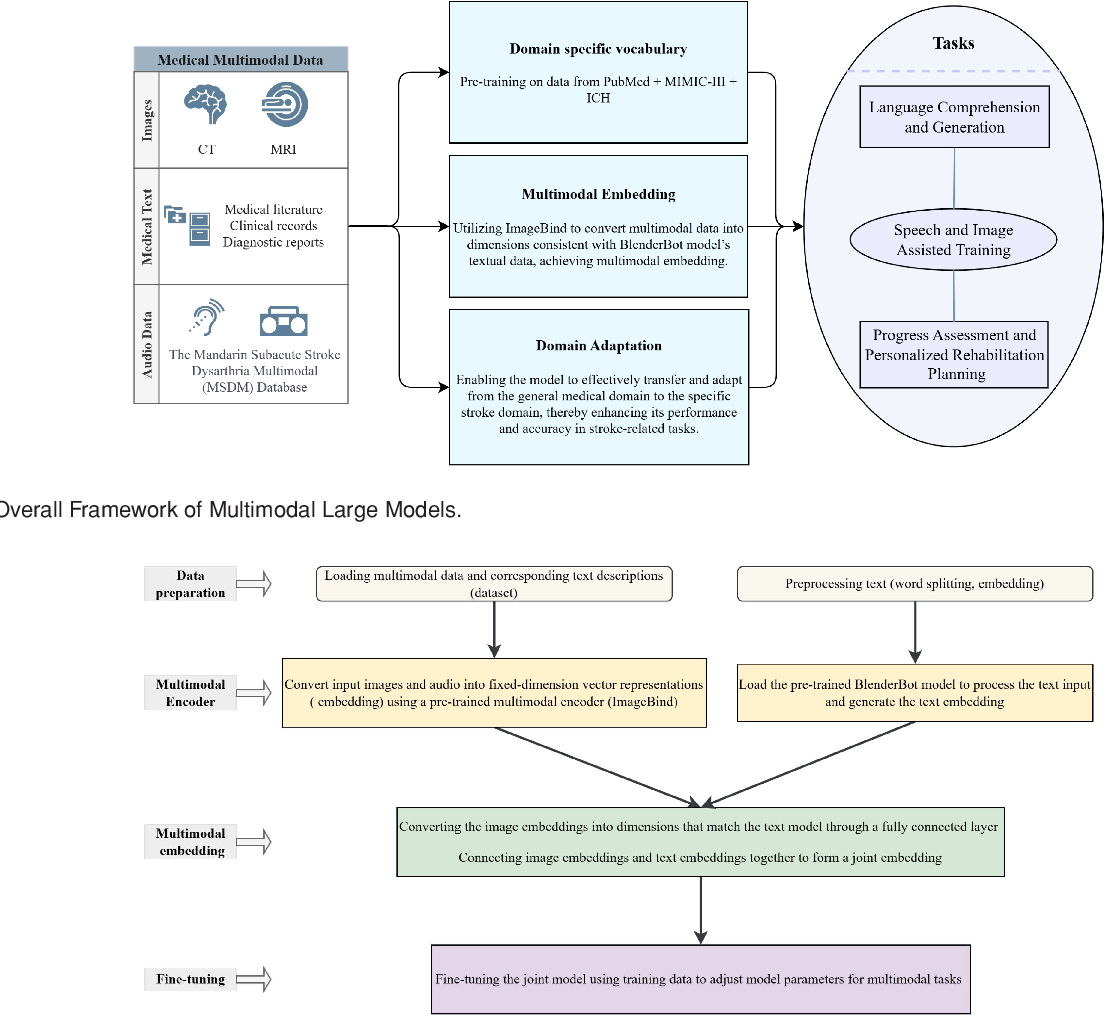
Figure 1 from MBBo-RPSLD: Training a Multimodal BlenderBot for ...
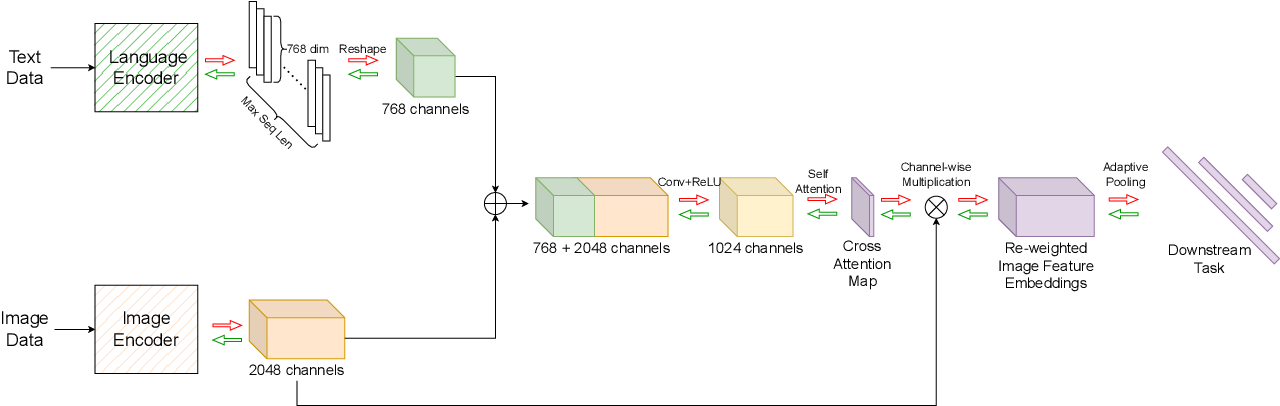
Figure 1 from Multimodal Guidance Network for Missing- Modality ...
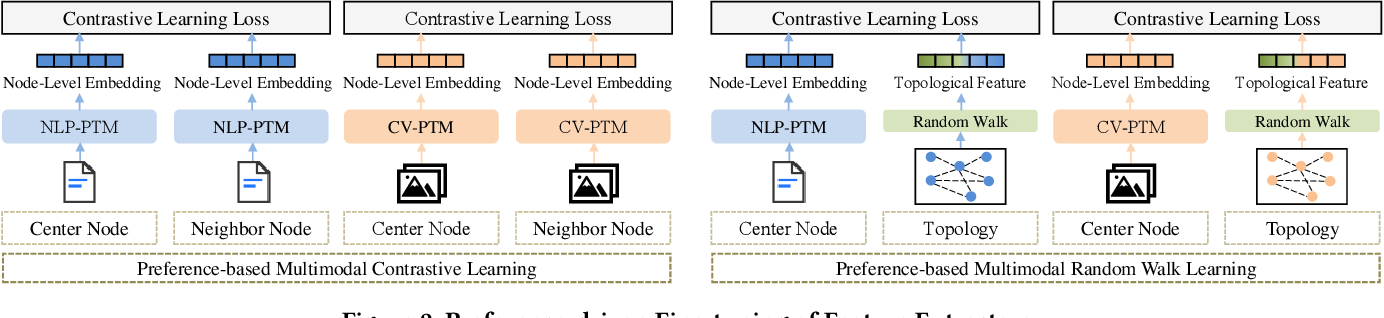
Figure 2 from ModalSync: Synchronizing User Behavior with Multimodal ...
Advertisement Space (336x280)

Figure 2 from Accessible museum collections for the visually impaired ...

Figure 2 from Multimodal Medical Image Classification via Synergistic ...

Figure 2 from Contrastive Pre-training with Multi-level Alignment for ...
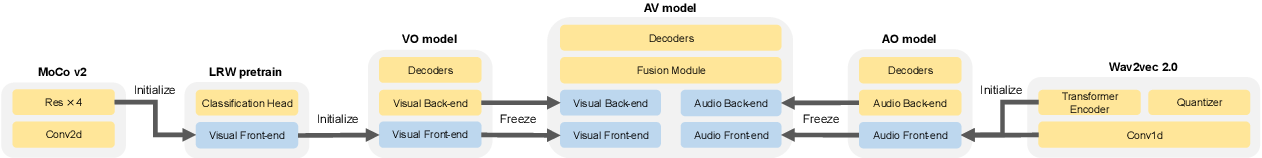
Figure 2 from Leveraging Unimodal Self-Supervised Learning for ...
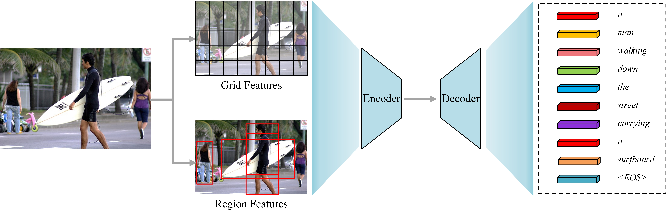
Figure 1 from Image Captioning with Multimodal Guidance and Search ...

Figure 1 from Multimodal Deep Learning for Mental Disorders Prediction ...
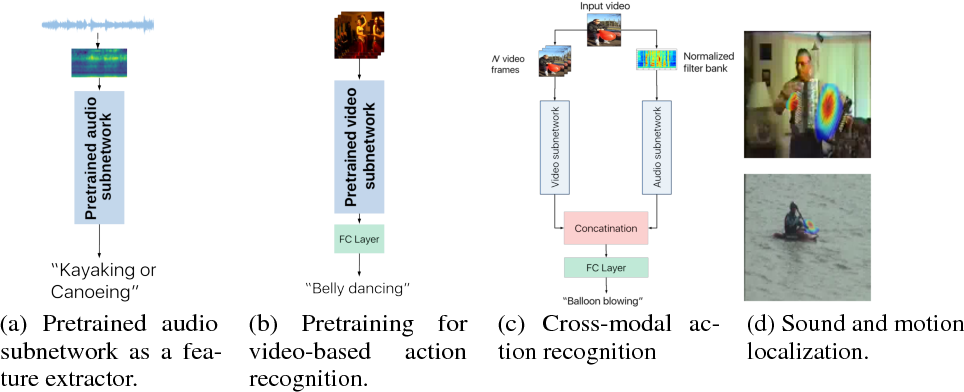
Figure 1 from Co-Training of Audio and Video Representations from Self ...

Figure 2 from Leveraging Latent Diffusion Models for Training-Free in ...
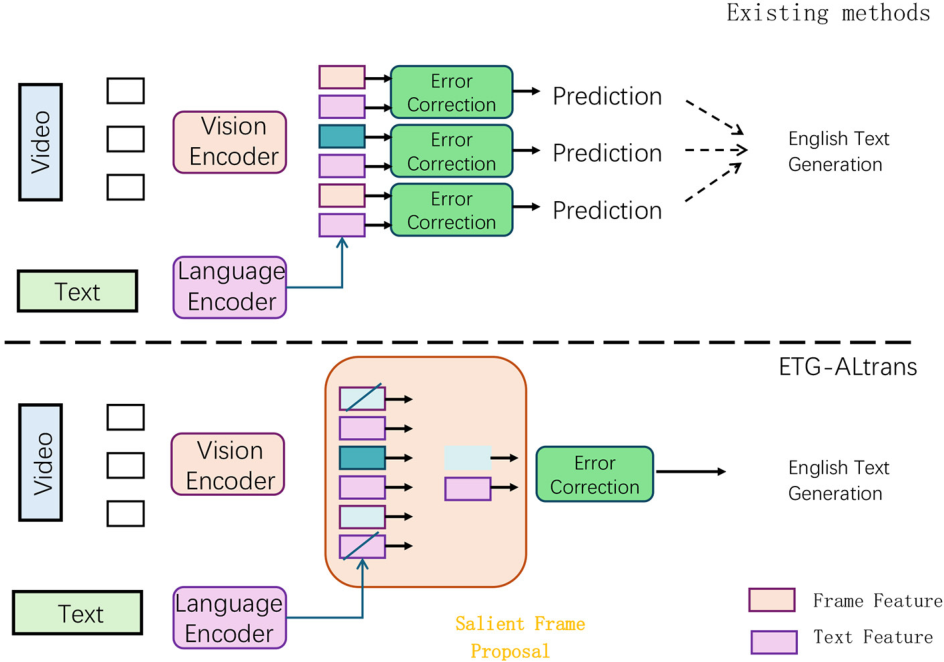
Figure 1 from Multimodal robot-assisted English writing guidance and ...
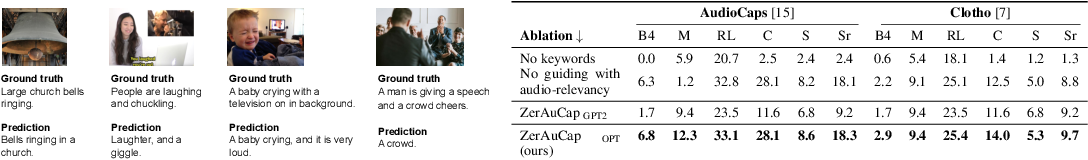
Figure 2 from Zero-shot audio captioning with audio-language model ...
Advertisement Space (336x280)
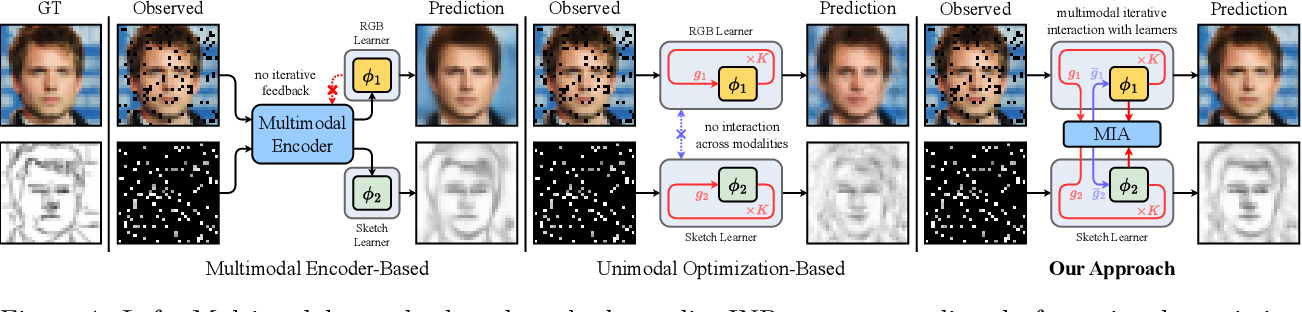
Figure 1 from Meta-Learning Approach for Joint Multimodal Signals with ...
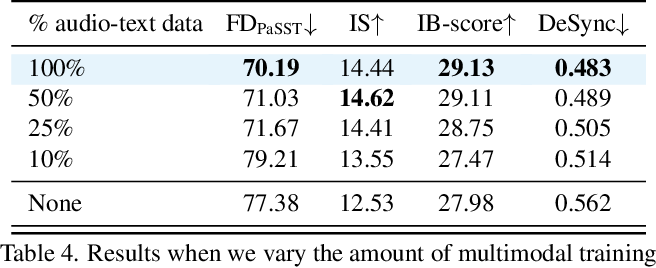
Table 4 from Taming Multimodal Joint Training for High-Quality Video-to ...

Taming Multimodal Joint Training for High-Quality Video-to-Audio ...

FlowMotion: Training-Free Flow Guidance for Video Motion Transfer

Natural-Language-Driven Multimodal Representation Learning for Audio ...
Multimodal Communication Practice Slides | Audio and Video Responses in ...