
Figure 3 From Deep Semantic Graph Transformer For Multi View 3d Human
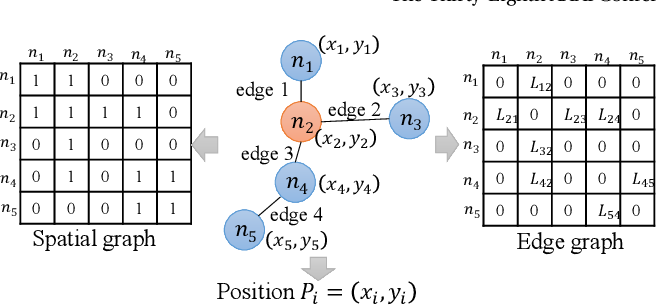
Figure 3 from Deep Semantic Graph Transformer for Multi-View 3D Human ...

Figure 2 from Deep Semantic Graph Transformer for Multi-View 3D Human ...
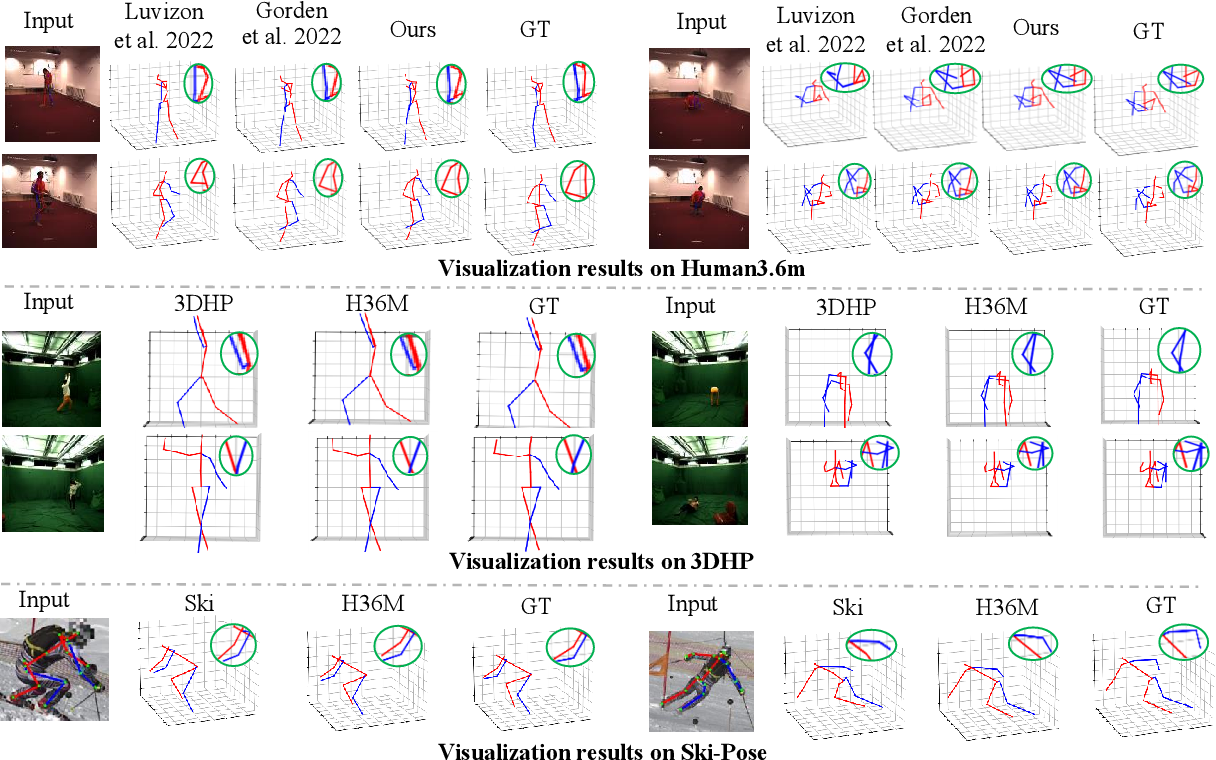
Figure 5 from Deep Semantic Graph Transformer for Multi-View 3D Human ...
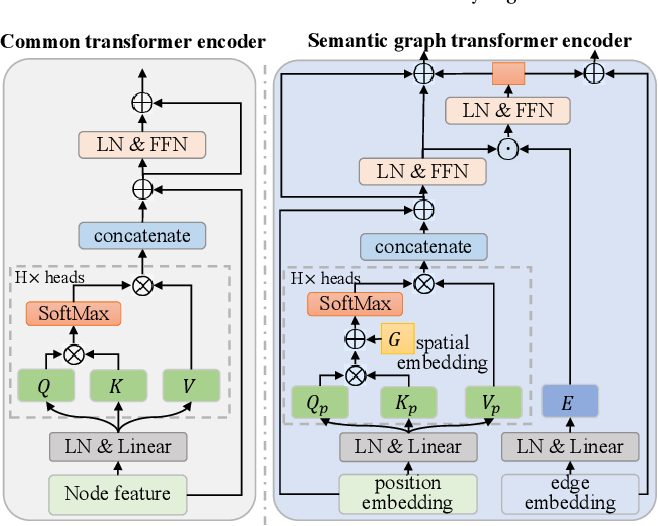
Figure 1 from Deep Semantic Graph Transformer for Multi-View 3D Human ...
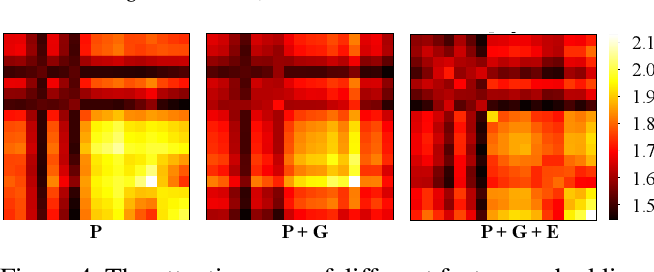
Figure 4 from Deep Semantic Graph Transformer for Multi-View 3D Human ...
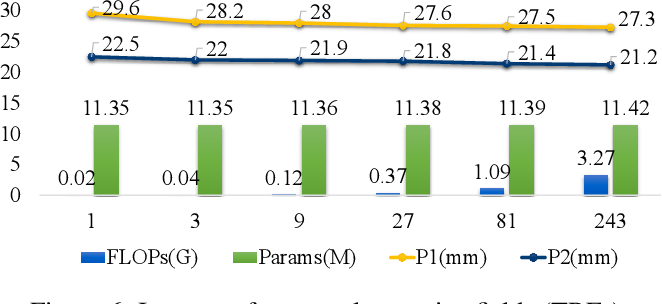
Figure 6 from Deep Semantic Graph Transformer for Multi-View 3D Human ...
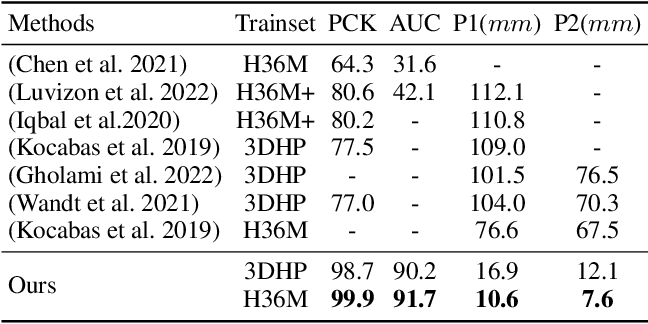
Table 3 from Deep Semantic Graph Transformer for Multi-View 3D Human ...

Table 1 from Deep Semantic Graph Transformer for Multi-View 3D Human ...
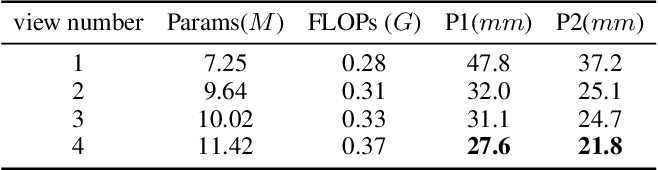
Table 7 from Deep Semantic Graph Transformer for Multi-View 3D Human ...
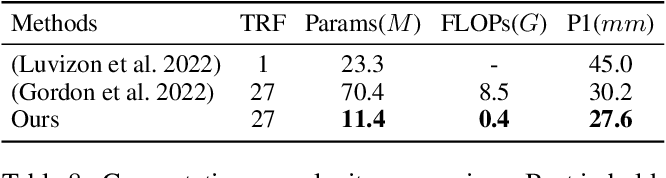
Table 8 from Deep Semantic Graph Transformer for Multi-View 3D Human ...
Advertisement Space (300x250)
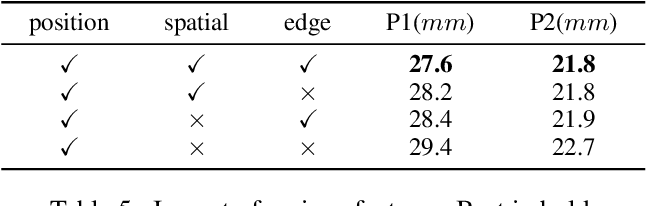
Table 5 from Deep Semantic Graph Transformer for Multi-View 3D Human ...
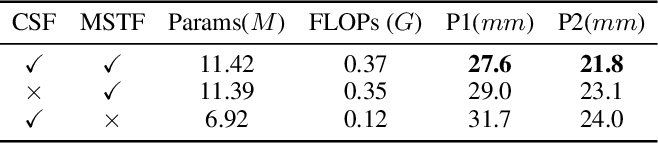
Table 6 from Deep Semantic Graph Transformer for Multi-View 3D Human ...
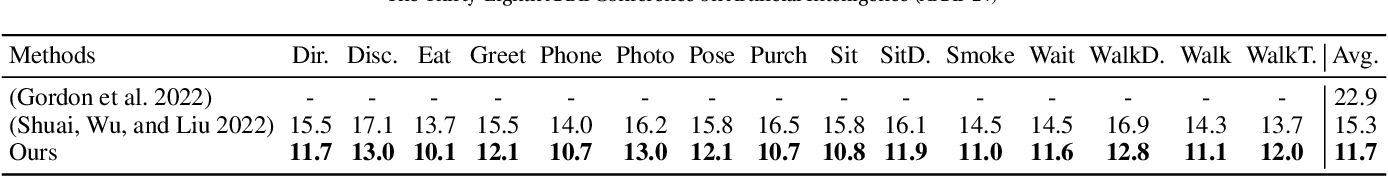
Table 2 from Deep Semantic Graph Transformer for Multi-View 3D Human ...

Figure 3 from Multi-View Transformer for 3D Visual Grounding | Semantic ...

Deep Semantic Graph Transformer for Multi-View 3D Human Pose Estimation ...

Figure 2 from Dual-Branch Graph Transformer Network for 3D Human Mesh ...
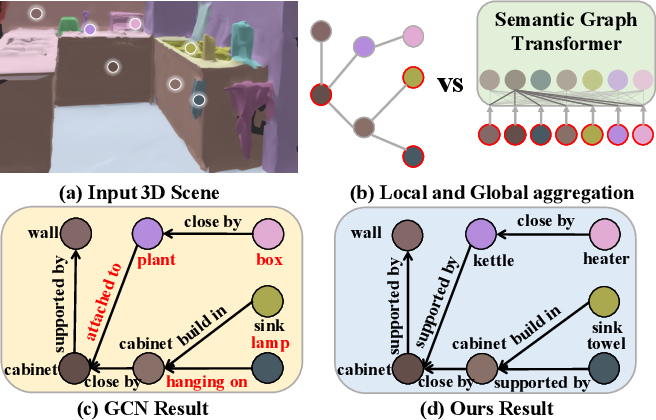
Figure 1 from SGFormer: Semantic Graph Transformer for Point Cloud ...

Figure 2 from SGFormer: Semantic Graph Transformer for Point Cloud ...

Figure 3 from Edge-Enriched Graph Transformer for Multiagent Trajectory ...

Figure 3 from Self-Explainable Graph Transformer for Link Sign ...
Advertisement Space (336x280)

Figure 1 from Mixed Transformer for Temporal 3D Human Pose and Shape ...
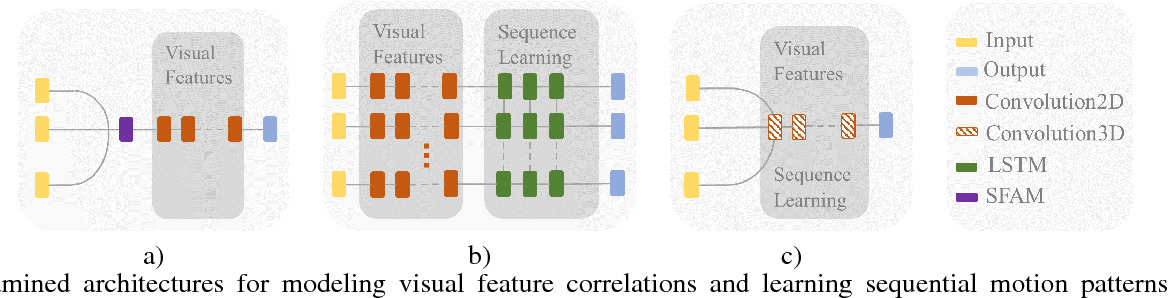
Figure 1 from Deep 3D Flow Features for Human Action Recognition ...

Figure 2 from Mask3D: Mask Transformer for 3D Semantic Instance ...

Figure 1 from Geometry-Biased Transformer for Robust Multi-View 3D ...
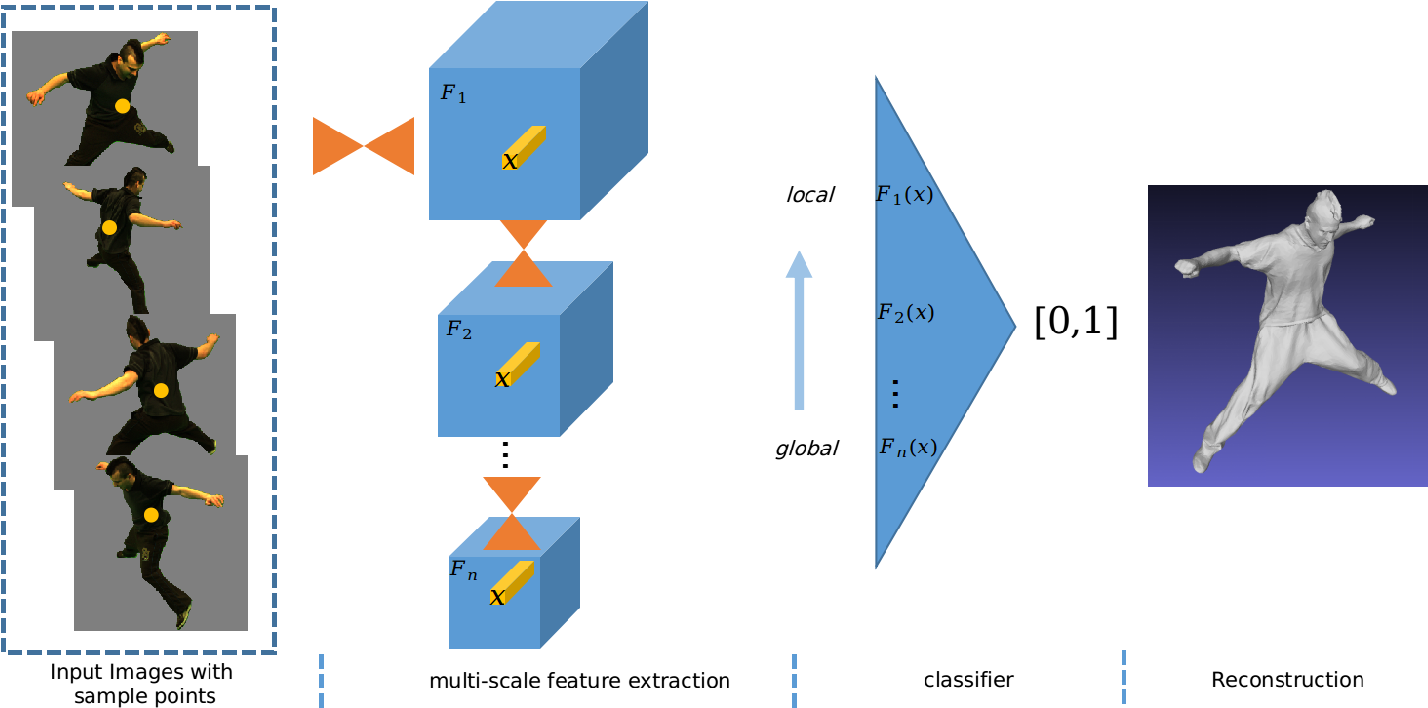
Figure 1 from Learning to Implicitly Represent 3D Human Body From Multi ...

SCGFormer: Semantic Chebyshev Graph Convolution Transformer for 3D ...

Figure 3 from Efficient 3D Semantic Segmentation with Superpoint ...

Figure 1 from 3D Human Pose Estimation from Deep Multi-View 2D Pose ...

Figure 1 from Learning Sequential Contexts using Transformer for 3D ...
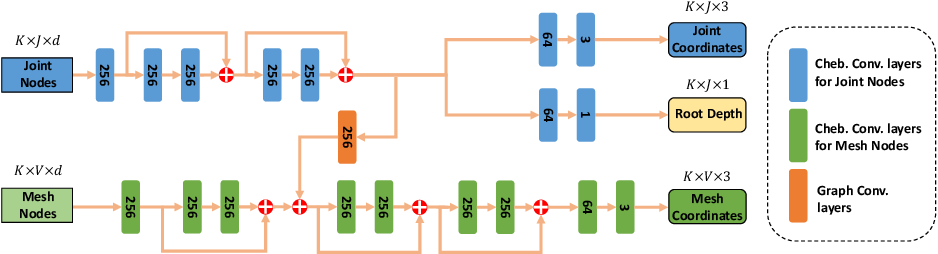
Figure 1 from MUG: Multi-human Graph Network for 3D Mesh Reconstruction ...
Advertisement Space (336x280)

Figure 3 from 3D Reconstruction of Medical Images with Transformer ...

(PDF) MeT: A Graph Transformer for Semantic Segmentation of 3D Meshes

Figure 5 from Edge-Enriched Graph Transformer for Multiagent Trajectory ...

A Robust Framework for 3D Human Pose Estimation Using Semantic Graph ...

Semantic Scene Graph Generation from Human Demonstration for Robotic ...

Figure 1 from Deep 3D Portrait From a Single Image | Semantic Scholar