
Figure 3 From Grounding 3d Object Affordance From 2d Interactions In

Figure 3 from Grounding 3D Object Affordance from 2D Interactions in ...

Figure 15 from Grounding 3D Object Affordance from 2D Interactions in ...

Figure 7 from Grounding 3D Object Affordance from 2D Interactions in ...

Figure 5 from Grounding 3D Object Affordance from 2D Interactions in ...
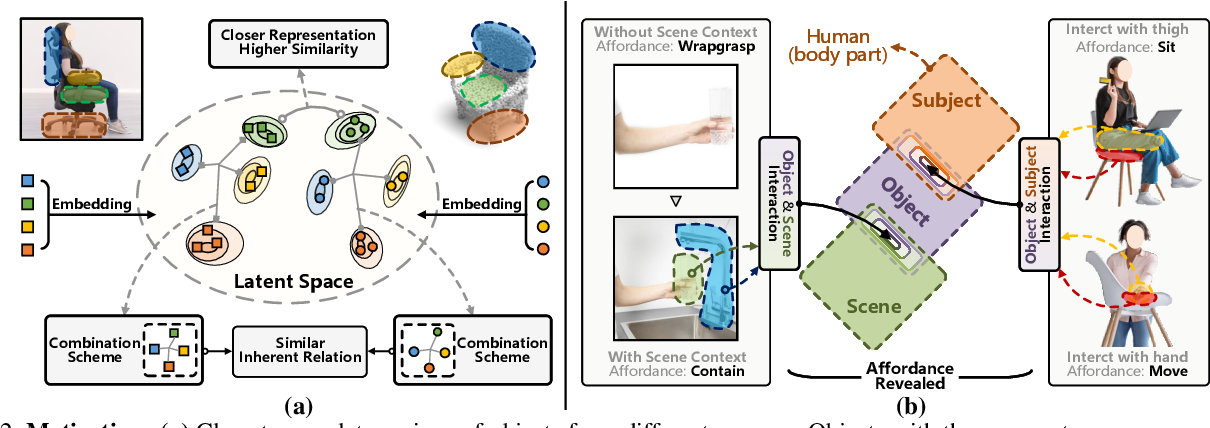
Figure 2 from Grounding 3D Object Affordance from 2D Interactions in ...

Figure 11 from Grounding 3D Object Affordance from 2D Interactions in ...

Figure 10 from Grounding 3D Object Affordance from 2D Interactions in ...

Figure 4 from Grounding 3D Object Affordance from 2D Interactions in ...

Grounding 3D Object Affordance from 2D Interactions in Images: Paper ...

Paper page - Grounding 3D Object Affordance from 2D Interactions in Images
Advertisement Space (300x250)

ICCV2023: Grounding 3D Object Affordance from 2D Interactions in Images ...

Table 1 from Grounding 3D Object Affordance from 2D Interactions in ...

Figure 3 from Dense Object Grounding in 3D Scenes | Semantic Scholar
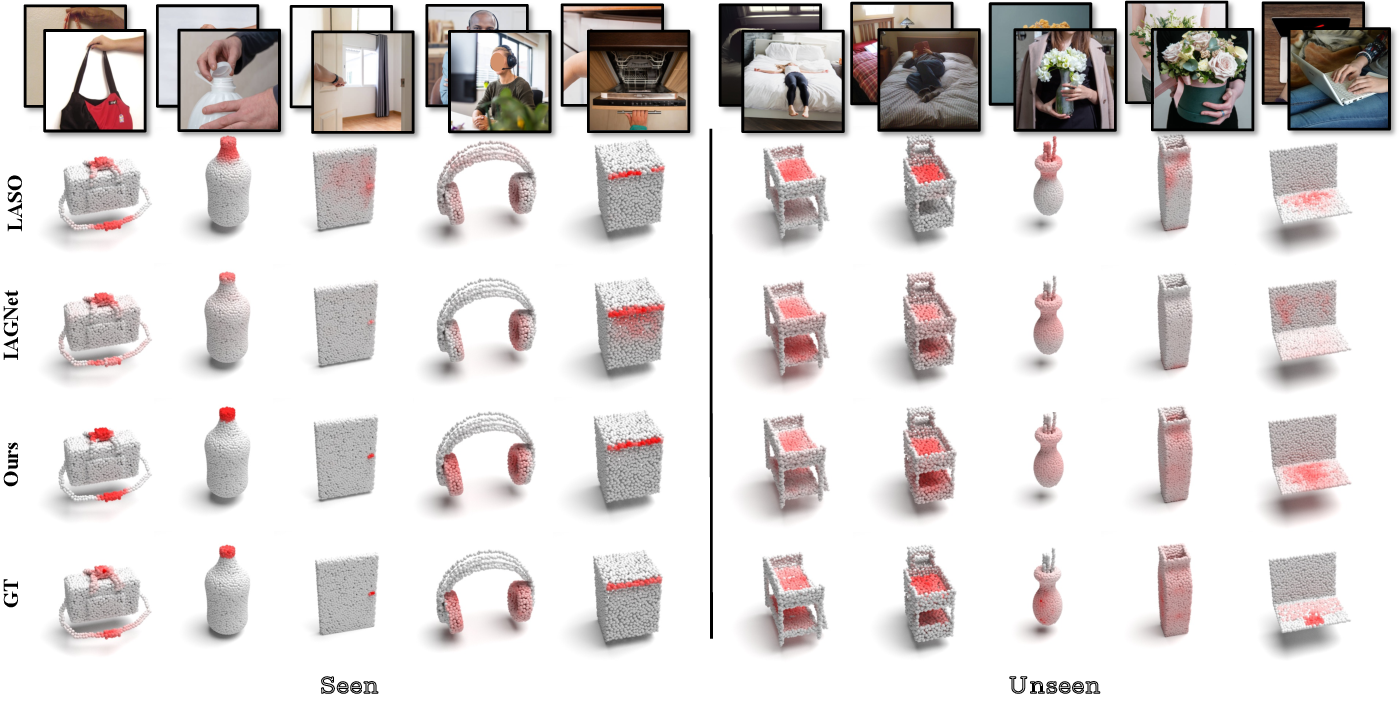
Figure 1 from Learning 2D Invariant Affordance Knowledge for 3D ...
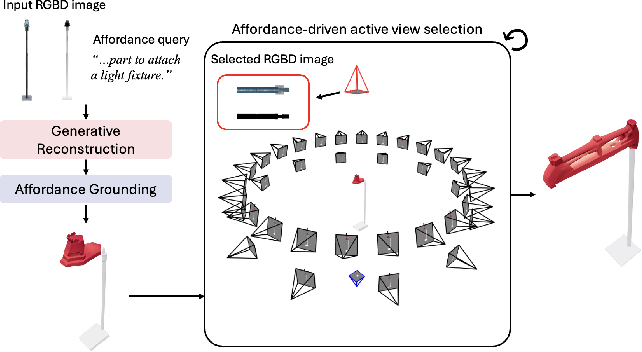
Figure 1 from Affostruction: 3D Affordance Grounding with Generative ...
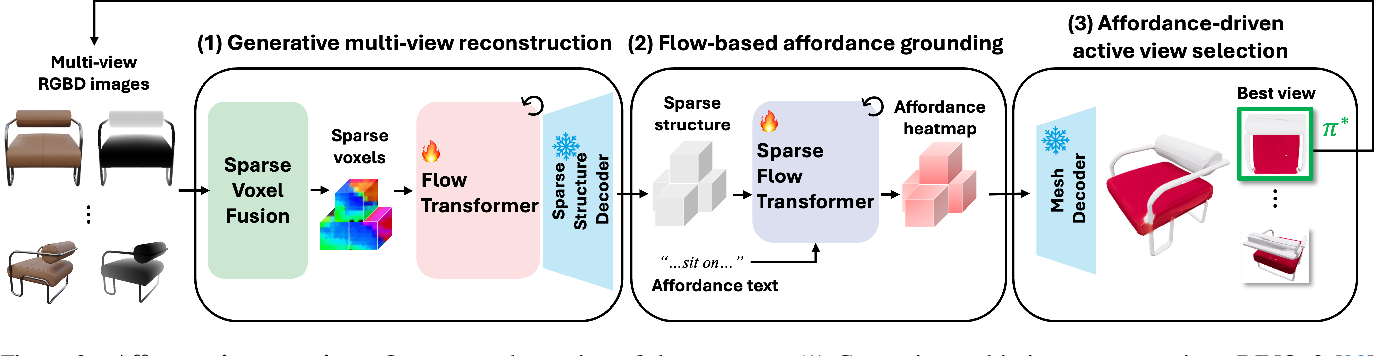
Figure 2 from Affostruction: 3D Affordance Grounding with Generative ...

Figure 1 from Grounding 3D Scene Affordance From Egocentric ...

Figure 1 from Grounding 3D Scene Affordance From Egocentric ...

Figure 2 from Unlocking 3D Affordance Segmentation with 2D Semantic ...
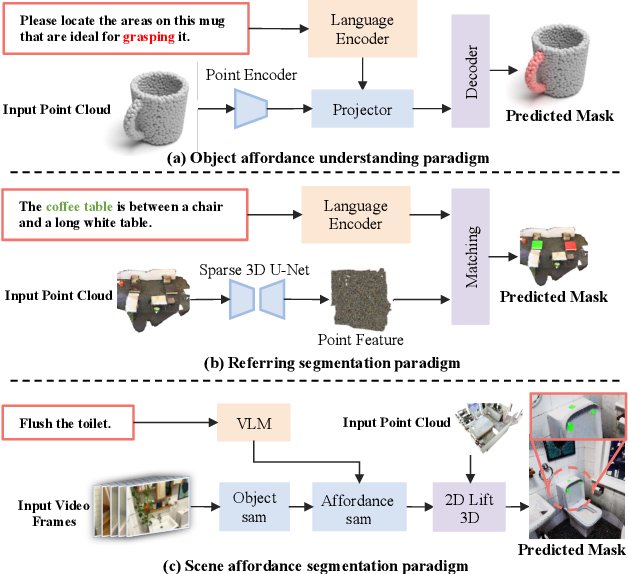
Figure 1 from Task-Aware 3D Affordance Segmentation via 2D Guidance and ...
Advertisement Space (336x280)
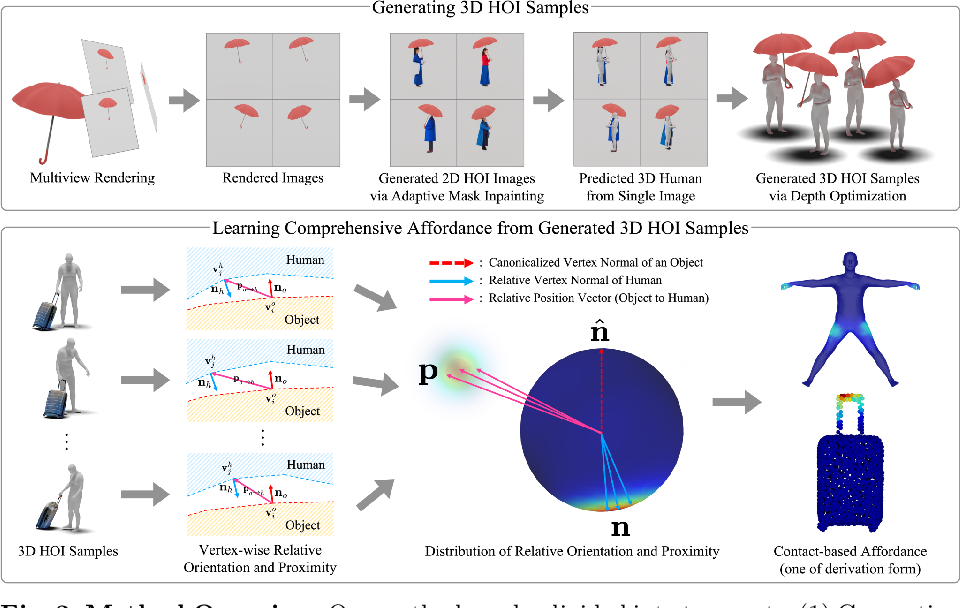
Figure 3 from Beyond the Contact: Discovering Comprehensive Affordance ...

VideoAfford: Grounding 3D Affordance from Human-Object-Interaction ...

Figure 2 from Embodied Affordance Grounding using Semantic ...

Figure 3 from Learning Foresightful Dense Visual Affordance for ...

Figure 2 from Learning Environment-Aware Affordance for 3D Articulated ...

[论文评述] VideoAfford: Grounding 3D Affordance from Human-Object ...

Figure 1 from AugRefer: Advancing 3D Visual Grounding via Cross-Modal ...
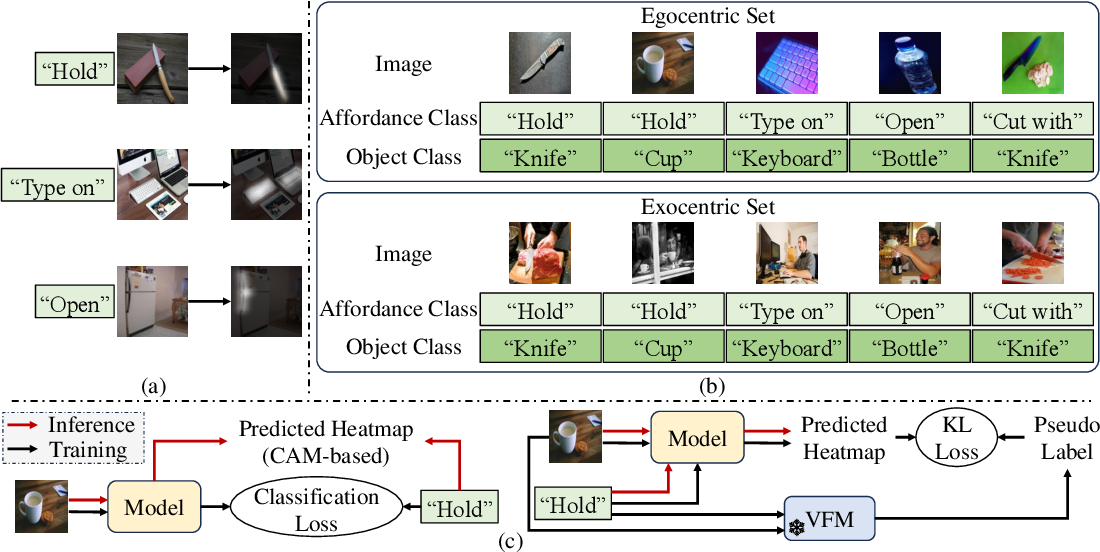
Figure 1 from Weakly-Supervised Affordance Grounding Guided by Part ...
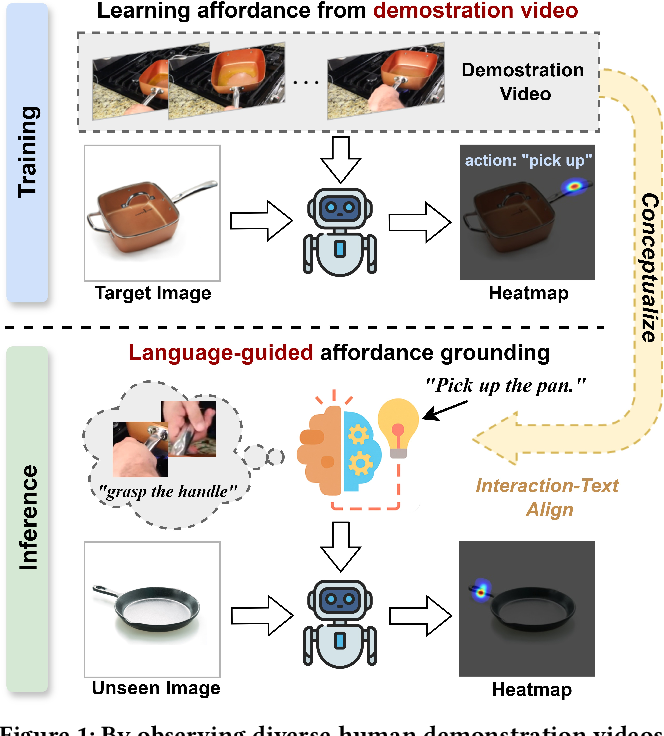
Figure 1 from Video-to-Image Affordance Grounding via Visual Conceptual ...

Figure 1 from Affordance Grounding from Demonstration Video to Target ...
Advertisement Space (336x280)
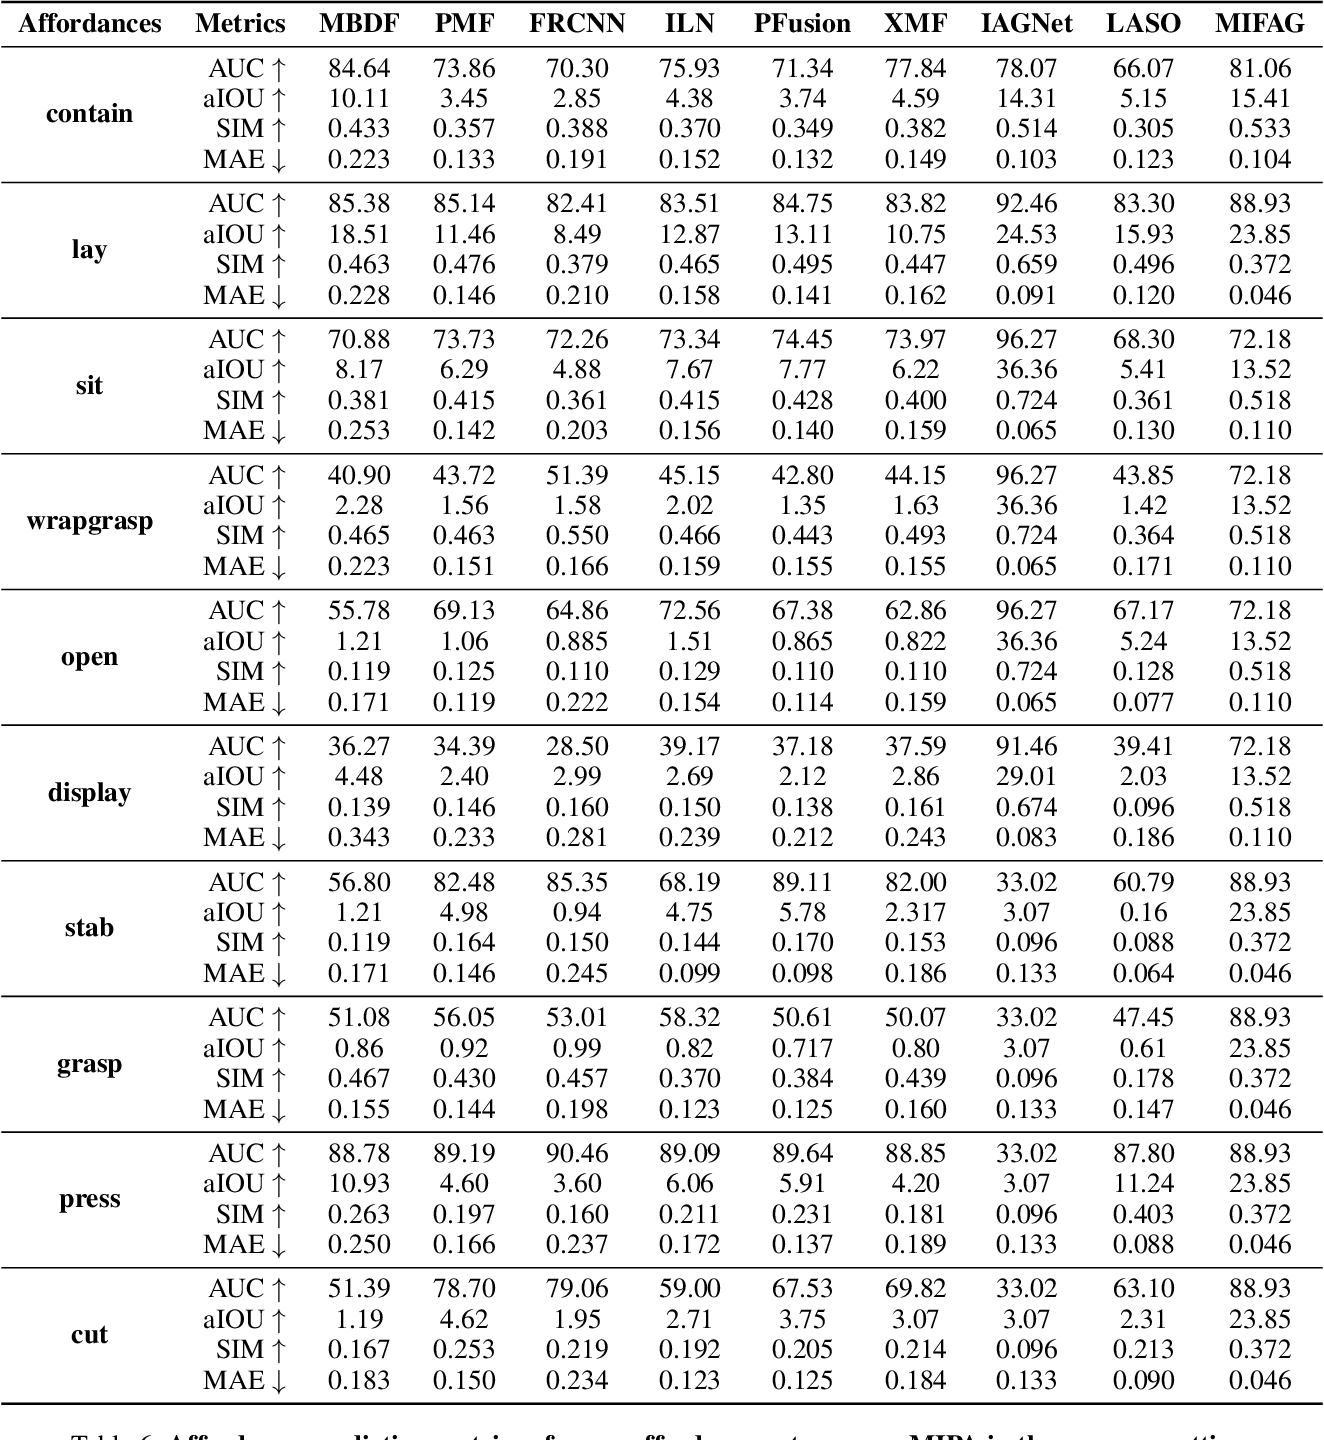
Table 6 from Learning 2D Invariant Affordance Knowledge for 3D ...

Figure 1 from Toward Explainable and Fine-Grained 3D Grounding through ...

CompassAD: Intent-Driven 3D Affordance Grounding in Functionally ...

Learning 2D Invariant Affordance Knowledge for 3D Affordance Grounding

Grounding 3D Object Affordance with Language Instructions, Visual ...

Learning 2D Invariant Affordance Knowledge for 3D Affordance Grounding