
Figure 3 From Multi Modal Image Captioning Semantic Scholar
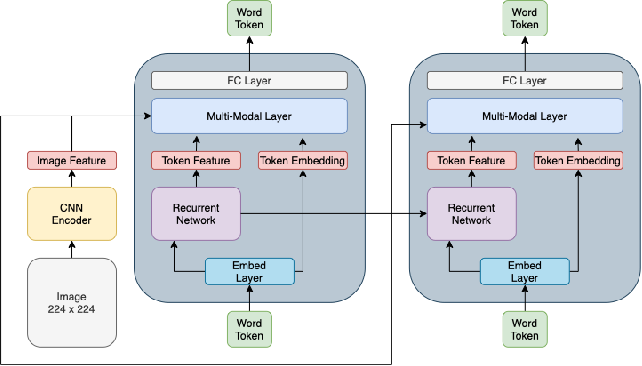
Figure 3 from Multi-Modal Image Captioning | Semantic Scholar
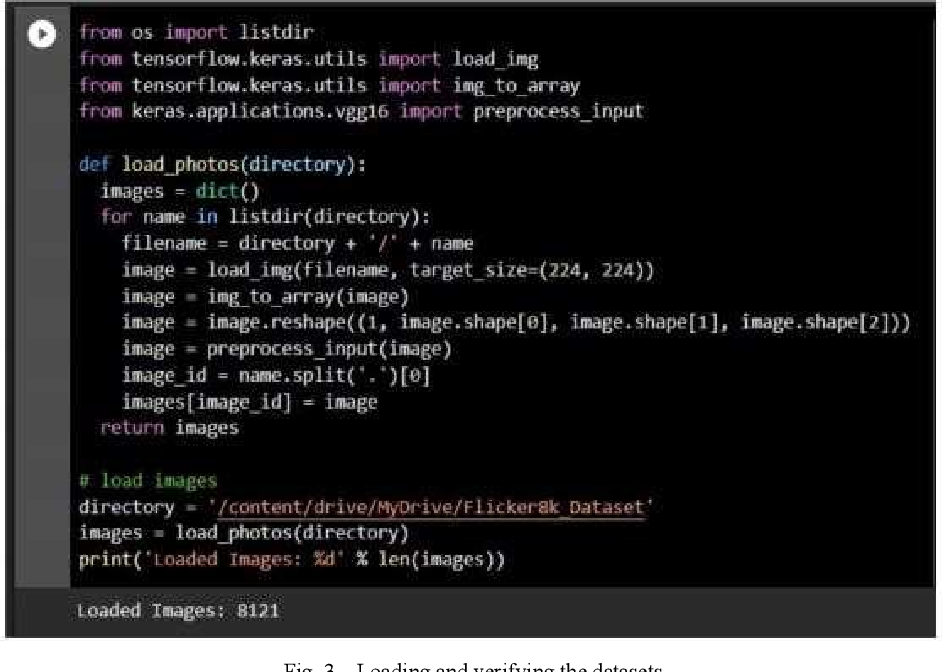
Figure 3 from Hybrid Image Captioning Model | Semantic Scholar

Figure 3 from Image Captioning Based on Deep Neural Networks | Semantic ...

Figure 1 from Multi-Modal Image Captioning | Semantic Scholar
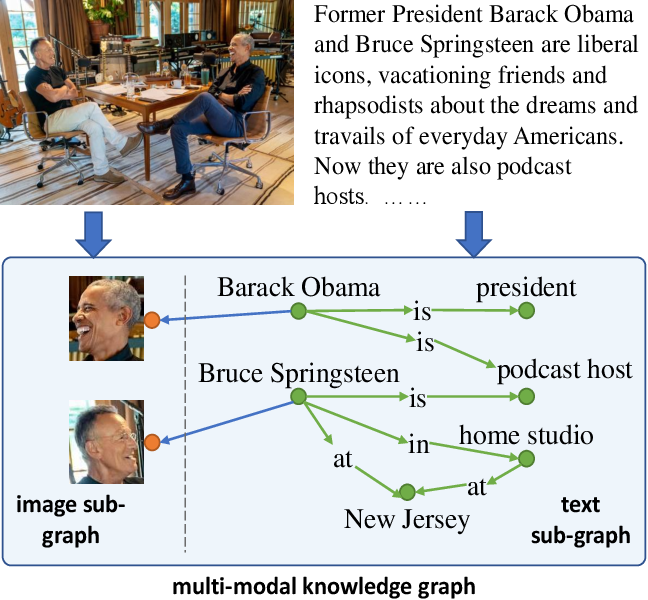
Figure 3 from Boosting Entity-Aware Image Captioning With Multi-Modal ...

Figure 3 from Variational Autoencoder-Based Multiple Image Captioning ...
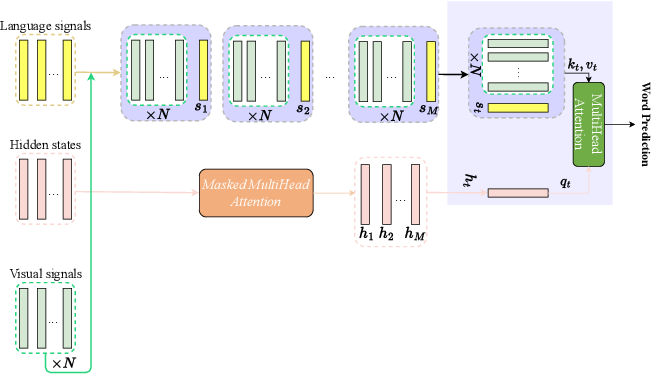
Figure 3 from A Multi-scale Approach for Vietnamese Image Captioning in ...

Figure 3 from Enlightened Imagery: Multi-modal Image Captioning with ...

Figure 3 from Image Captioning Method Based on Layer Feature Attention ...

Table 2 from Multi-Modal Image Captioning | Semantic Scholar
Advertisement Space (300x250)

Figure 3 from Voice-based Image Captioning using Inception-V3 Transfer ...

Figure 3 from Towards Few-shot Image Captioning with Cycle-based ...
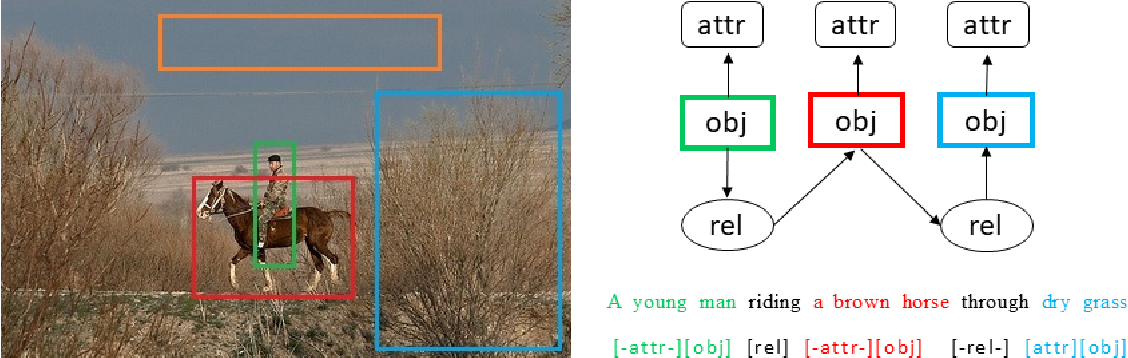
Figure 3 from Image Captioning According to User's Intention and Style ...

Figure 3 from Improving Generalization of Image Captioning with ...
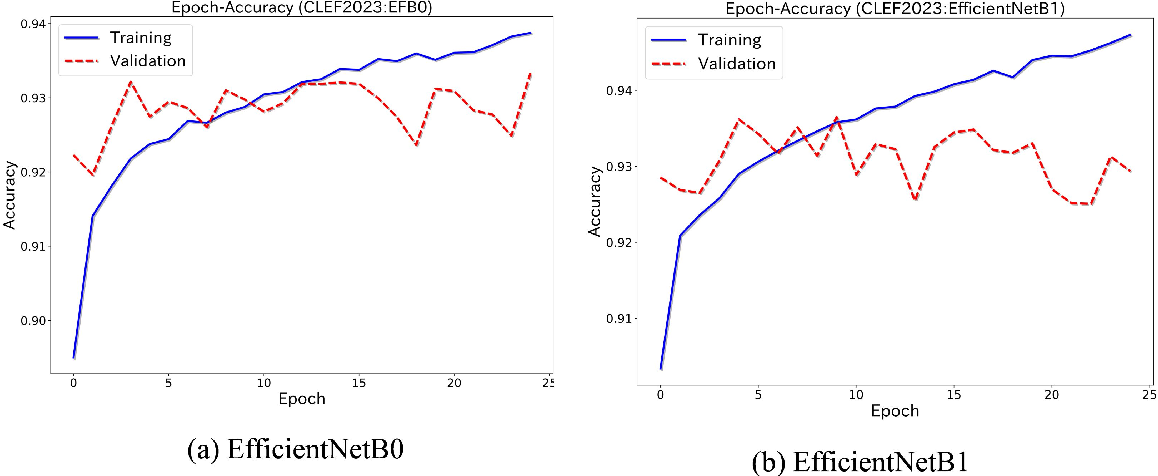
Figure 3 from Multi-stage Medical Image Captioning using Classification ...

Figure 3 from Towards Multimodal Video Paragraph Captioning Models ...

Figure 2 from Boosting Entity-Aware Image Captioning With Multi-Modal ...
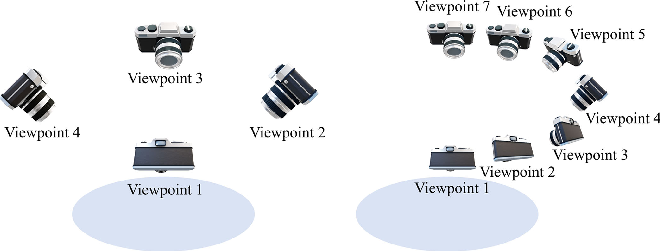
Figure 3 from 3D-Aware Scene Change Captioning From Multiview Images ...

Figure 3 from Hijacking Context in Large Multi-modal Models | Semantic ...

Figure 3 from Multi-Modal Medical Image Fusion for Enhanced Diagnosis ...
Advertisement Space (336x280)

Figure 3 from Exploring Diverse In-Context Configurations for Image ...

Figure 3 from Emotional Video Captioning With Vision-Based Emotion ...
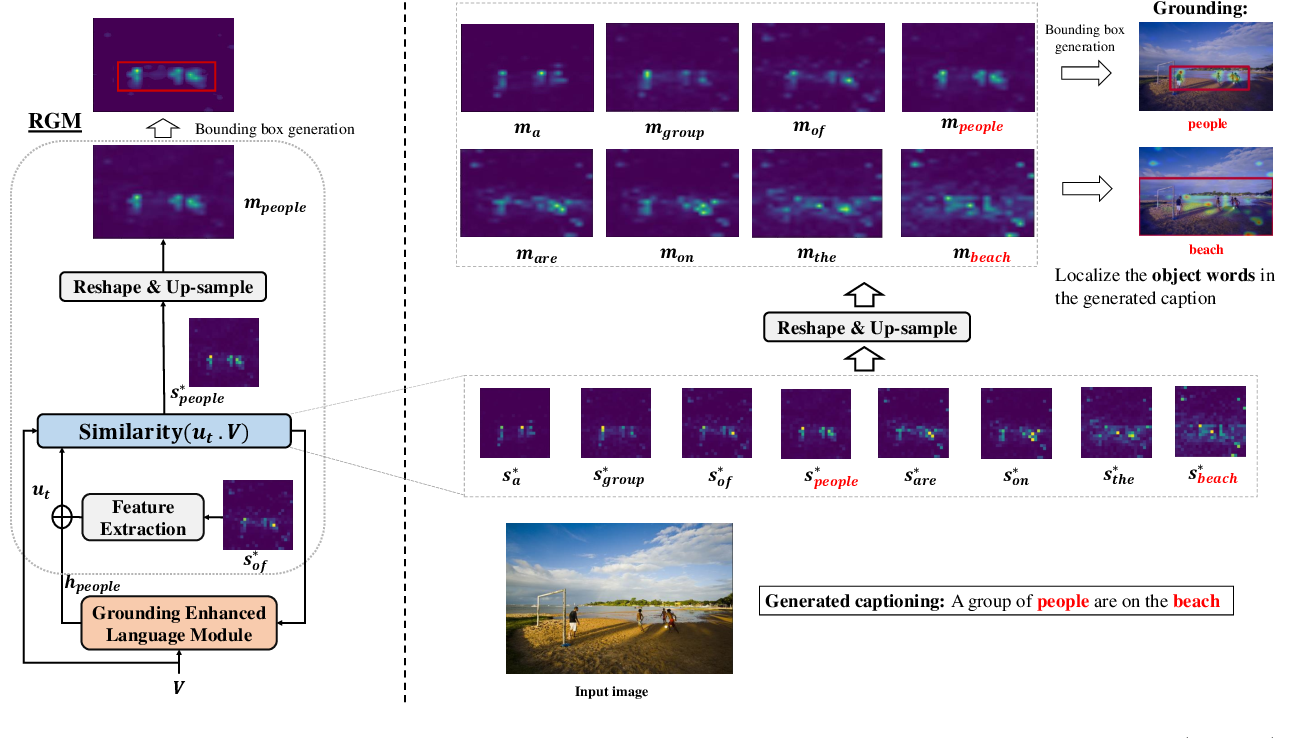
Figure 3 from Top-Down Viewing for Weakly Supervised Grounded Image ...

Figure 3 from Textual Context-Aware Dense Captioning With Diverse Words ...

Figure 3 from Towards Multimodal Semantic Consistency Analysis of Long ...

Figure 2 from Cross2StrA: Unpaired Cross-lingual Image Captioning with ...
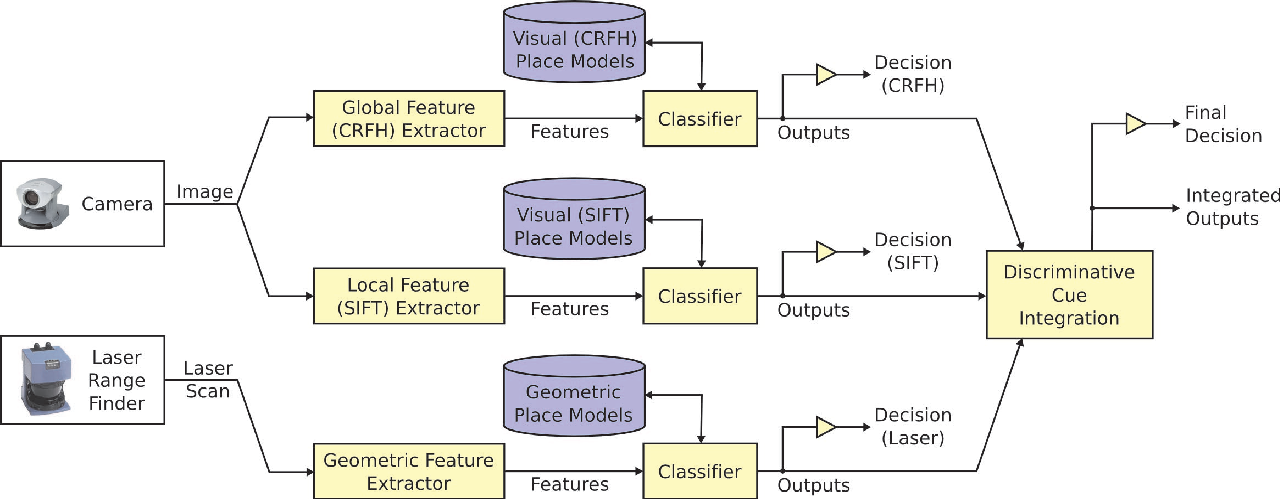
Figure 1 from Multi-modal Semantic Place Classification | Semantic Scholar
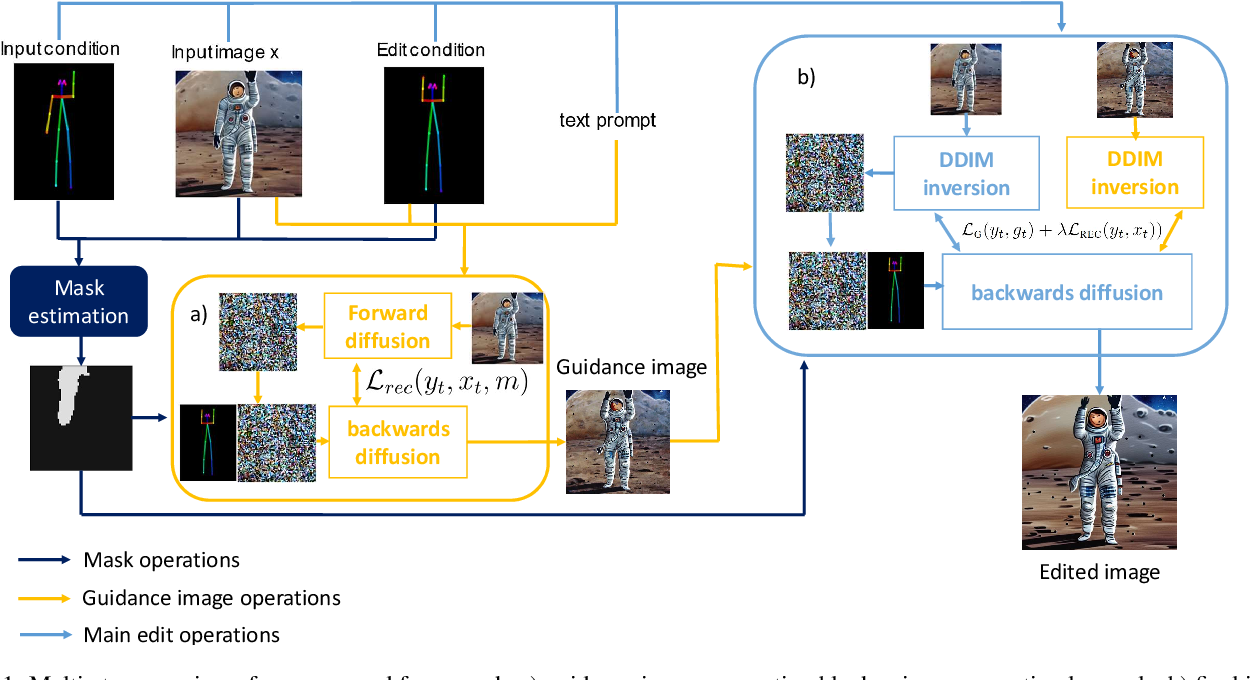
Figure 1 from Optimisation-Based Multi-Modal Semantic Image Editing ...

Figure 1 from Imageability- and Length-controllable Image Captioning ...

Figure 2 from Image Captioning with Multi-Context Synthetic Data ...
Advertisement Space (336x280)

Table 3 from Mixture of Attention Variants for Modal Fusion in Multi ...

Figure 2 from Prompting Multi-Modal Image Segmentation with Semantic ...

Figure 2 from Improving Image Captioning via Predicting Structured ...
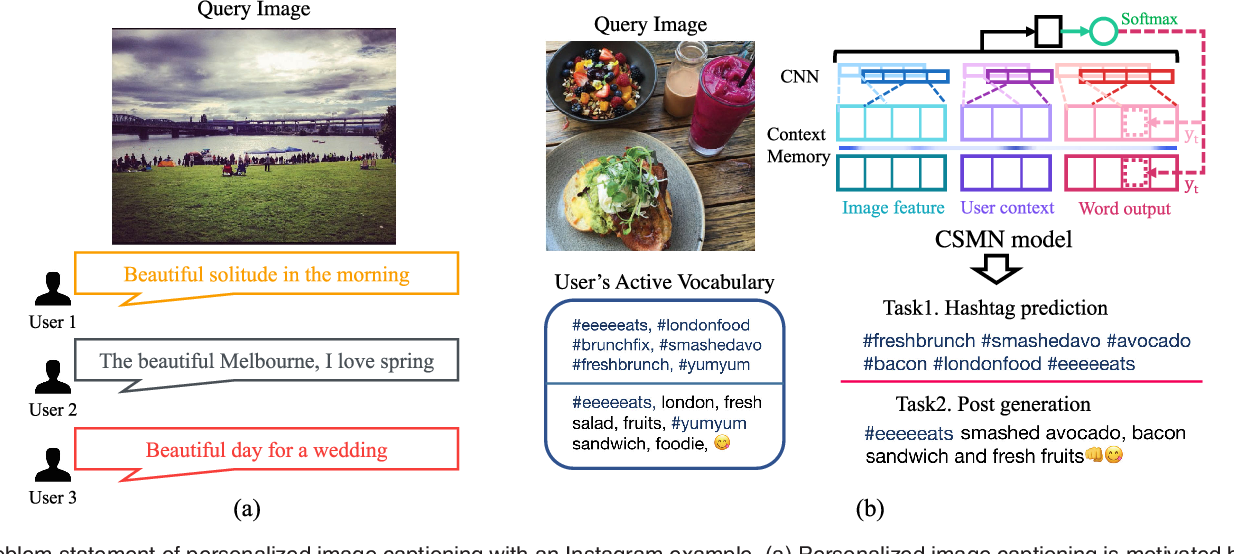
Figure 1 from Towards Personalized Image Captioning via Multimodal ...

Figure 3 from Multimodal Transformer With Multi-View Visual ...
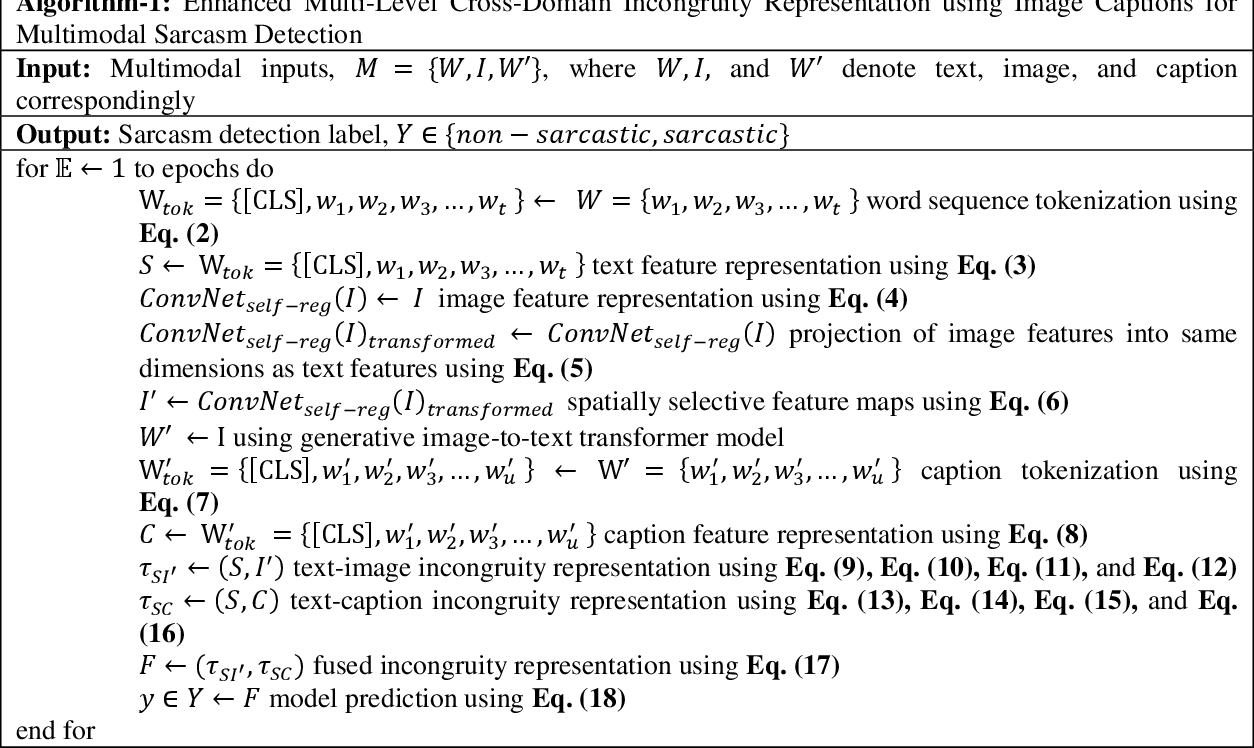
Table 1 from Modelling Visual Semantics via Image Captioning to extract ...