
Figure 3 From Sequence Level Semantics Aggregation For Video Object
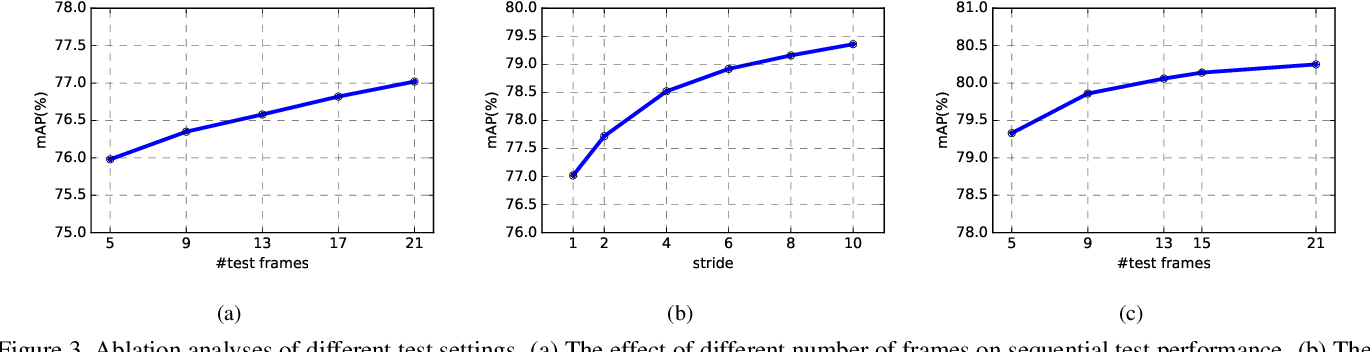
Figure 3 from Sequence Level Semantics Aggregation for Video Object ...

Sequence Level Semantics Aggregation for Video Object Detection
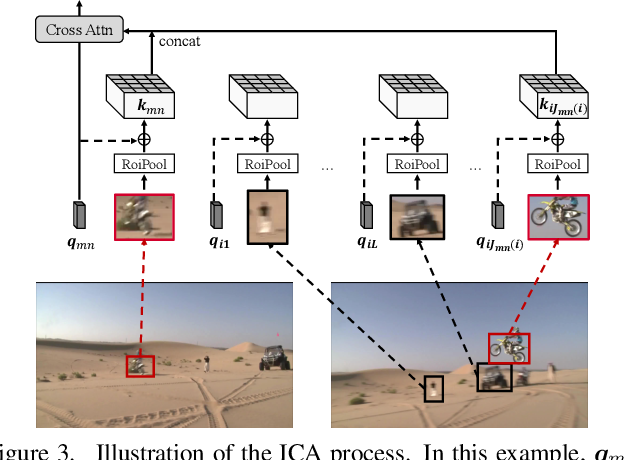
Figure 3 from Identity-Consistent Aggregation for Video Object ...

Sequence Level Semantics Aggregation for Video Object Detection
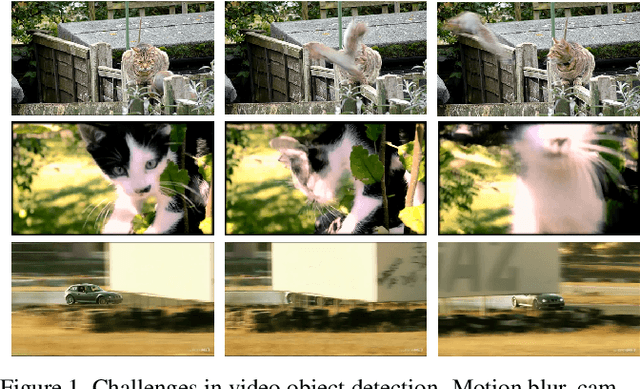
Sequence Level Semantics Aggregation for Video Object Detection

Figure 3 from Flow-Guided Feature Aggregation for Video Object ...

Sequence Level Semantics Aggregation for Video Object Detection
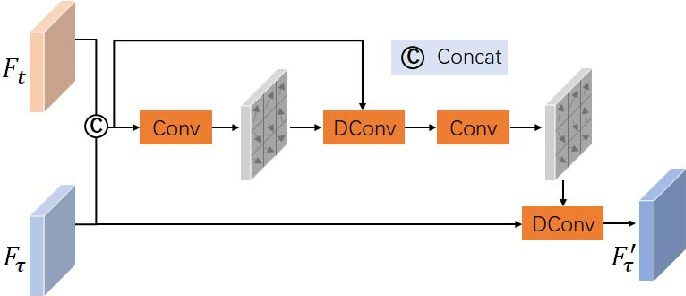
Figure 3 from Multilevel Spatial-Temporal Feature Aggregation for Video ...

Figure 1 from Class-Aware Feature Aggregation Network for Video Object ...
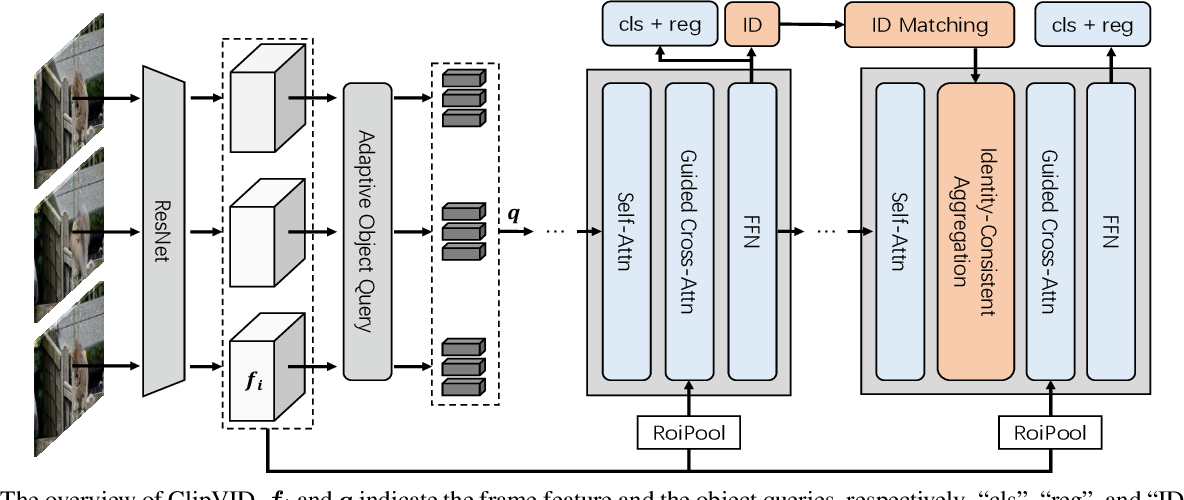
Figure 2 from Identity-Consistent Aggregation for Video Object ...
Advertisement Space (300x250)
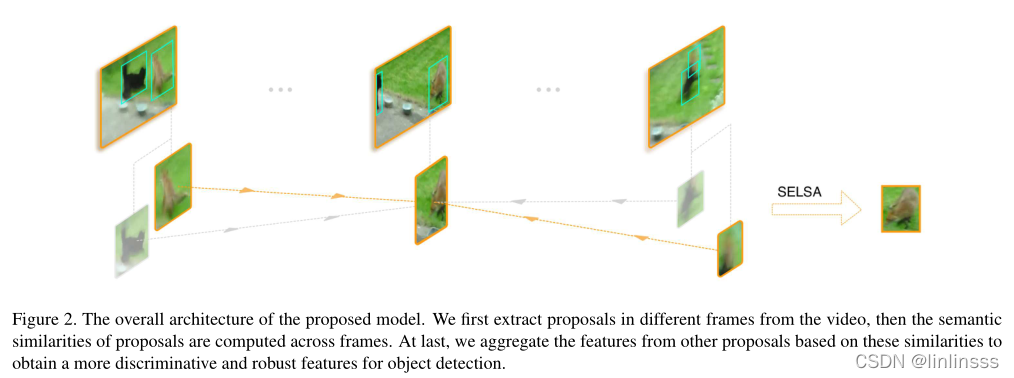
视频目标检测paper(二)《Sequence Level Semantics Aggregation for Video Object ...

视频目标检测paper(二)《Sequence Level Semantics Aggregation for Video Object ...
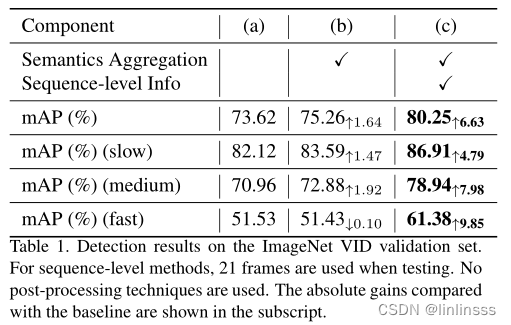
视频目标检测paper(二)《Sequence Level Semantics Aggregation for Video Object ...
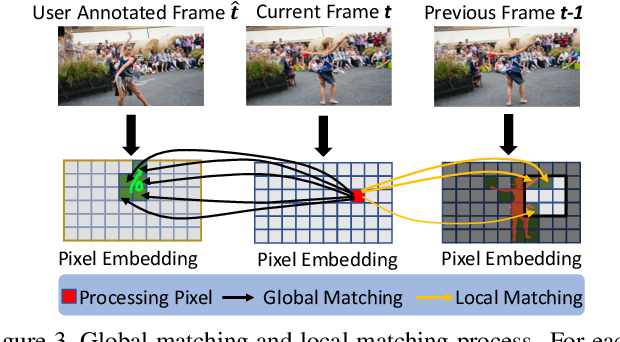
Figure 3 from Memory Aggregation Networks for Efficient Interactive ...
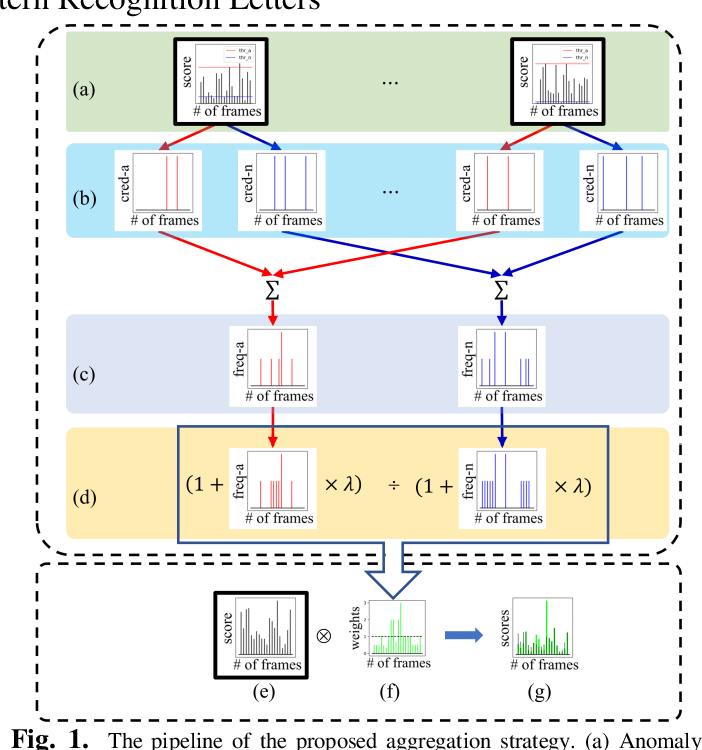
Figure 1 from Main-Auxiliary Aggregation Strategy for Video Anomaly ...

Figure 1 from Learning intra-inter semantic aggregation for video ...
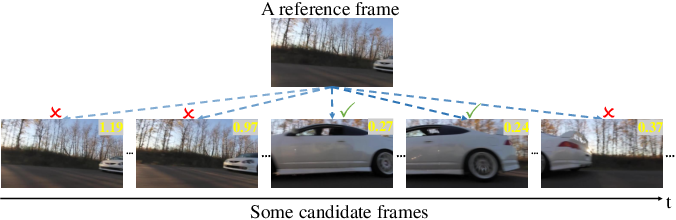
Figure 2 from Guided Sampling Based Feature Aggregation for Video ...
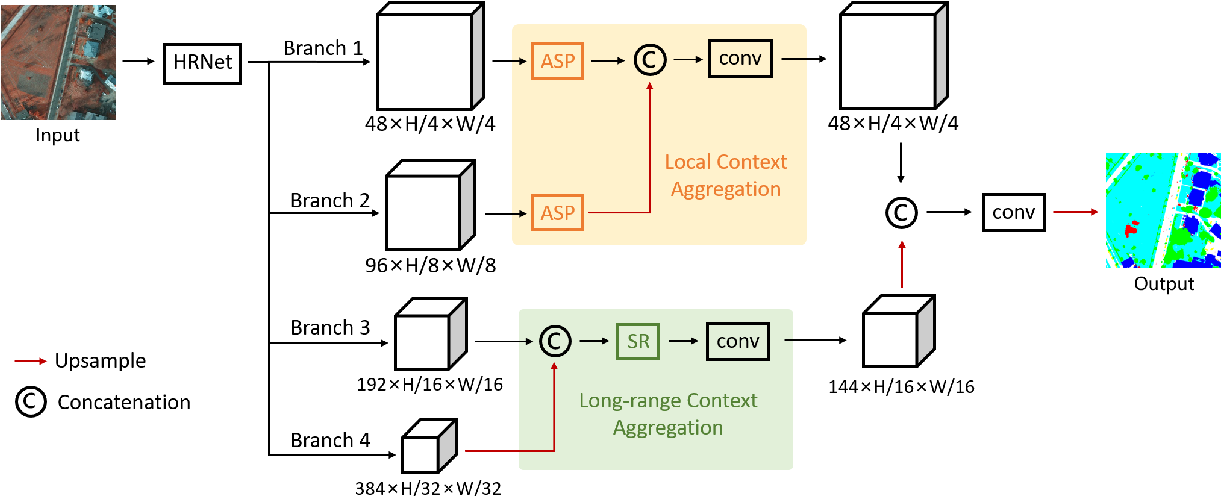
Figure 3 from Multi-Scale Context Aggregation for Semantic Segmentation ...

Figure 2 from Temporal ROI Align for Video Object Recognition ...

Figure 1 from Fast Video Object Segmentation With Temporal Aggregation ...
Advertisement Space (336x280)

Figure 3 from Exploring Segment-Level Semantics for Online Phase ...
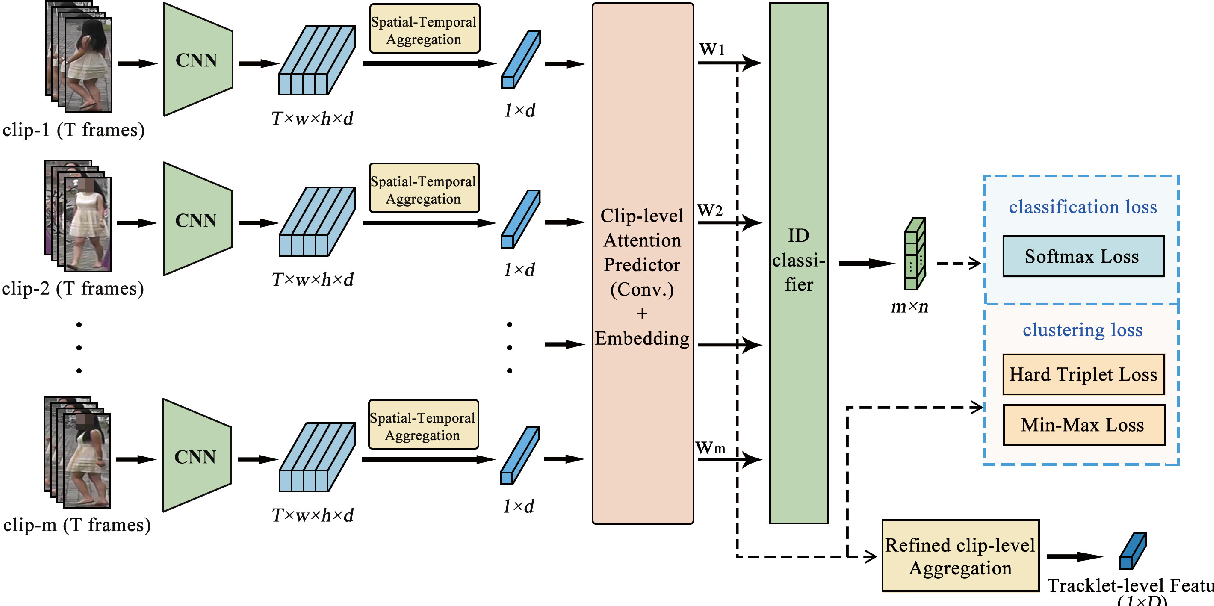
Figure 1 from Temporal Aggregation with Clip-level Attention for Video ...
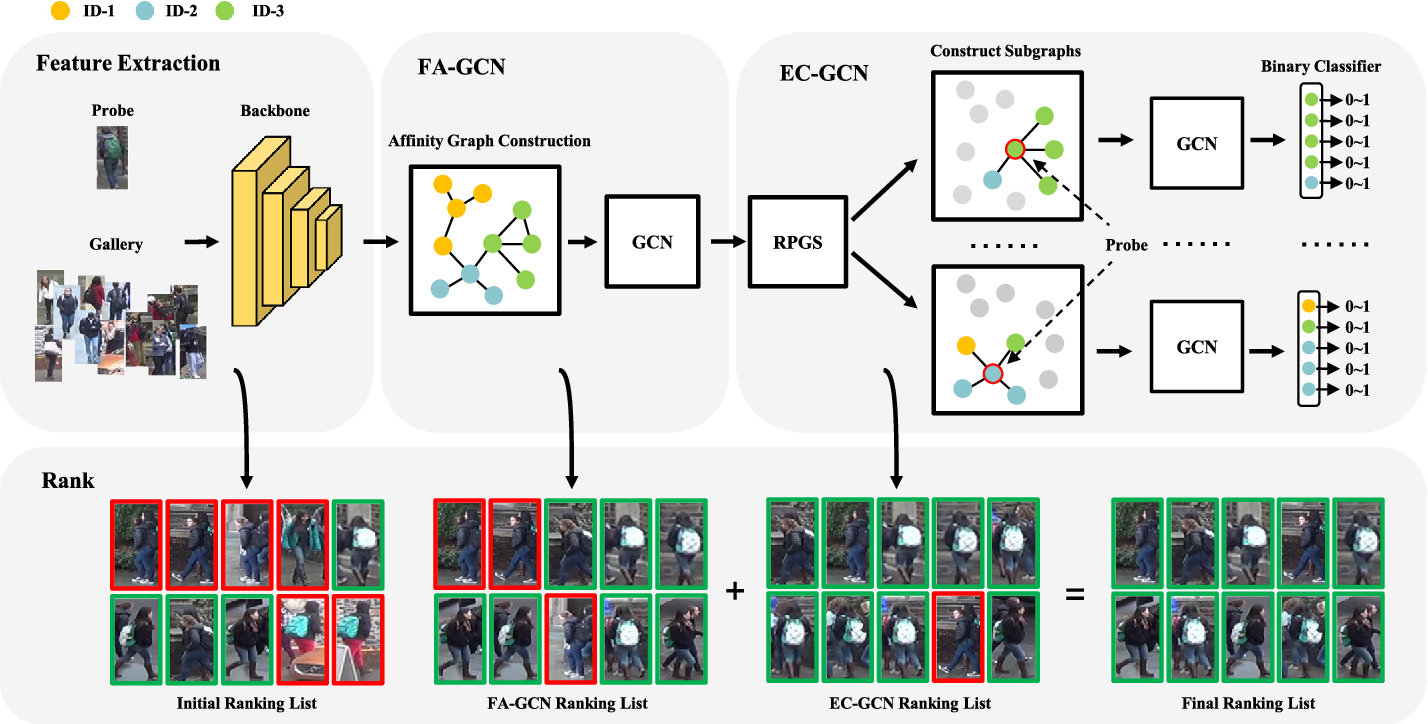
Figure 2 from Feature aggregation and connectivity for object re ...
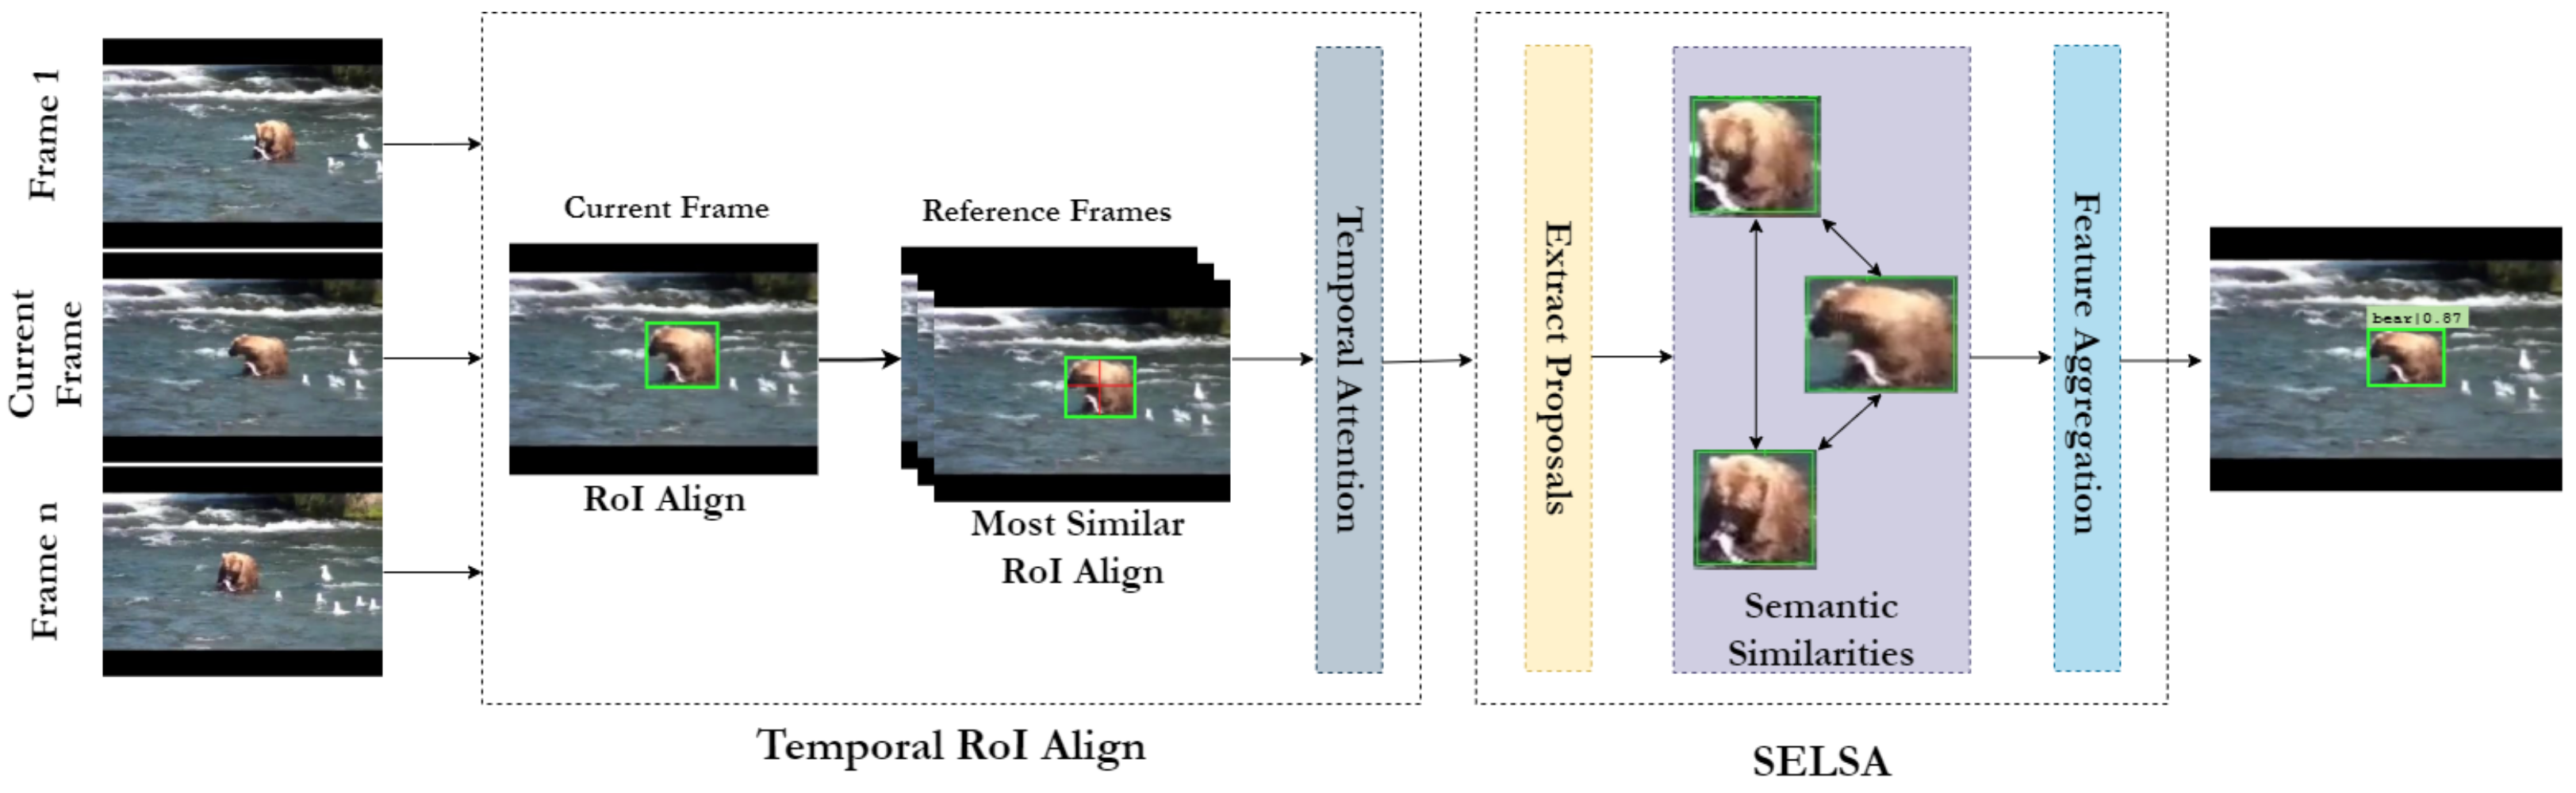
Attention-Guided Disentangled Feature Aggregation for Video Object ...
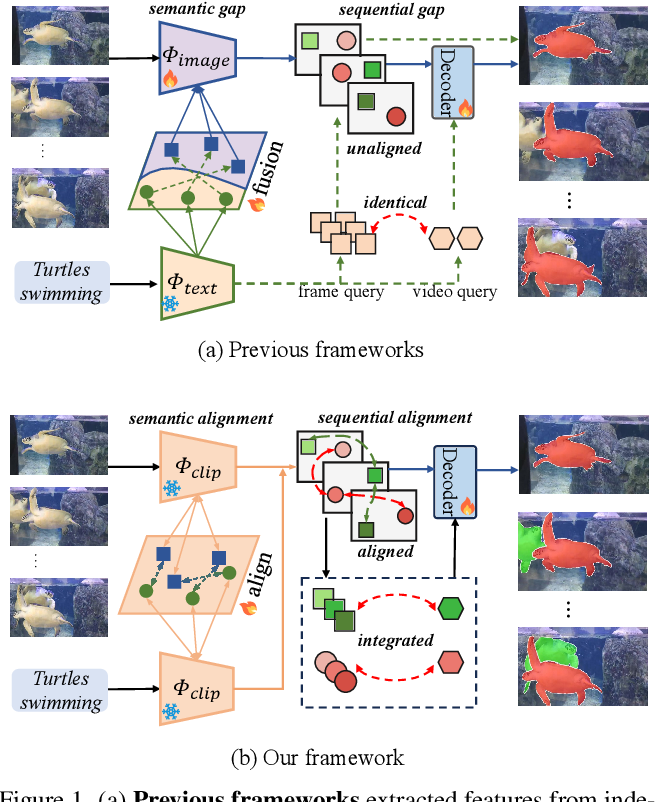
Figure 1 from Semantic and Sequential Alignment for Referring Video ...

Figure 5 from Attention-Guided Disentangled Feature Aggregation for ...
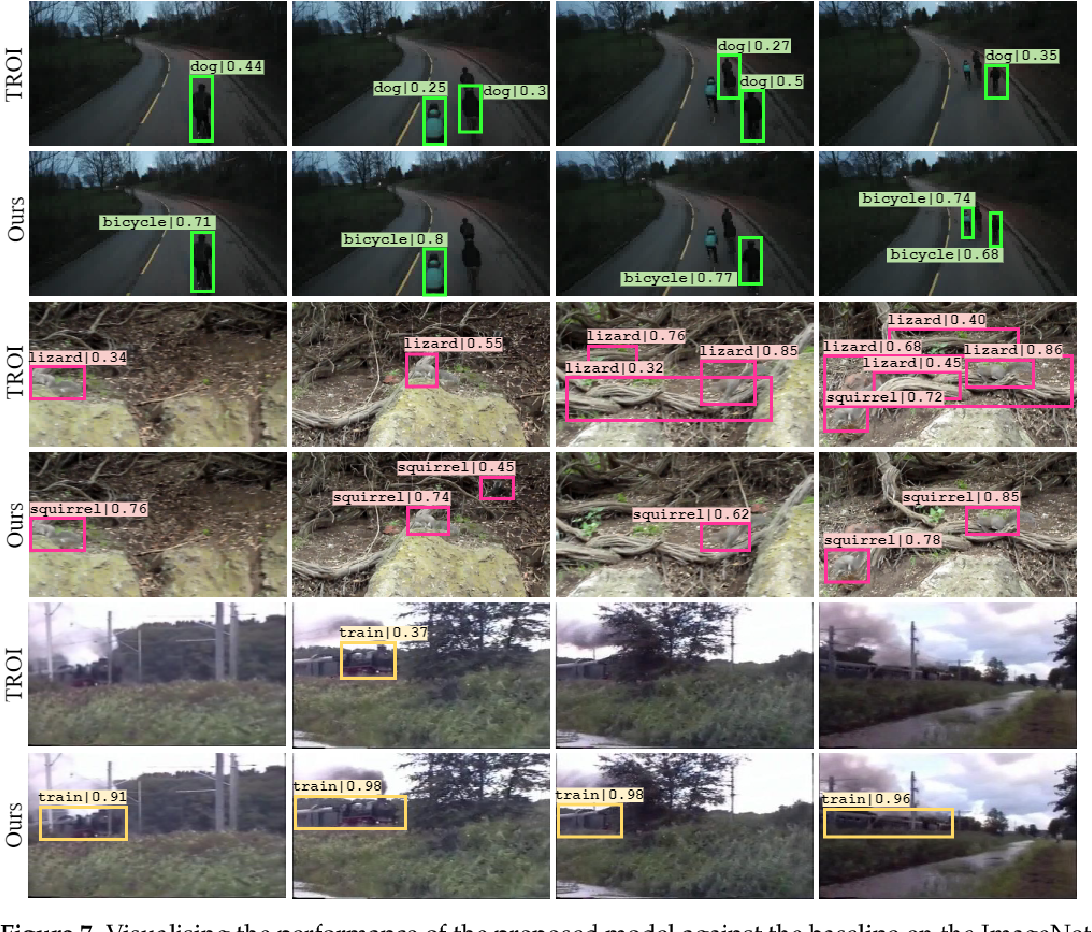
Figure 7 from Attention-Guided Disentangled Feature Aggregation for ...
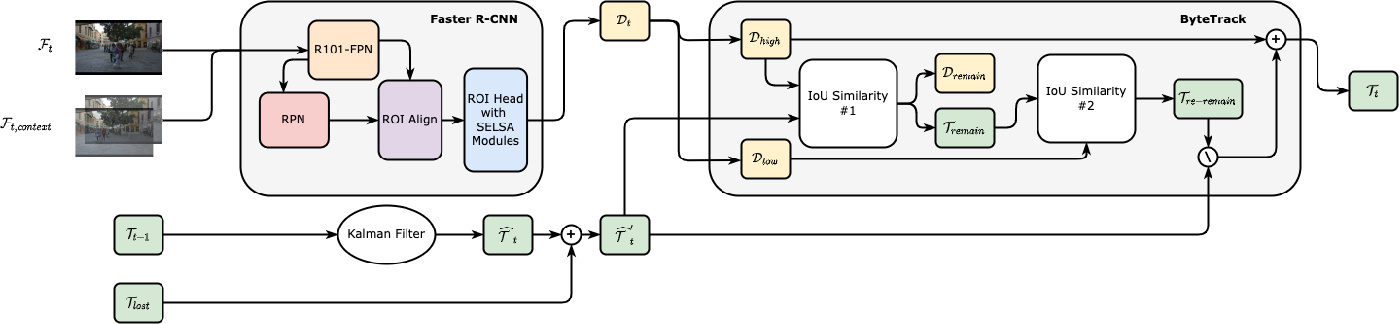
Figure 2 from SELSAMOT: Sequence-Level Semantic Aggregation for Multi ...

Figure 1 from Video Object Detection Using Object's Motion Context and ...

Figure 1 from Video Object Detection Using Object's Motion Context and ...
Advertisement Space (336x280)
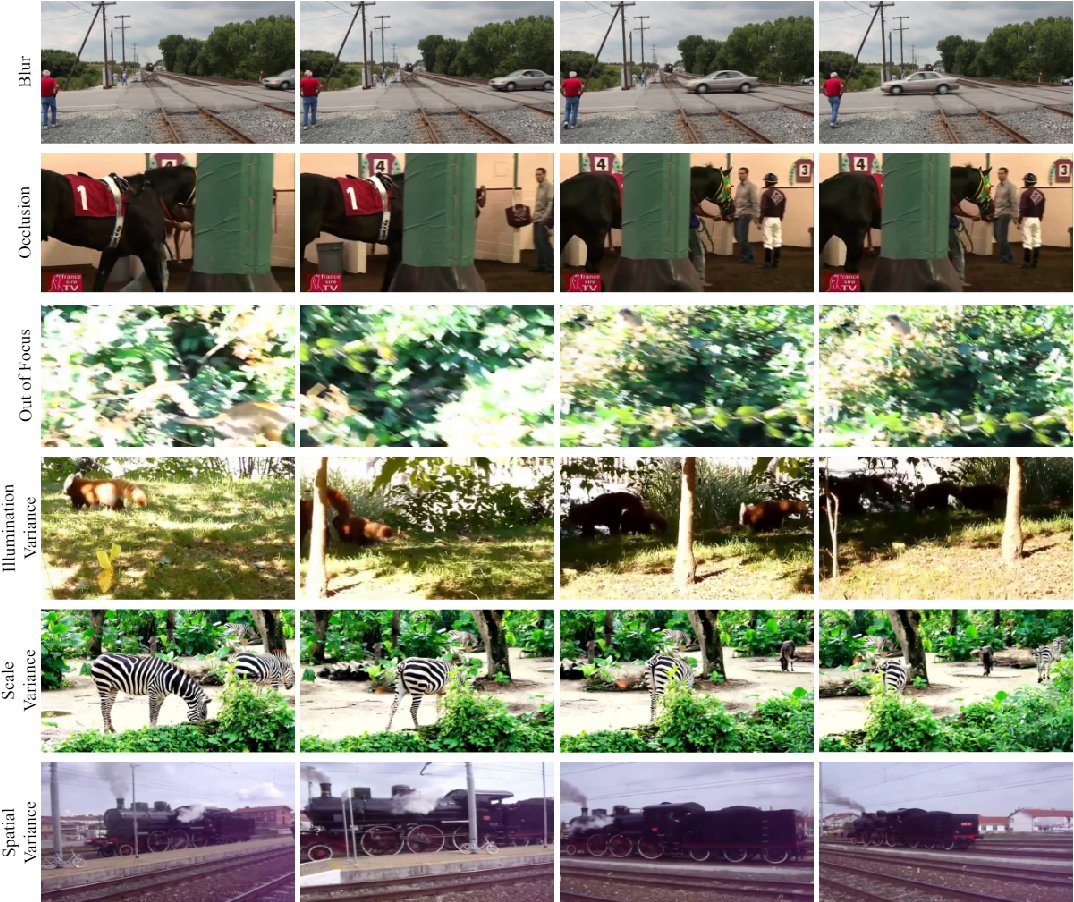
Figure 1 from Attention-Guided Disentangled Feature Aggregation for ...
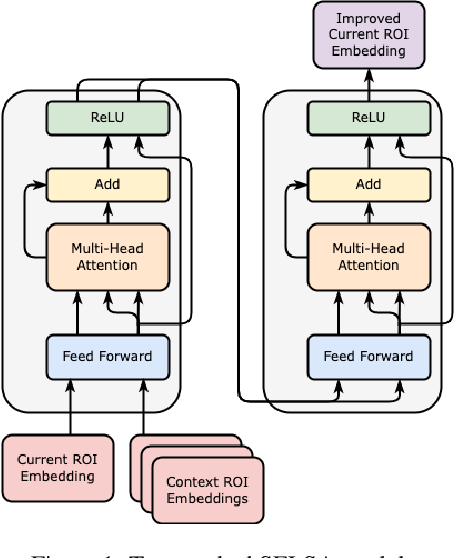
Figure 1 from SELSAMOT: Sequence-Level Semantic Aggregation for Multi ...

Figure 1 from Video Object Detection Using Object's Motion Context and ...
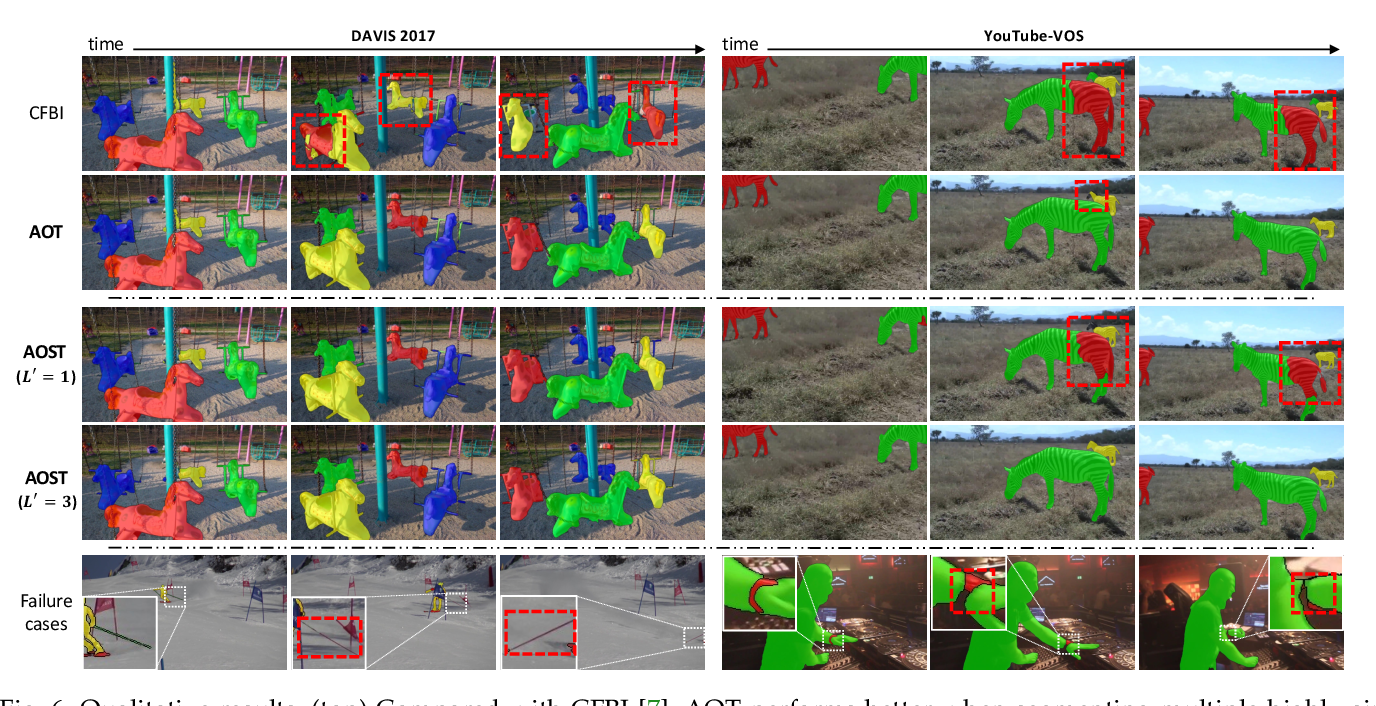
Figure 1 from Associating Objects with Scalable Transformers for Video ...

Figure 3 from Multi-Scale Feature Aggregation by Cross-Scale Pixel-to ...
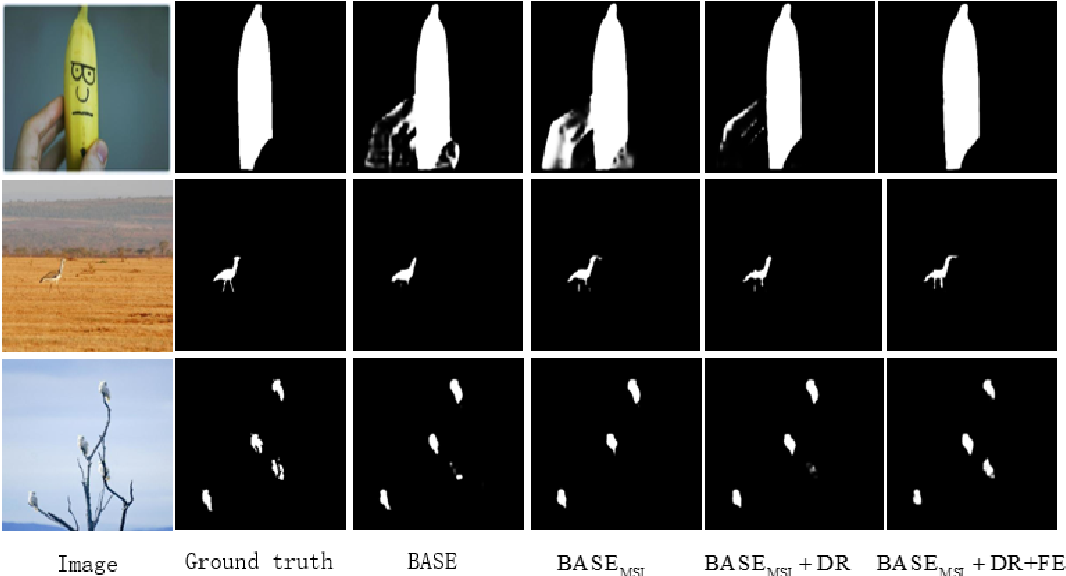
Figure 12 from Multistep feature aggregation framework for salient ...