
Figure 5 From Positional Label For Self Supervised Vision Transformer
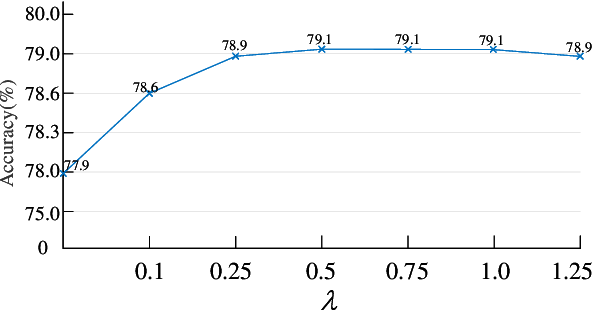
Figure 5 from Positional Label for Self-Supervised Vision Transformer ...

Figure 1 from Positional Label for Self-Supervised Vision Transformer ...
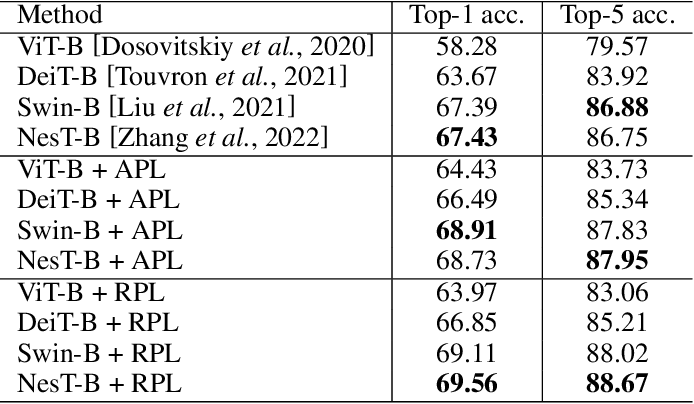
Table 5 from Positional Label for Self-Supervised Vision Transformer ...

Figure 2 from Positional Label for Self-Supervised Vision Transformer ...

Figure 4 from Positional Label for Self-Supervised Vision Transformer ...
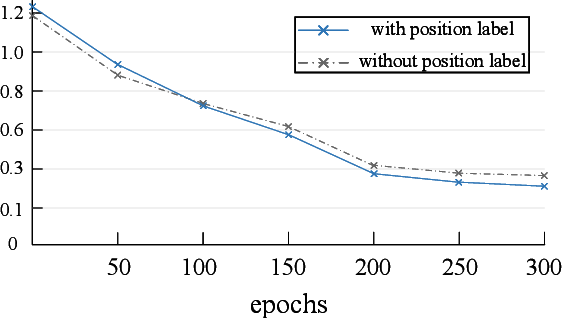
Figure 7 from Positional Label for Self-Supervised Vision Transformer ...
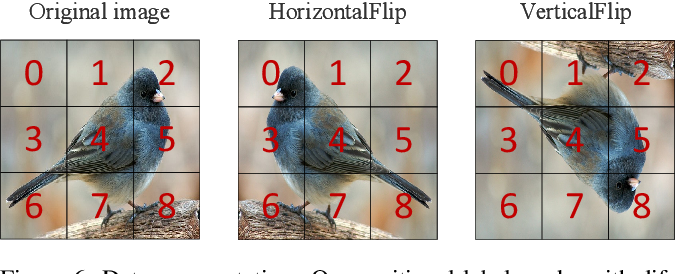
Figure 6 from Positional Label for Self-Supervised Vision Transformer ...
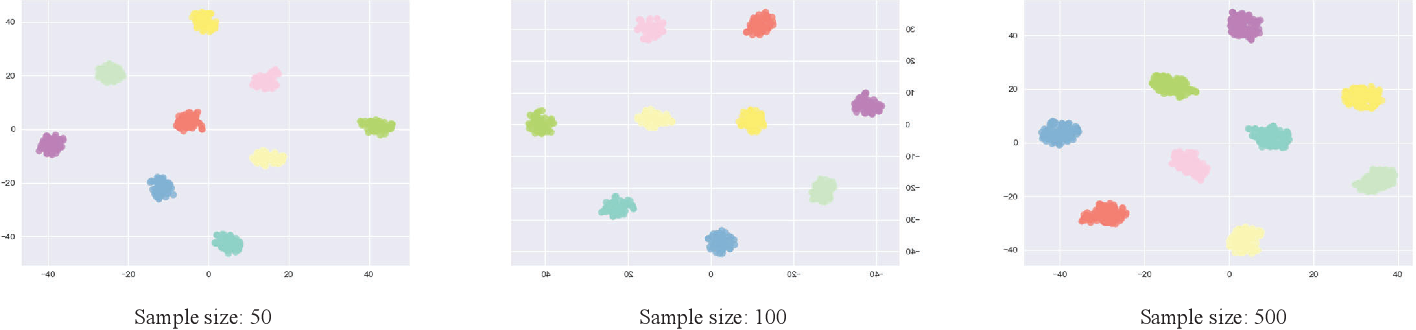
Figure 5 from Self-Supervised Vision Transformer for Intelligent Fault ...
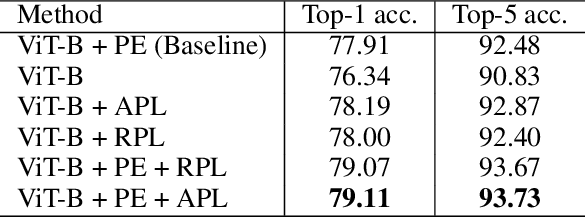
Table 1 from Positional Label for Self-Supervised Vision Transformer ...
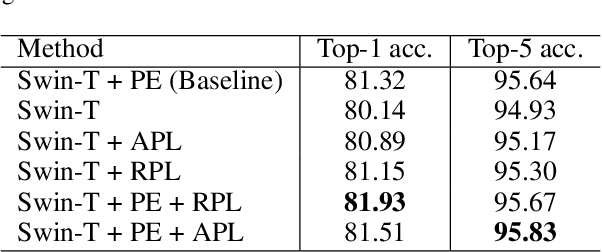
Table 2 from Positional Label for Self-Supervised Vision Transformer ...
Advertisement Space (300x250)
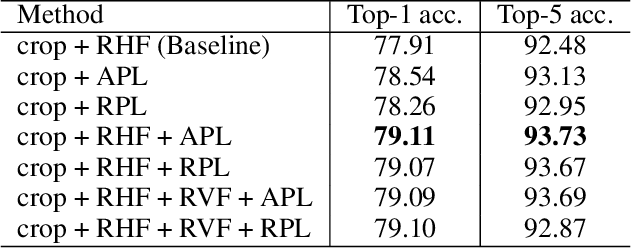
Table 3 from Positional Label for Self-Supervised Vision Transformer ...

Figure 5 from Self-supervised Vision Transformers for 3D Pose ...
Positional Label for Self-Supervised Vision Transformer | Underline

Figure 1 from SSVT: Self-Supervised Vision Transformer For Eye Disease ...
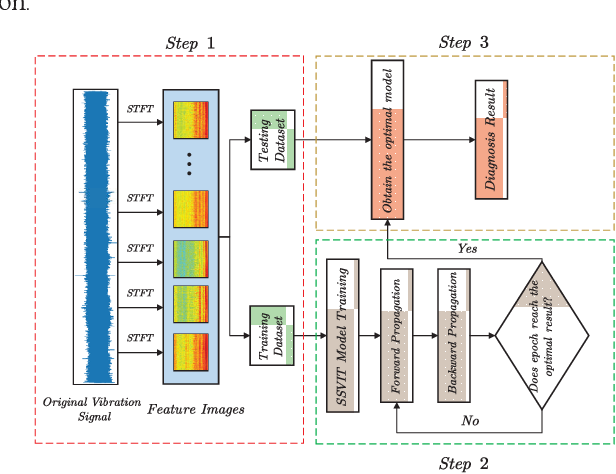
Figure 1 from Self-Supervised Vision Transformer for Intelligent Fault ...

Figure 2 from Self-Supervised Vision Transformer for Intelligent Fault ...

Figure 6 from Distilling Self-Supervised Vision Transformers for Weakly ...

Figure 1 from Pretraining the Vision Transformer using self-supervised ...

Figure 1 from RePre: Improving Self-Supervised Vision Transformer with ...

Figure 2 from Self-Supervised Pretraining Vision Transformer With ...
Advertisement Space (336x280)

Figure 1 from Self-supervised Vision Transformers for Land-cover ...

Transfer Learning With Self-Supervised Vision Transformer For Large ...

Position Labels for Self-Supervised Vision Transformer

Self-Supervised Vision Transformer for Enhanced Virtual Clothes Try-On

Slide-Transformer: Hierarchical Vision Transformer with Local Self ...

Learning Content and Positional Features for Object Detection via Self ...

Figure 1 from Semi-supervised Vision Transformers at Scale | Semantic ...

From Vision Transformer Paper to code

Lightweight Vision Transformer for Frame-Level Ergonomic Posture ...
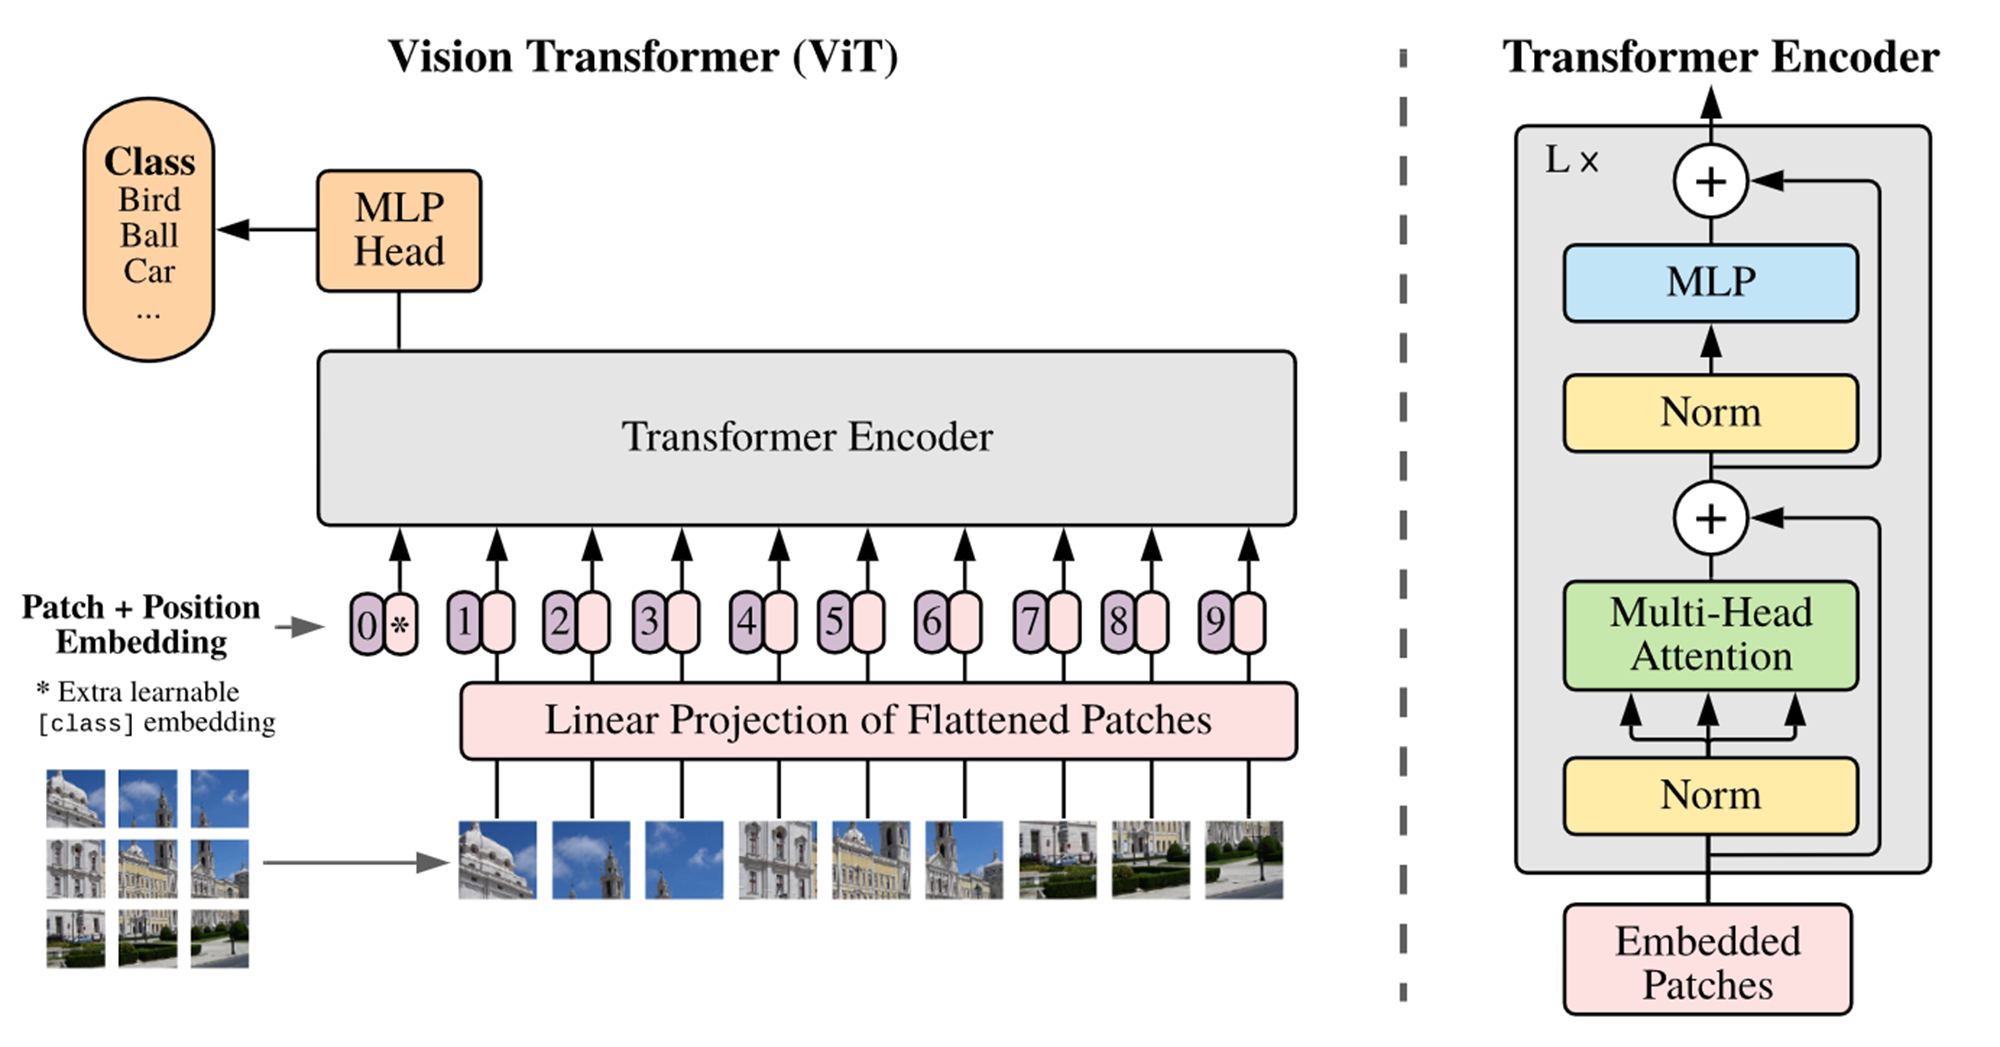
Vision Transformer (ViT) architecture.
Advertisement Space (336x280)

SiT: Self-supervised vIsion Transformer by Sara Atito et al. : r/arxiv ...

SiT: Self-supervised vIsion Transformer - 知乎

[논문 리뷰] Self-supervised Vision Transformer are Scalable Generative ...

Exploring Self-Supervised Vision Transformers for Gait Recognition in ...
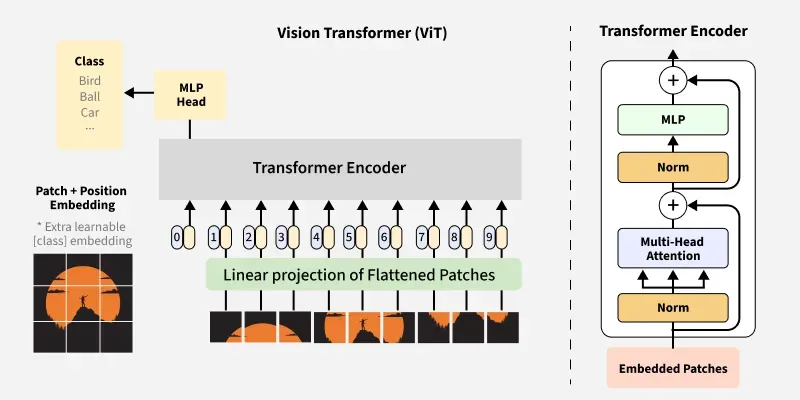
Vision Transformer in Computer Vision - GeeksforGeeks

Self-supervised vision Transformer (SiT) | Download Scientific Diagram