
Figure 5 From Video Action Segmentation Via Contextually Refined

Figure 5 from Video Action Segmentation via Contextually Refined ...
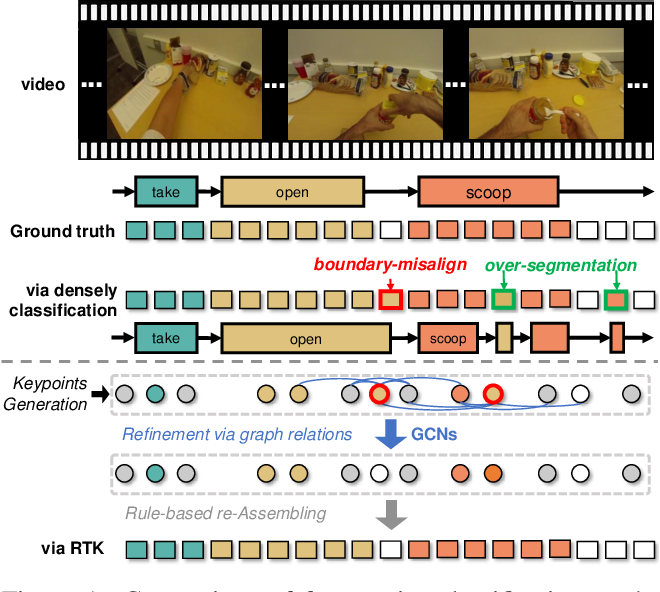
Figure 1 from Video Action Segmentation via Contextually Refined ...

Figure 2 from Video Action Segmentation via Contextually Refined ...

Figure 1 from Video Action Segmentation via Contextually Refined ...

Table 1 from Video Action Segmentation via Contextually Refined ...

Figure 5 from A Simple Image Segmentation Framework via In-Context ...

Figure 1 from Refining Action Segmentation with Hierarchical Video ...

Figure 1 from Refining Action Segmentation with Hierarchical Video ...

Figure 1 from Refining Action Segmentation with Hierarchical Video ...

Figure 1 from Refining Action Segmentation with Hierarchical Video ...
Advertisement Space (300x250)

Figure 1 from Domain Adaptive Video Segmentation via Temporal Pseudo ...

Figure 2 from Weakly-Supervised Action Segmentation and Alignment via ...

Figure 1 from Boosting Video Object Segmentation via Robust and ...

Figure 1 from Unsupervised method for video action segmentation through ...
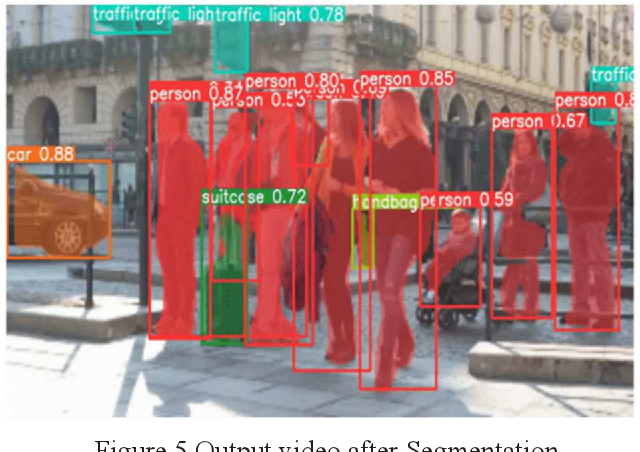
Figure 2 from Video Segmentation using YOLOv5 for Surveillance ...

Figure 5 from Refined Division Features Based on Transformer for ...

Figure 1 from Mirror Segmentation via Semantic-aware Contextual ...

Figure 1 from Unsupervised Action Segmentation by Joint Representation ...

Figure 1 from Multi-Modal Few-Shot Temporal Action Segmentation ...

Figure 3 from Self-Attention Based Action Segmentation Using Intra-And ...
Advertisement Space (336x280)

Figure 1 from Weakly-Supervised Online Action Segmentation in Multi ...

Figure 7 from A Simple Image Segmentation Framework via In-Context ...

Figure 1 from Activity Grammars for Temporal Action Segmentation ...
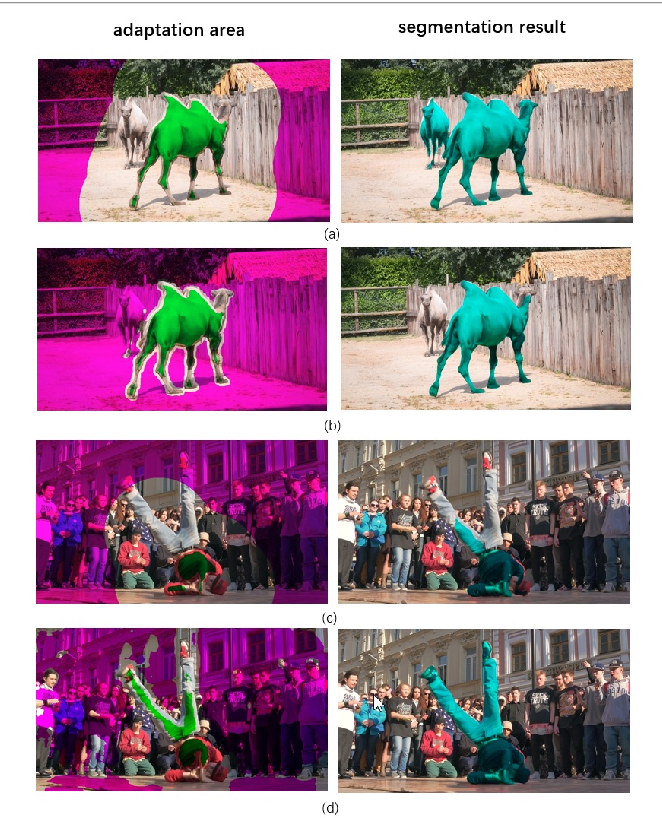
Figure 1 from Adaptive ROI Generation for Video Object Segmentation ...
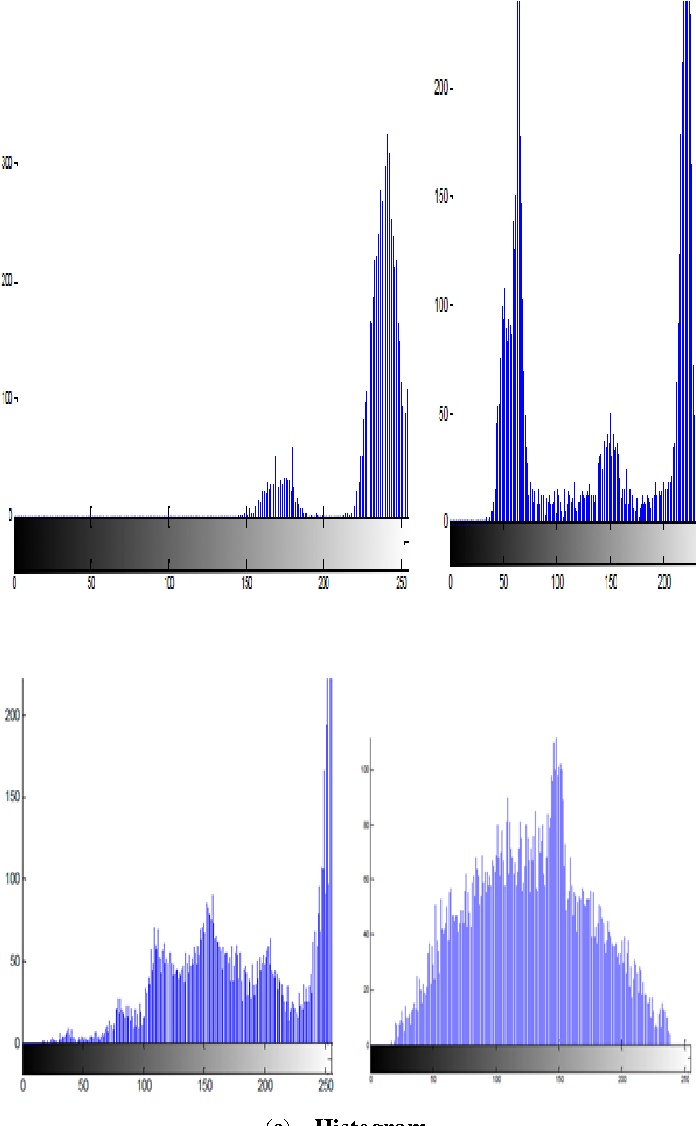
Figure 5 from Segmentation of Textile Textures using Contextual ...

Figure 1 from Guided Interactive Video Object Segmentation Using ...

Figure 3 from Mirror Segmentation via Semantic-aware Contextual ...

Figure 2 from Self-Attention Based Action Segmentation Using Intra-And ...

Figure 1 from Real-time High-Resolution Video Object Segmentation ...

Figure 4 from Mirror Segmentation via Semantic-aware Contextual ...
Advertisement Space (336x280)

Multi-Modal Human Action Segmentation Using Skeletal Video Ensembles

Efficient Temporal Action Segmentation via Boundary-aware Query Voting ...

Figure 6 from How Much Temporal Long-Term Context is Needed for Action ...

[논문 리뷰] Joint Self-Supervised Video Alignment and Action Segmentation
Action Segmentation , Pose-aware video action segmentation – IPRH

Efficient Temporal Action Segmentation via Boundary-aware Query Voting ...