
Fine Tune Large Language Models With Reinforcement Learning From Human

Fine-tune large language models with reinforcement learning from human ...

Fine-tune large language models with reinforcement learning from human ...
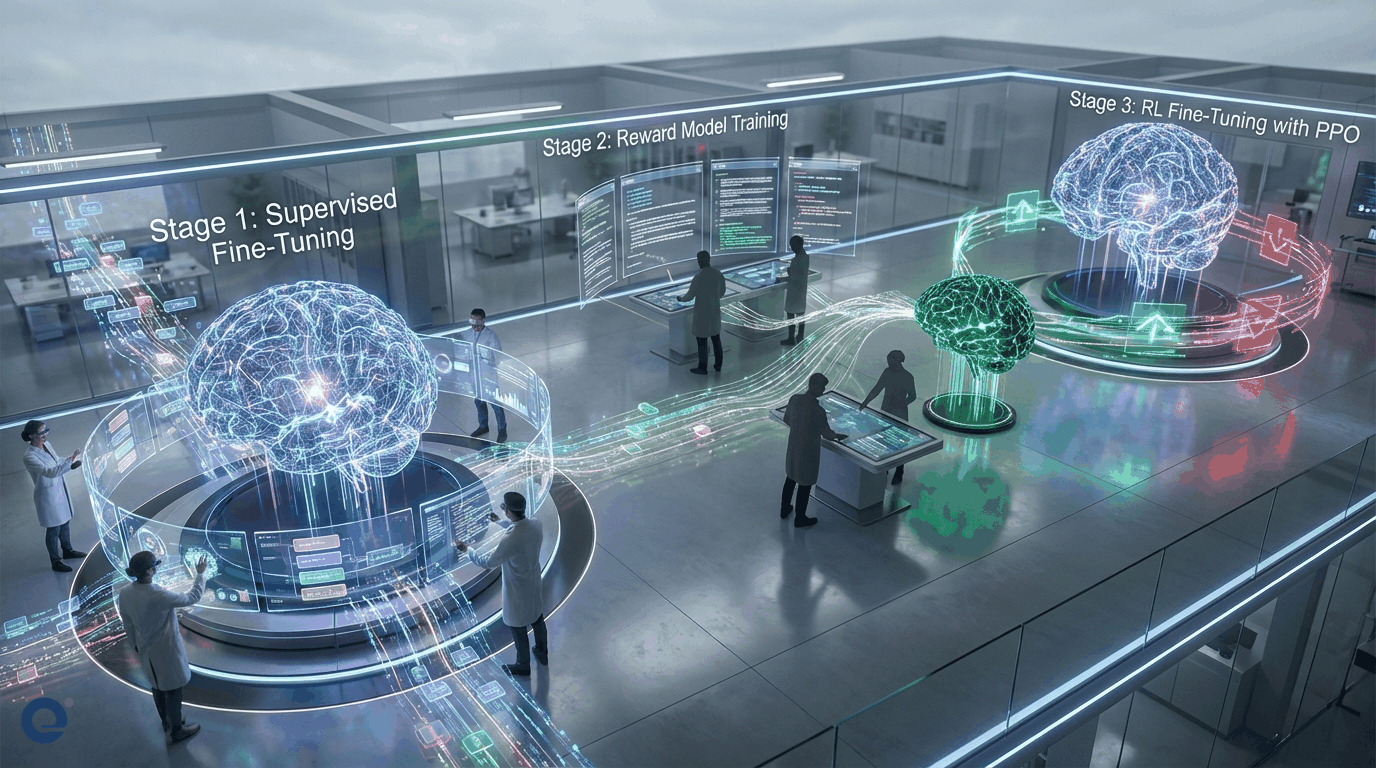
Reinforcement learning from human feedback for fine tuning large models ...

Aligning Language Models with Offline Reinforcement Learning from Human ...

Reinforcement learning from human feedback for fine tuning large models ...

Fine Tuning Large Language Models(LLM) | Reinforcement Learning from ...
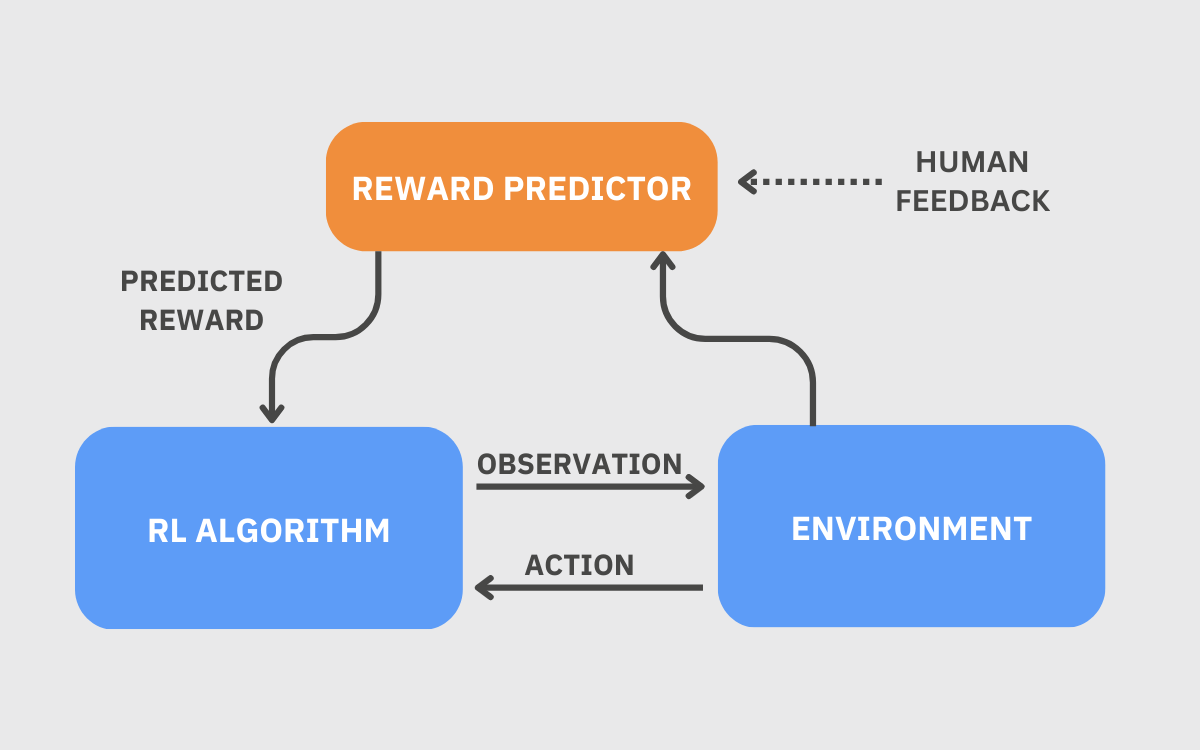
Using reinforcement learning from human feedback to fine-tune large ...
Using reinforcement learning from human feedback to fine-tune large ...

Improving Large Language Models via Fine-grained Reinforcement Learning ...

Fine-tuning Large Language Models with Human-inspired Learning ...
Advertisement Space (300x250)

How to Fine-Tune Small Language Models to Think with Reinforcement Learning

Improving Large Language Models via Fine-grained Reinforcement Learning ...

Reinforcement Learning for Large Language Models
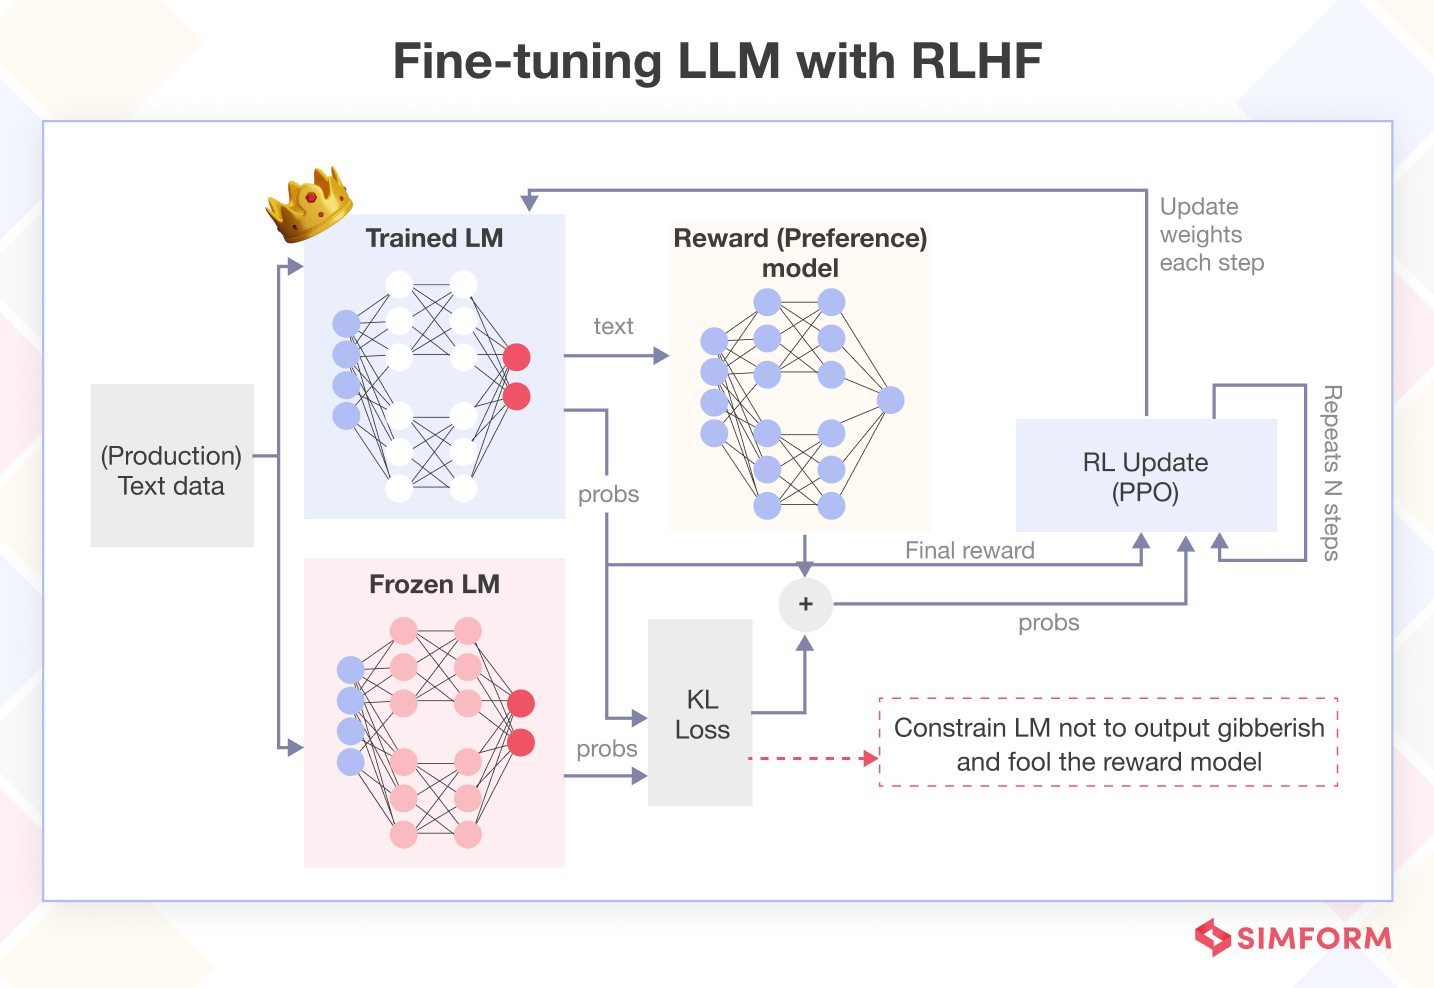
What is Reinforcement Learning from Human Feedback (RLHF)?
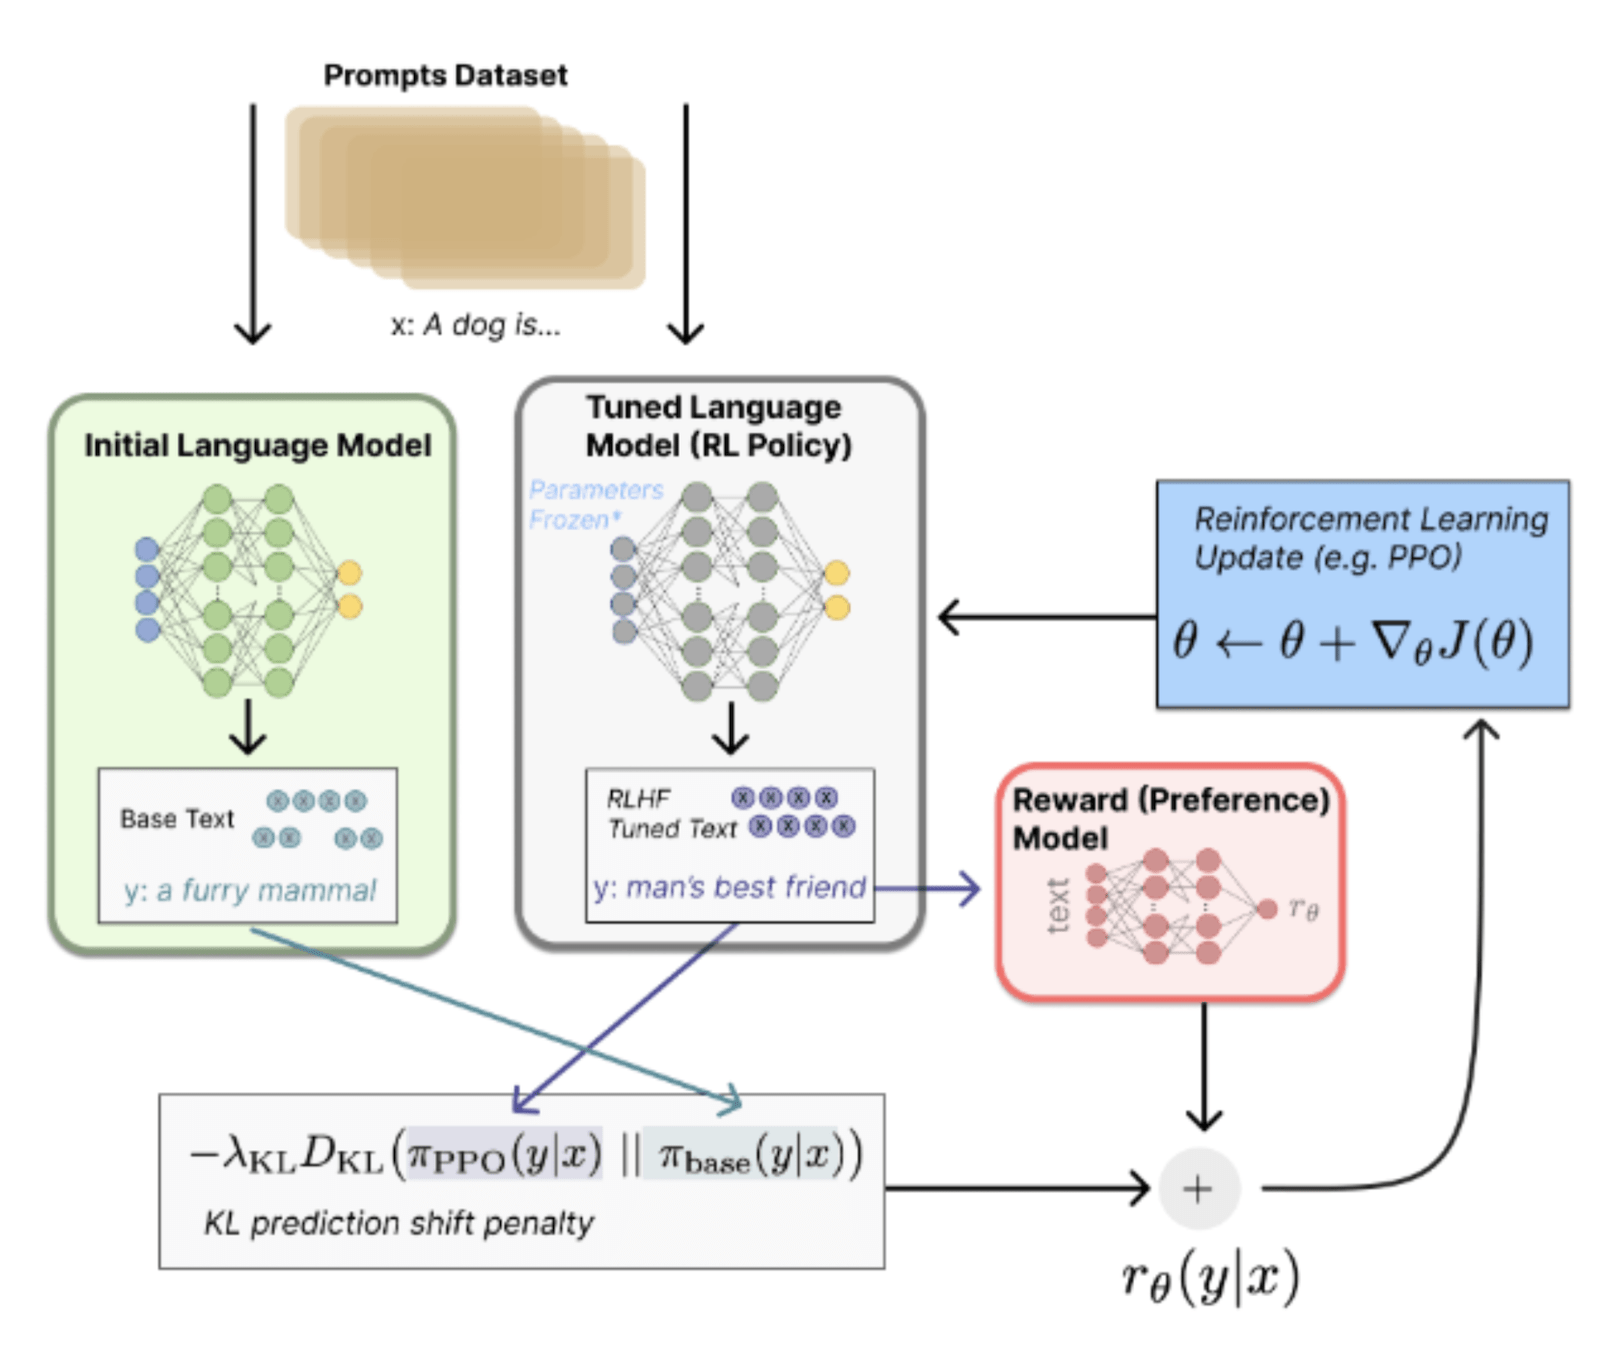
Reinforcement Learning from Human Feedback (RLHF) for LLMs - deepsense.ai

Reinforcement Learning from Human Feedback (RLHF)

The AiEdge+: How to fine-tune Large Language Models with Intermediary ...
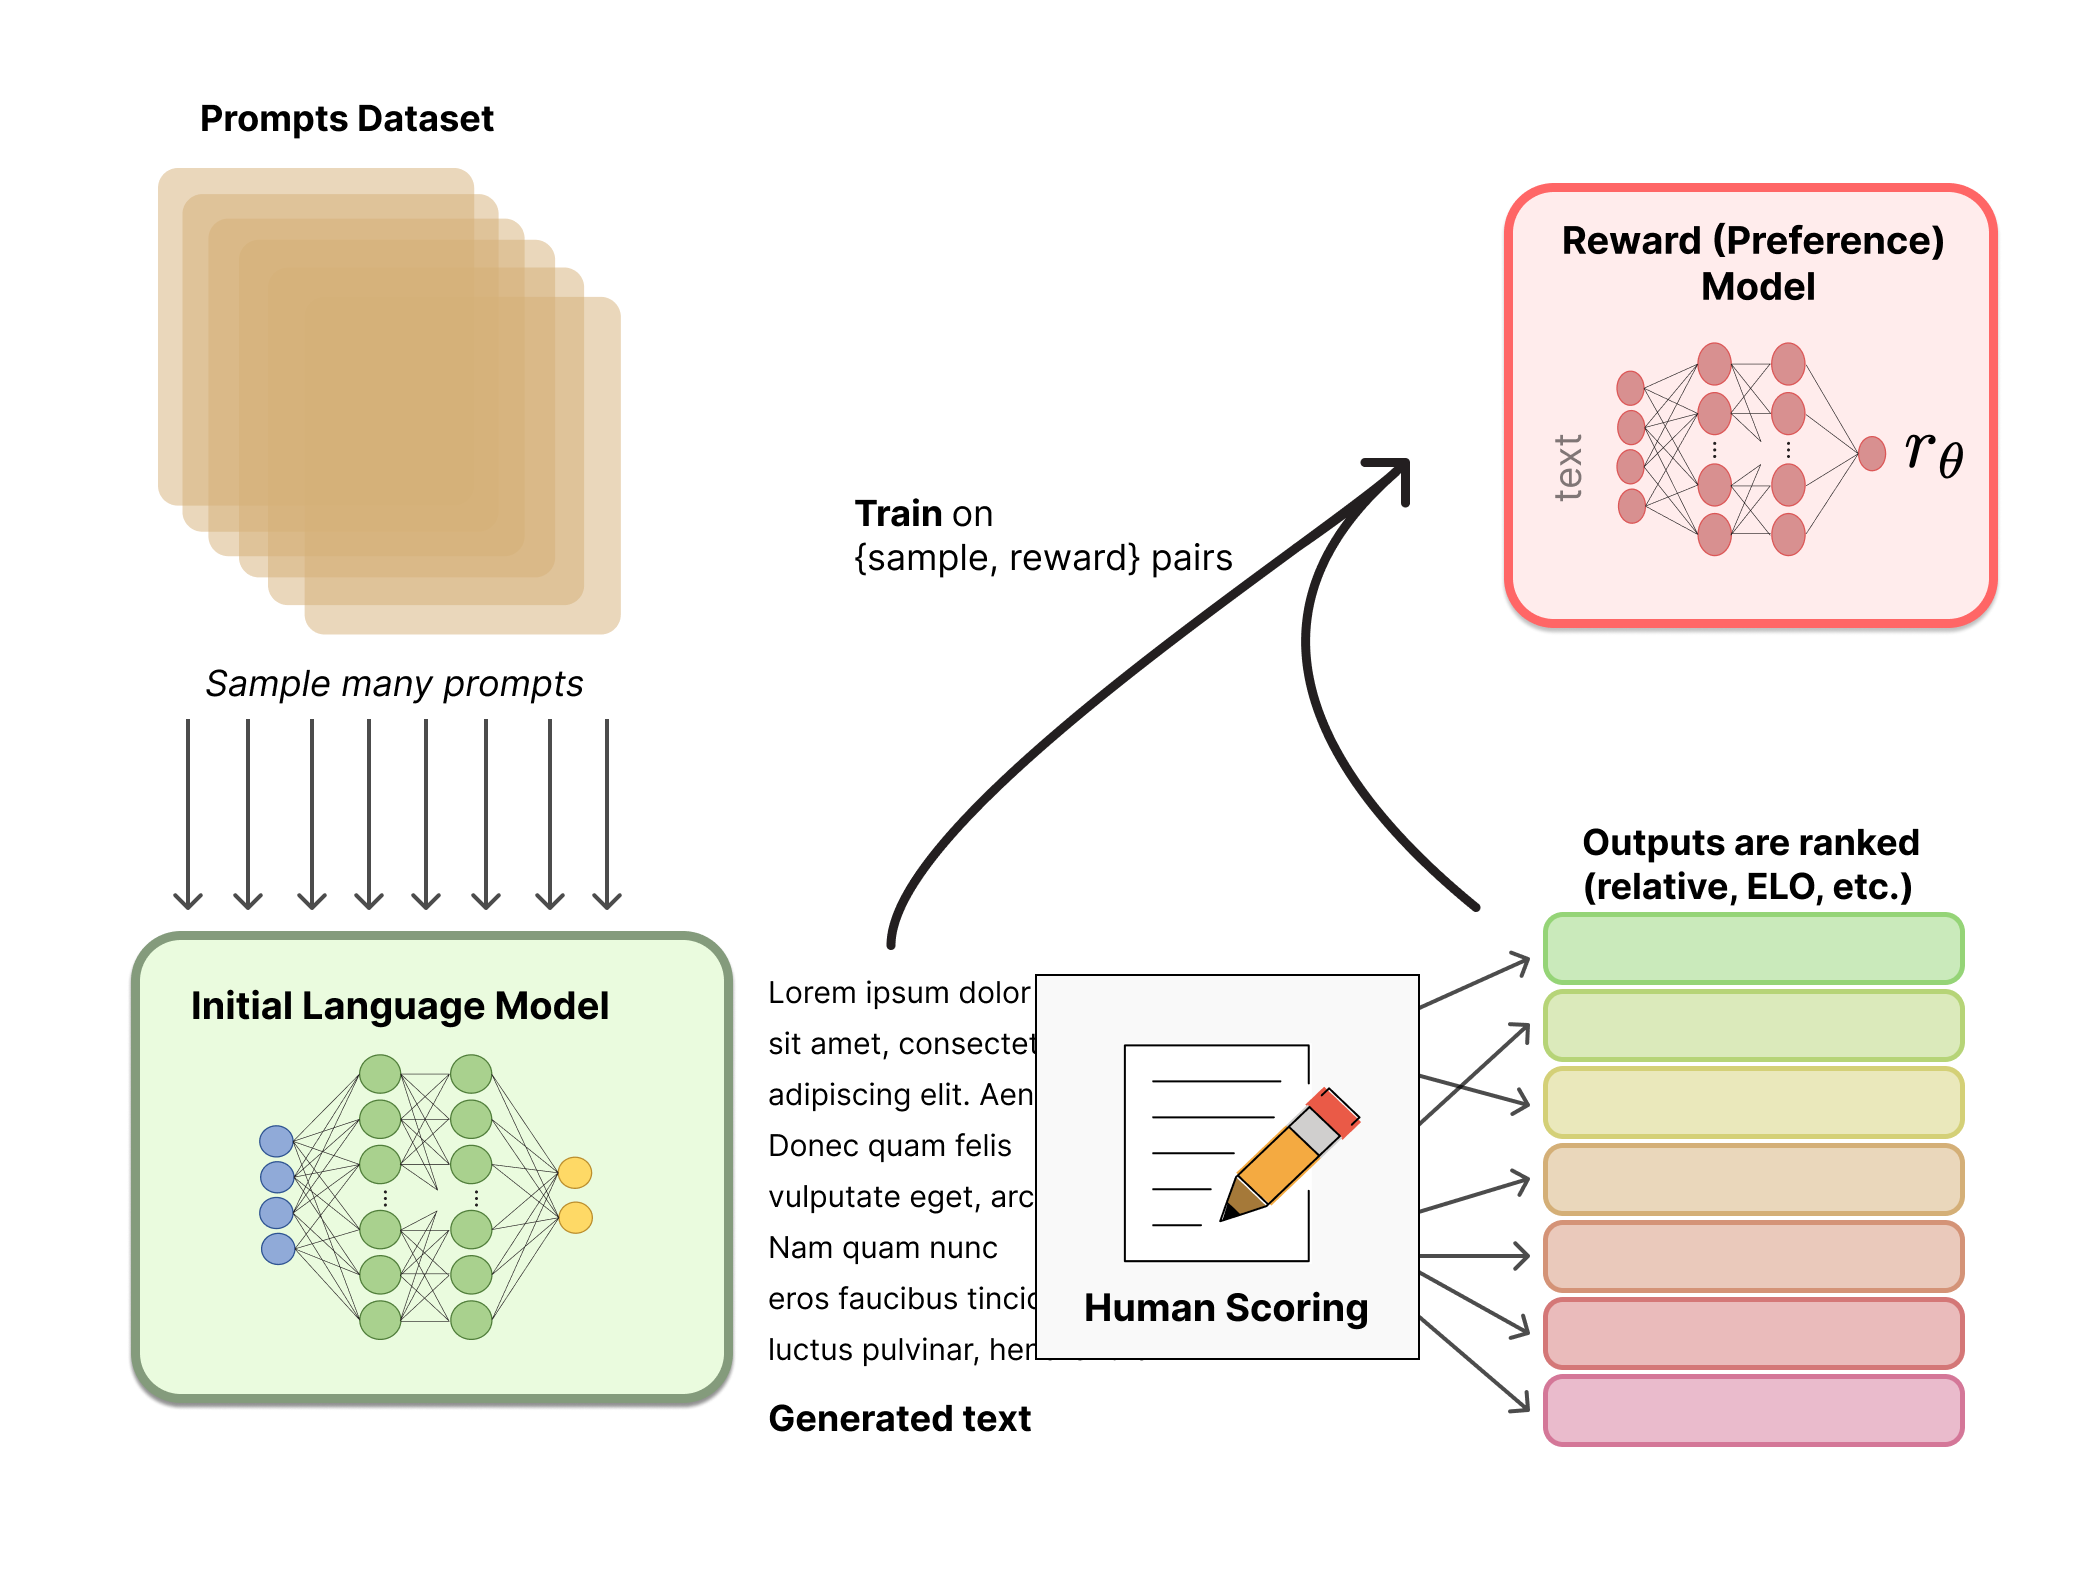
Illustrating Reinforcement Learning from Human Feedback (RLHF)
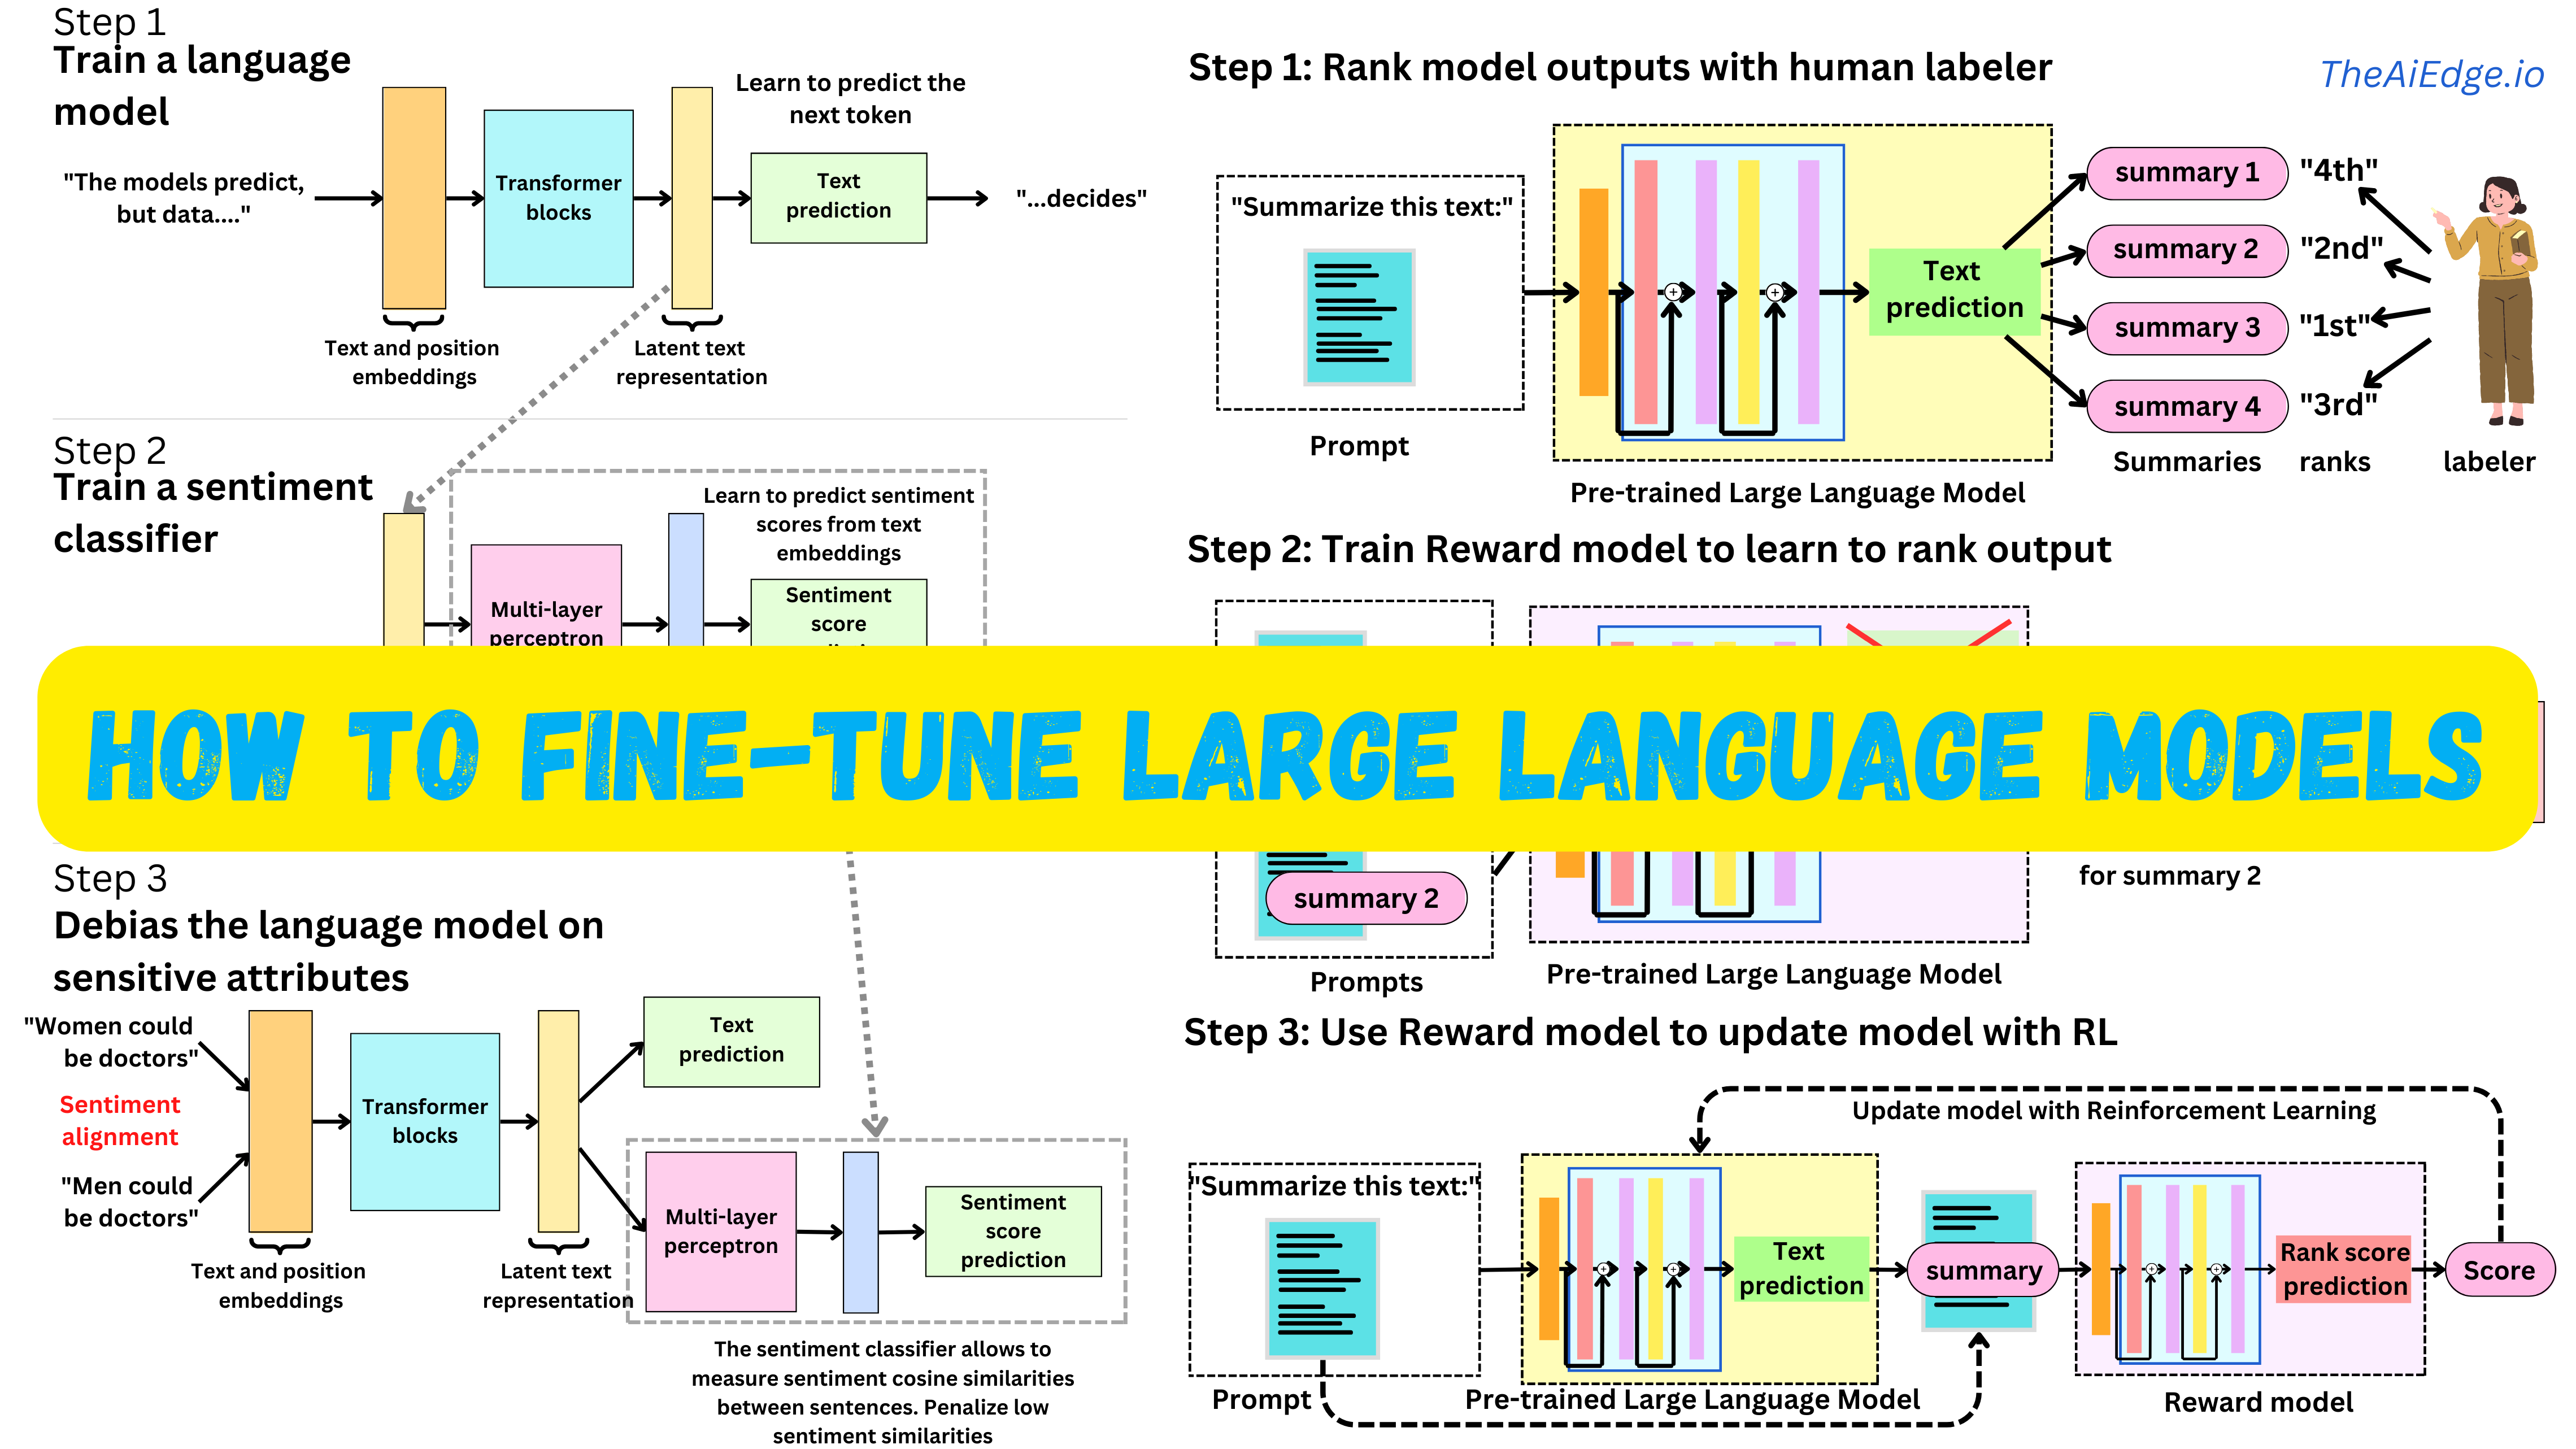
The AiEdge+: How to fine-tune Large Language Models with Intermediary ...

Reinforcement Learning from Human Feedback (RLHF) - a simplified ...
Advertisement Space (336x280)

The AiEdge+: How to fine-tune Large Language Models with Intermediary ...

The AiEdge+: How to fine-tune Large Language Models with Intermediary ...

A Comprehensive Guide to Reinforcement Learning from Human Feedback for ...

Transfer Learning for Finetuning Large Language Models | AI Research ...
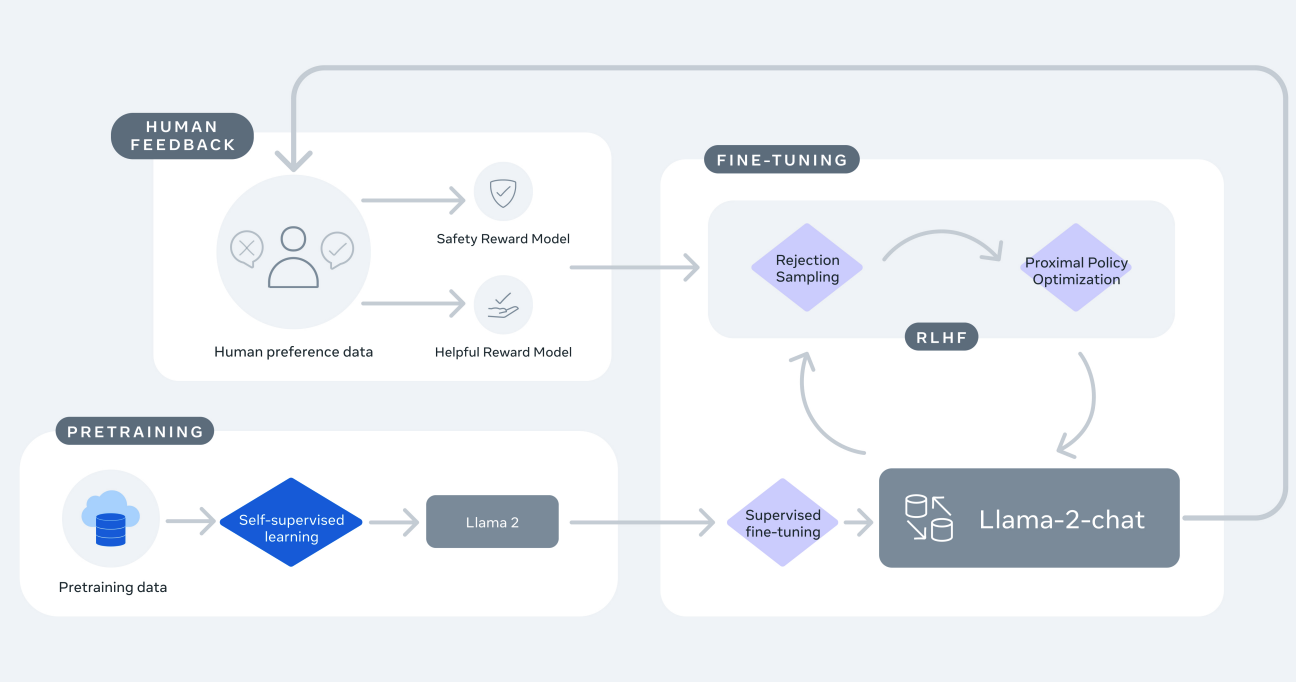
Reinforcement Learning from Human Feedback (RLHF) | Niklas Heidloff

Reinforcement learning from human feedback | Sai's Notebook
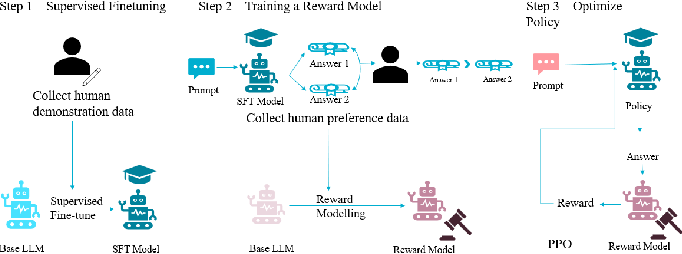
Figure 1 from Enhancing Large Language Model Performance with ...

Reinforcement Learning with Human Feedback (RLHF) - How to train and ...
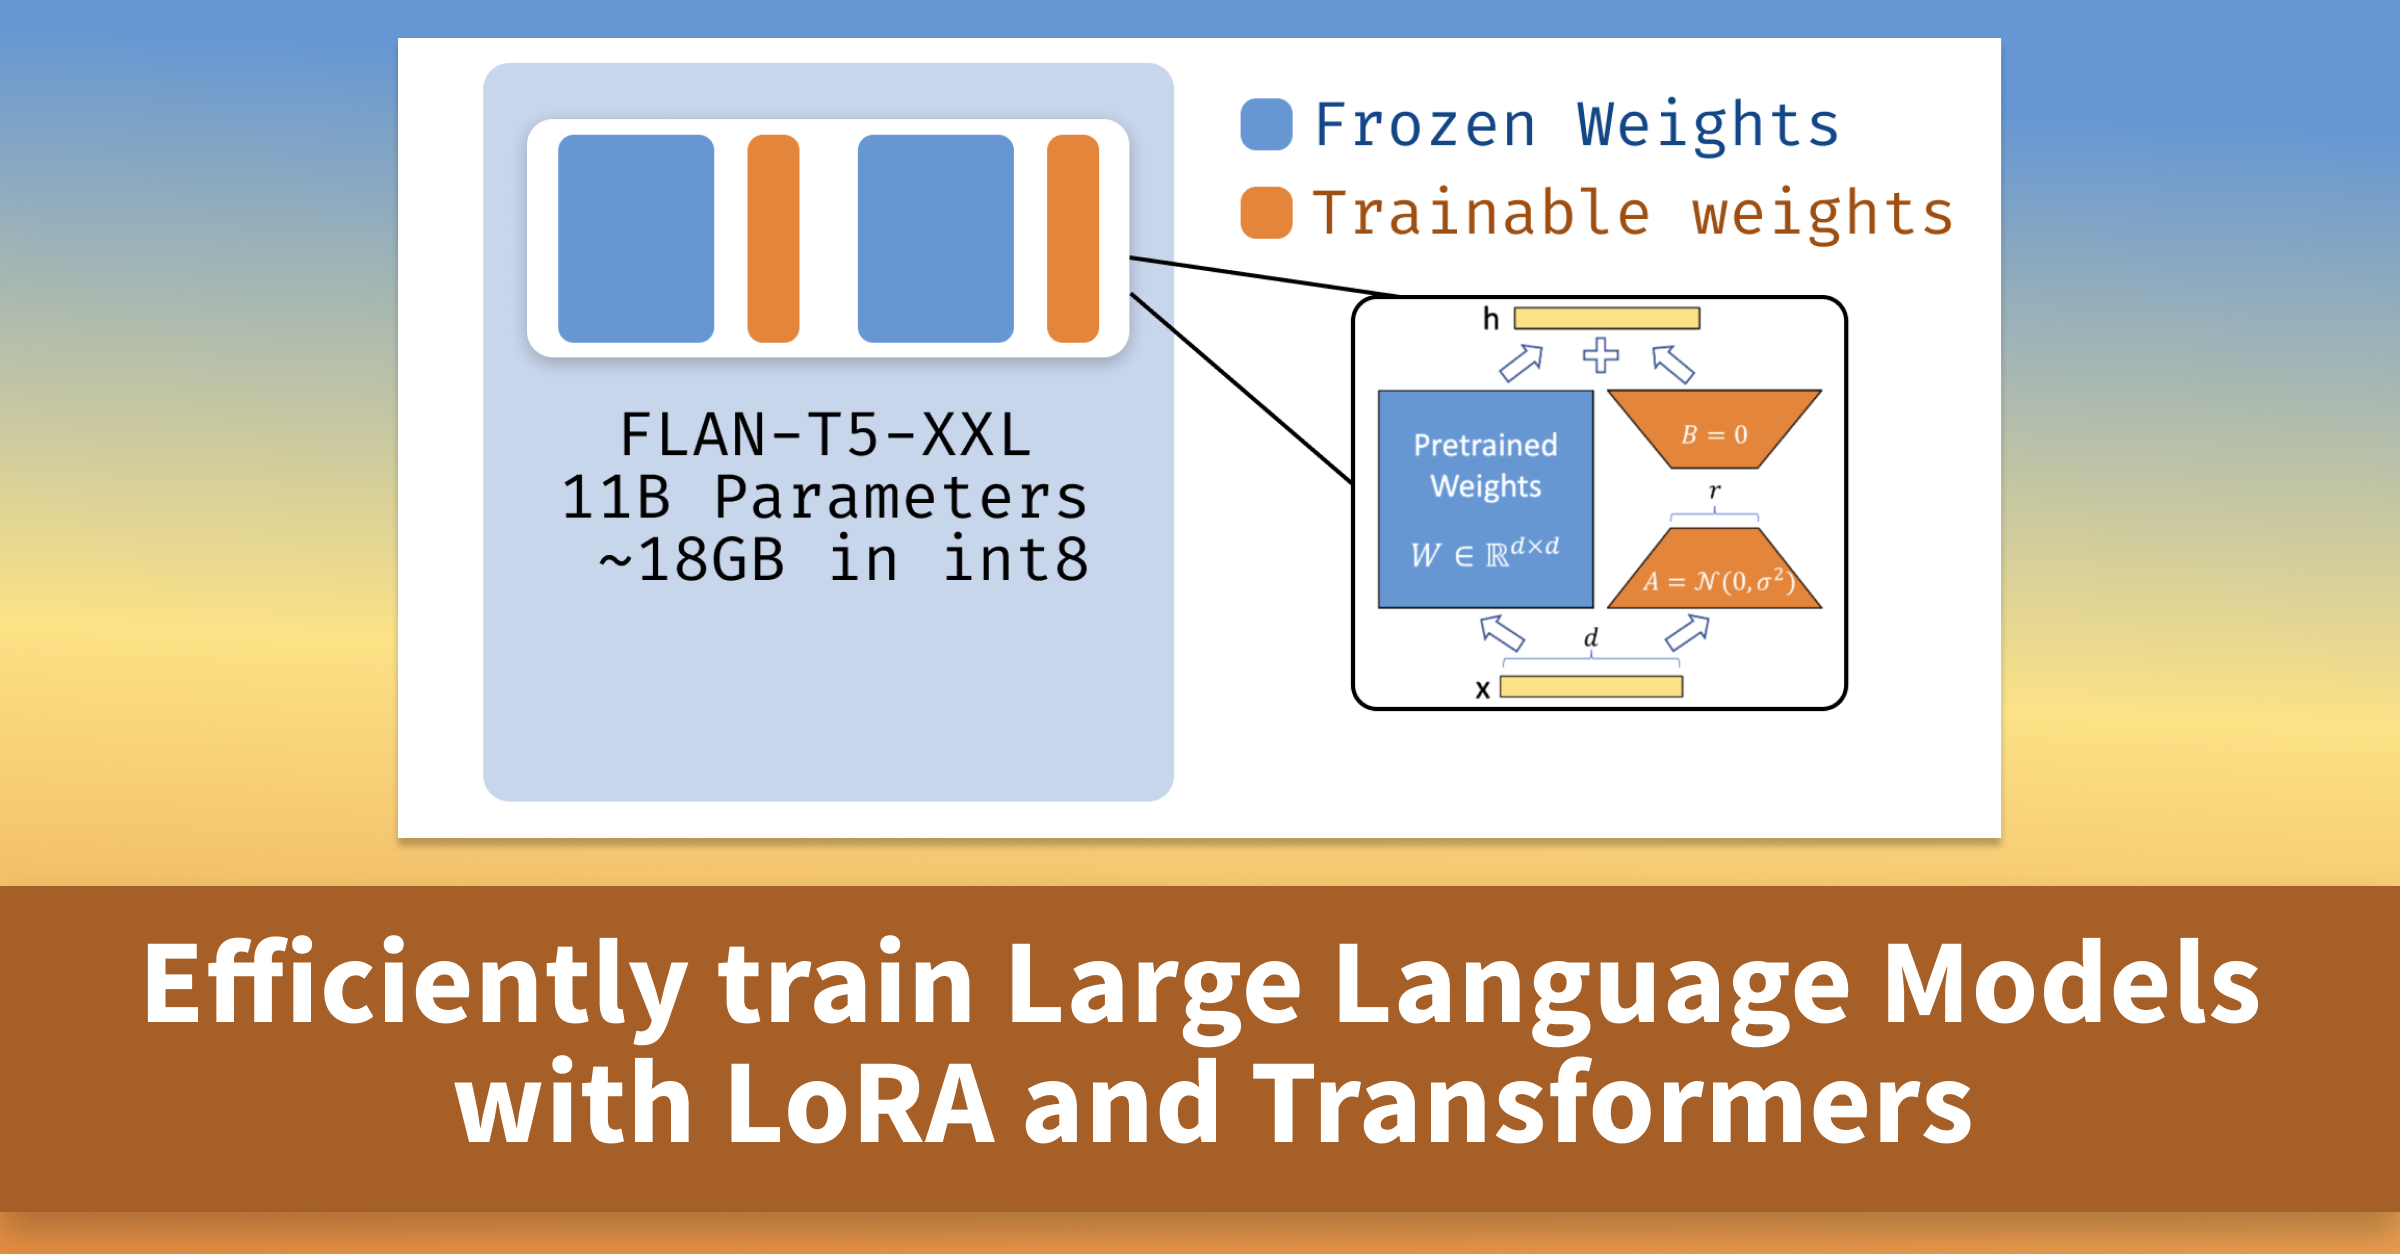
Illustrating Reinforcement Learning from Human Feedback (RLHF)

Reinforcement Learning Meets Large Language Models: A New Era of AI
Advertisement Space (336x280)
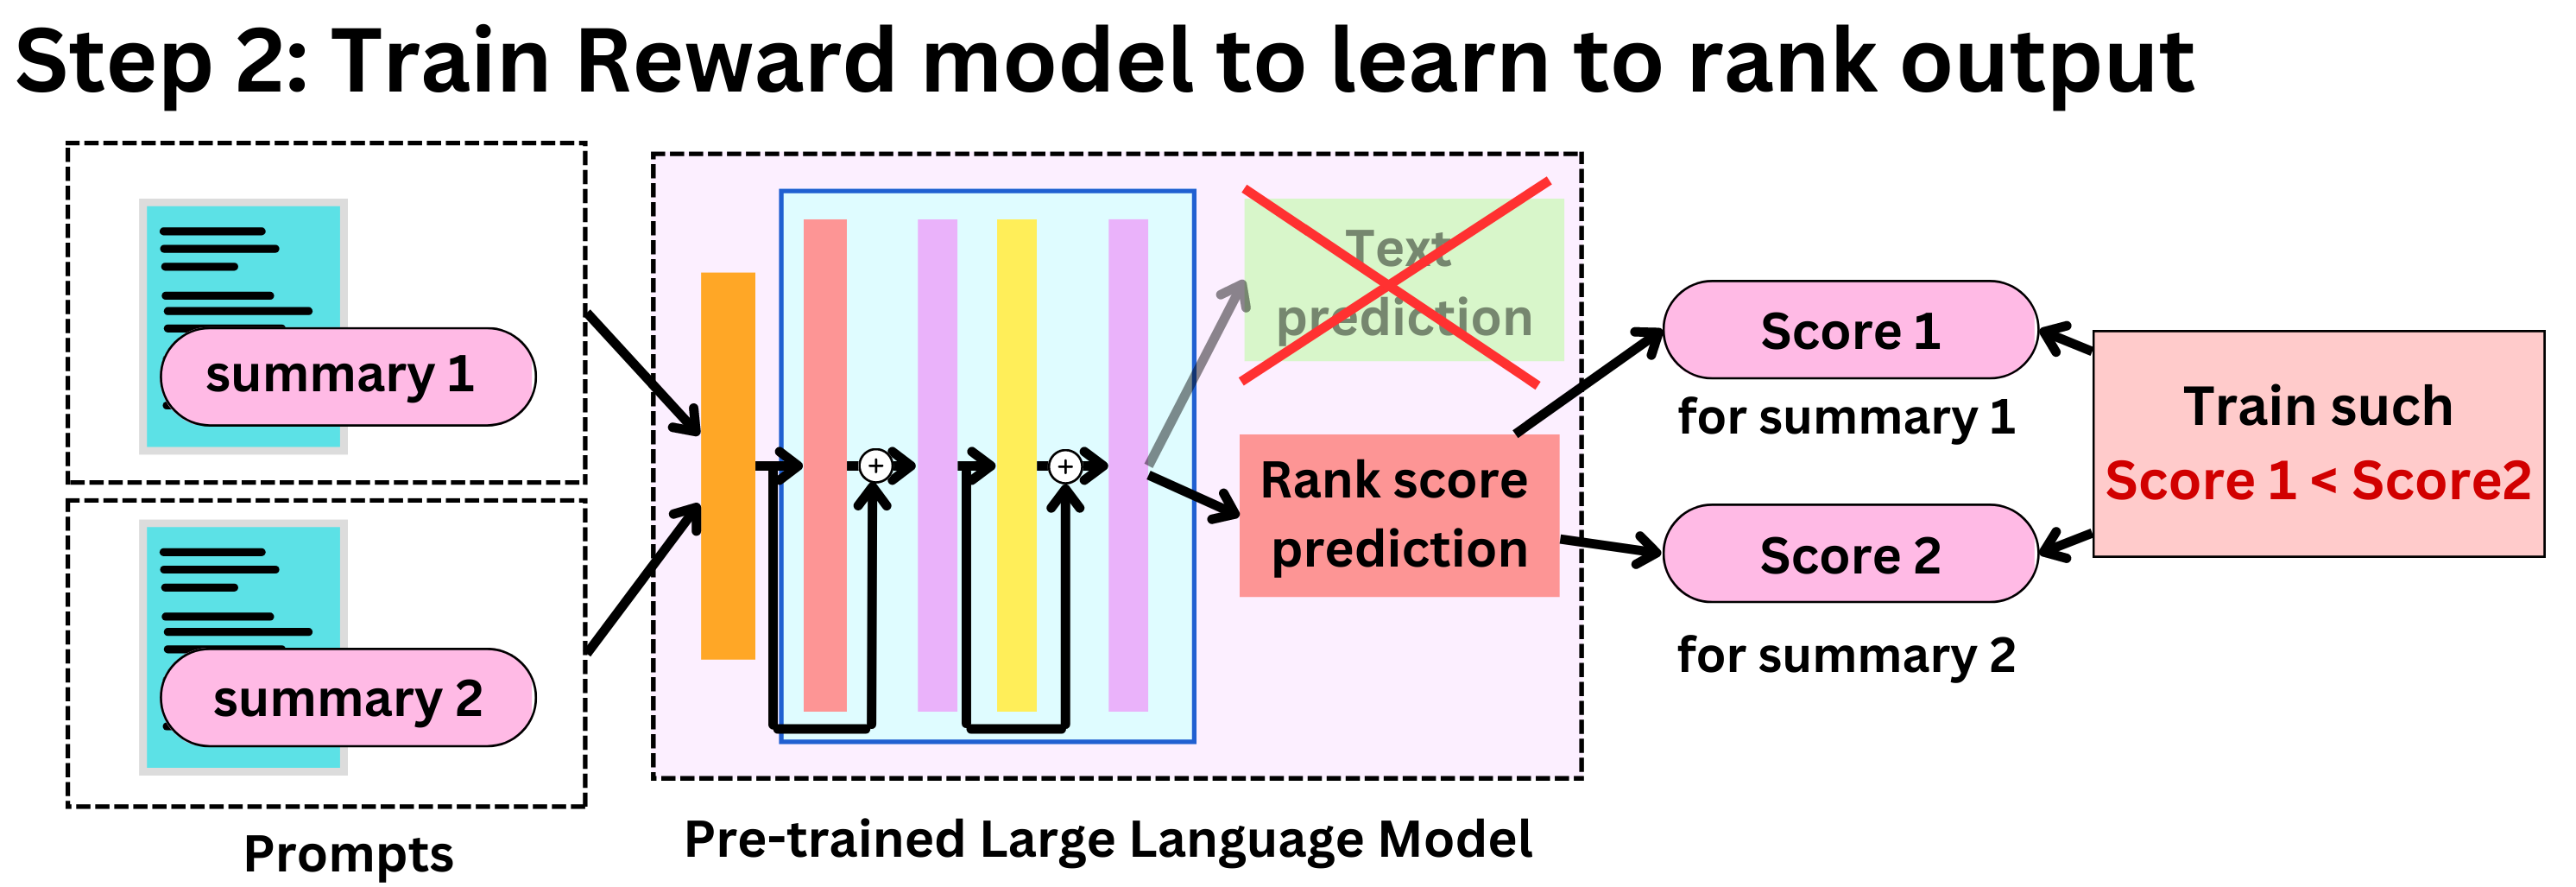
The AiEdge+: How to fine-tune Large Language Models with Intermediary ...

Reinforcement Learning for tuning language models ( how to train ...
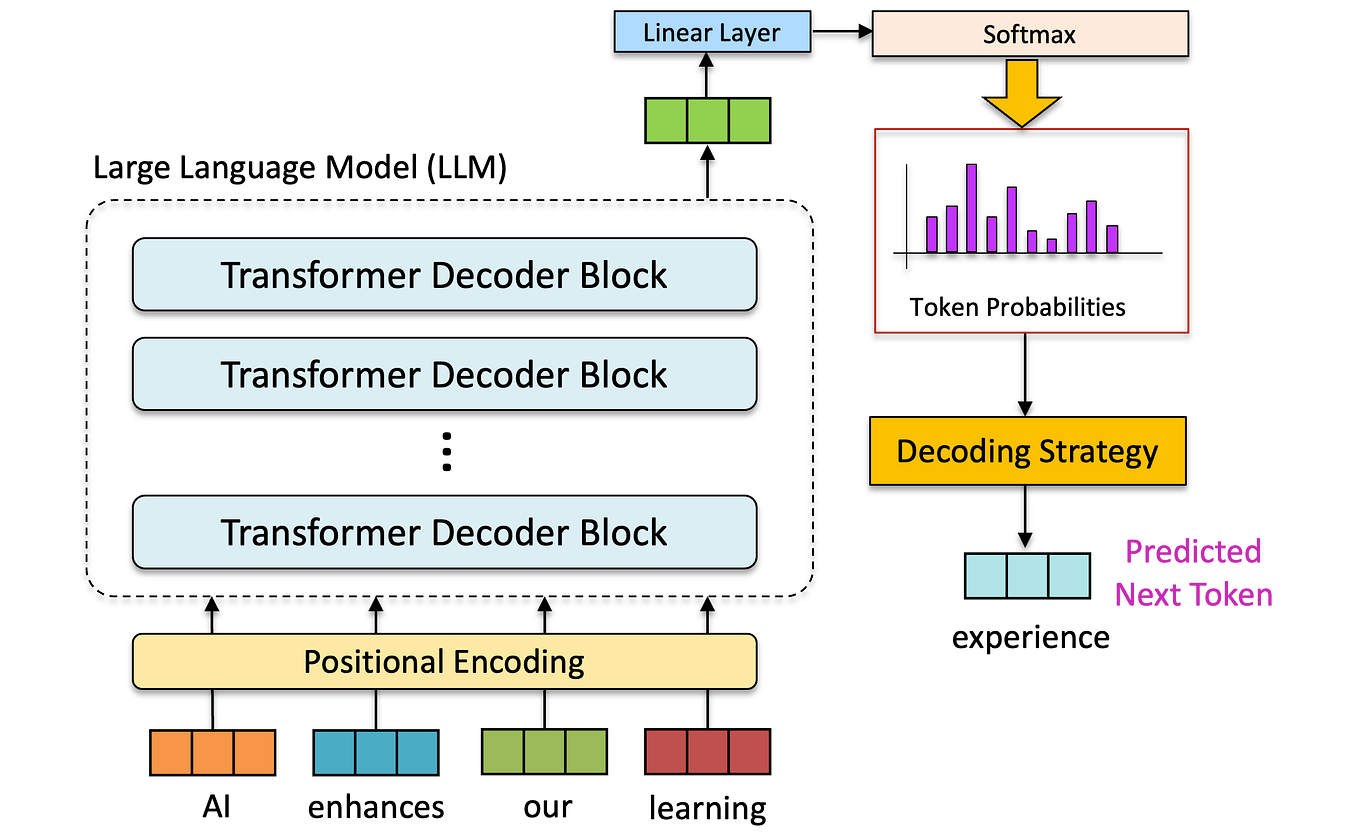
Fine-Tuning Large Language Models with DeepSpeed: A Step-by-Step Guide ...
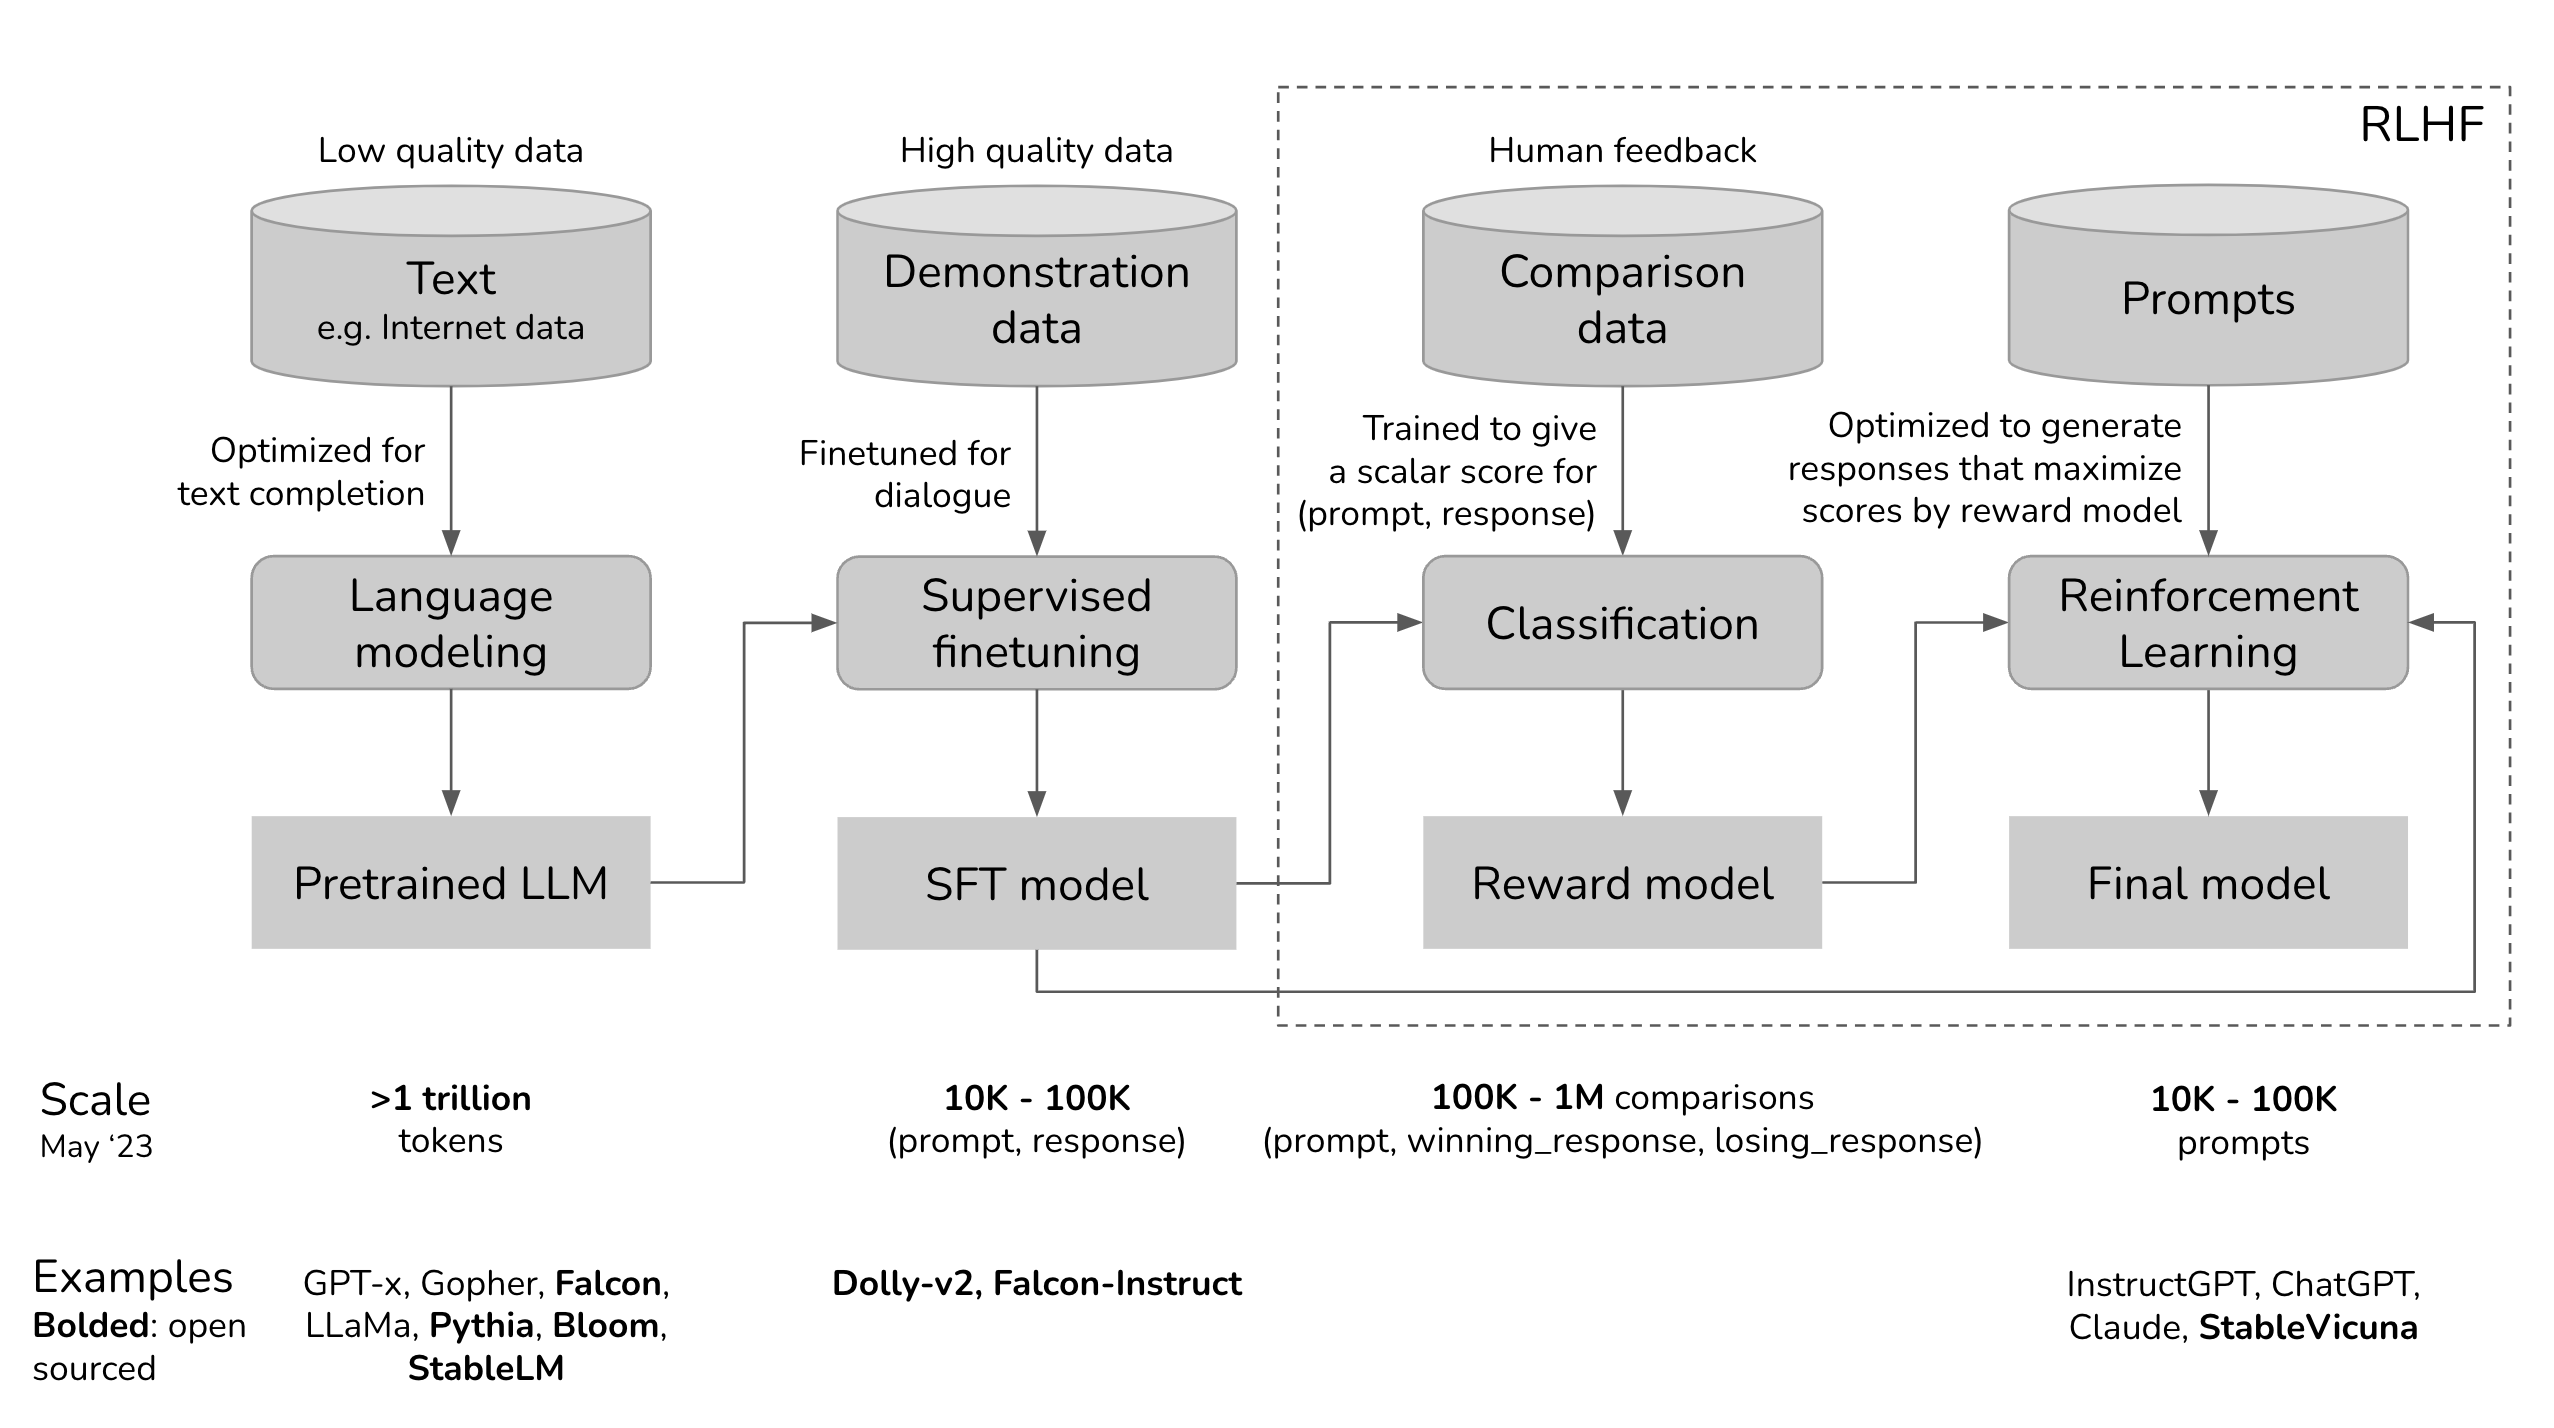
Fine tuning of large-scale language models and RLHF (Reinforcement ...
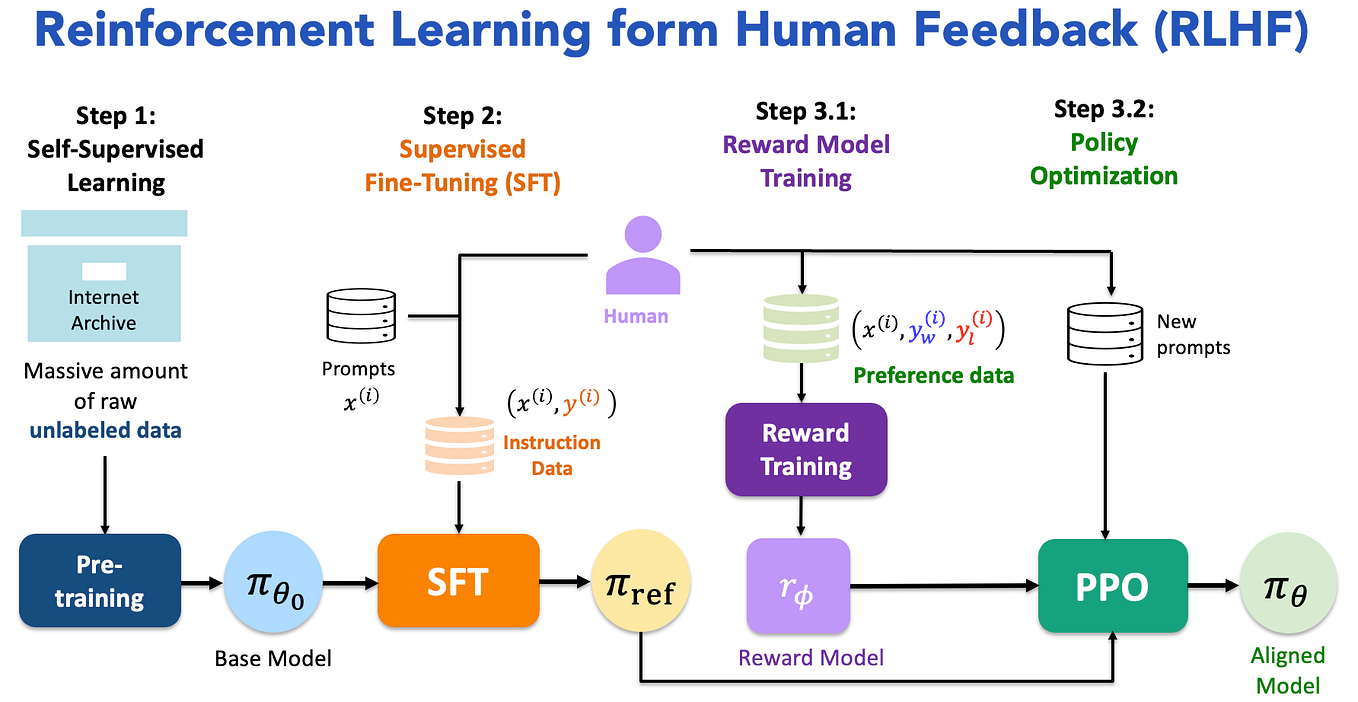
Fine-Tuning Large Language Models (LLMs) | by Shaw Talebi | Towards ...

RLHF (Reinforcement Learning From Human Feedback): Overview + Tutorial