
Flashattention Implementation Gpu Memory Optimization For Transformers
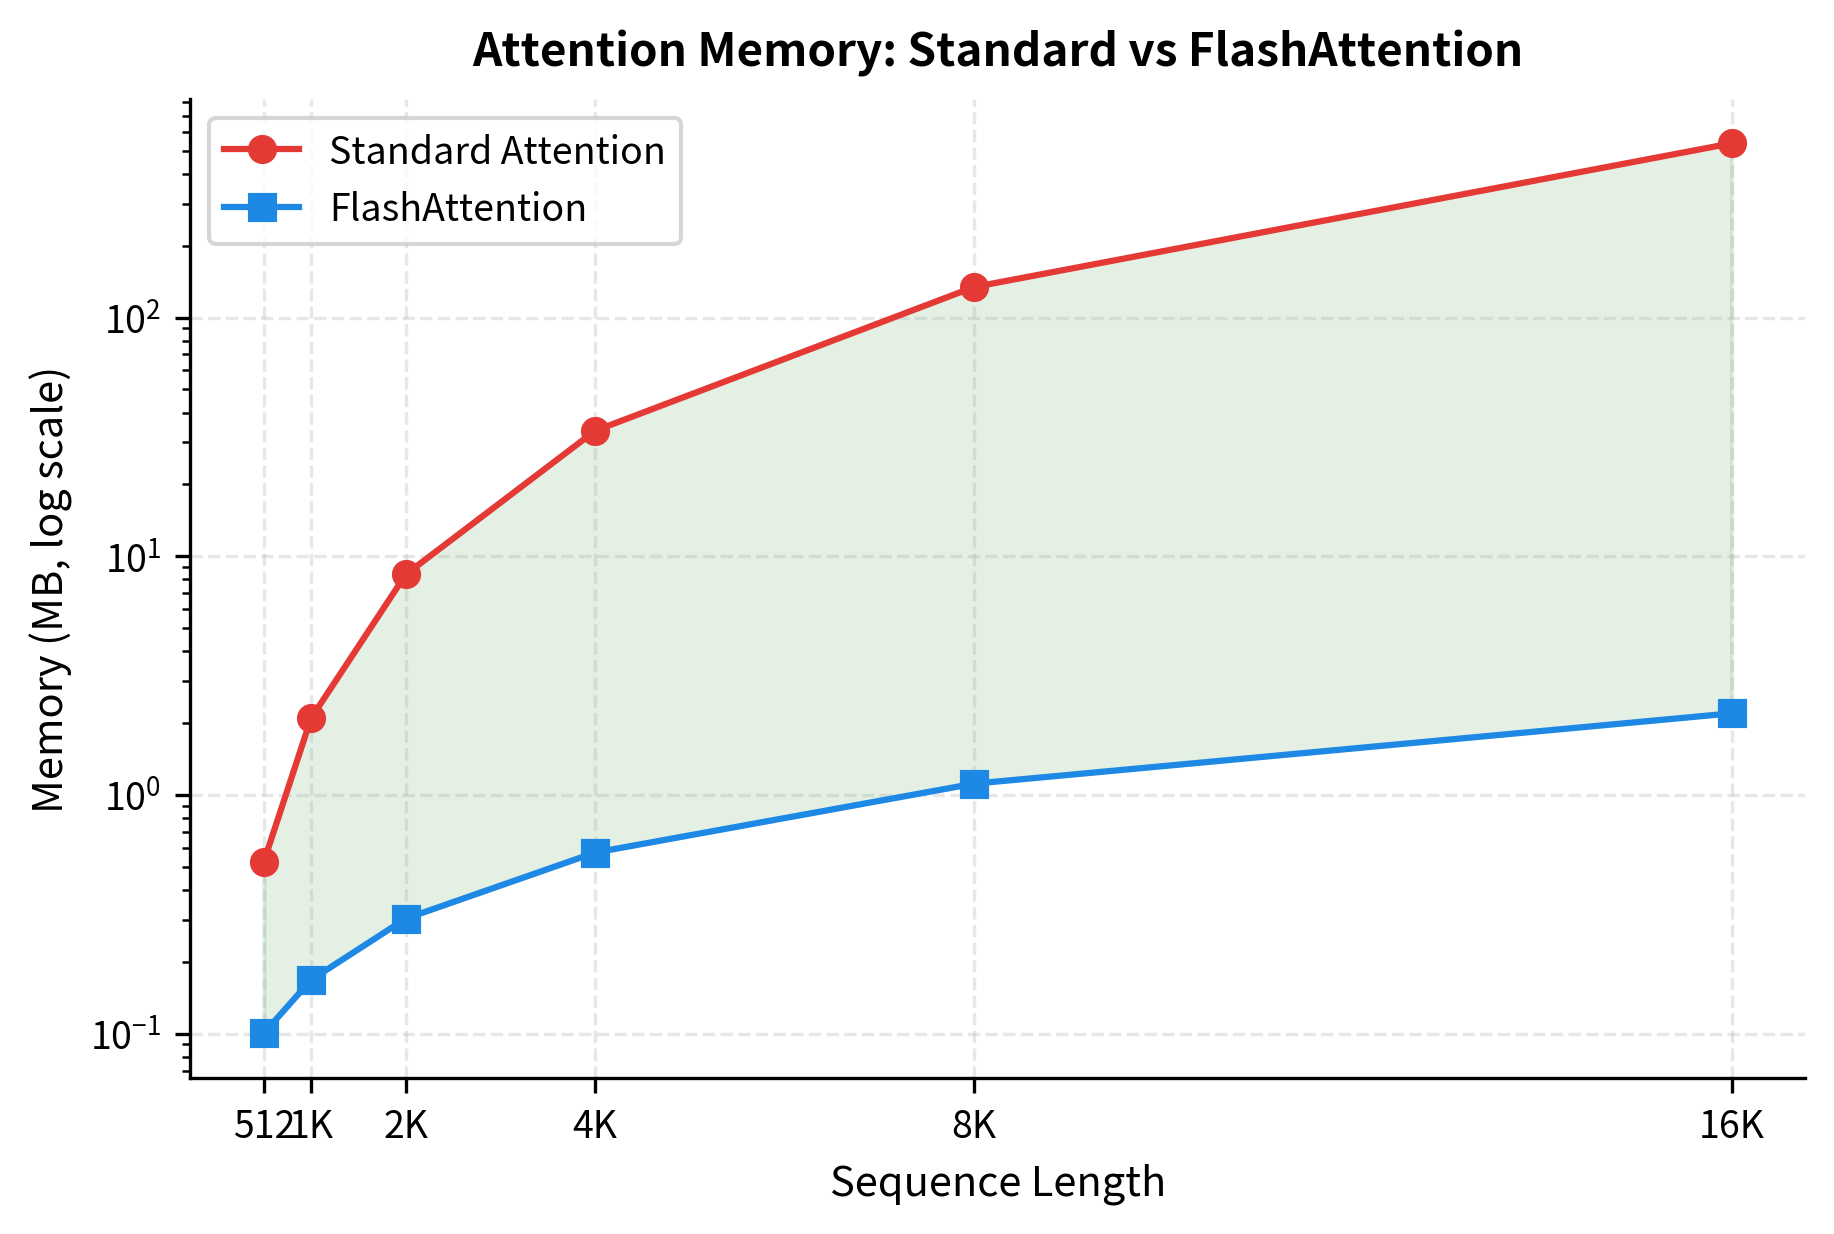
FlashAttention Implementation: GPU Memory Optimization for Transformers ...
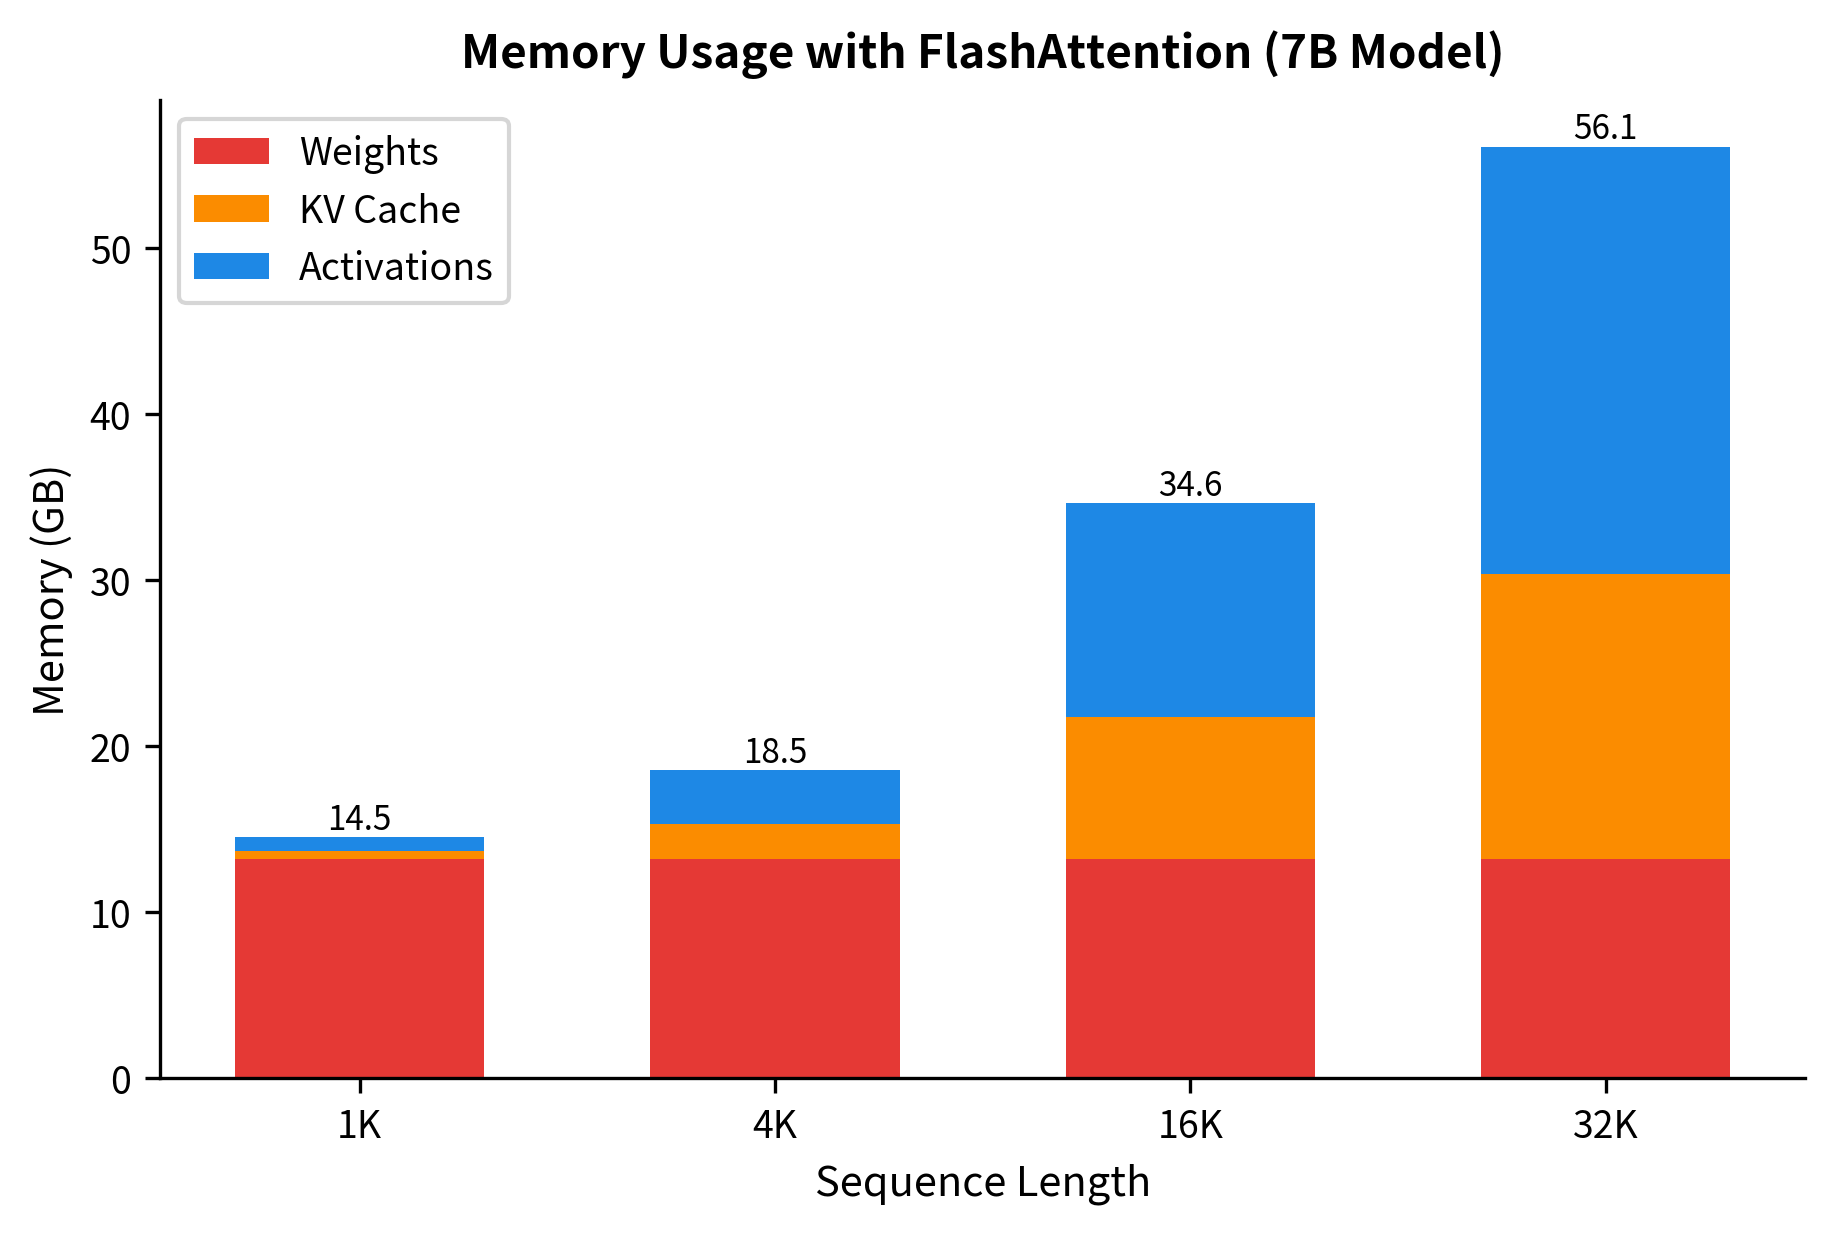
FlashAttention Implementation: GPU Memory Optimization for Transformers ...
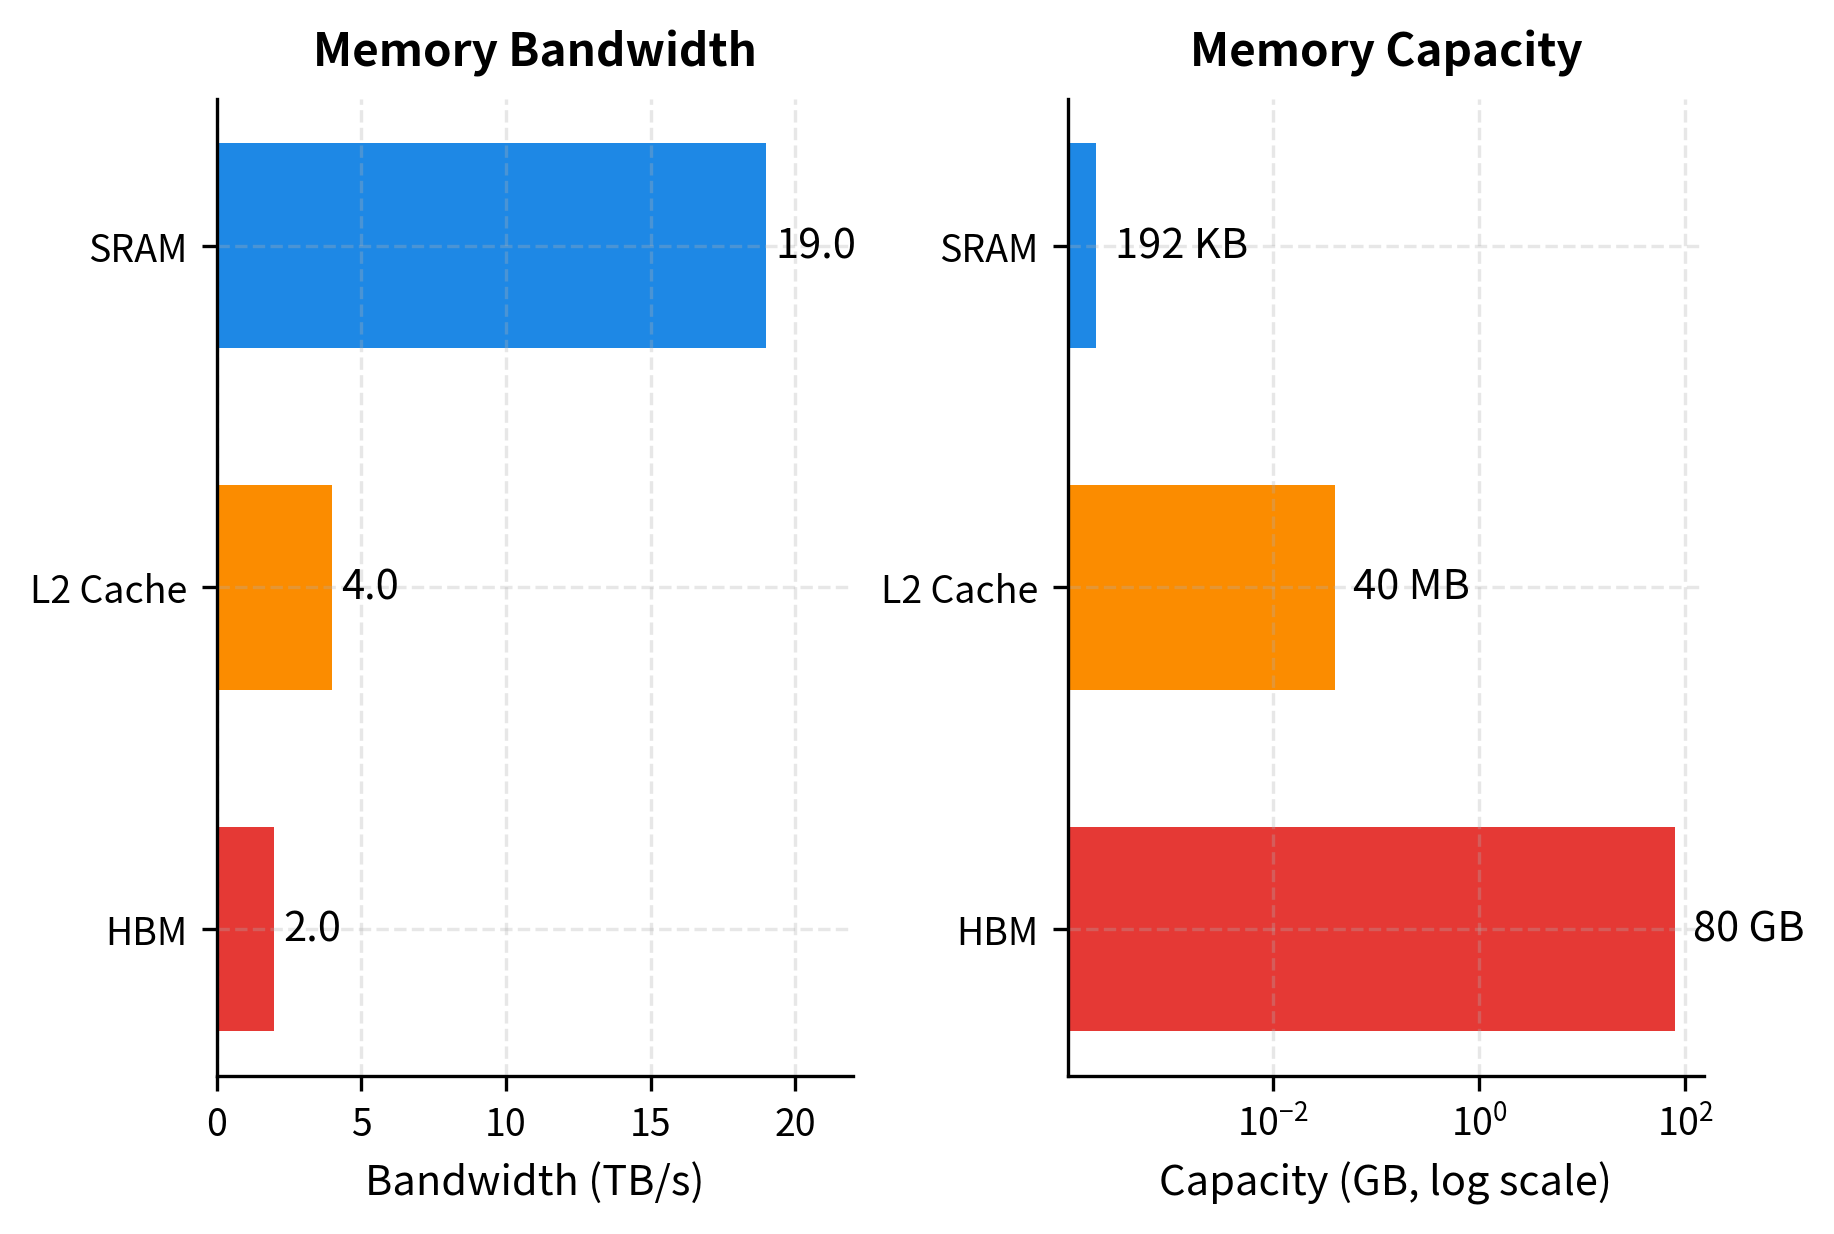
FlashAttention Implementation: GPU Memory Optimization for Transformers ...
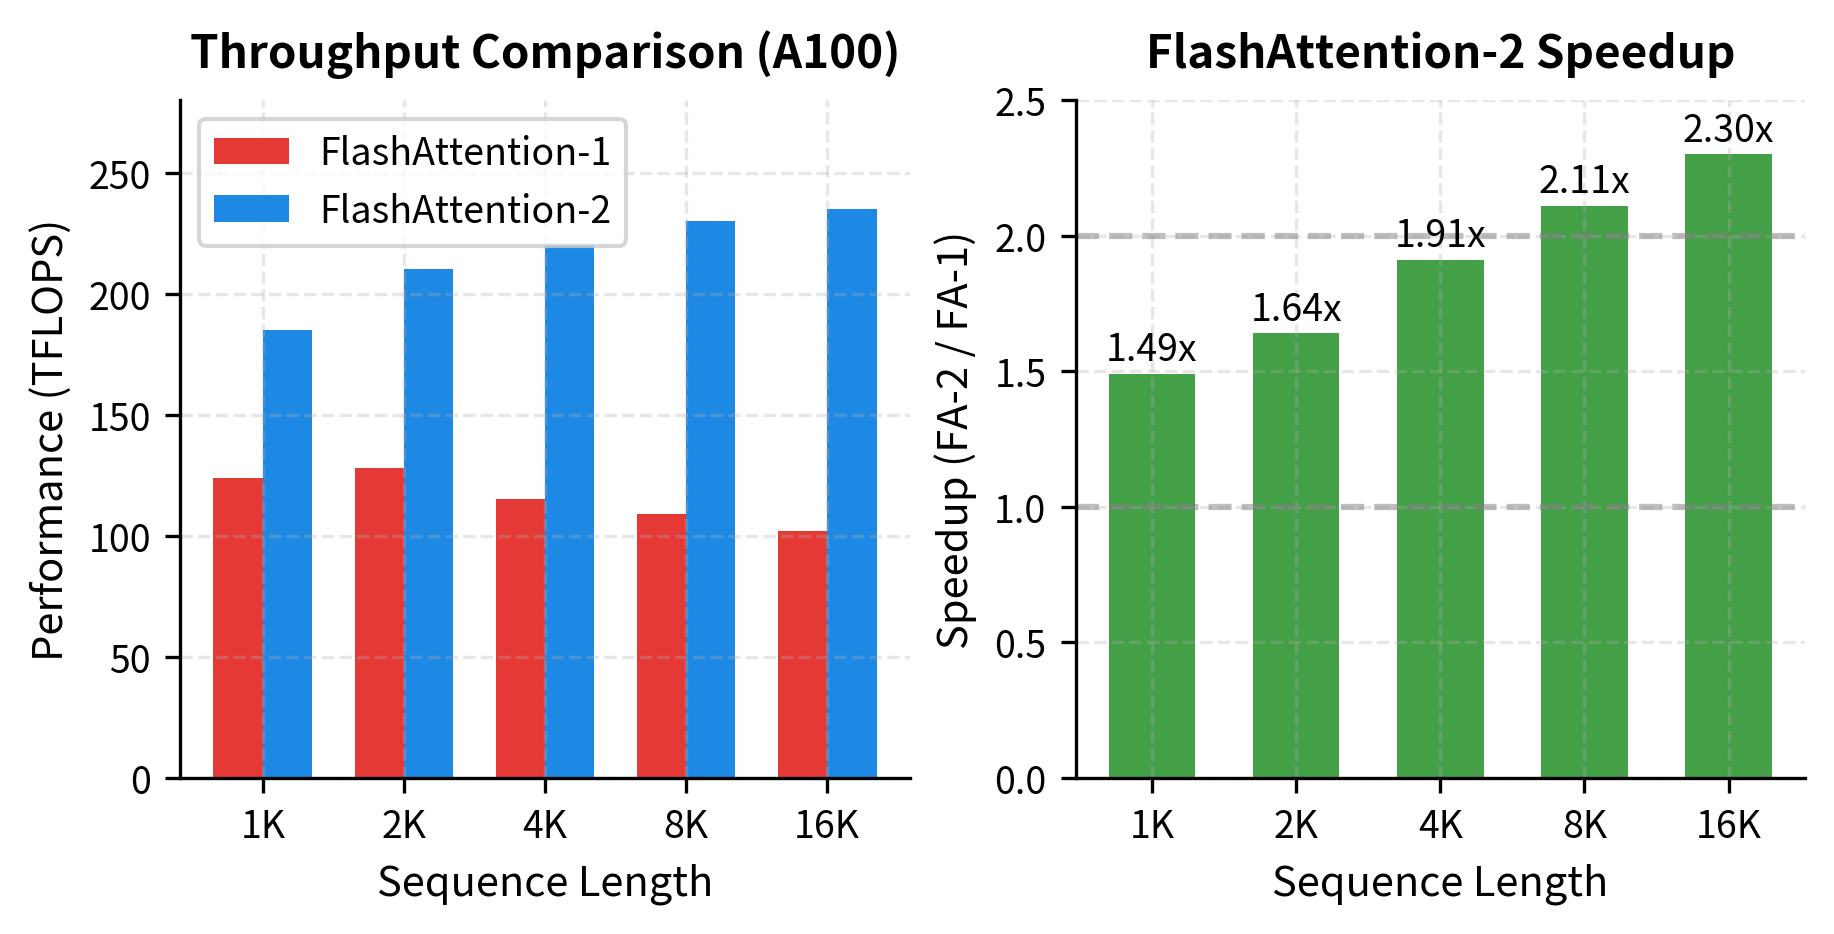
FlashAttention Implementation: GPU Memory Optimization for Transformers ...
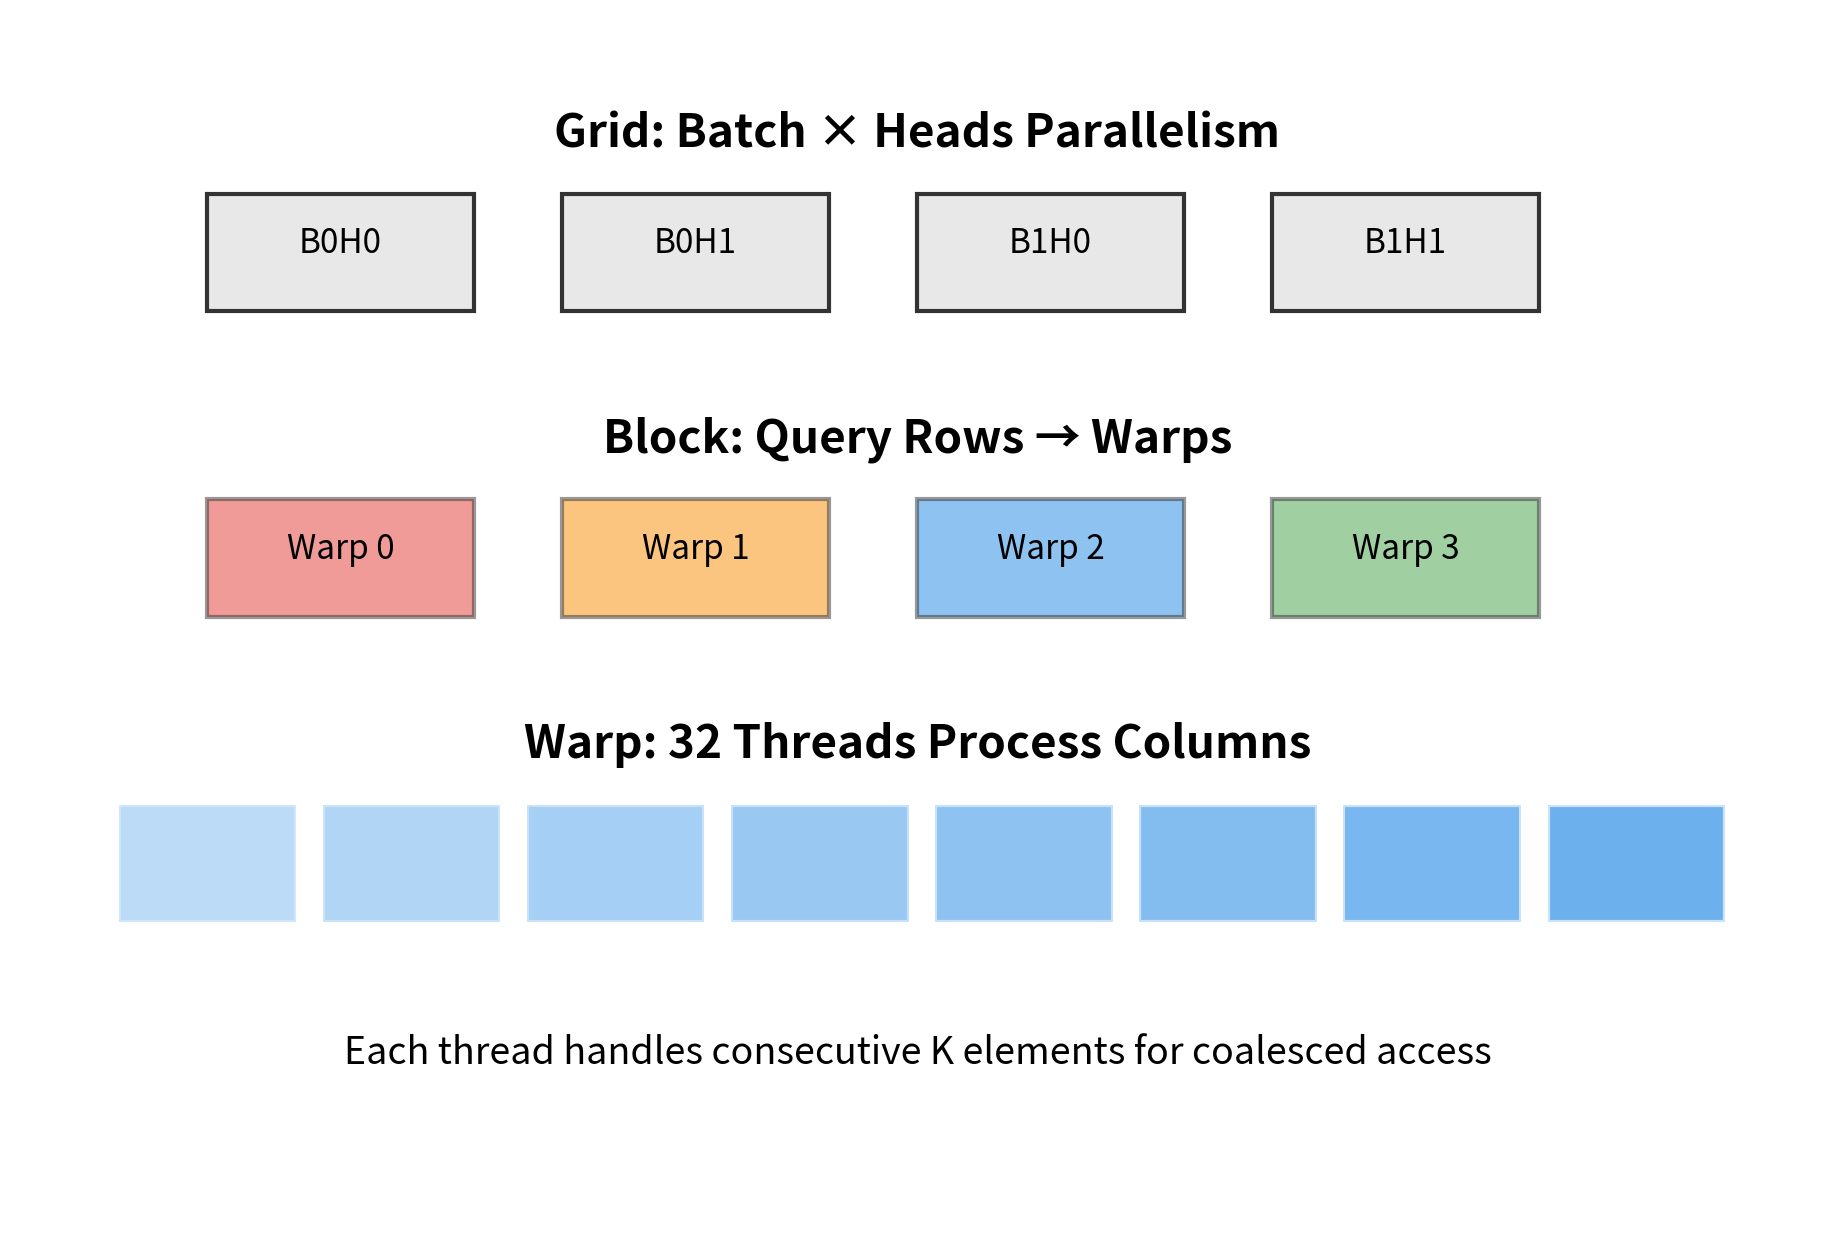
FlashAttention Implementation: GPU Memory Optimization for Transformers ...
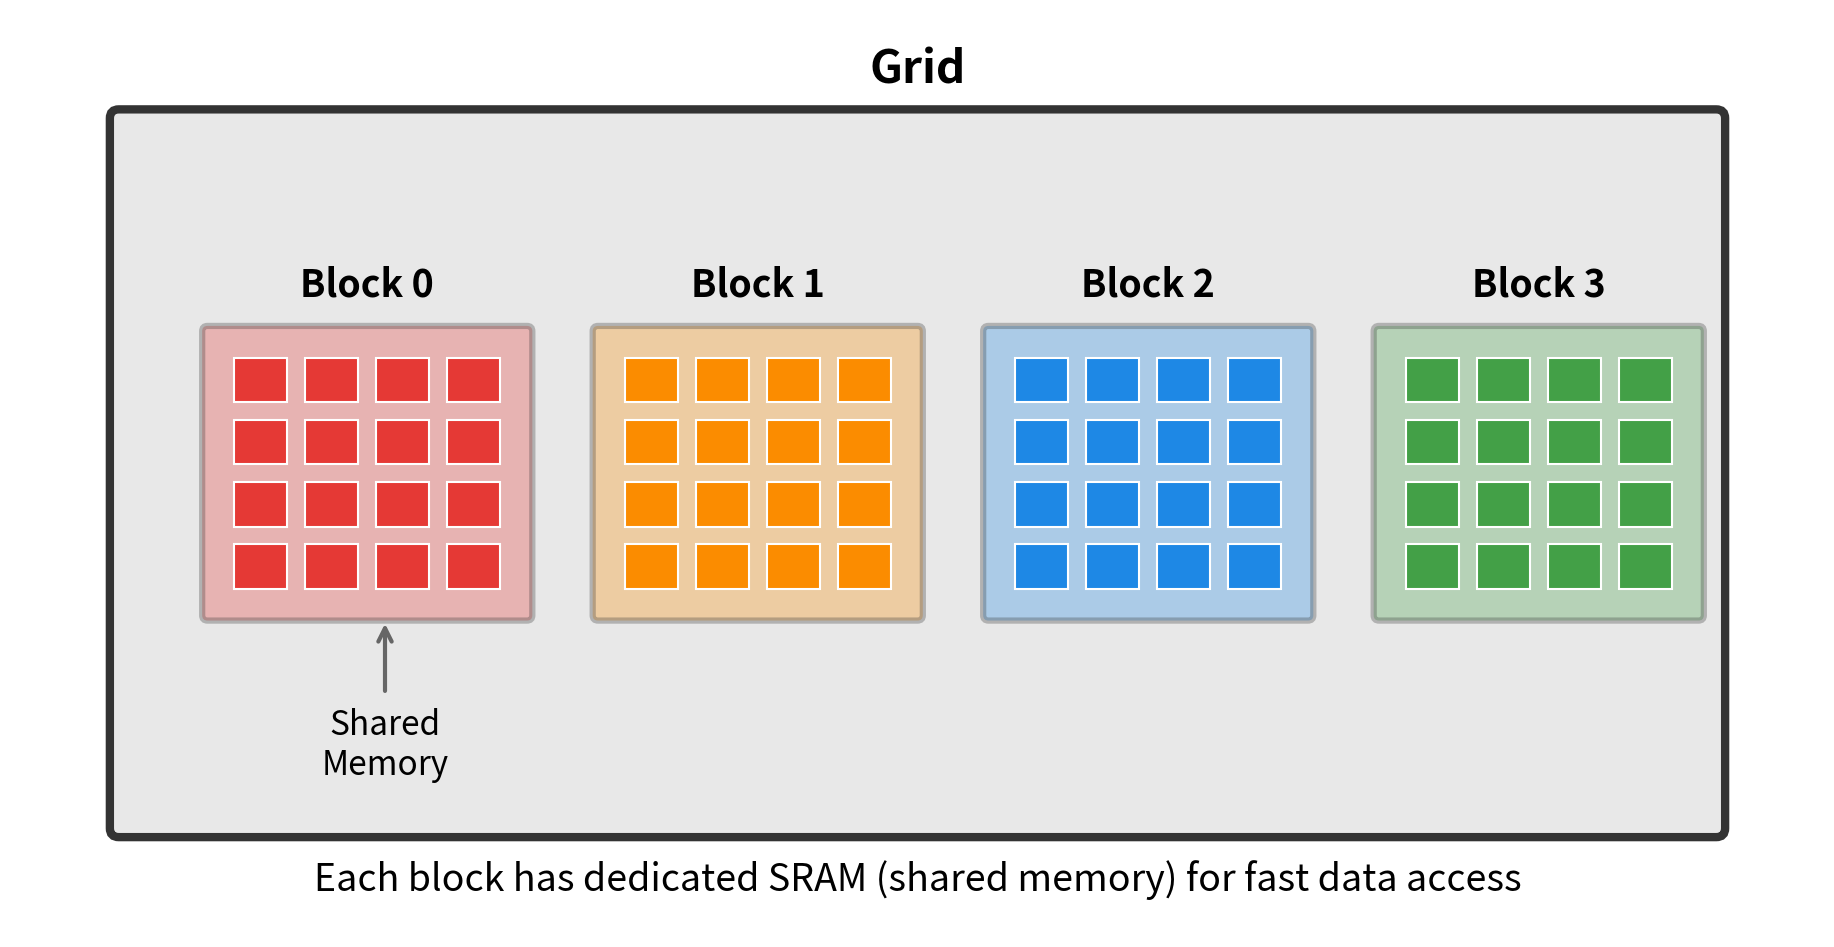
FlashAttention Implementation: GPU Memory Optimization for Transformers ...
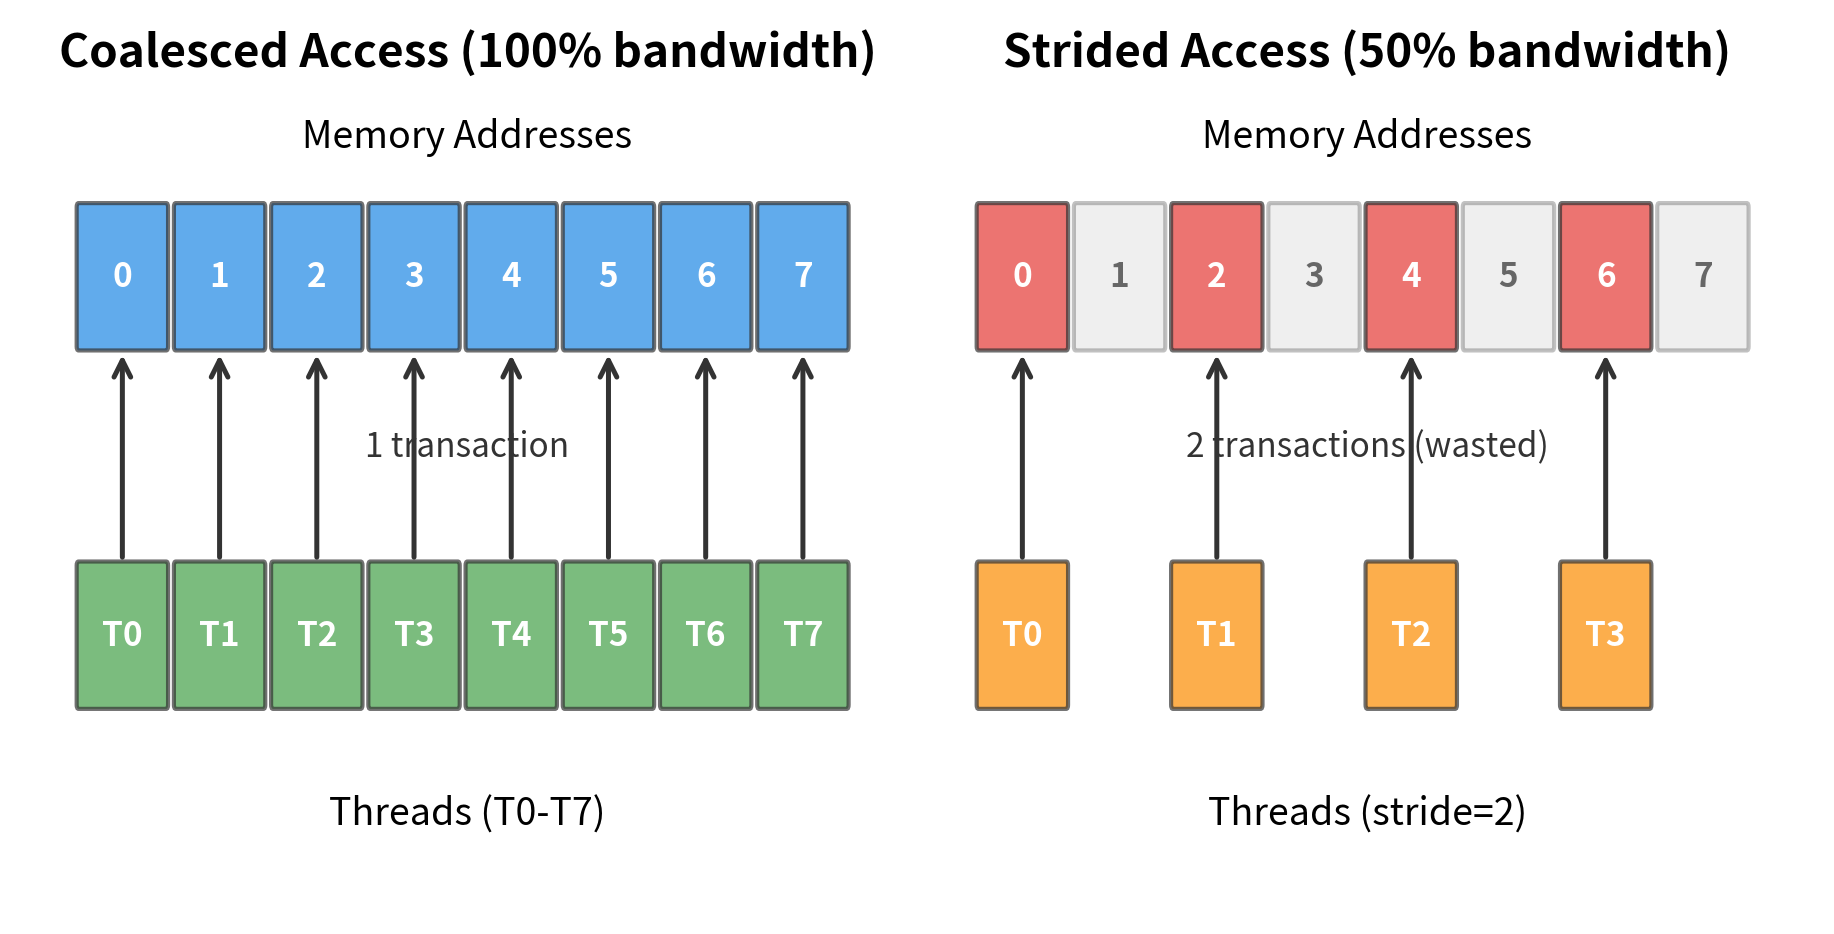
FlashAttention Implementation: GPU Memory Optimization for Transformers ...
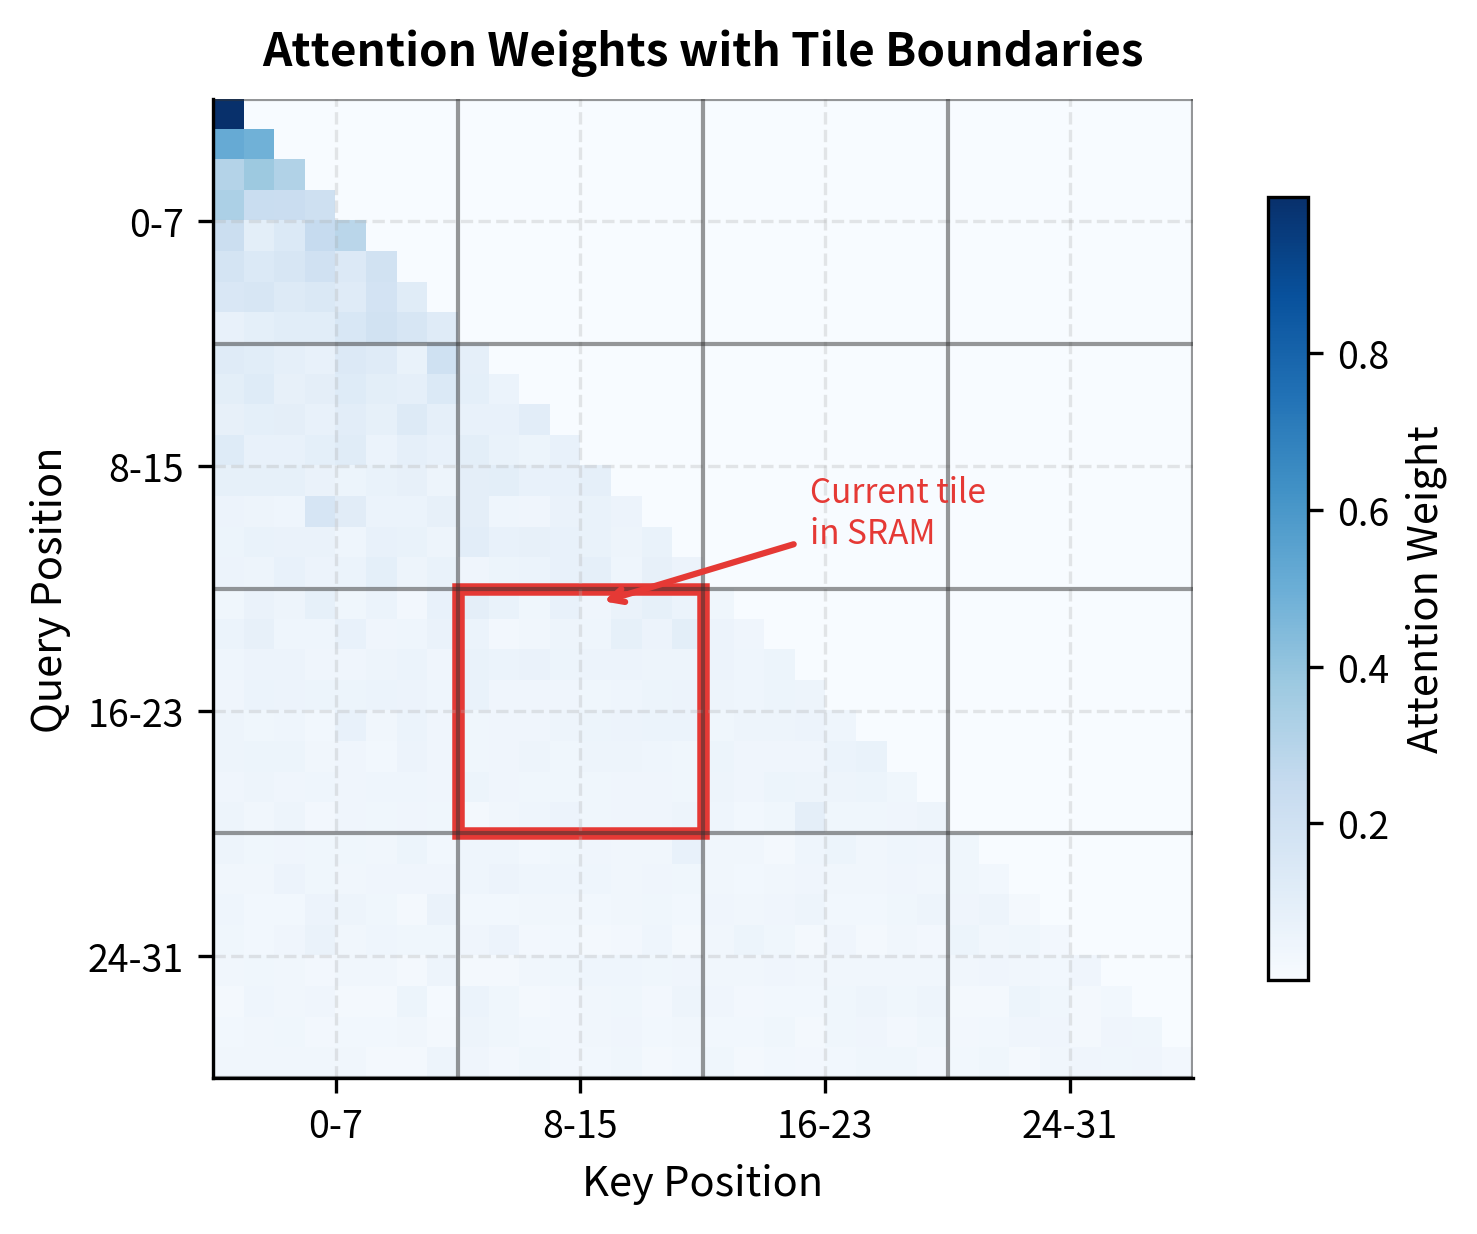
FlashAttention Implementation: GPU Memory Optimization for Transformers ...
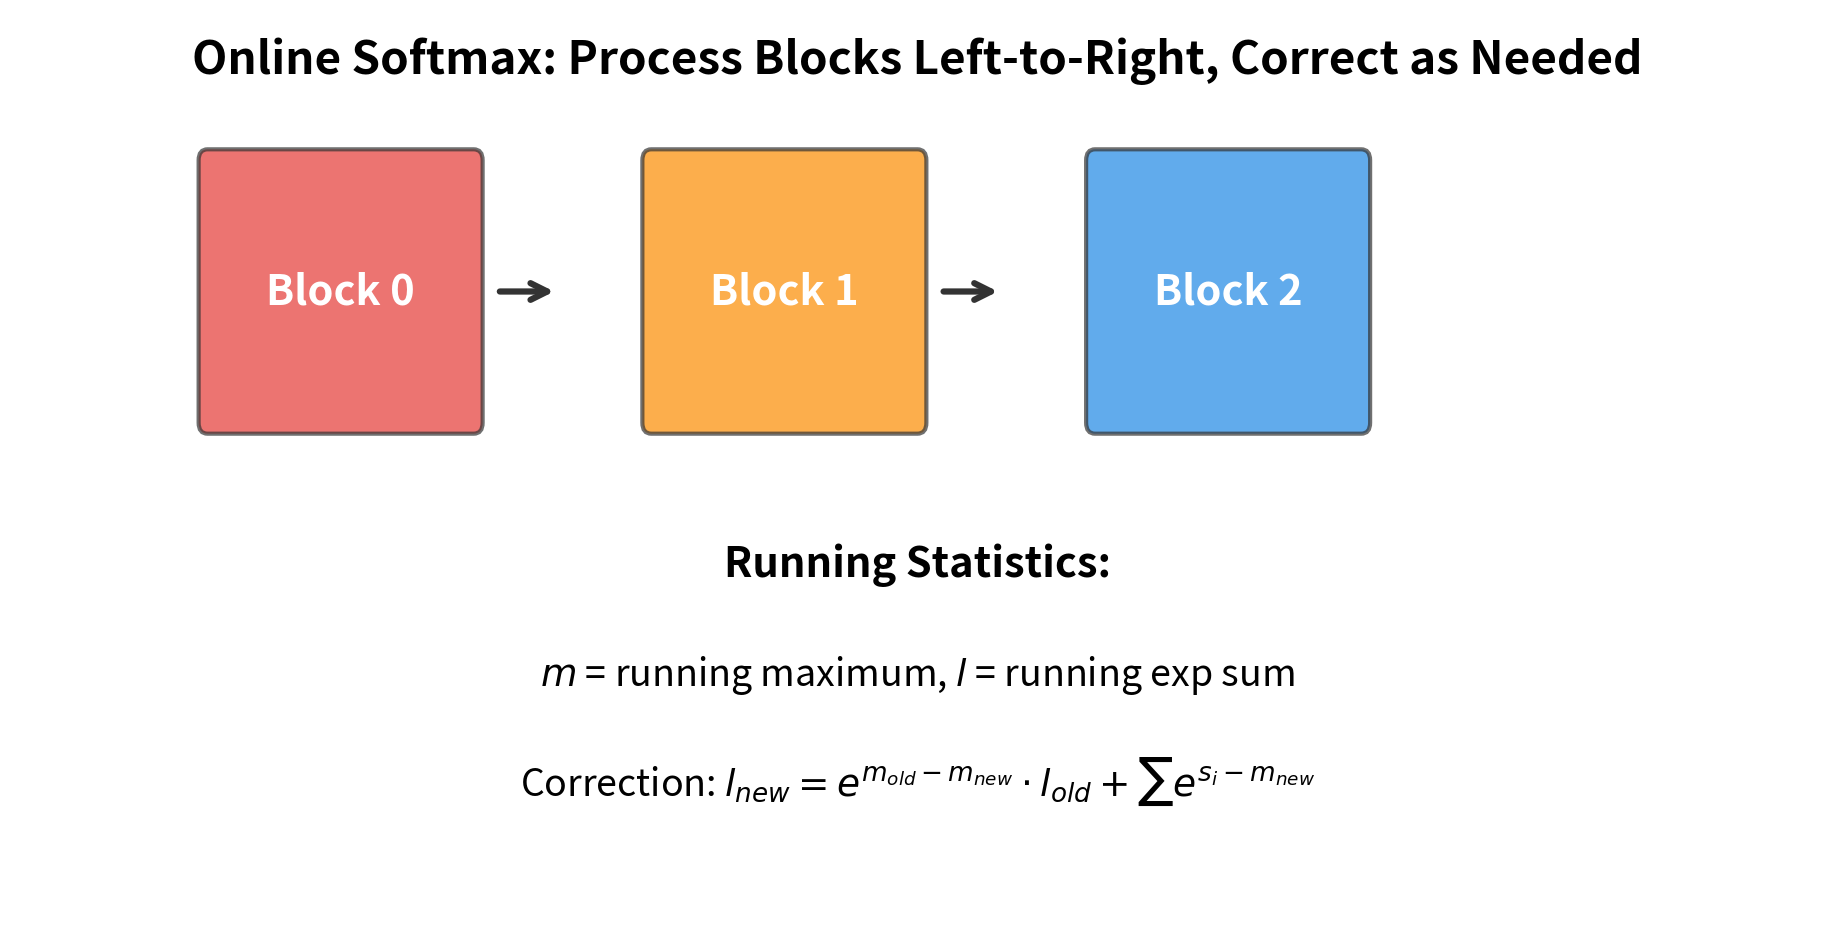
FlashAttention Implementation: GPU Memory Optimization for Transformers ...

GPU Optimization for Transformers | PDF | Graphics Processing Unit ...
Advertisement Space (300x250)

GPU Performance Optimization for Deep Learning | DigitalOcean

Methods of Memory Optimization for Transformer-Based Models
GPU Memory Requirement Prediction for Deep Learning Task Based on ...

Transformers Inference Optimization Guide | PDF | Random Access Memory ...

Kernel-Level GPU Optimization for Transformer Attention: A Technical ...
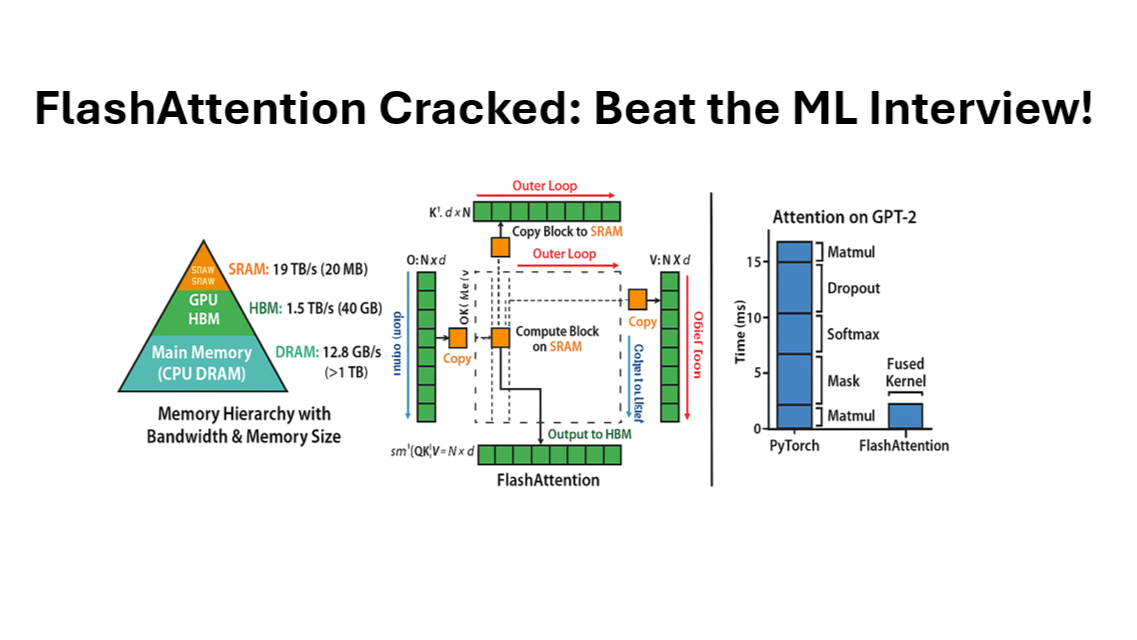
FlashAttention: Fast, Memory-Efficient Attention for Transformers

GitHub - ai-bond/flash-attention-v100: Implementation of FlashAttention ...
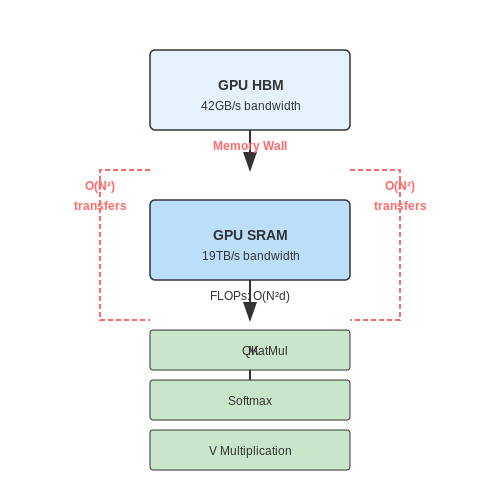
FlashAttention for Efficient Training | AI Tutorial | Next Electronics
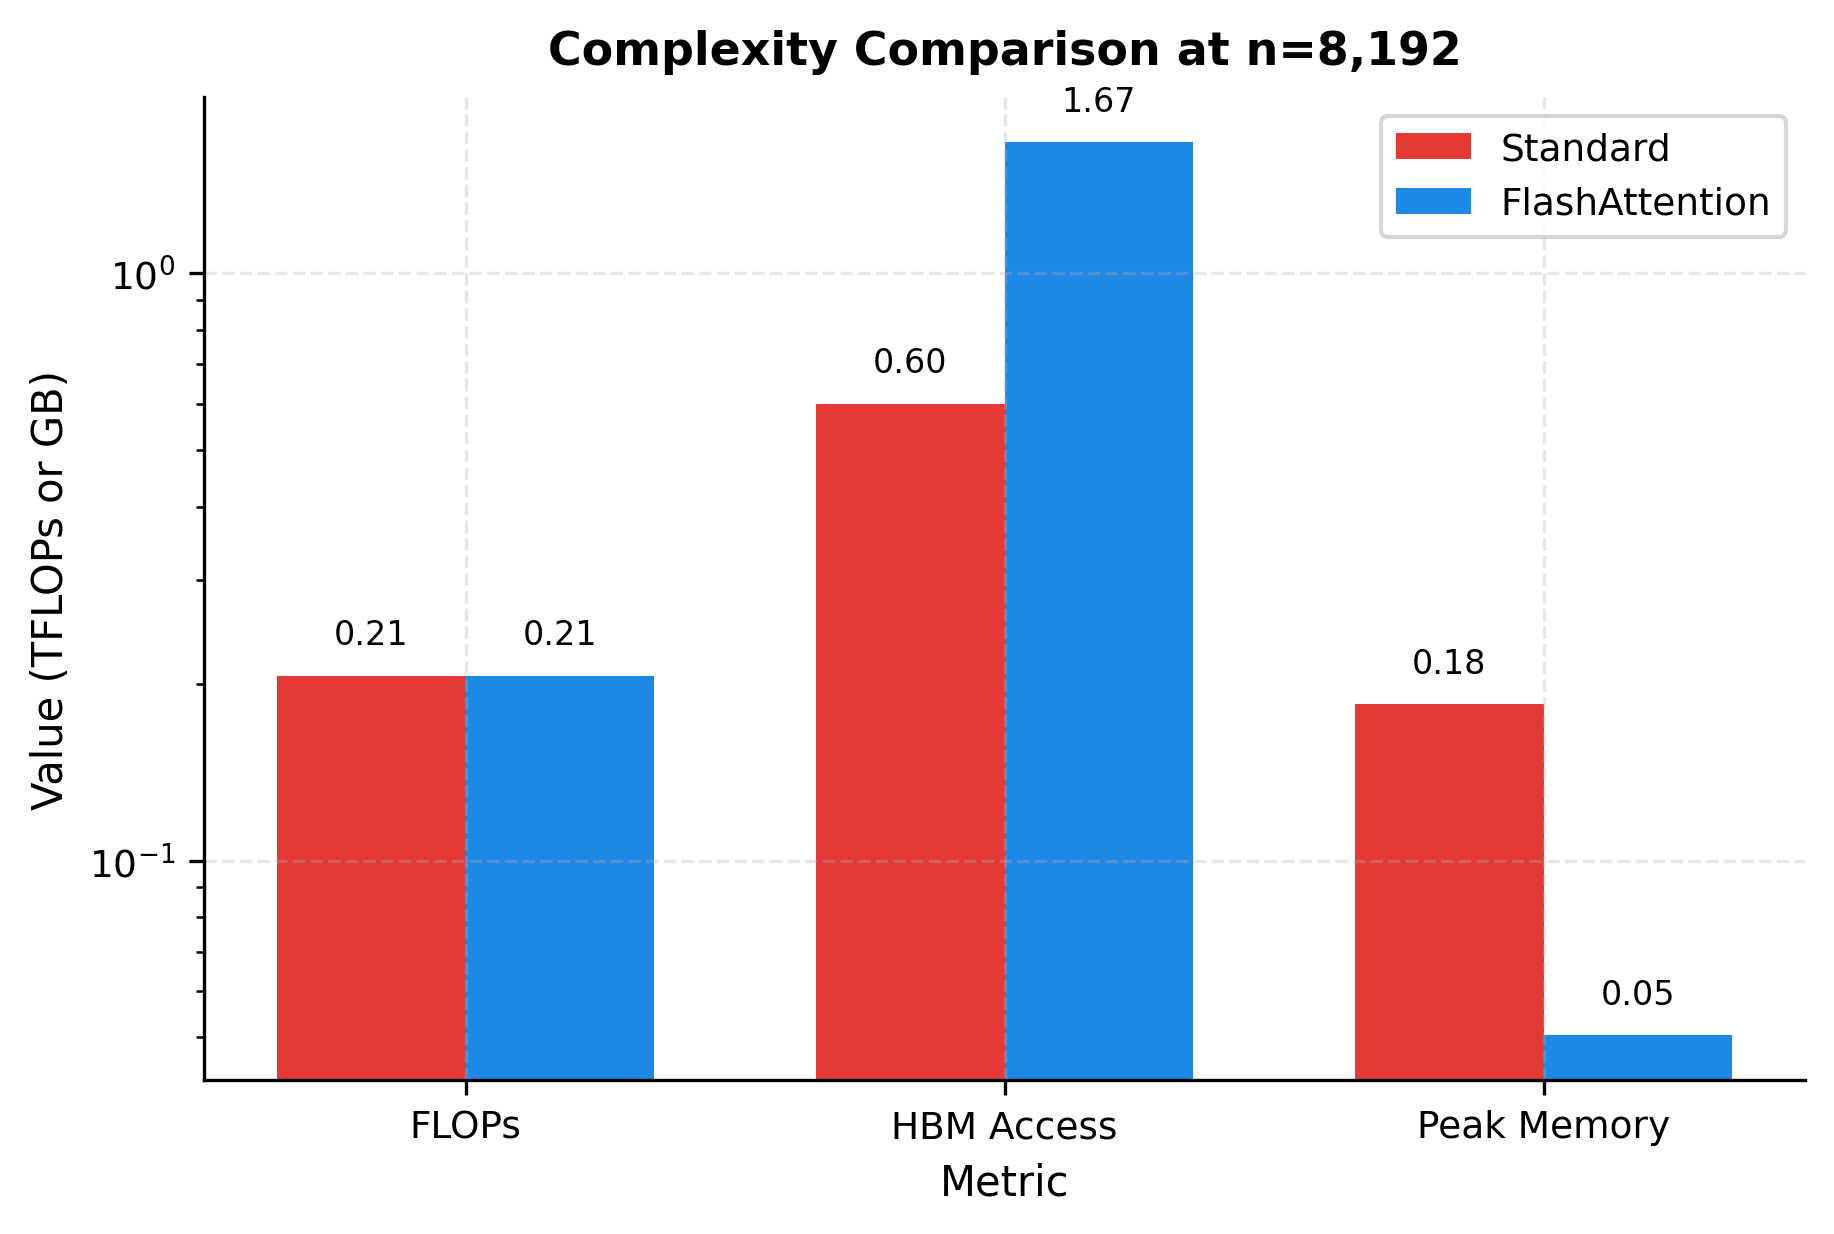
FlashAttention Algorithm: Memory-Efficient Exact Attention via GPU ...

Reimplementing FlashAttention for performance and giggles | AmineDiro
Advertisement Space (336x280)
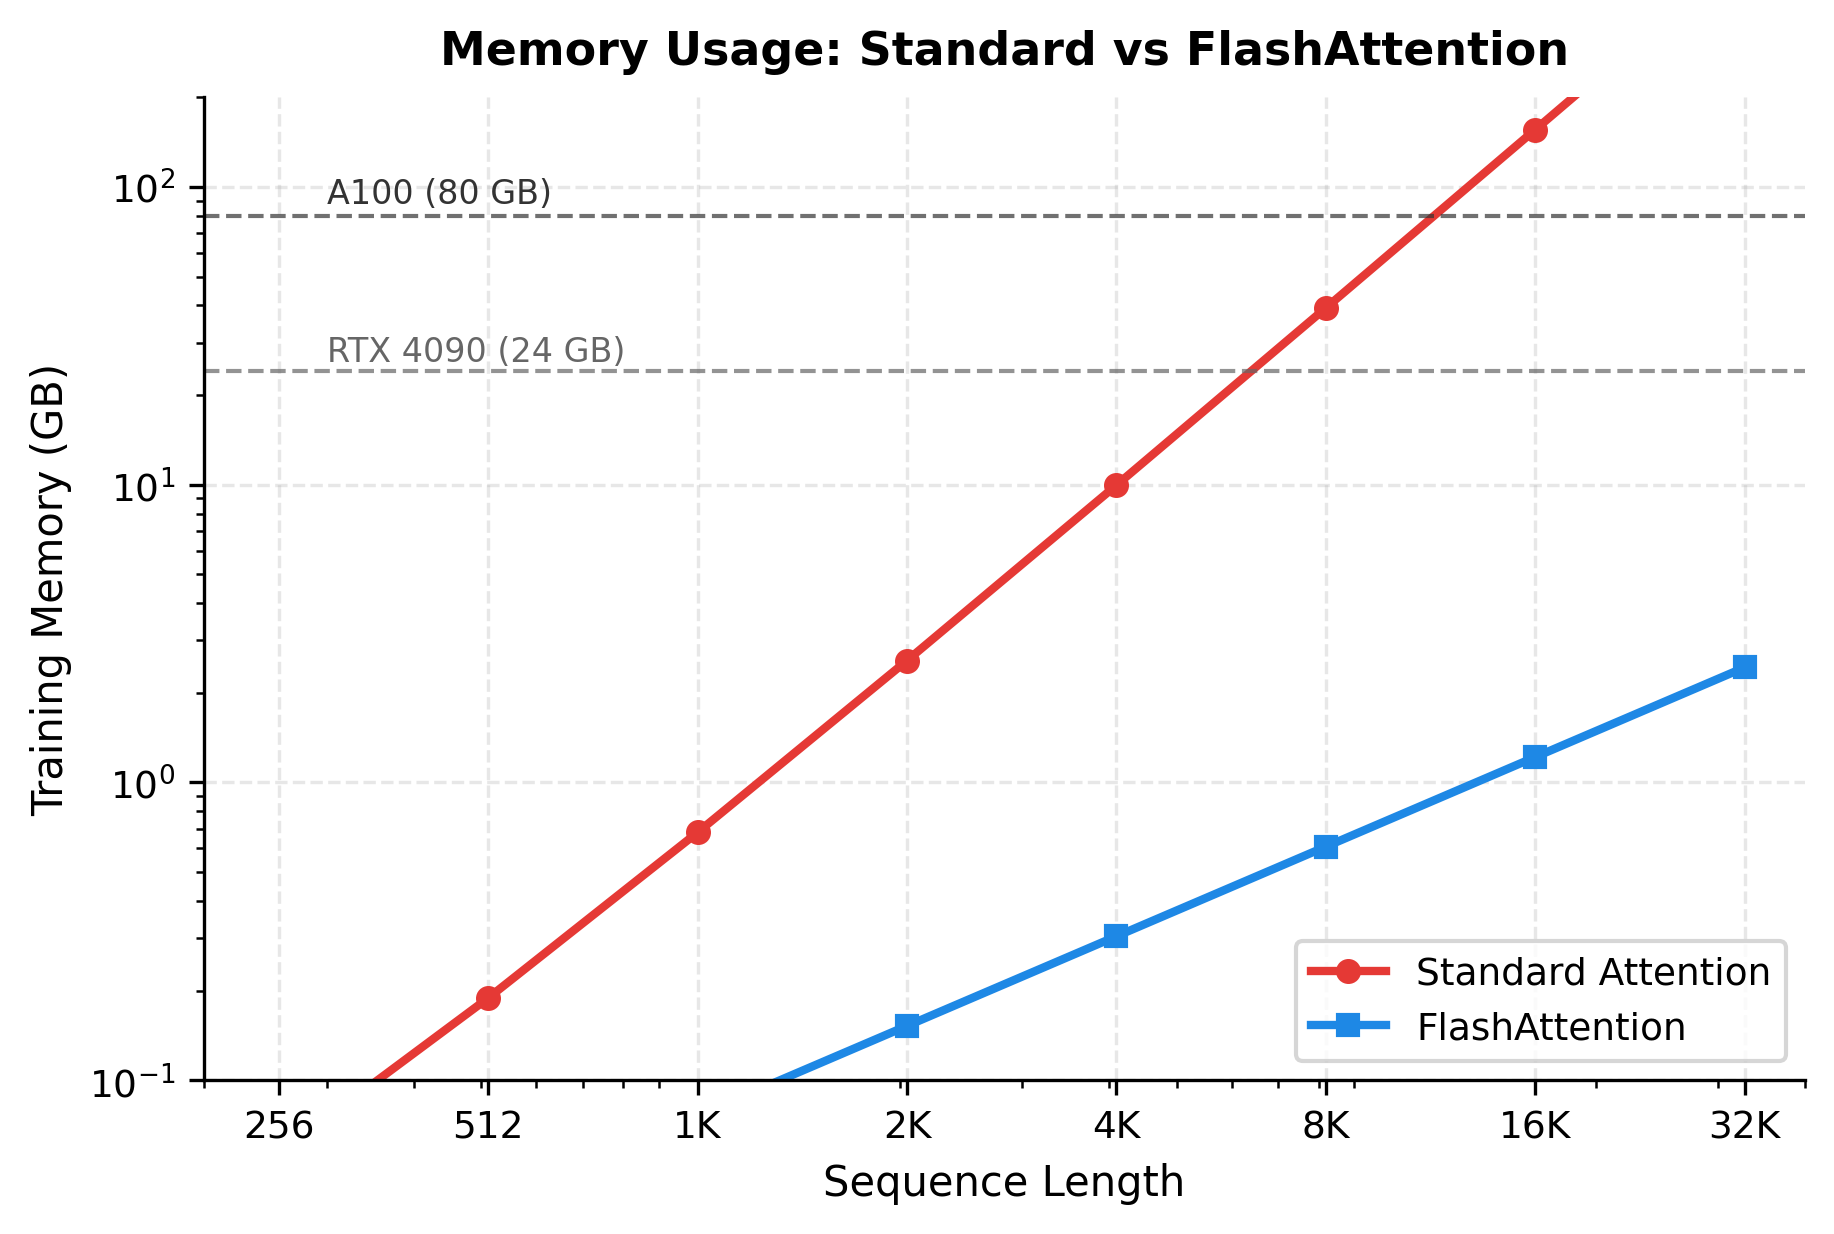
FlashAttention Algorithm: Memory-Efficient Exact Attention via GPU ...
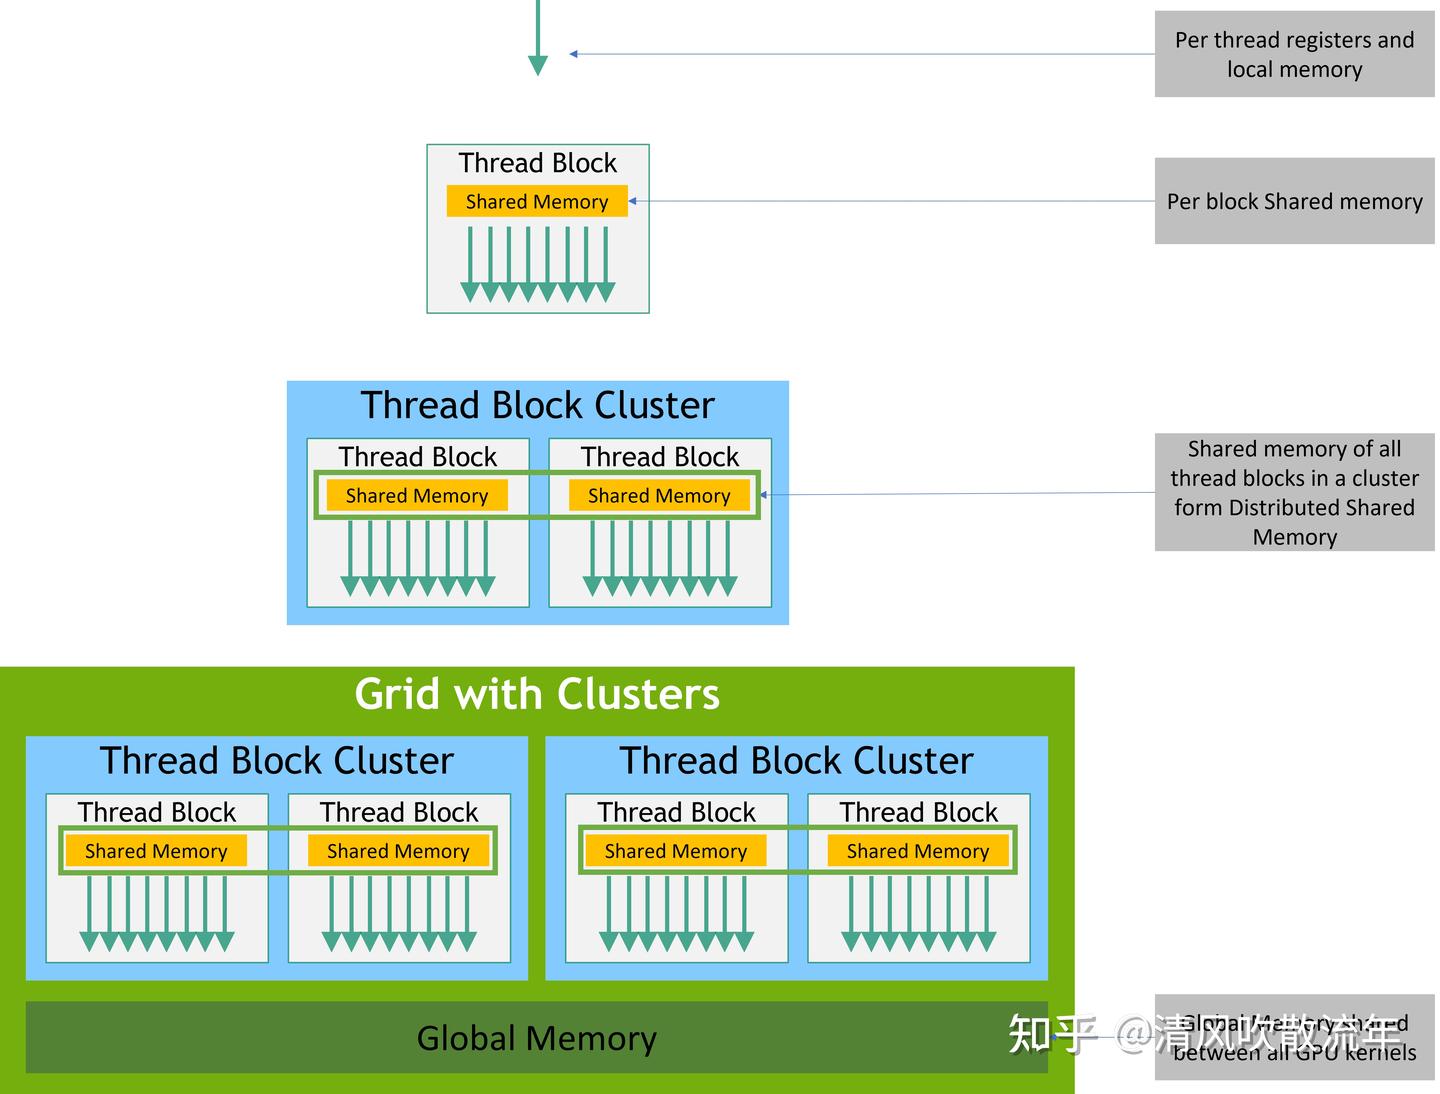
万字长文从 FlashAttention 1–4 看 NVIDIA GPU 的代际变化 - 知乎
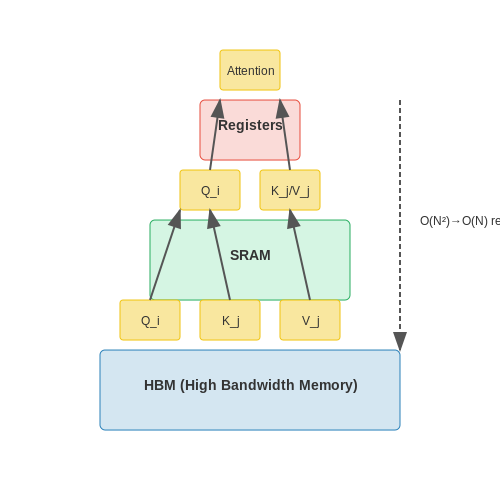
FlashAttention for Efficient Training | AI Tutorial | Next Electronics
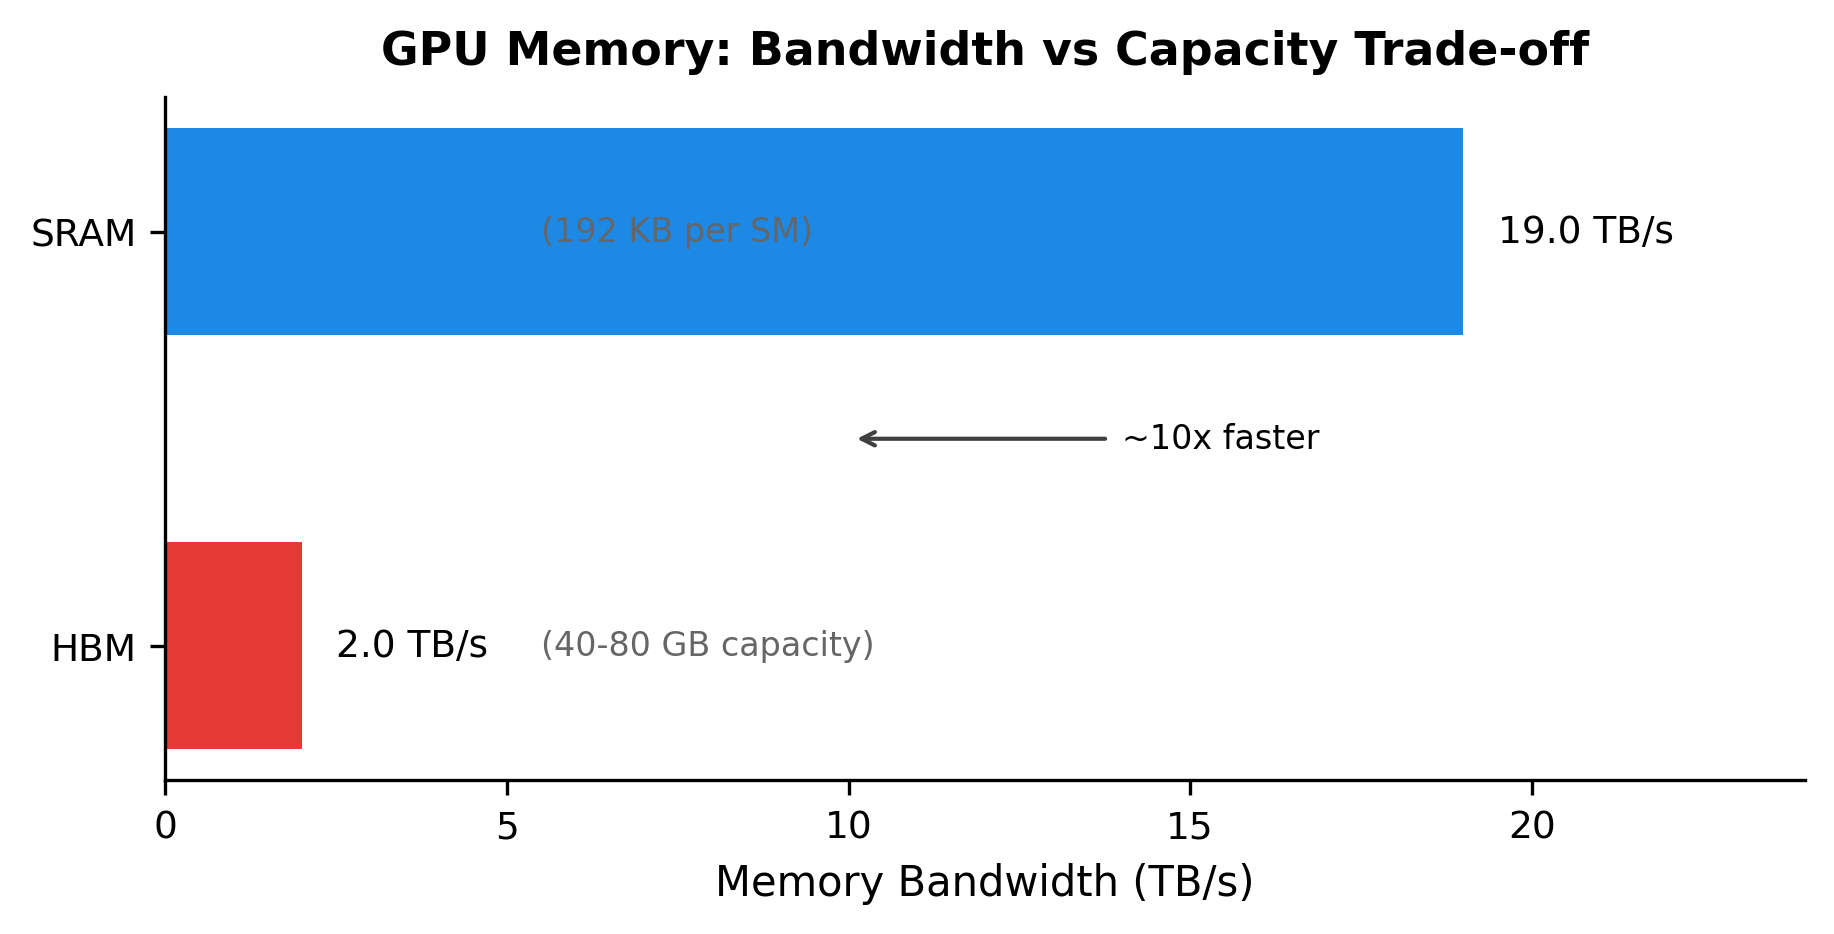
FlashAttention Algorithm: Memory-Efficient Exact Attention via GPU ...
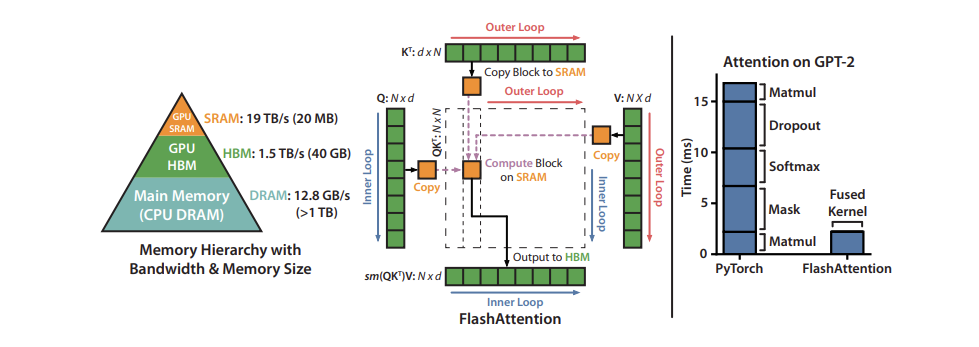
Mastering LLM Techniques: Inference Optimization – GIXtools
The 4 Flash Attention Variants: How to Train Transformers 10× Longer ...

Why Do We Use Negative Infinity for Masking in Attention? | by Sachin ...
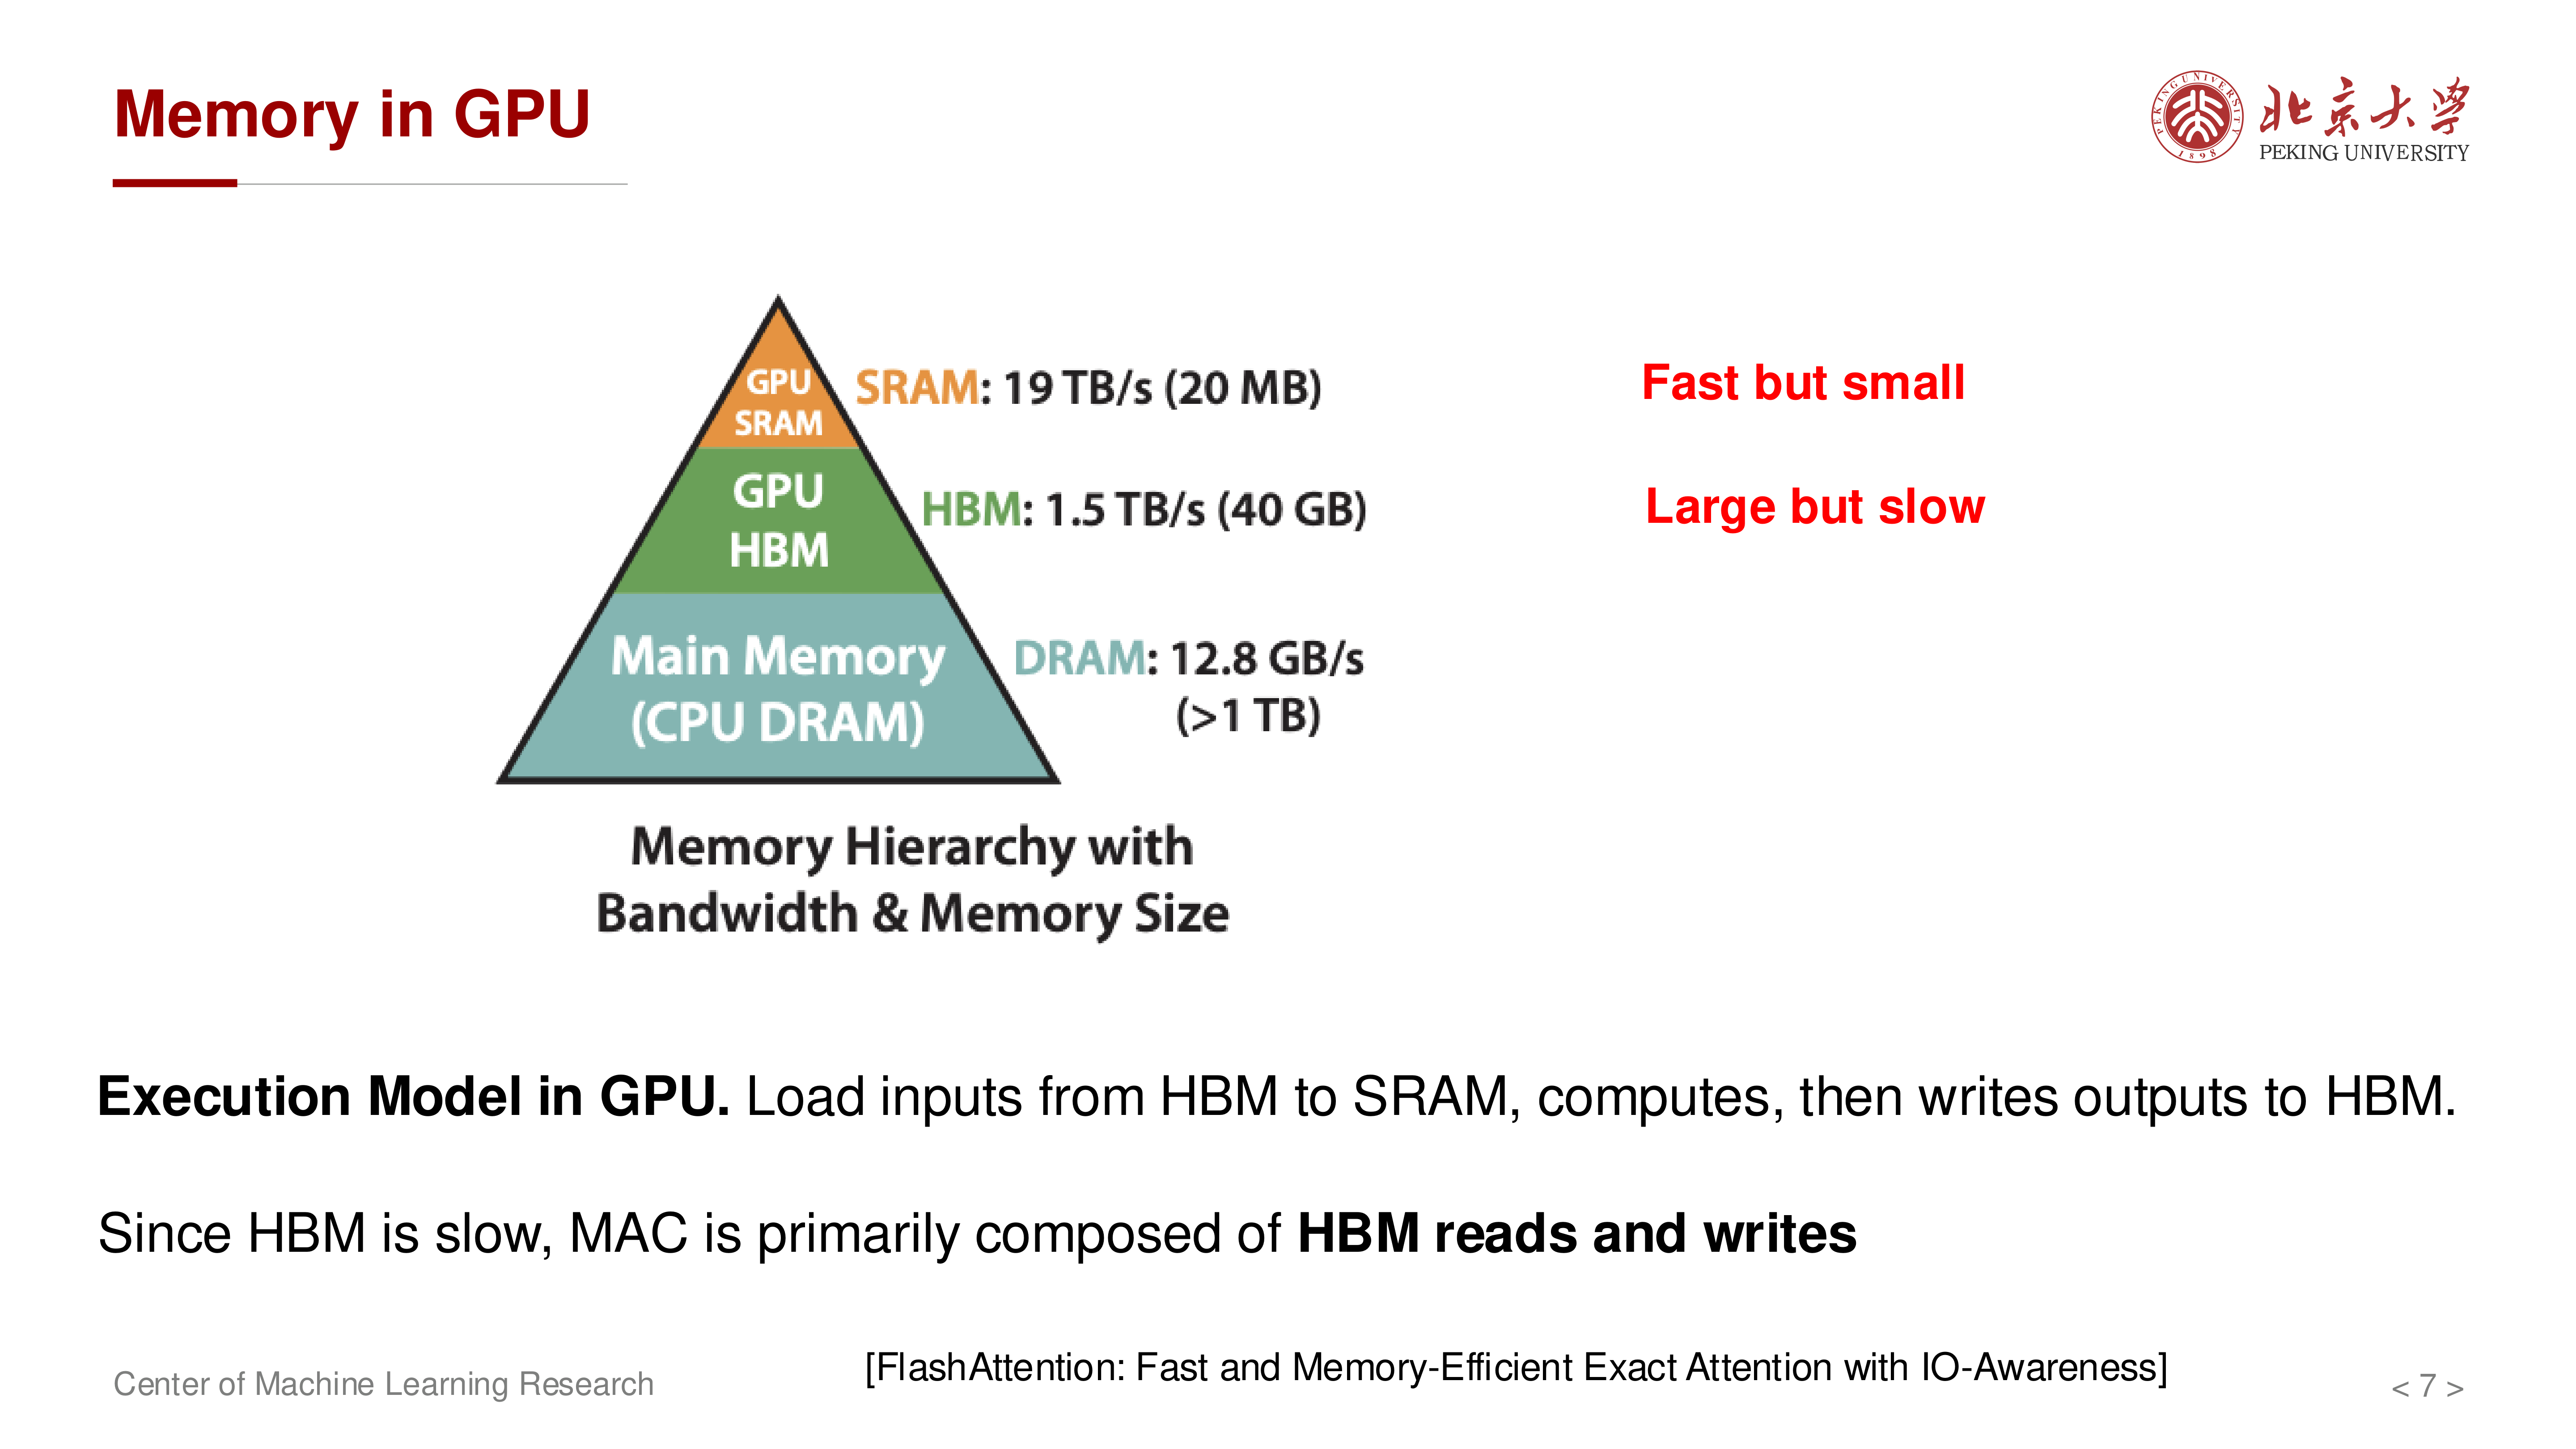
FlashAttention - Semt0's Blog

ELI5 FlashAttention: Understanding GPU Architecture - Part 1 - YouTube
Flash Attention: I/O-Aware Algorithm for Transformer Speedup ...
Advertisement Space (336x280)

Transformer Based Linear Attention with Optimized GPU Kernel ...
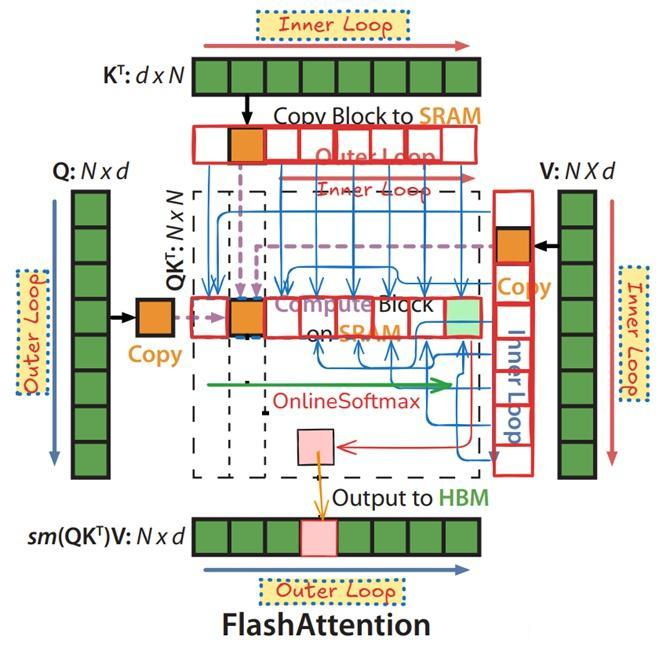
Attention 与 FlashAttention 深入原理剖析-公式推导-FlashAttention(V1/V2/V3)对比-主流大模型 ...
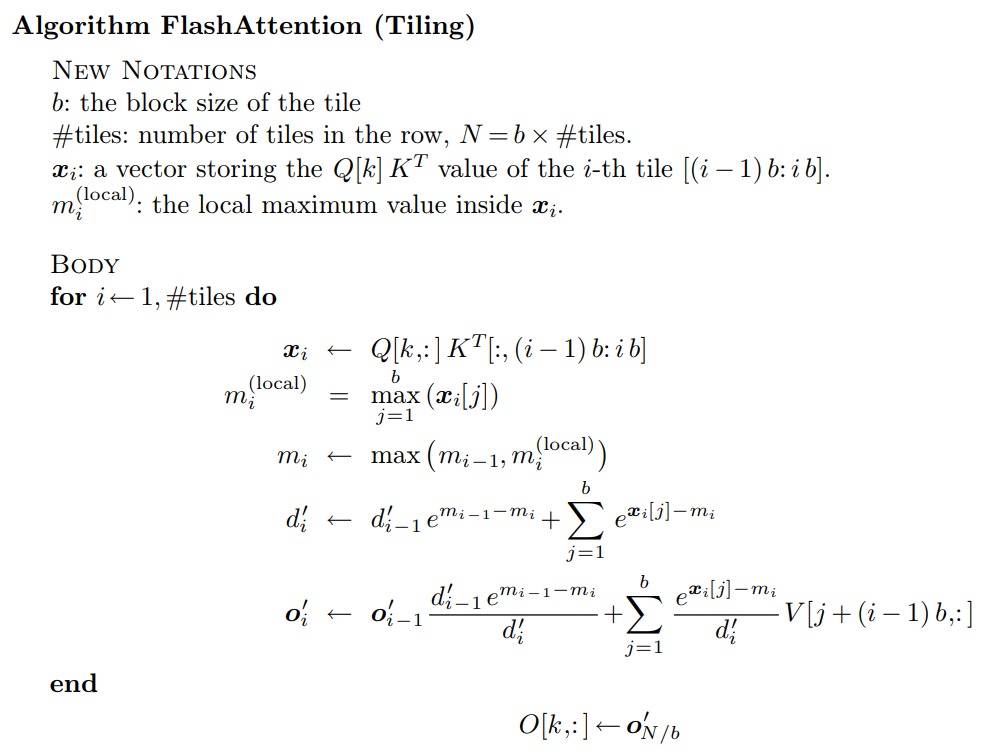
探秘Transformer系列之(18)--- FlashAttention - 罗西的思考 - 博客园
FlashAttention Basics — Memory-Efficient Attention Explained | tutorialQ
Understanding The Attention Mechanism in Transformers with Code | by ...