
Frontiers Distilled Vision Transformers With Cnn Fusion For Robust

Frontiers | Distilled vision transformers with CNN fusion for robust ...

Frontiers | Distilled vision transformers with CNN fusion for robust ...

Frontiers | Distilled vision transformers with CNN fusion for robust ...

Frontiers | Distilled vision transformers with CNN fusion for robust ...

Frontiers | Distilled vision transformers with CNN fusion for robust ...

Frontiers | Distilled vision transformers with CNN fusion for robust ...

Frontiers | Distilled vision transformers with CNN fusion for robust ...

Frontiers | Efficient vision transformers with edge enhancement for ...

Frontiers | Efficient vision transformers with edge enhancement for ...

Frontiers | Efficient vision transformers with edge enhancement for ...
Advertisement Space (300x250)

Frontiers | O-Net: A Novel Framework With Deep Fusion of CNN and ...

Frontiers | Vision transformers for automated detection of diabetic ...
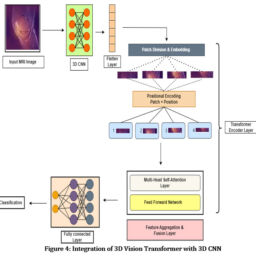
Synergistic Integration of 3D CNN and Vision Transformers for Enhanced ...

(PDF) Contextual Vision Transformers for Robust Representation Learning

Frontiers | MoNetViT: an efficient fusion of CNN and transformer ...
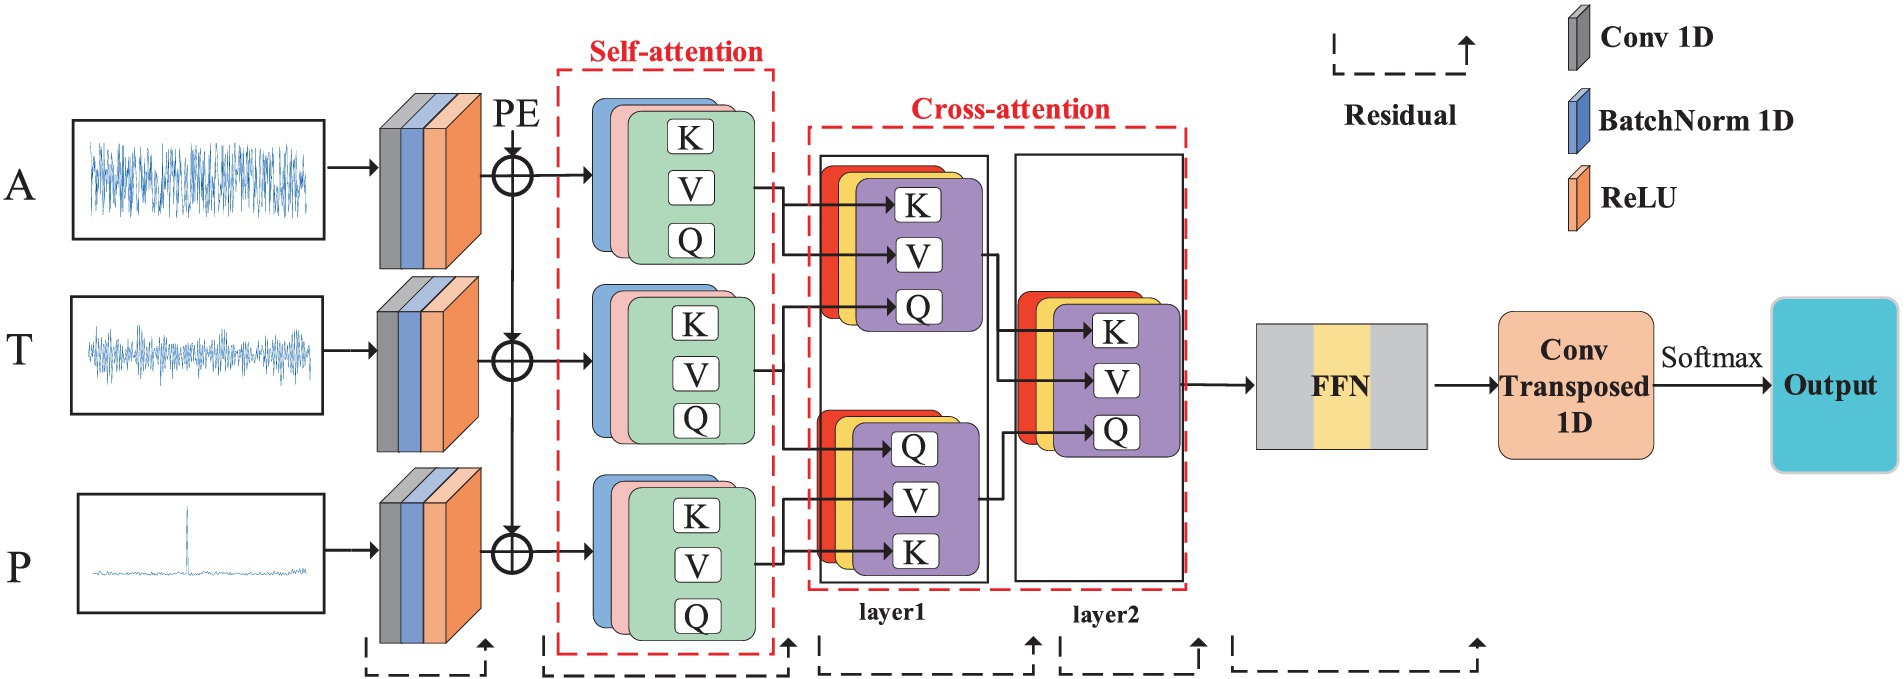
Frontiers | A combination network of CNN and transformer for ...

Heterogeneous Feature Fusion Module Based on CNN and Transformer for ...

Heterogeneous Feature Fusion Module Based on CNN and Transformer for ...

Heterogeneous Feature Fusion Module Based on CNN and Transformer for ...
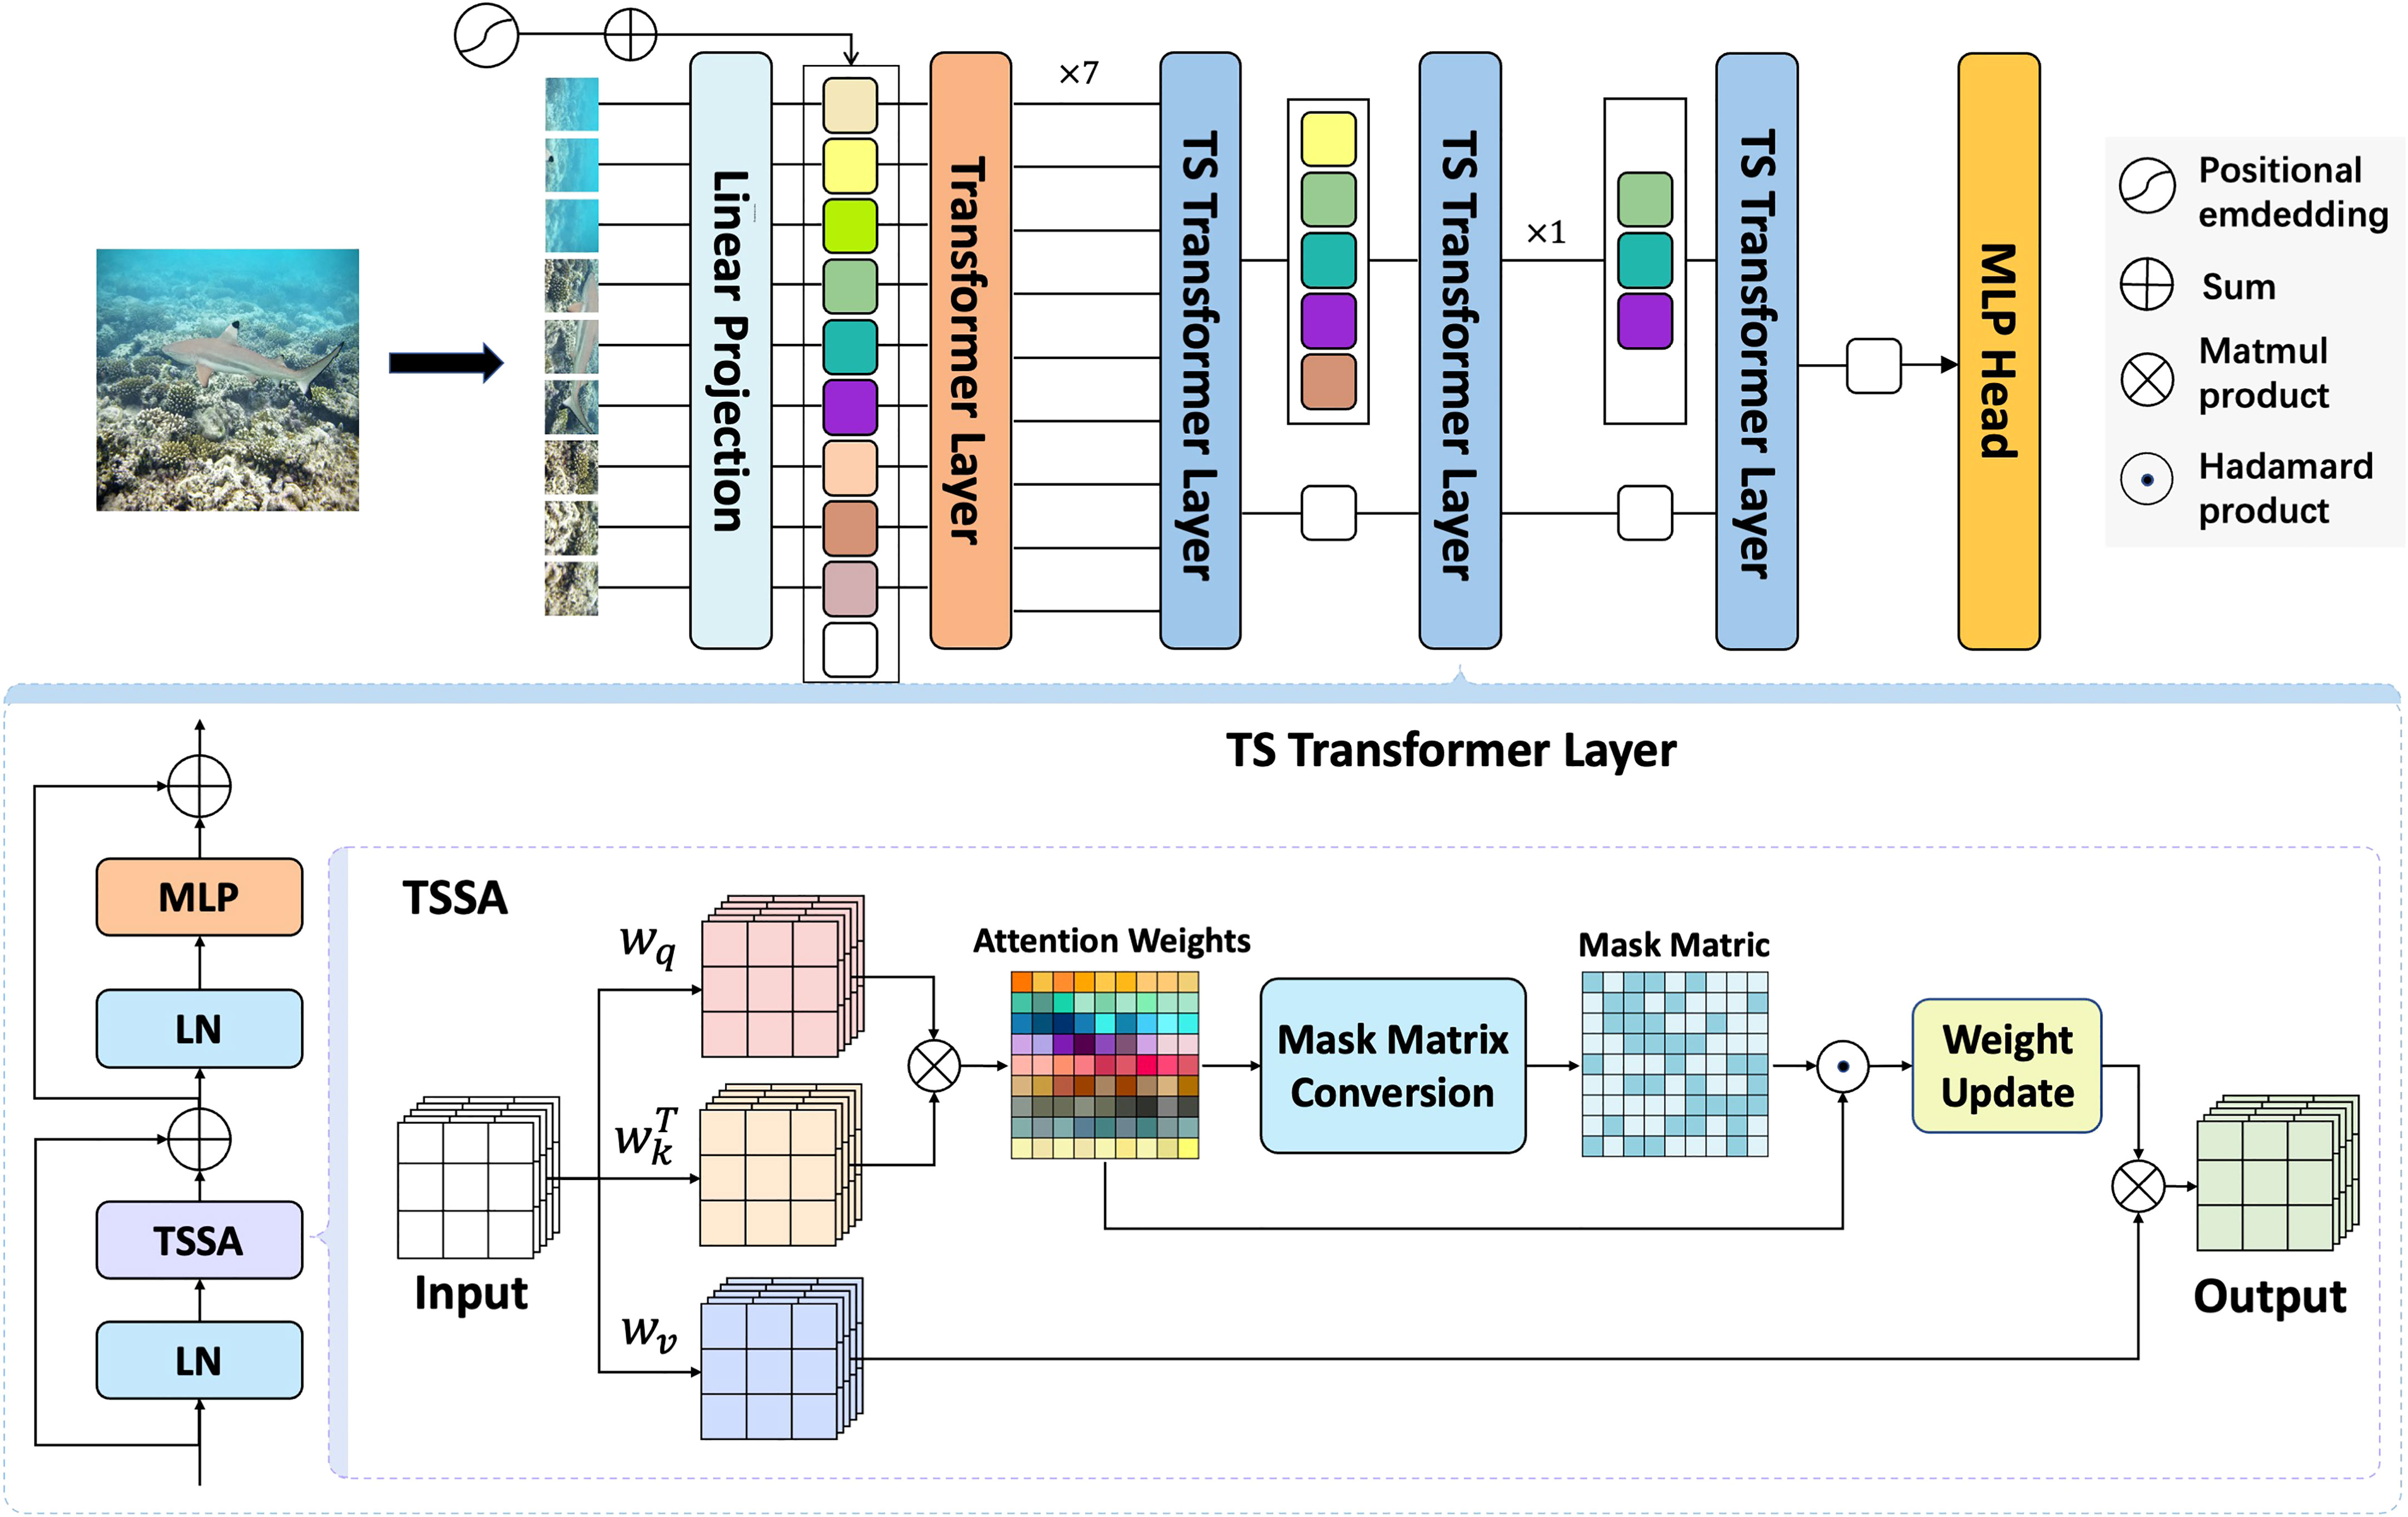
Frontiers | Token-Selective Vision Transformer for fine-grained image ...
Advertisement Space (336x280)

Heterogeneous Feature Fusion Module Based on CNN and Transformer for ...

Deformer: Dynamic Fusion Transformer for Robust Hand Pose Estimation

Achieving Greater Accuracy In Real-Time Vision Processing With Transformers

(PDF) CNN or ViT? Revisiting Vision Transformers Through the Lens of ...
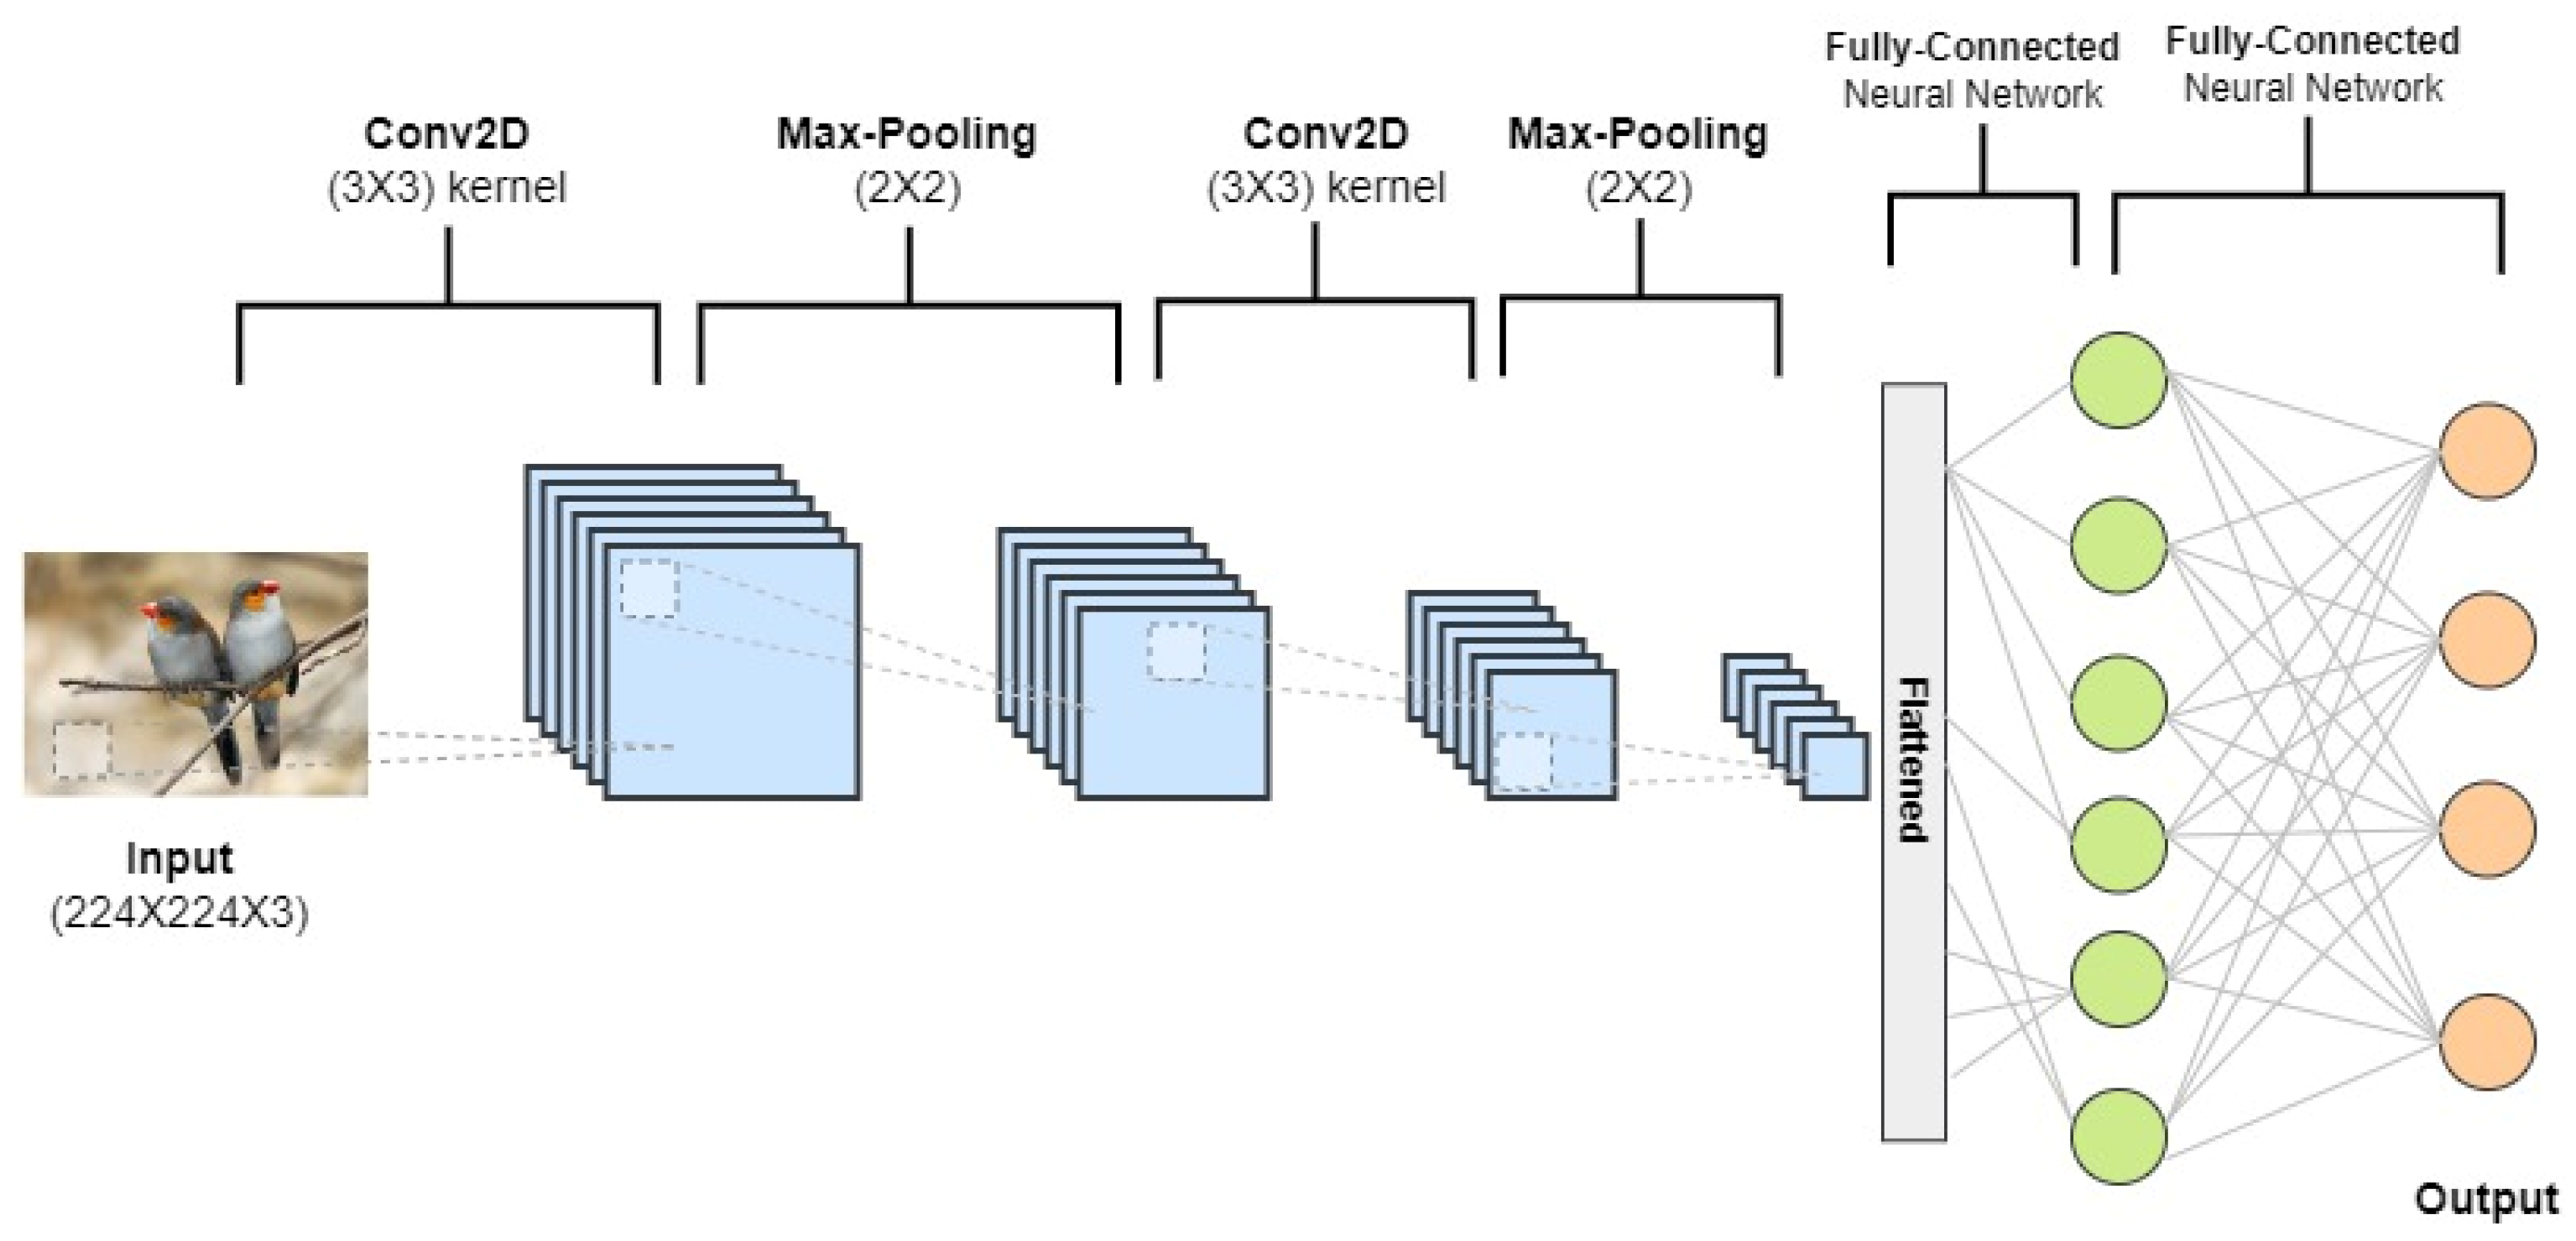
Comparing Vision Transformers and Convolutional Neural Networks for ...

Frontiers | BAF-Net: Bidirectional attention fusion network via CNN and ...
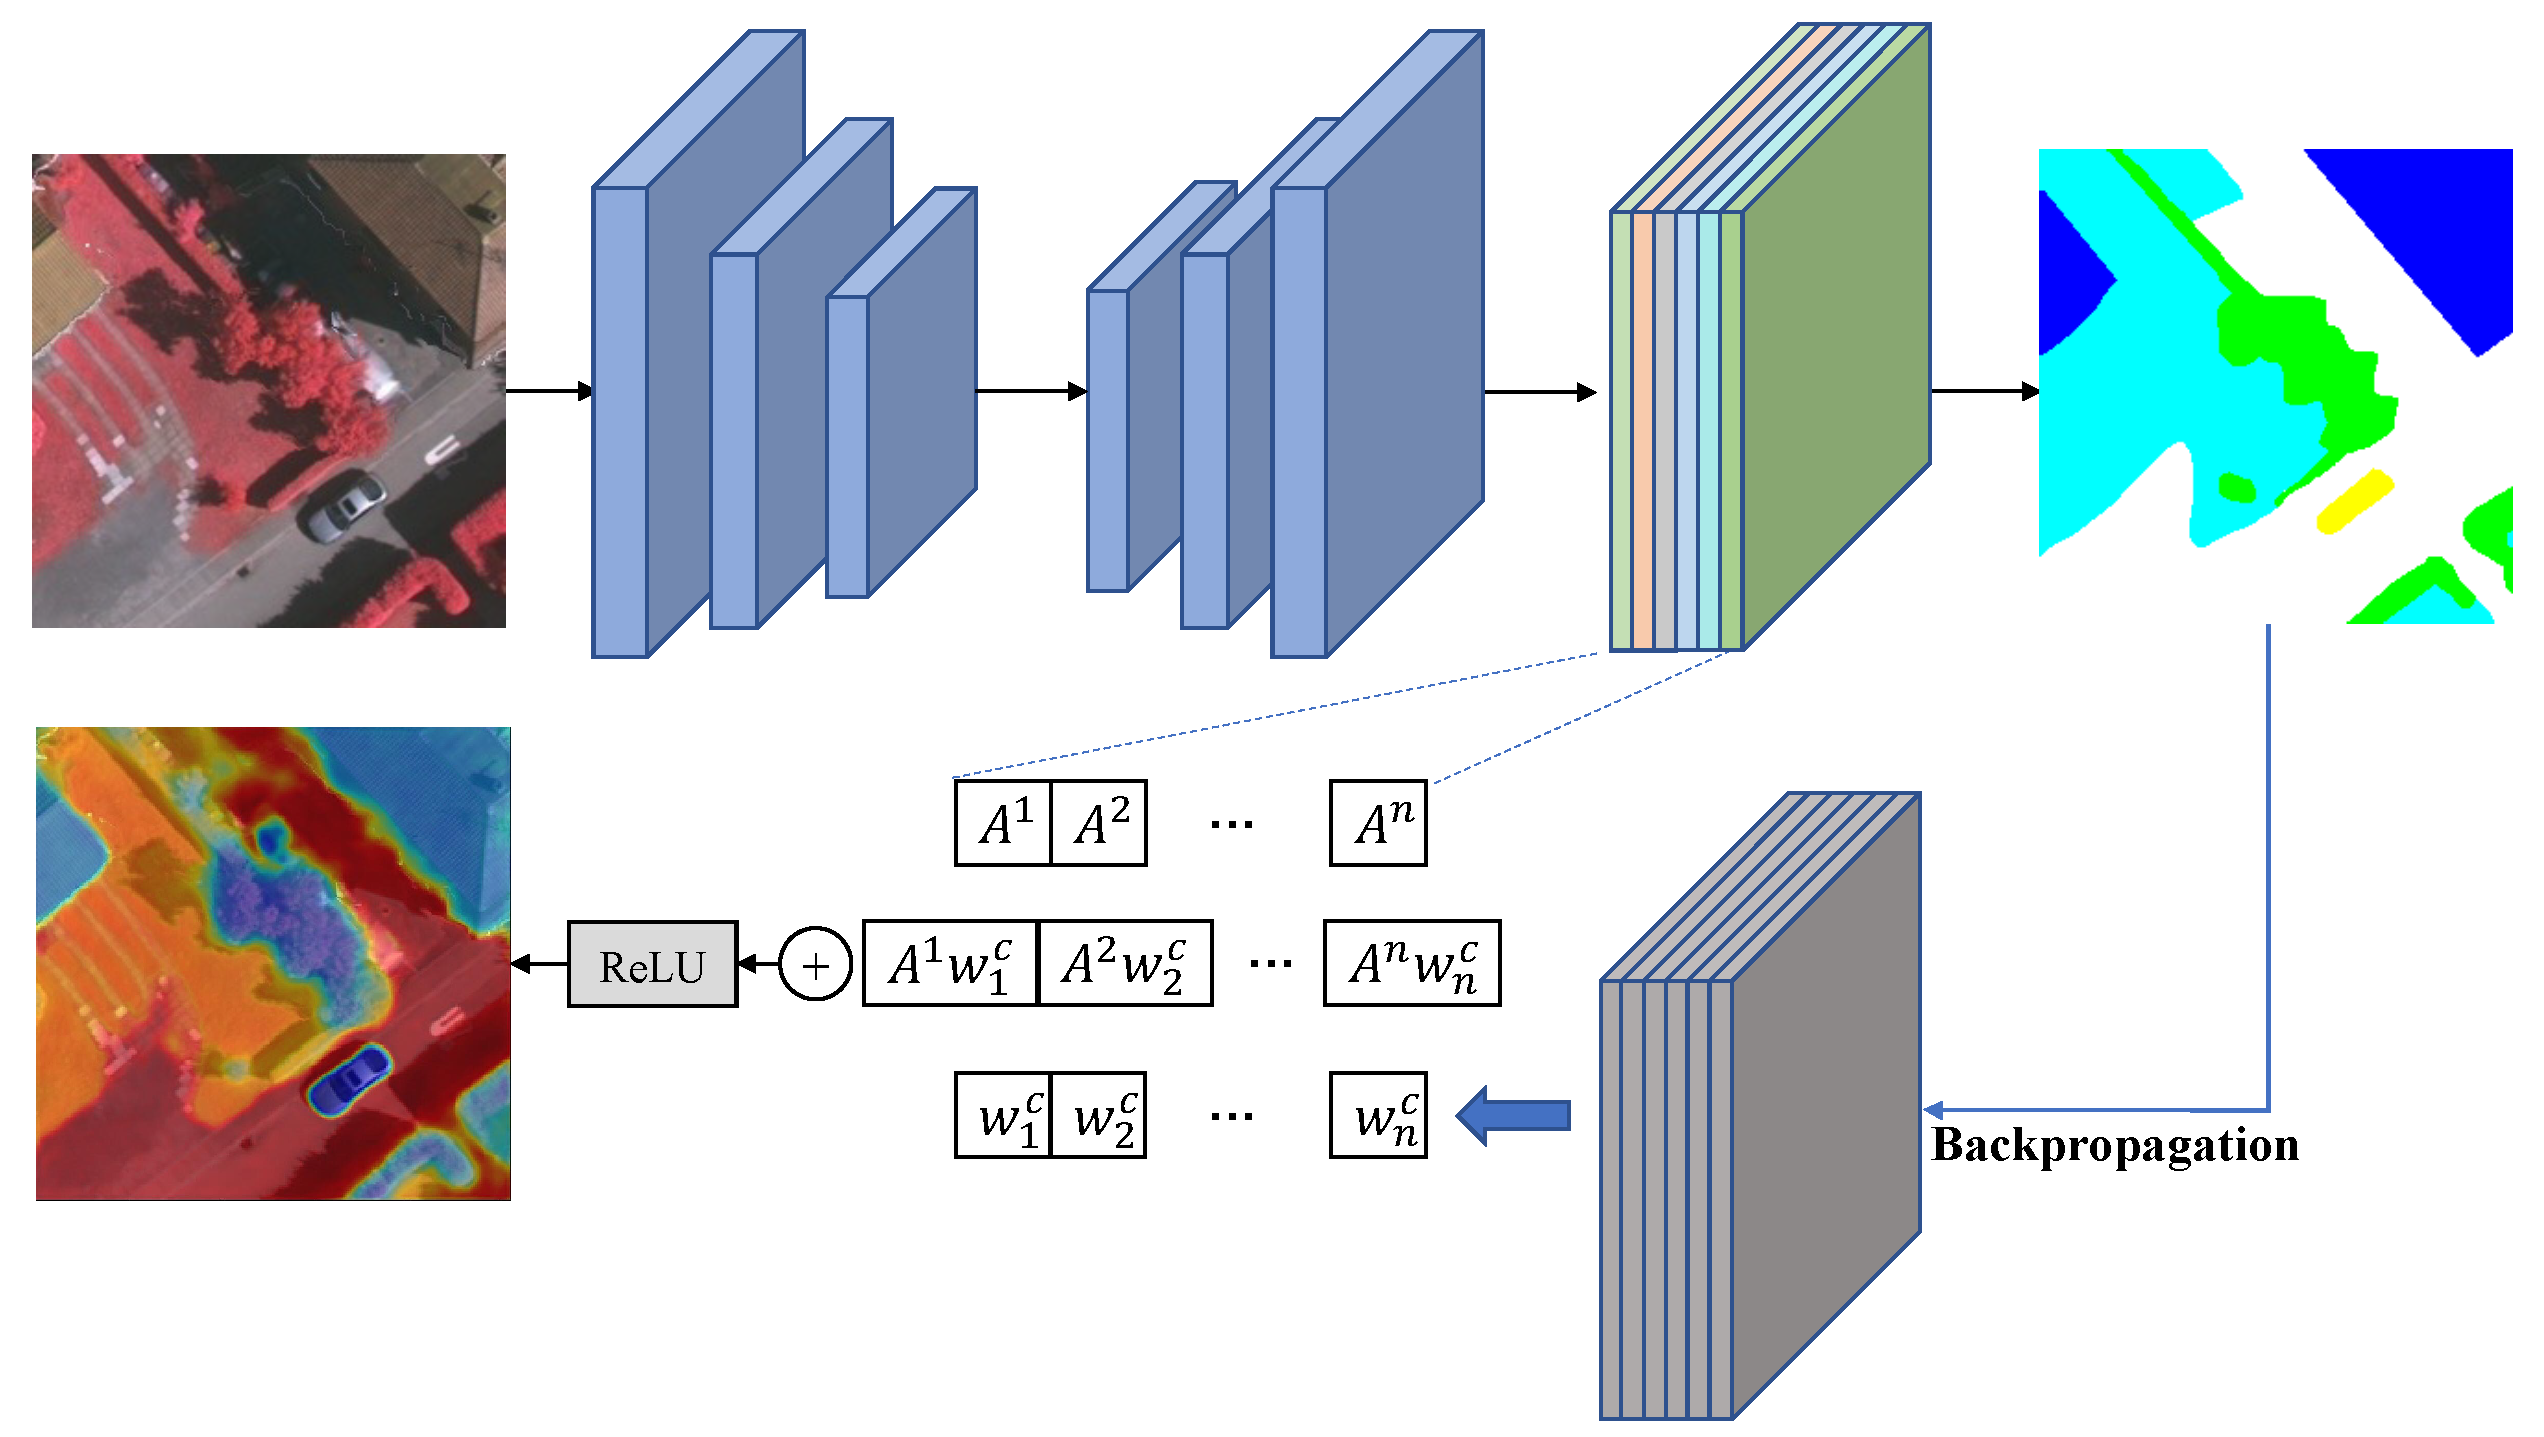
CNN and Transformer Fusion for Remote Sensing Image Semantic Segmentation
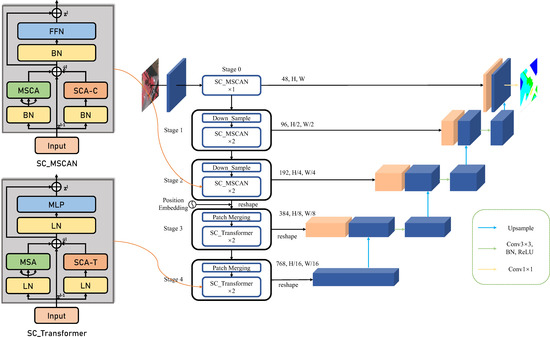
CNN and Transformer Fusion for Remote Sensing Image Semantic Segmentation

MFTransNet: A Multi-Modal Fusion with CNN-Transformer Network for ...
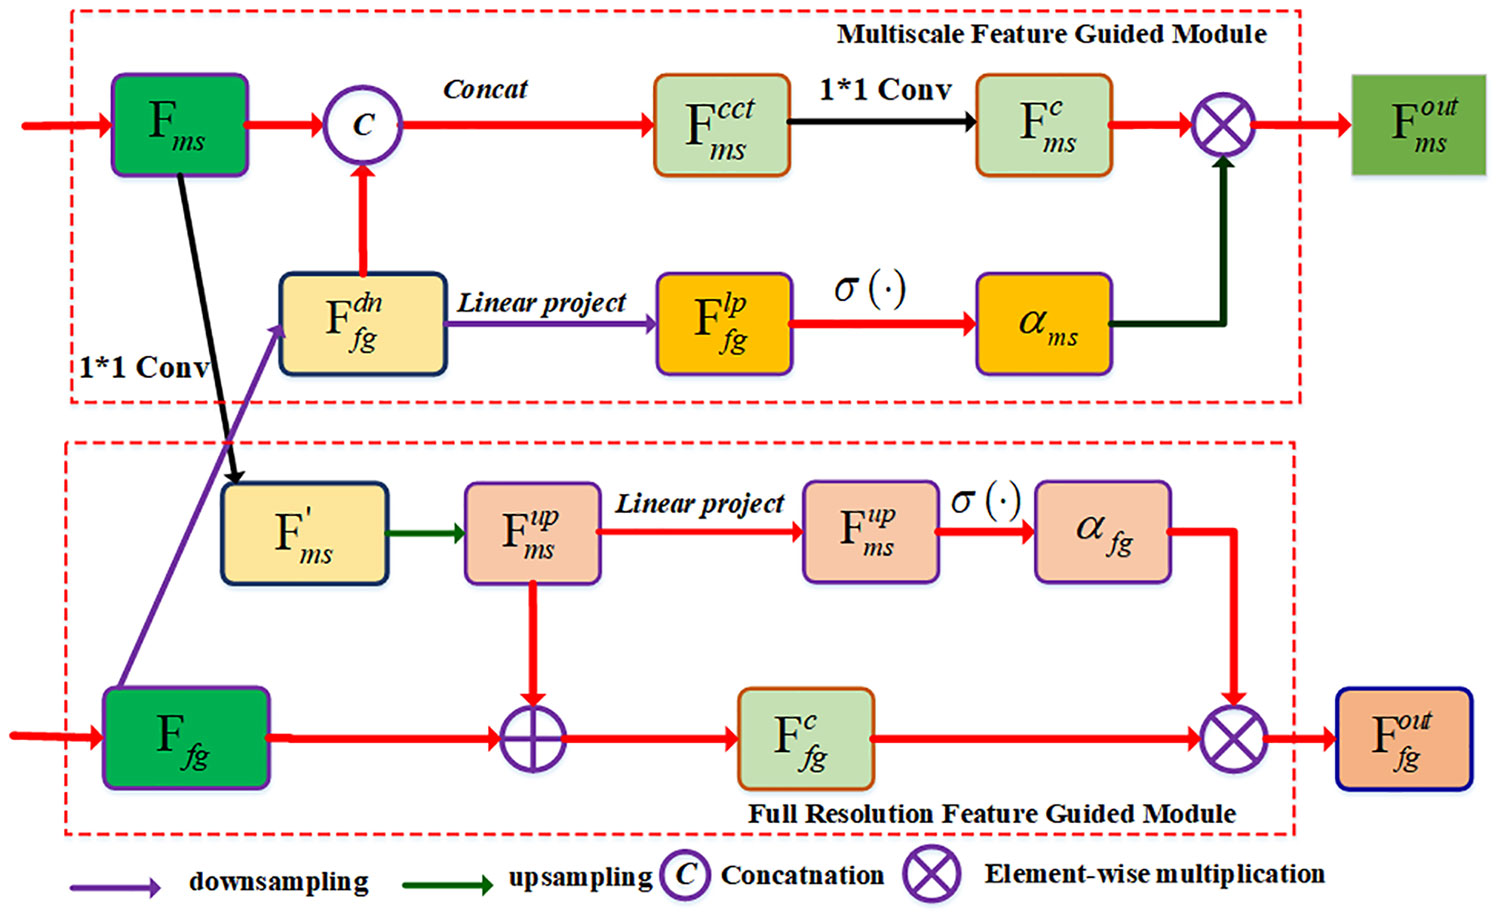
Frontiers | BAF-Net: Bidirectional attention fusion network via CNN and ...
Advertisement Space (336x280)

社内勉強会資料_TransNeXt: Robust Foveal Visual Perception for Vision ...

Frontiers | A SWIN-based vision transformer for high-fidelity and high ...

[论文评述] Approximate Nullspace Augmented Finetuning for Robust Vision ...
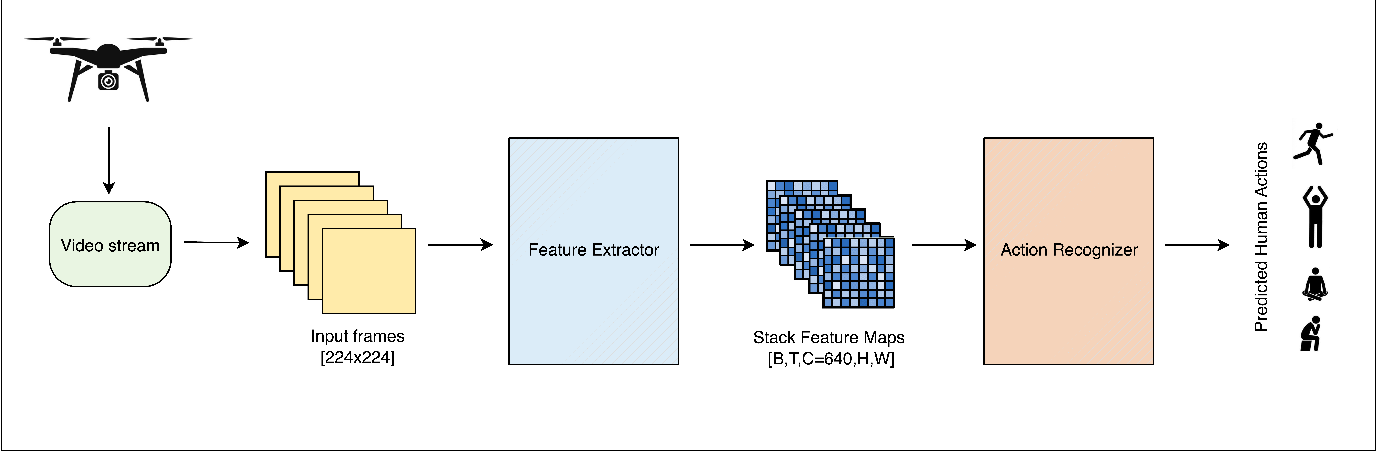
Figure 1 from CNN and Transformer Fusion for Aerial Human Action ...

解读CVPR2024-论文分享|TransNeXt: Robust Foveal Visual Perception for Vision ...

Paper page - TransNeXt: Robust Foveal Visual Perception for Vision ...