
Genprm Scaling Test Time Compute Of Process Reward Models Via

GenPRM: Scaling Test-Time Compute of Process Reward Models via ...

GenPRM: Scaling Test-Time Compute of Process Reward Models via ...

GenPRM: Scaling Test-Time Compute of Process Reward Models via ...

GenPRM: Scaling Test-Time Compute of Process Reward Models via ...

GenPRM: Scaling Test-Time Compute of Process Reward Models via ...
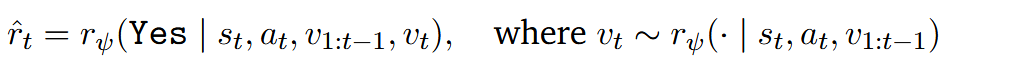
GenPRM: Scaling Test-Time Compute of Process Reward Models via ...

Paper page - GenPRM: Scaling Test-Time Compute of Process Reward Models ...

PROMISE: Process Reward Models Unlock Test-Time Scaling Laws in ...

Scaling LLM Test Time Compute

Scaling LLM Test Time Compute
Advertisement Space (300x250)

The Art of Scaling Test-Time Compute for Large Language Models | AI ...

GenPRM-Extends the testing time calculation of the process reward model ...

Scaling LLM Test Time Compute

Scaling LLM Test Time Compute

The Art of Scaling Test-Time Compute for Large Language Models | AI ...
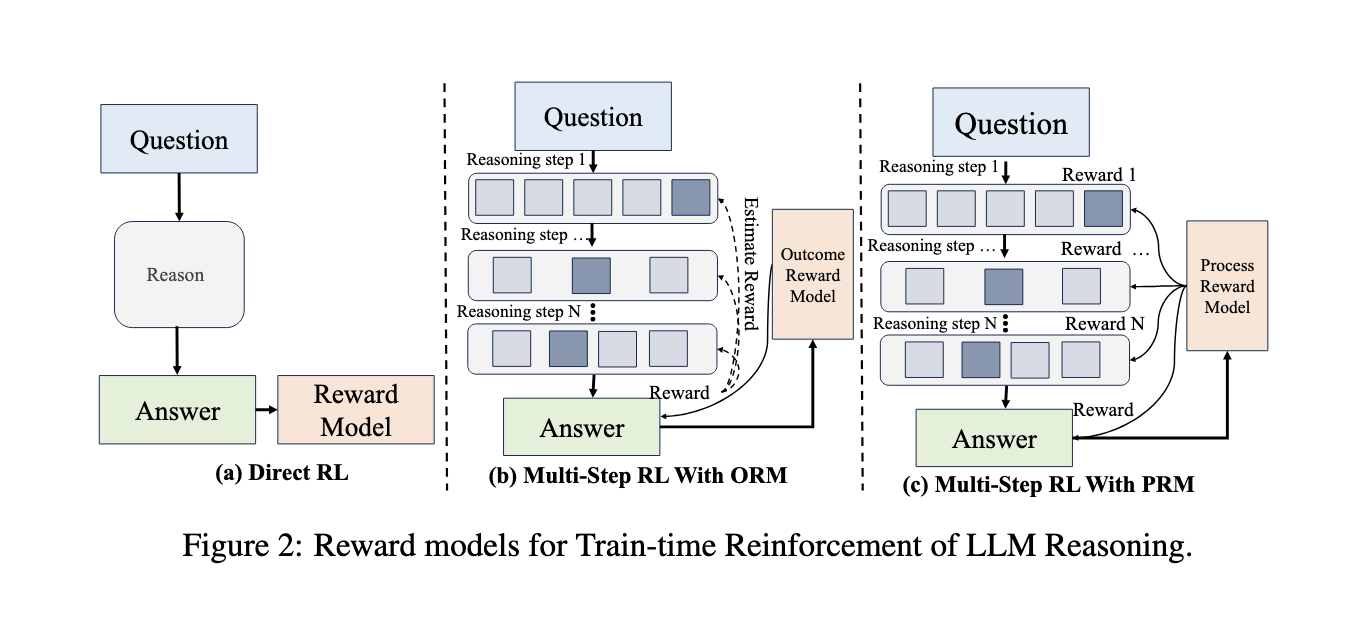
This AI Paper Explores Reinforced Learning and Process Reward Models ...

Scaling Evaluation-Time Compute with Reasoning Models as Evaluators

Rethinking Reward Models for Multi-Domain Test-Time Scaling | AI ...

Paper page - Rethinking Reward Models for Multi-Domain Test-Time Scaling

VRPRM: Process Reward Modeling via Visual Reasoning
Advertisement Space (336x280)
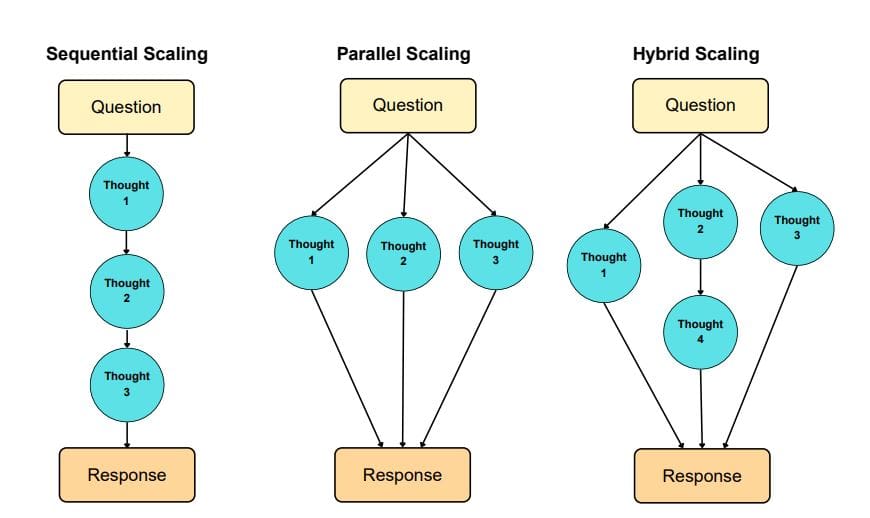
Test-time Compute Scaling Across 8 Large Language Models

Scaling Test-Time Compute for Reasoning Models — AI Post Transformers

[论文评述] Recurrent-Depth VLA: Implicit Test-Time Compute Scaling of ...

[논문 리뷰] Lookahead Sample Reward Guidance for Test-Time Scaling of ...

Towards Robust Process Reward Modeling via Noise-aware Learning | AI ...

ToolPRMBench: Evaluating and Advancing Process Reward Models for Tool ...

[논문 리뷰] Process Reward Models for LLM Agents: Practical Framework and ...

[논문 리뷰] Efficient Process Reward Model Training via Active Learning

GitHub - mukhal/ThinkPRM: [TMLR] Process Reward Models That Think · GitHub

Process Reward Models That Think | AI Research Paper Details
Advertisement Space (336x280)

ThinkPRM: Process Reward Models That Think

VersaPRM: Multi-Domain Process Reward Model via Synthetic Reasoning Data

Distributional Process Reward Models: Calibrated Prediction of Future ...

Generative AI Act II: Test Time Scaling Drives Cognition Engineering

Efficient Process Reward Model Training via Active Learning

Test-Time Scaling of Reasoning Models for Machine Translation | AI ...