
Github Sameerdharursorting Vqa A Modular Framework For Vision
GitHub - sameerdharur/sorting-vqa: A modular framework for vision ...
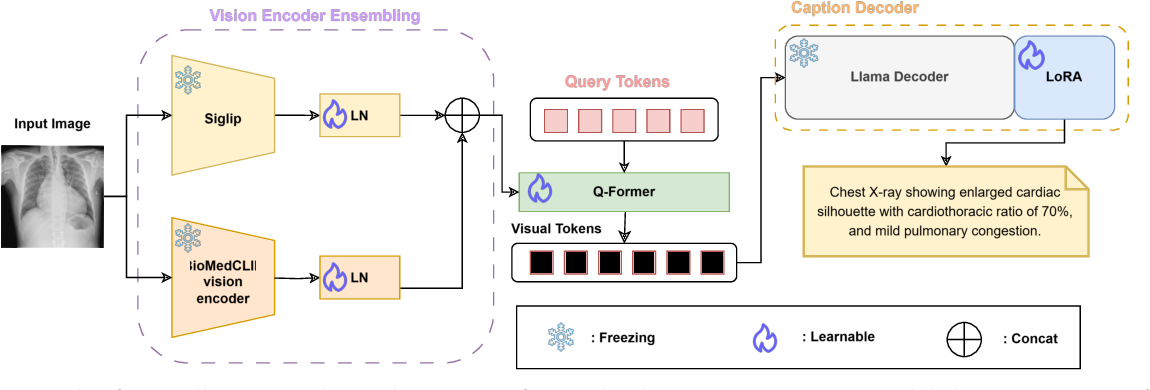
Figure 2 from AI Stat Lab: A Modular Framework for Clinically Accurate ...

Figure 1 from MC-CoT: A Modular Collaborative CoT Framework for Zero ...

Paper page - MC-CoT: A Modular Collaborative CoT Framework for Zero ...

Quid est VERITAS? A Modular Framework for Archival Document Analysis ...

Automated Report-Derived Oncology VQA Benchmark for Evaluating Vision ...

Modular Visual Question Answering VQA System For Autonomous Mobility | PDF
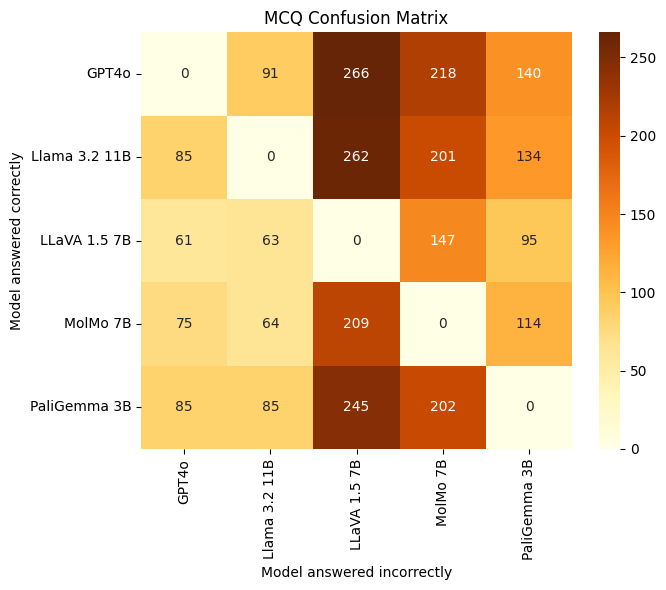
ROMEO: Rational Optimized Multi-task Enhancement framework for VQA ...
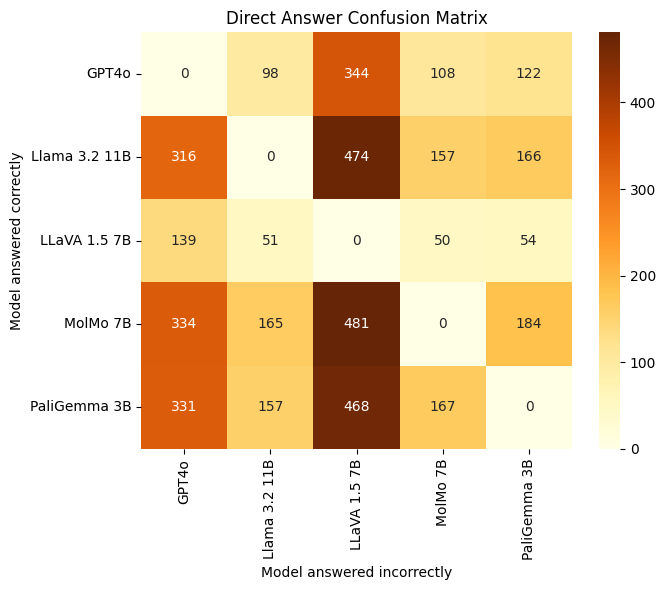
ROMEO: Rational Optimized Multi-task Enhancement framework for VQA ...

GitHub - Archer-Tatsu/VQA-ODV: A large-scale VQA database of ...
Advertisement Space (300x250)

LQA: A Lightweight Quantized-Adaptive Framework for Vision-Language ...
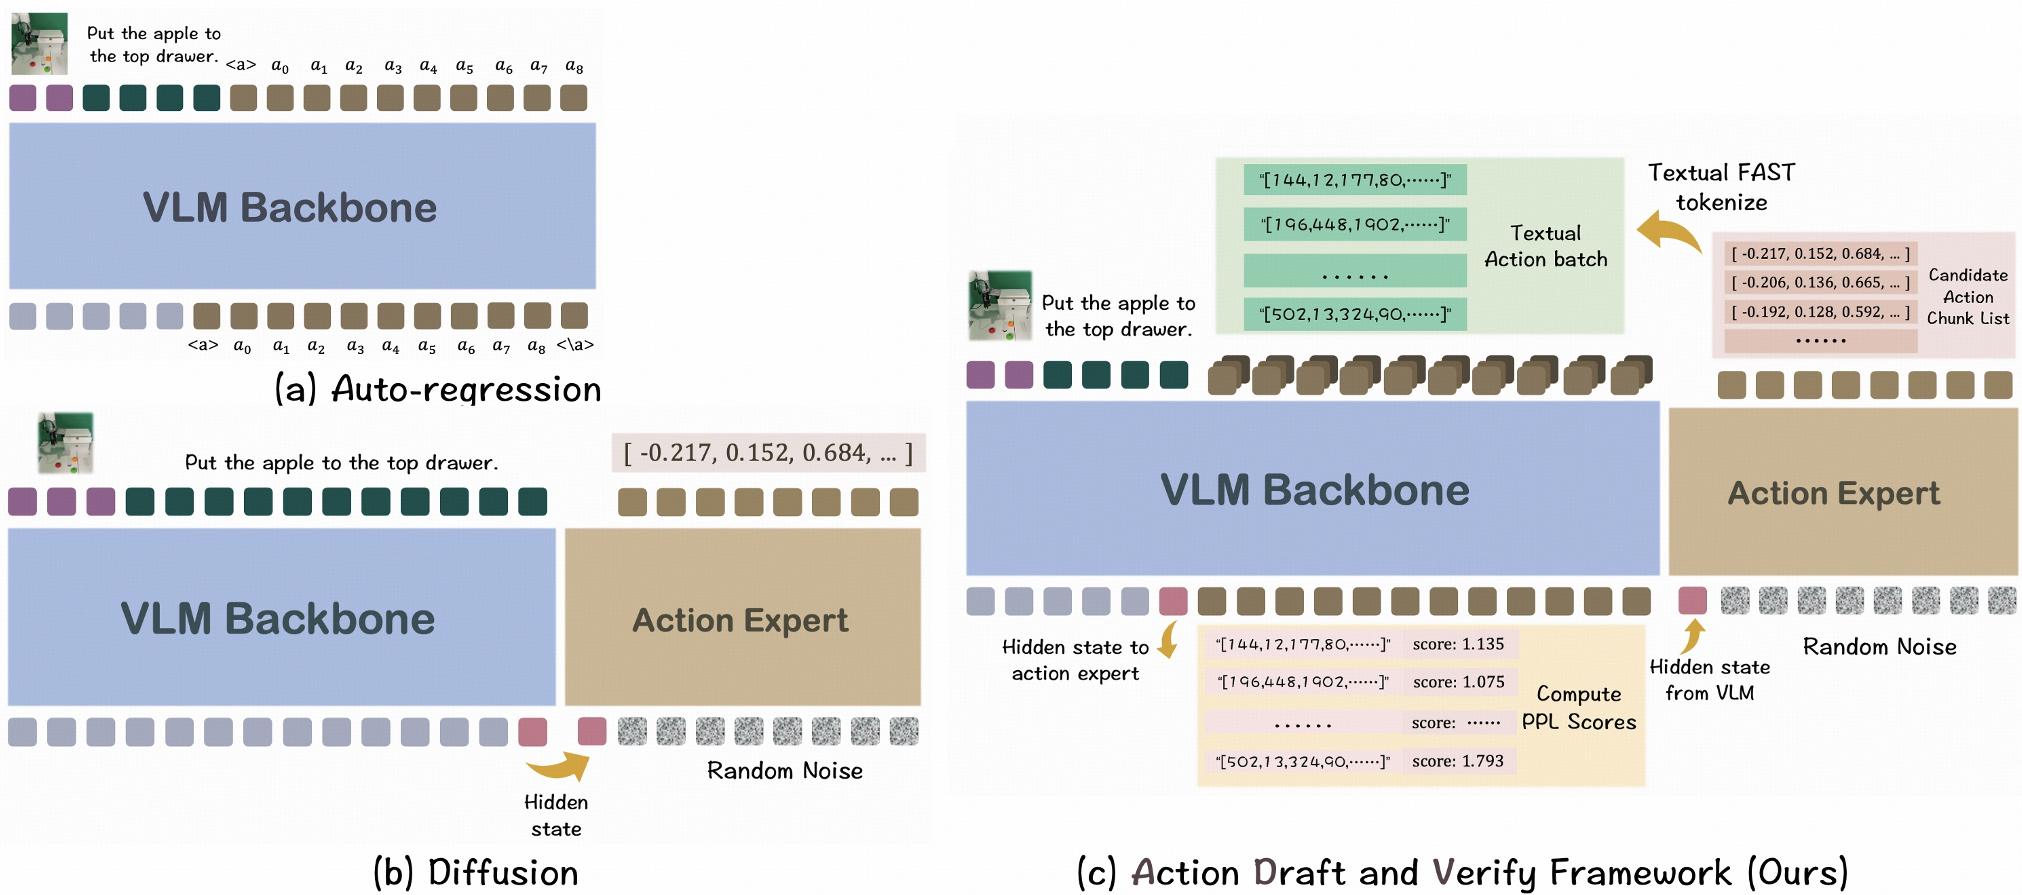
Action Draft and Verify: A Self-Verifying Framework for Vision-Language ...

GitHub - Mahmood-Anaam/arabic-visual-question-answering: Modular and ...
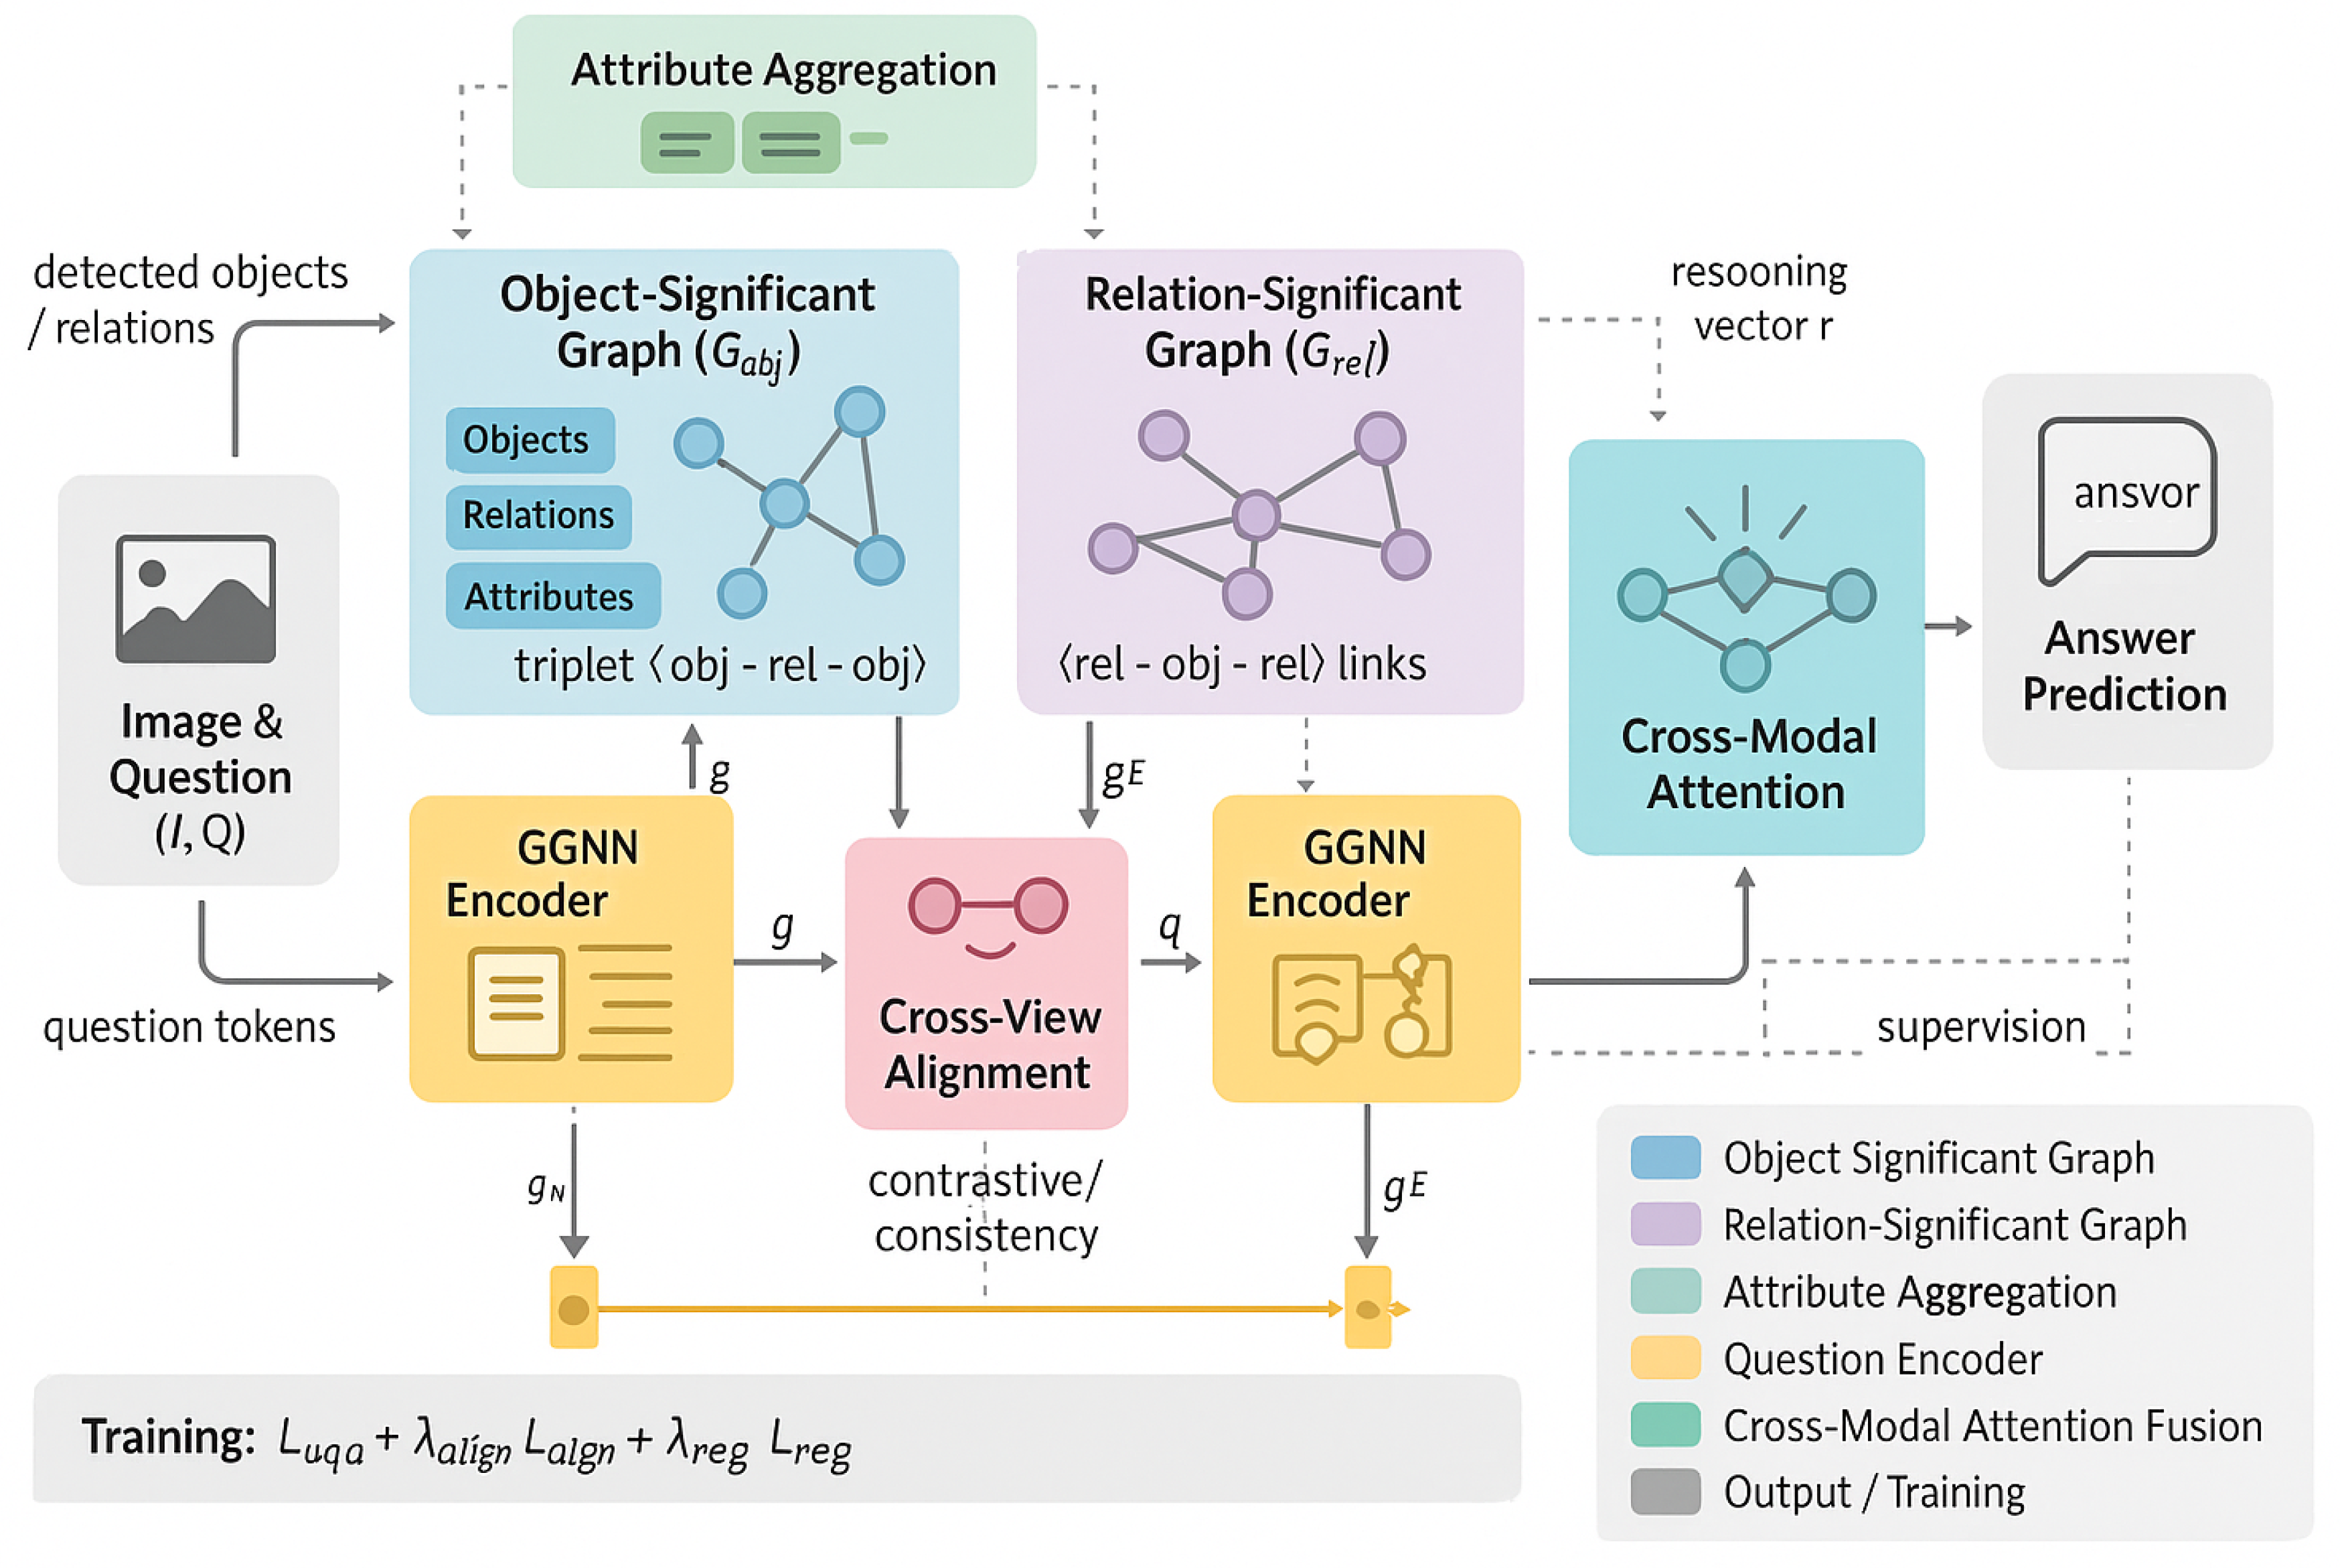
Relation-Sensitive VQA with A Unified Tri-Modal Graph Framework[v1 ...
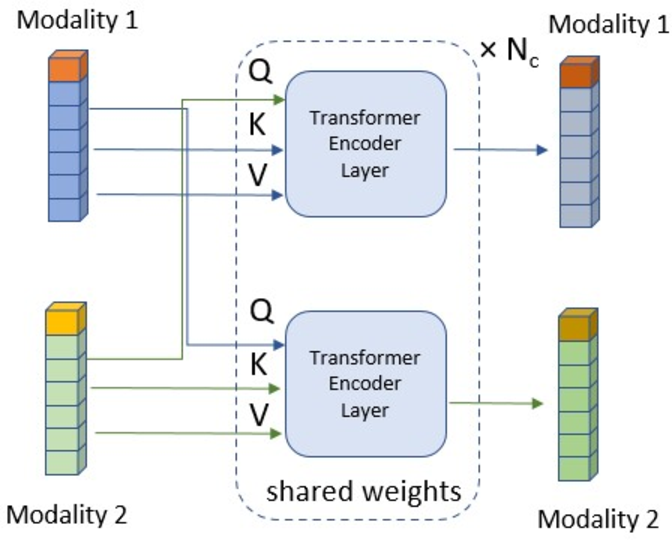
Figure 1 from Supplementary: Weakly Supervised Grounding for VQA in ...

GitHub - harshraj22/vqa: For storing the complete exploration of Visual ...

GitHub - codezakh/SelTDA: [CVPR 23] Q: How to Specialize Large Vision ...

GitHub - shtechair/vqa-sva: Structured Attentions for Visual Question ...
GitHub - UsefGamal/Visual-Question-Answering-VQA: A Multimodal project ...
GitHub - sumit-agrwl/multimodal-vqa: Developing multimodal models for ...
Advertisement Space (336x280)

GitHub - clh124/VQAThinker: [AAAI 2026] Official Code for VQAThinker ...
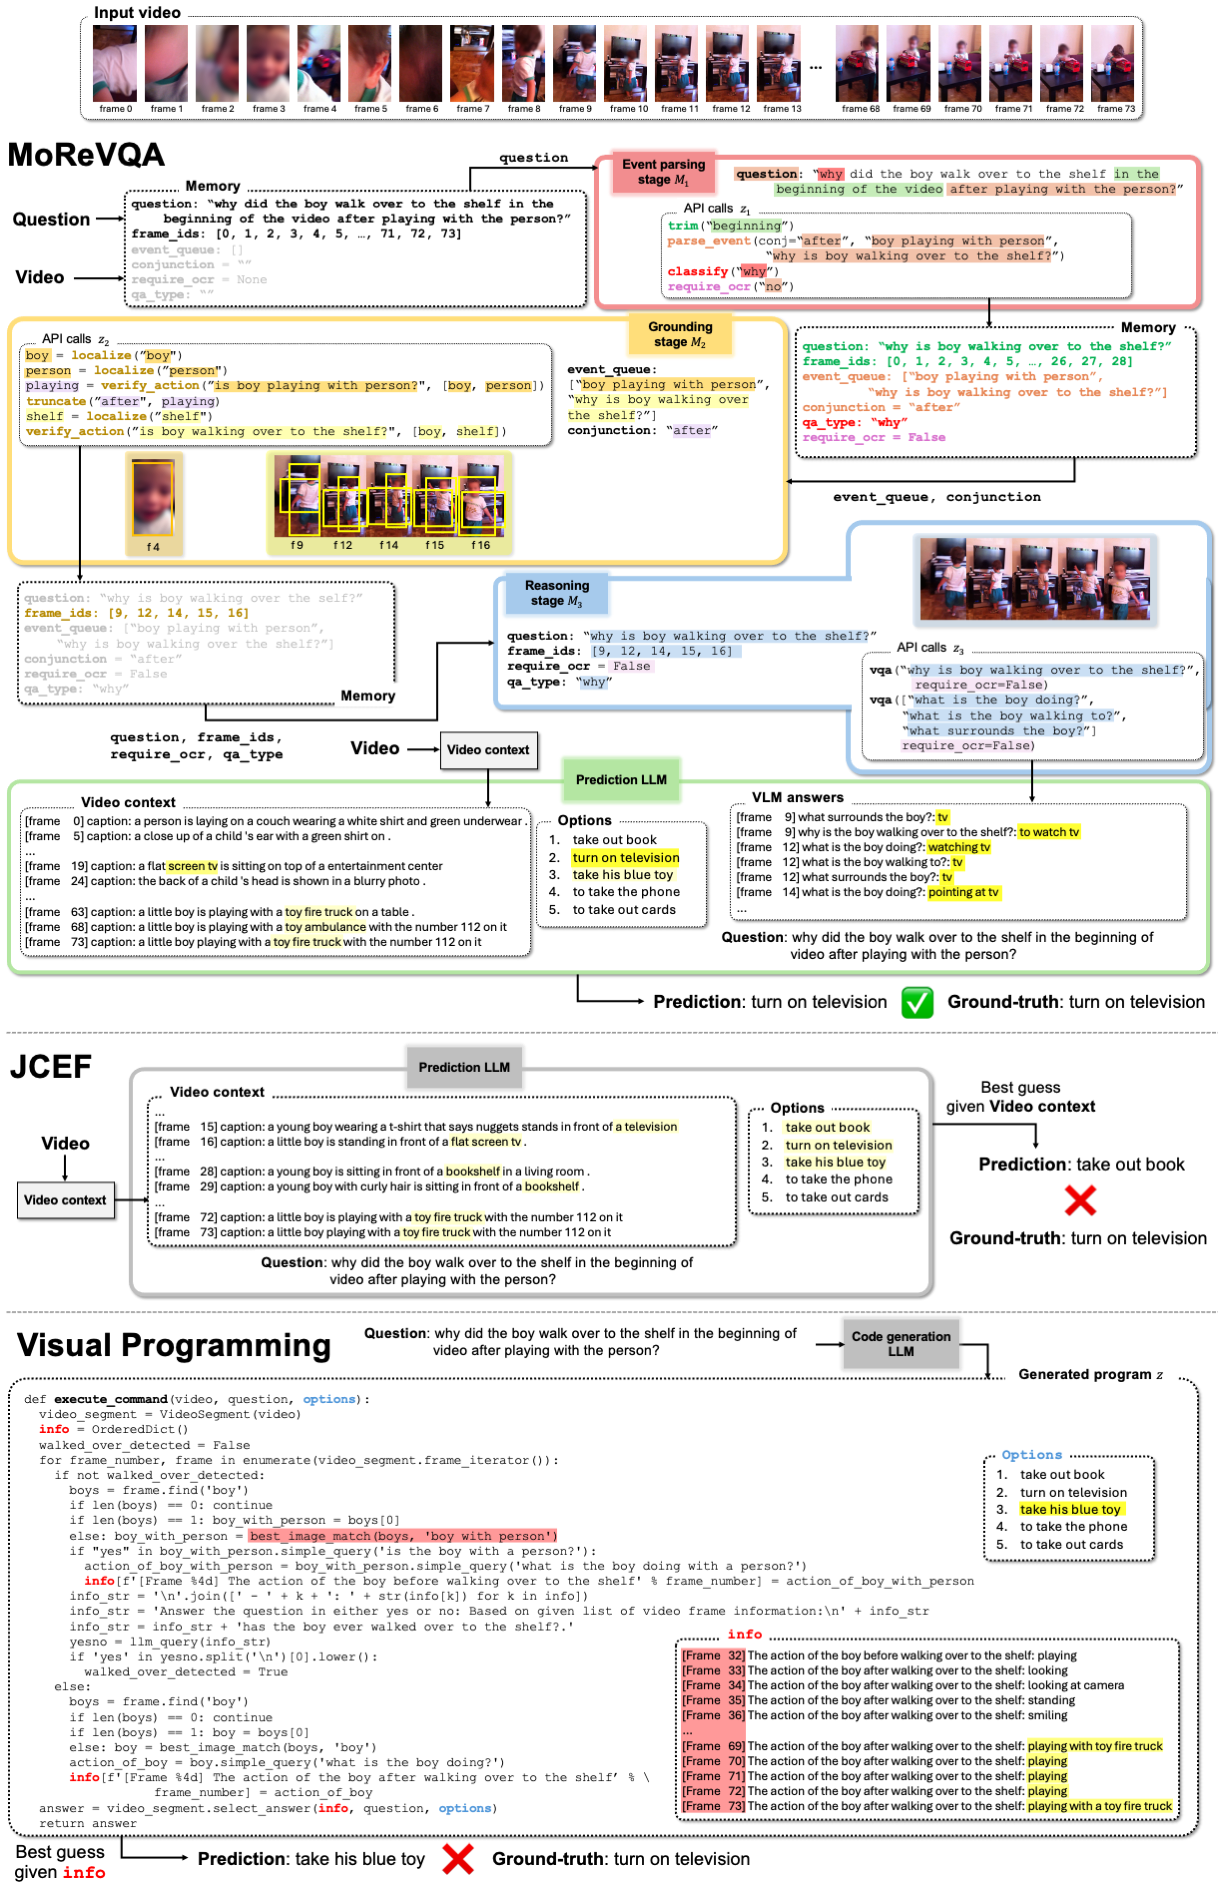
MoReVQA: Exploring Modular Reasoning Models for Video Question Answering

Unified Vision-Language Pre-Training for Image Captioning and VQA
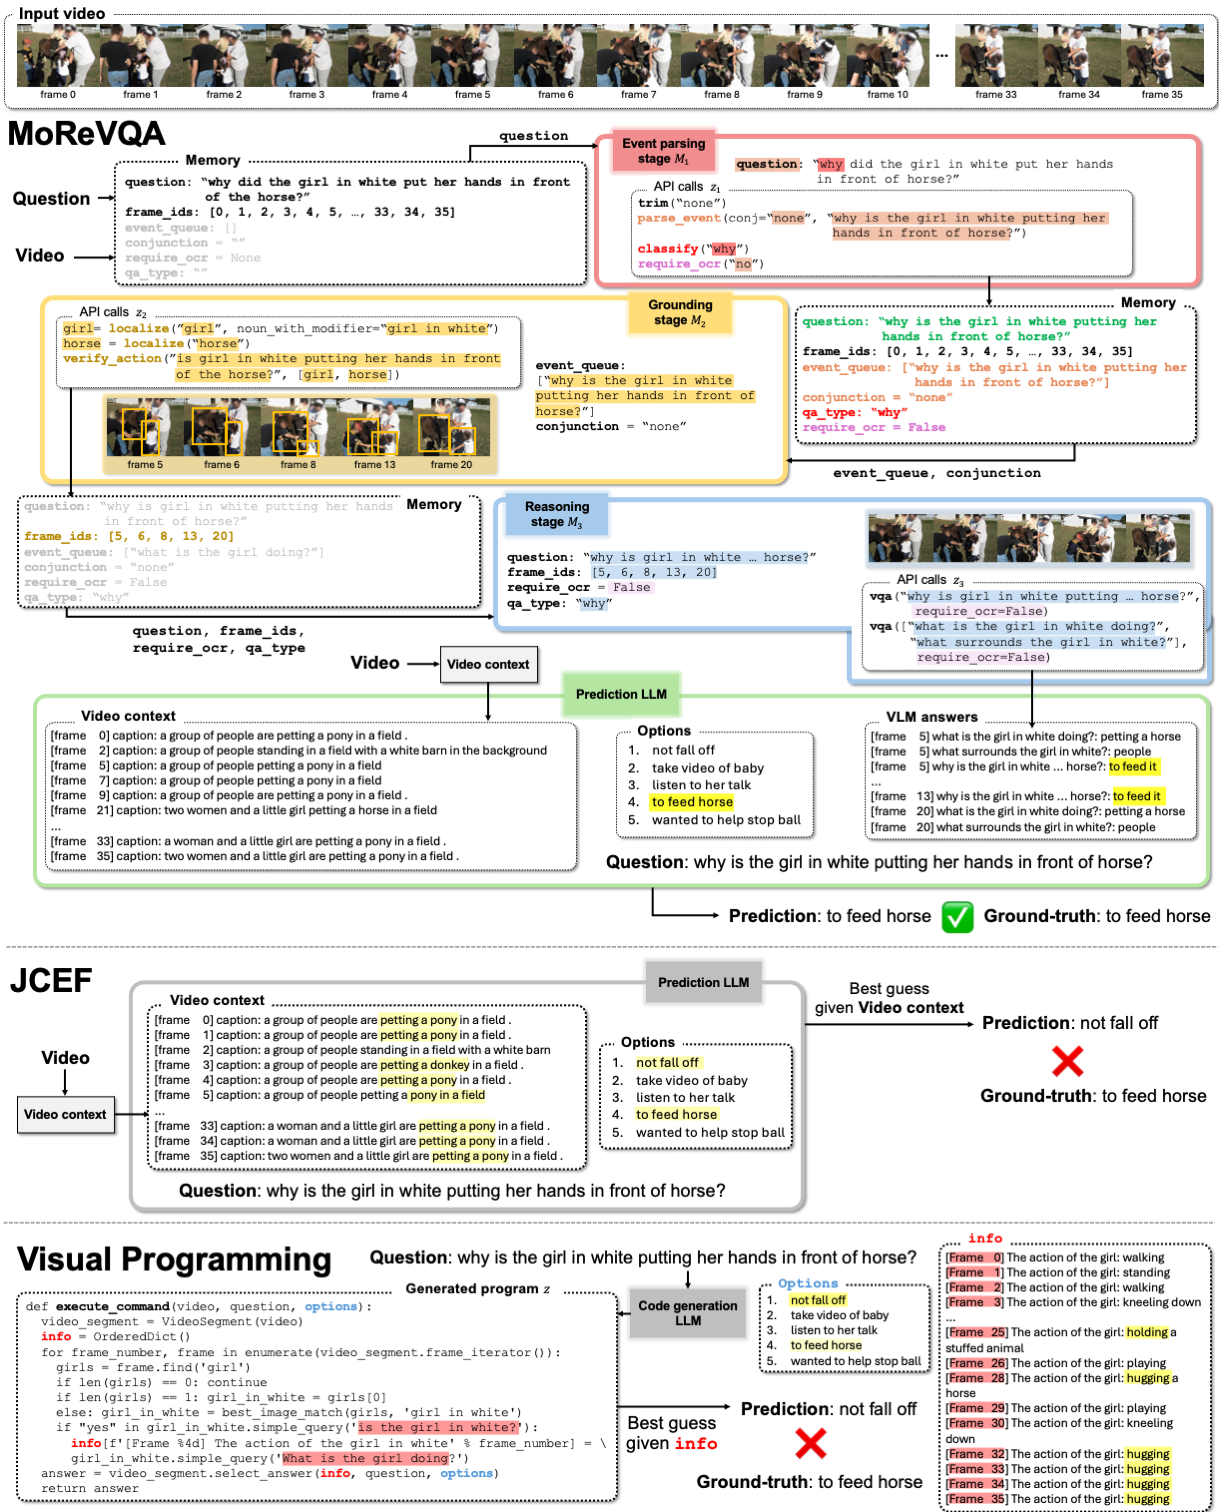
MoReVQA: Exploring Modular Reasoning Models for Video Question Answering
GitHub - sweta125/multimodal-VQA: Understanding text in images for ...

GitHub - autogyro/Planning-Vision-Model: Dynamic VQA Dataset and Self ...
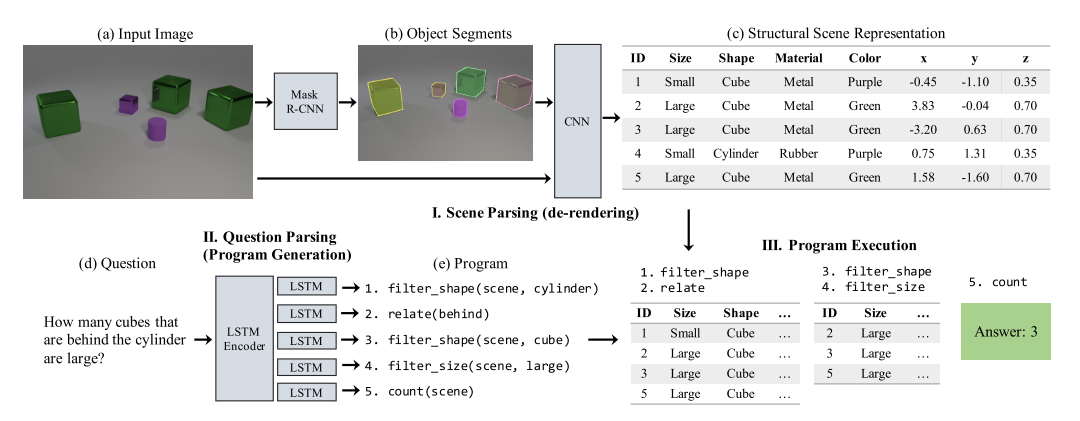
Neuro-Symbolic VQA : Disentangling Reasoning from Vision and Language ...

GitHub - PhoebusSi/SAR: Code for our ACL2021 paper: "Check It Again ...

A basic model design for VQA. Visual and textual features are extracted ...
General framework of VQA system [3][4] 2.2 VQA Methods Visual question ...
Advertisement Space (336x280)
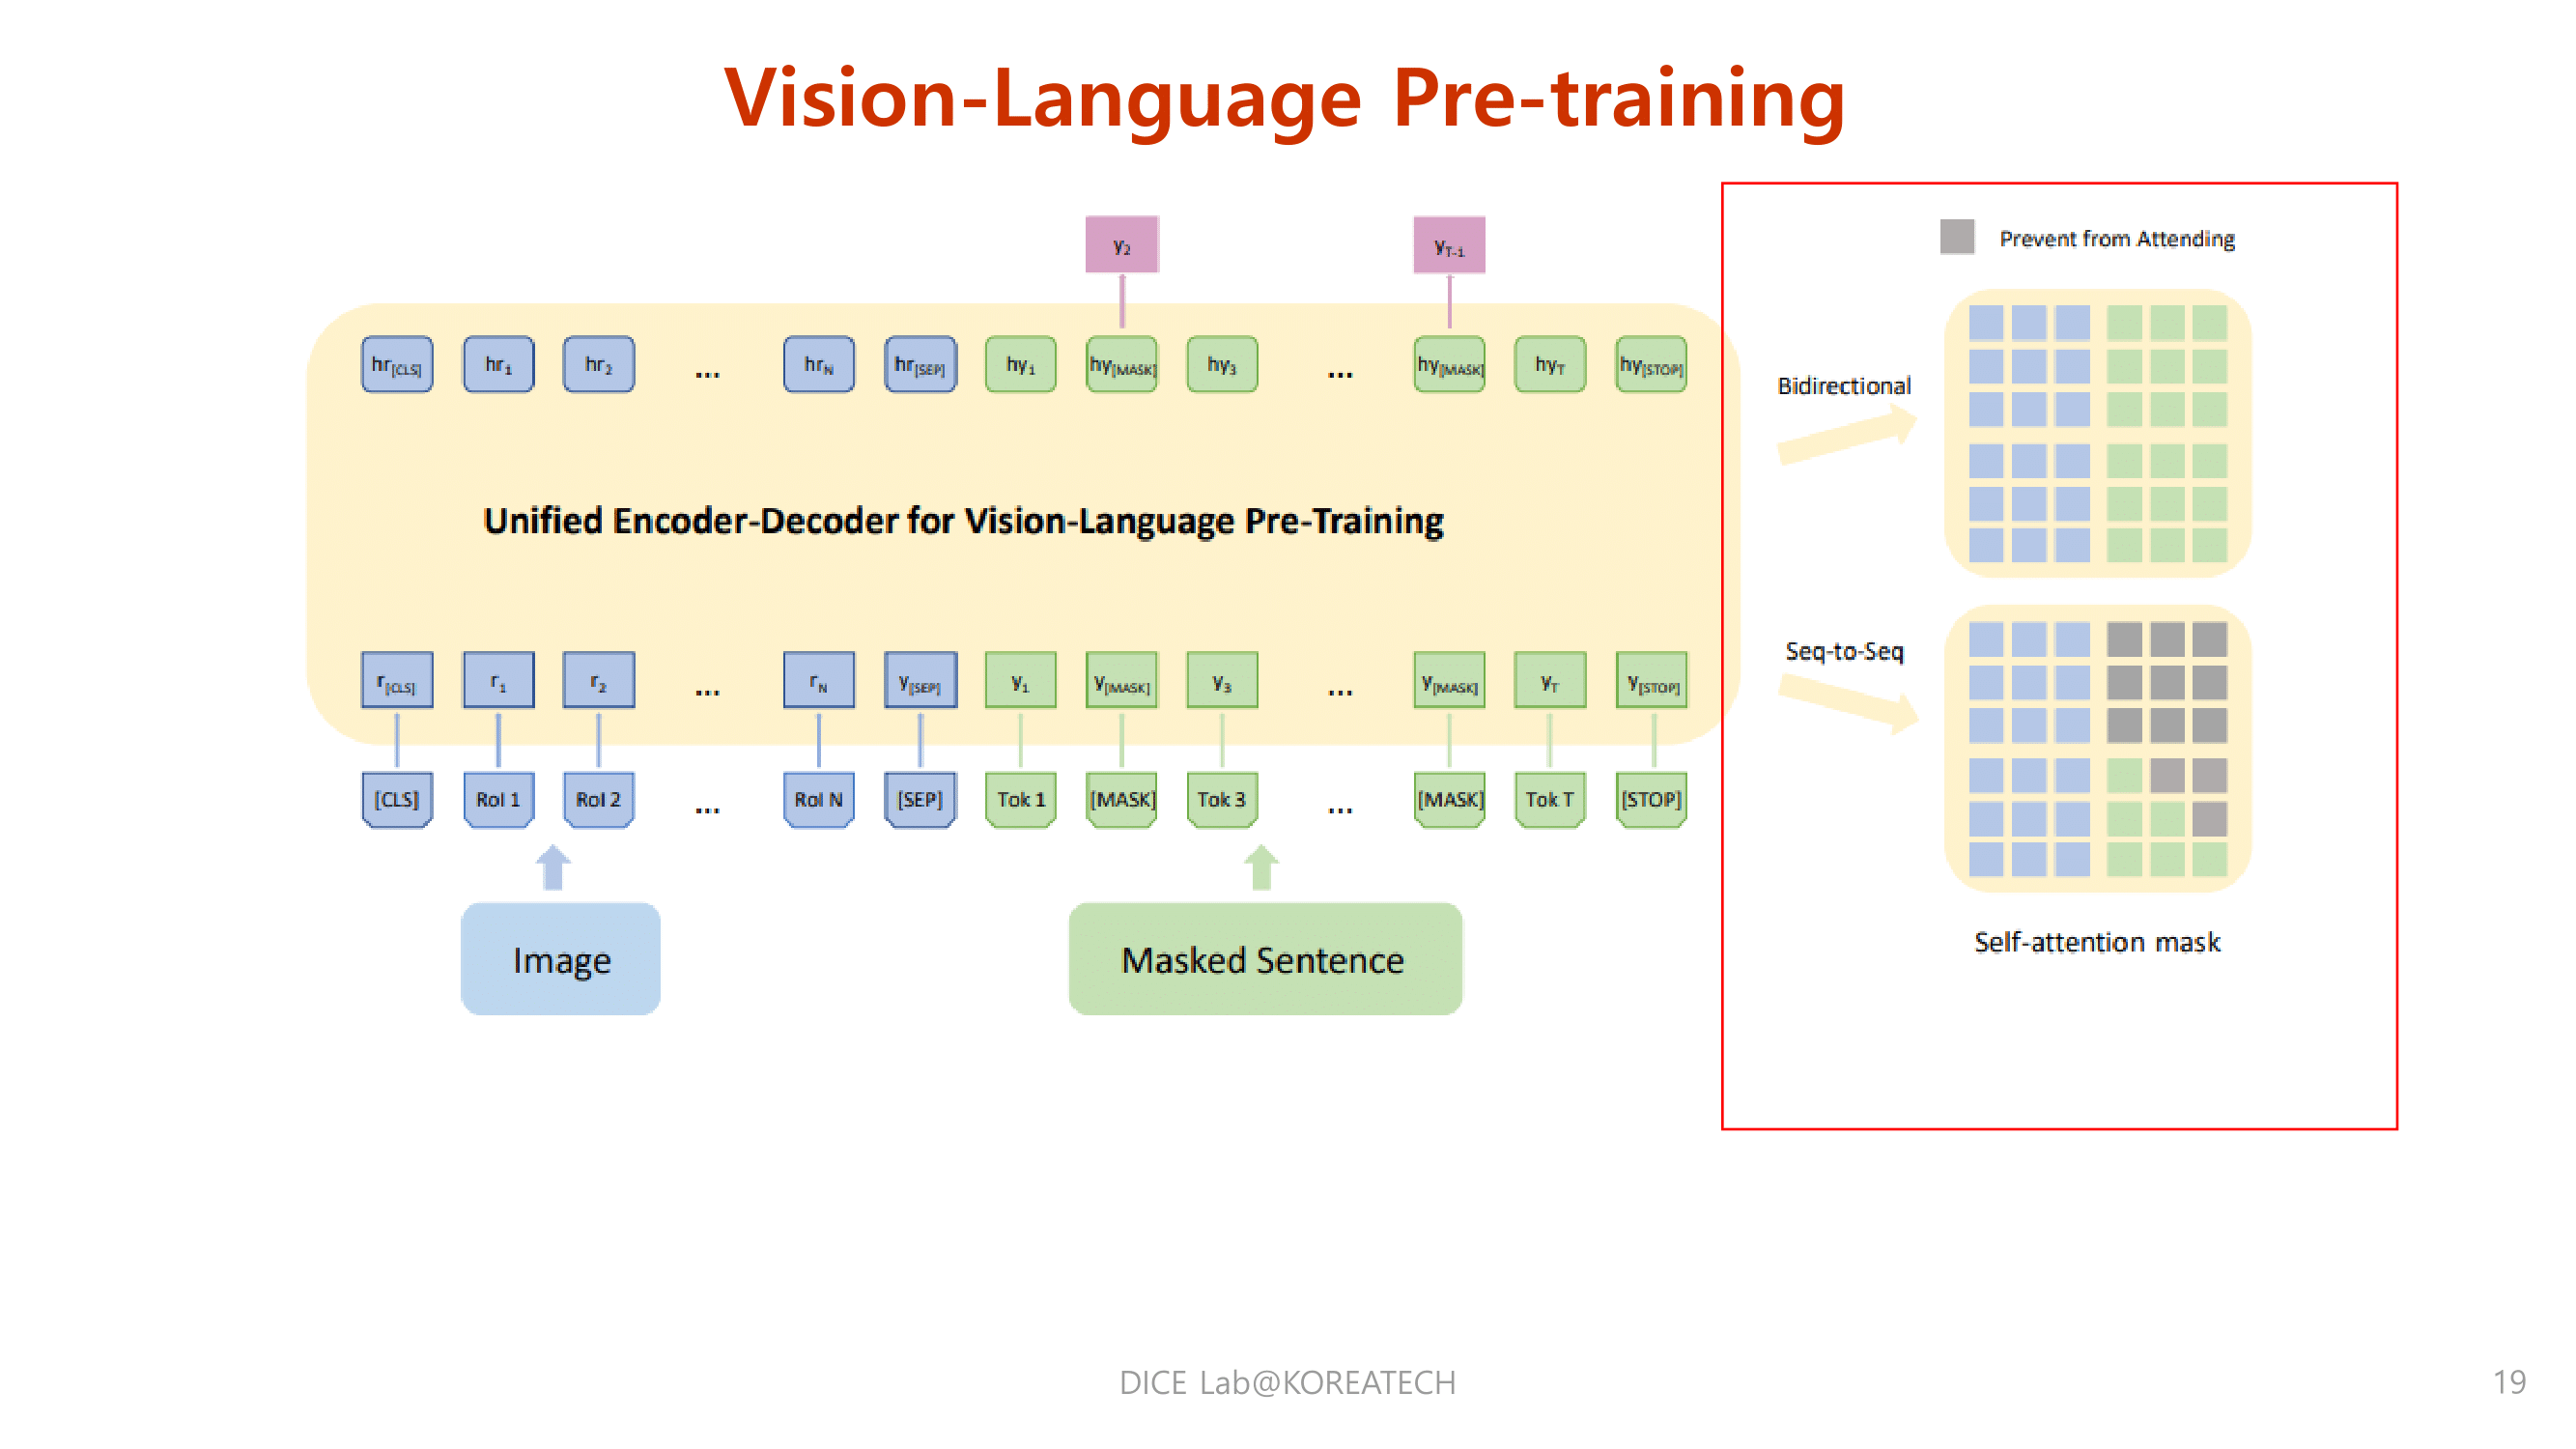
Paper Review. Unified Vision Language Pre-Training for Image Captioning ...
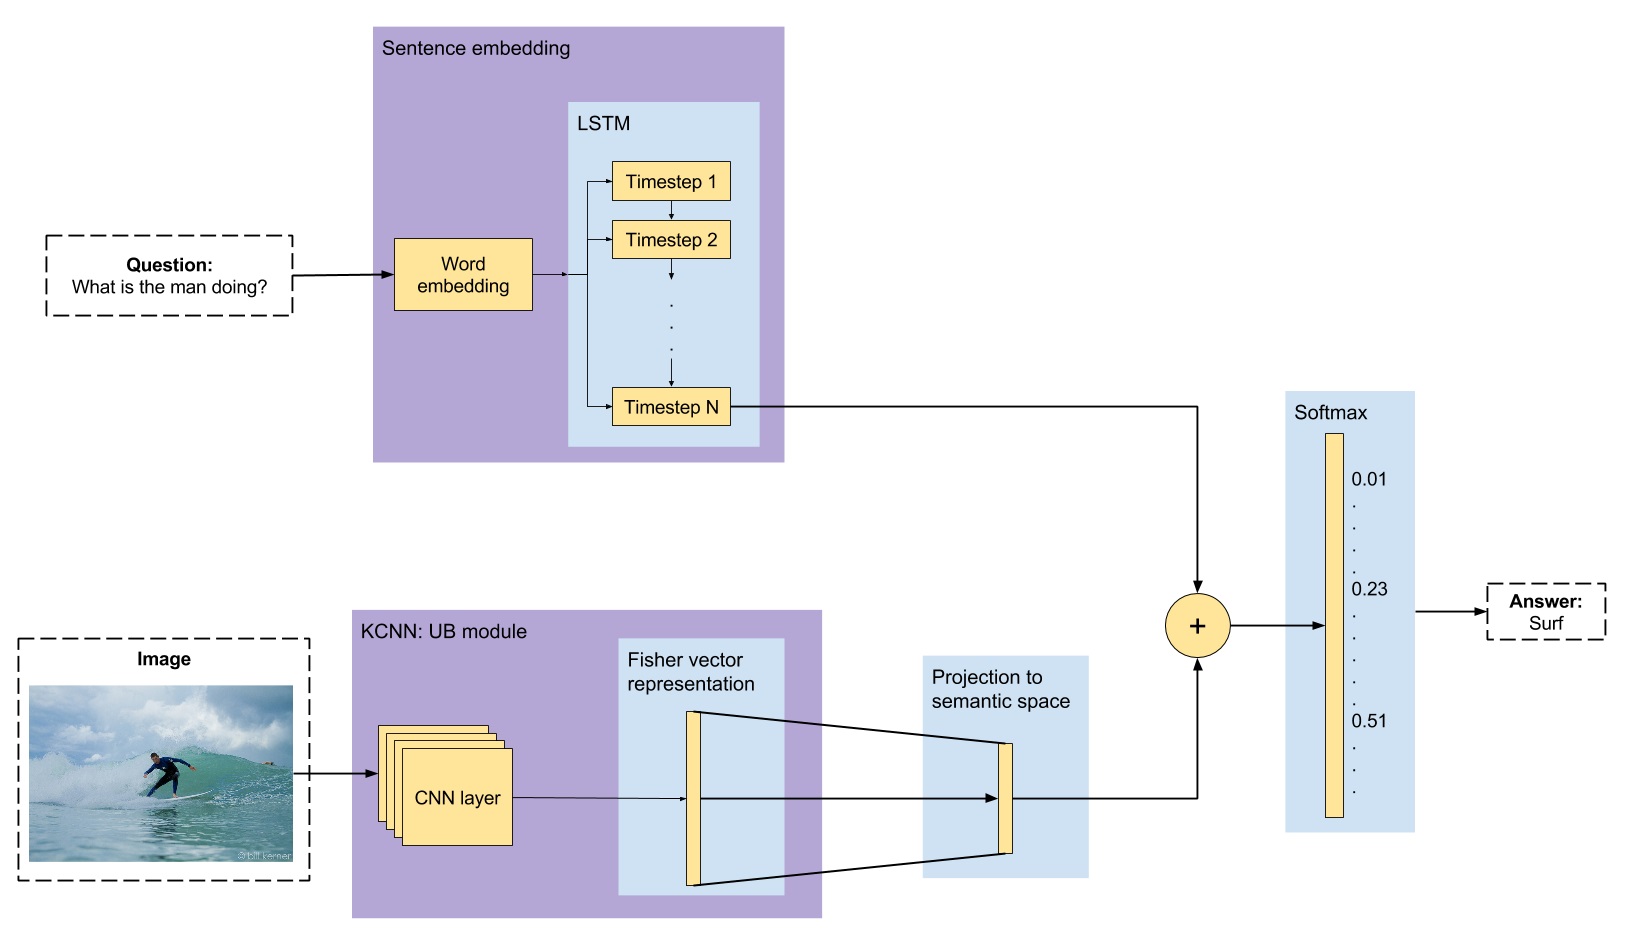
GitHub - imatge-upc/vqa-2016-cvprw: Visual question answering for ...
GitHub - Baiqi-Li/NaturalBench: 🚀 [NeurIPS24] Make Vision Matter in ...
A custom Visual Question Answering VQA model using Deep Learning | Upwork
GitHub - aimbrain/vqa-project: Code for our paper: Learning Conditioned ...
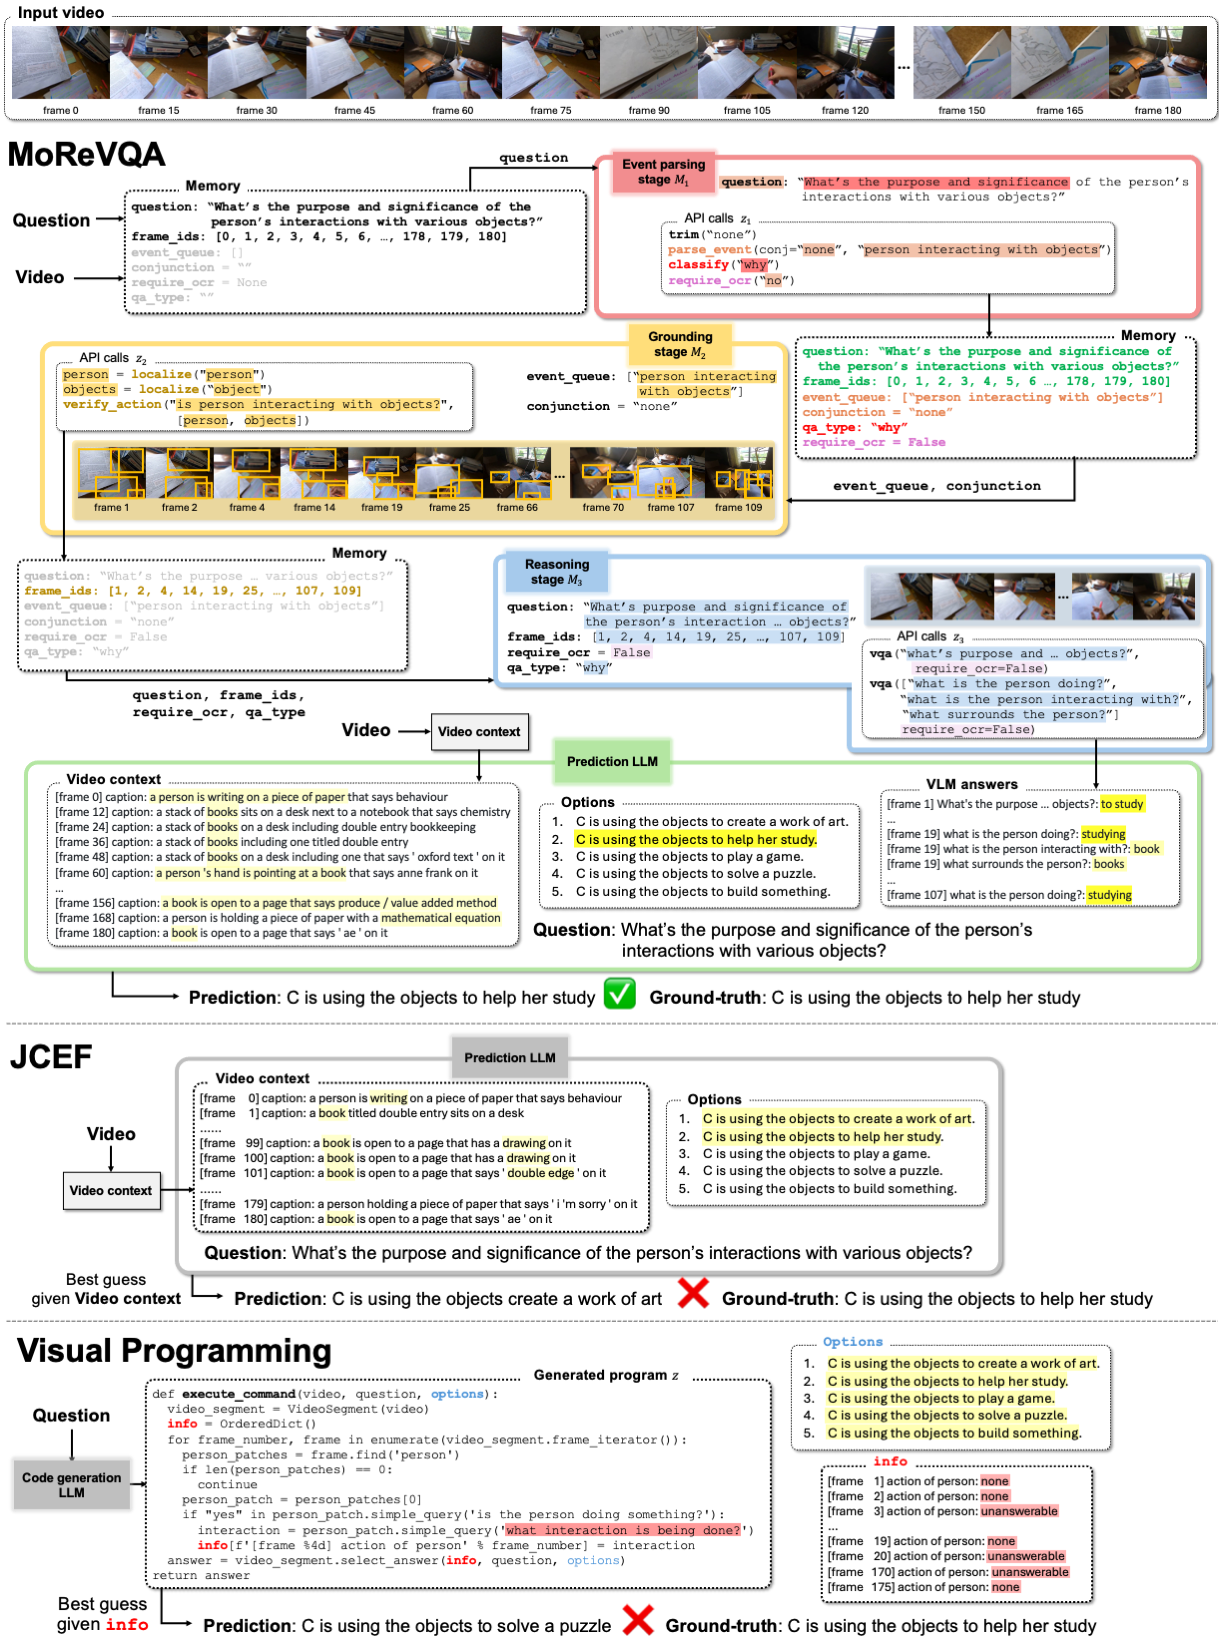
MoReVQA: Exploring Modular Reasoning Models for Video Question Answering