
Github Squeezebitsquick Quick Quantization Aware Interleaving And
GitHub - SqueezeBits/QUICK: QUICK: Quantization-aware Interleaving and ...

GitHub - SqueezeBits/QUICK: QUICK: Quantization-aware Interleaving and ...
GitHub - jnulzl/PyTorch-QAT: PyTorch Quantization Aware Training(QAT ...
GitHub - Jealousc11gx/QUEST: A SNN Quantization Aware Training ...
GitHub - suupahako/PipeQS-code: PipeQS is an adaptive quantization and ...
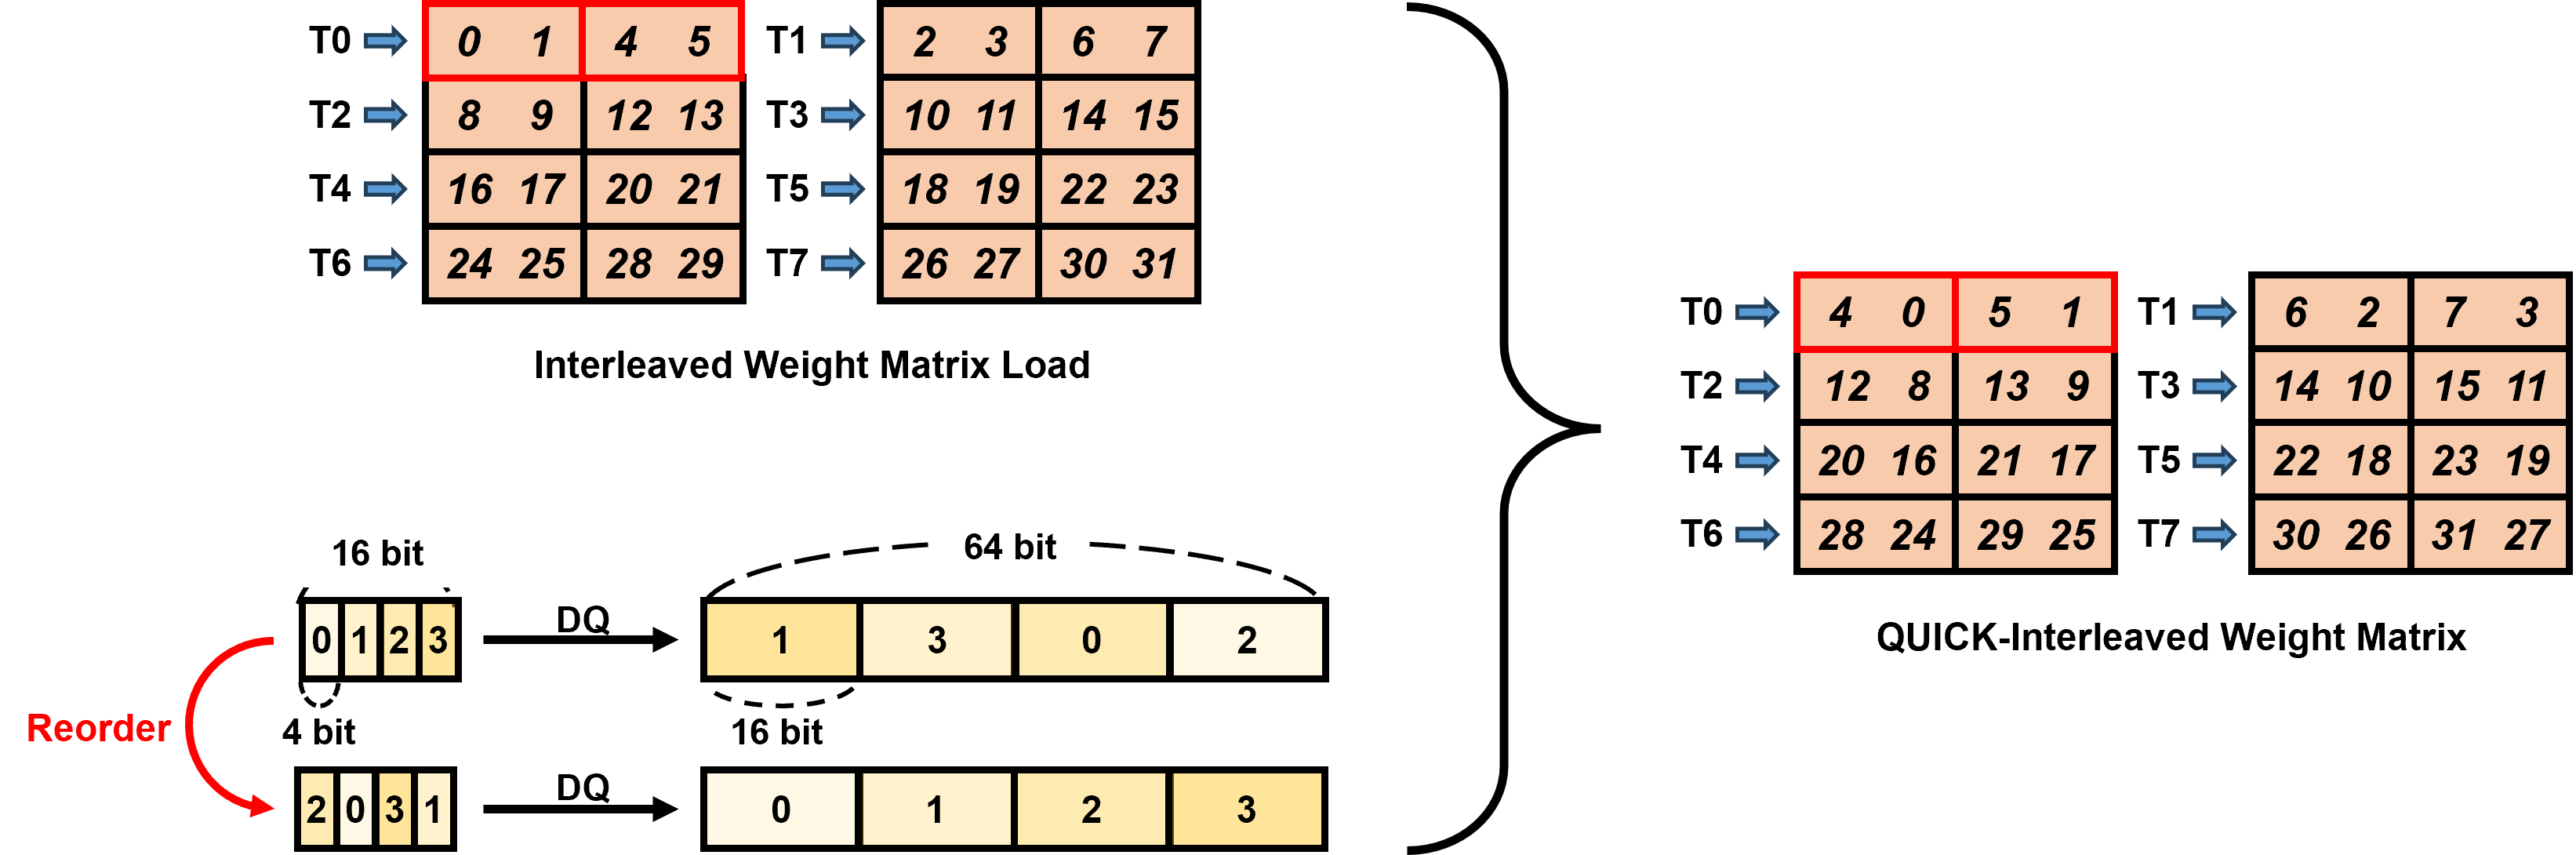
[2402.10076] QUICK: Quantization-aware Interleaving and Conflict-free ...
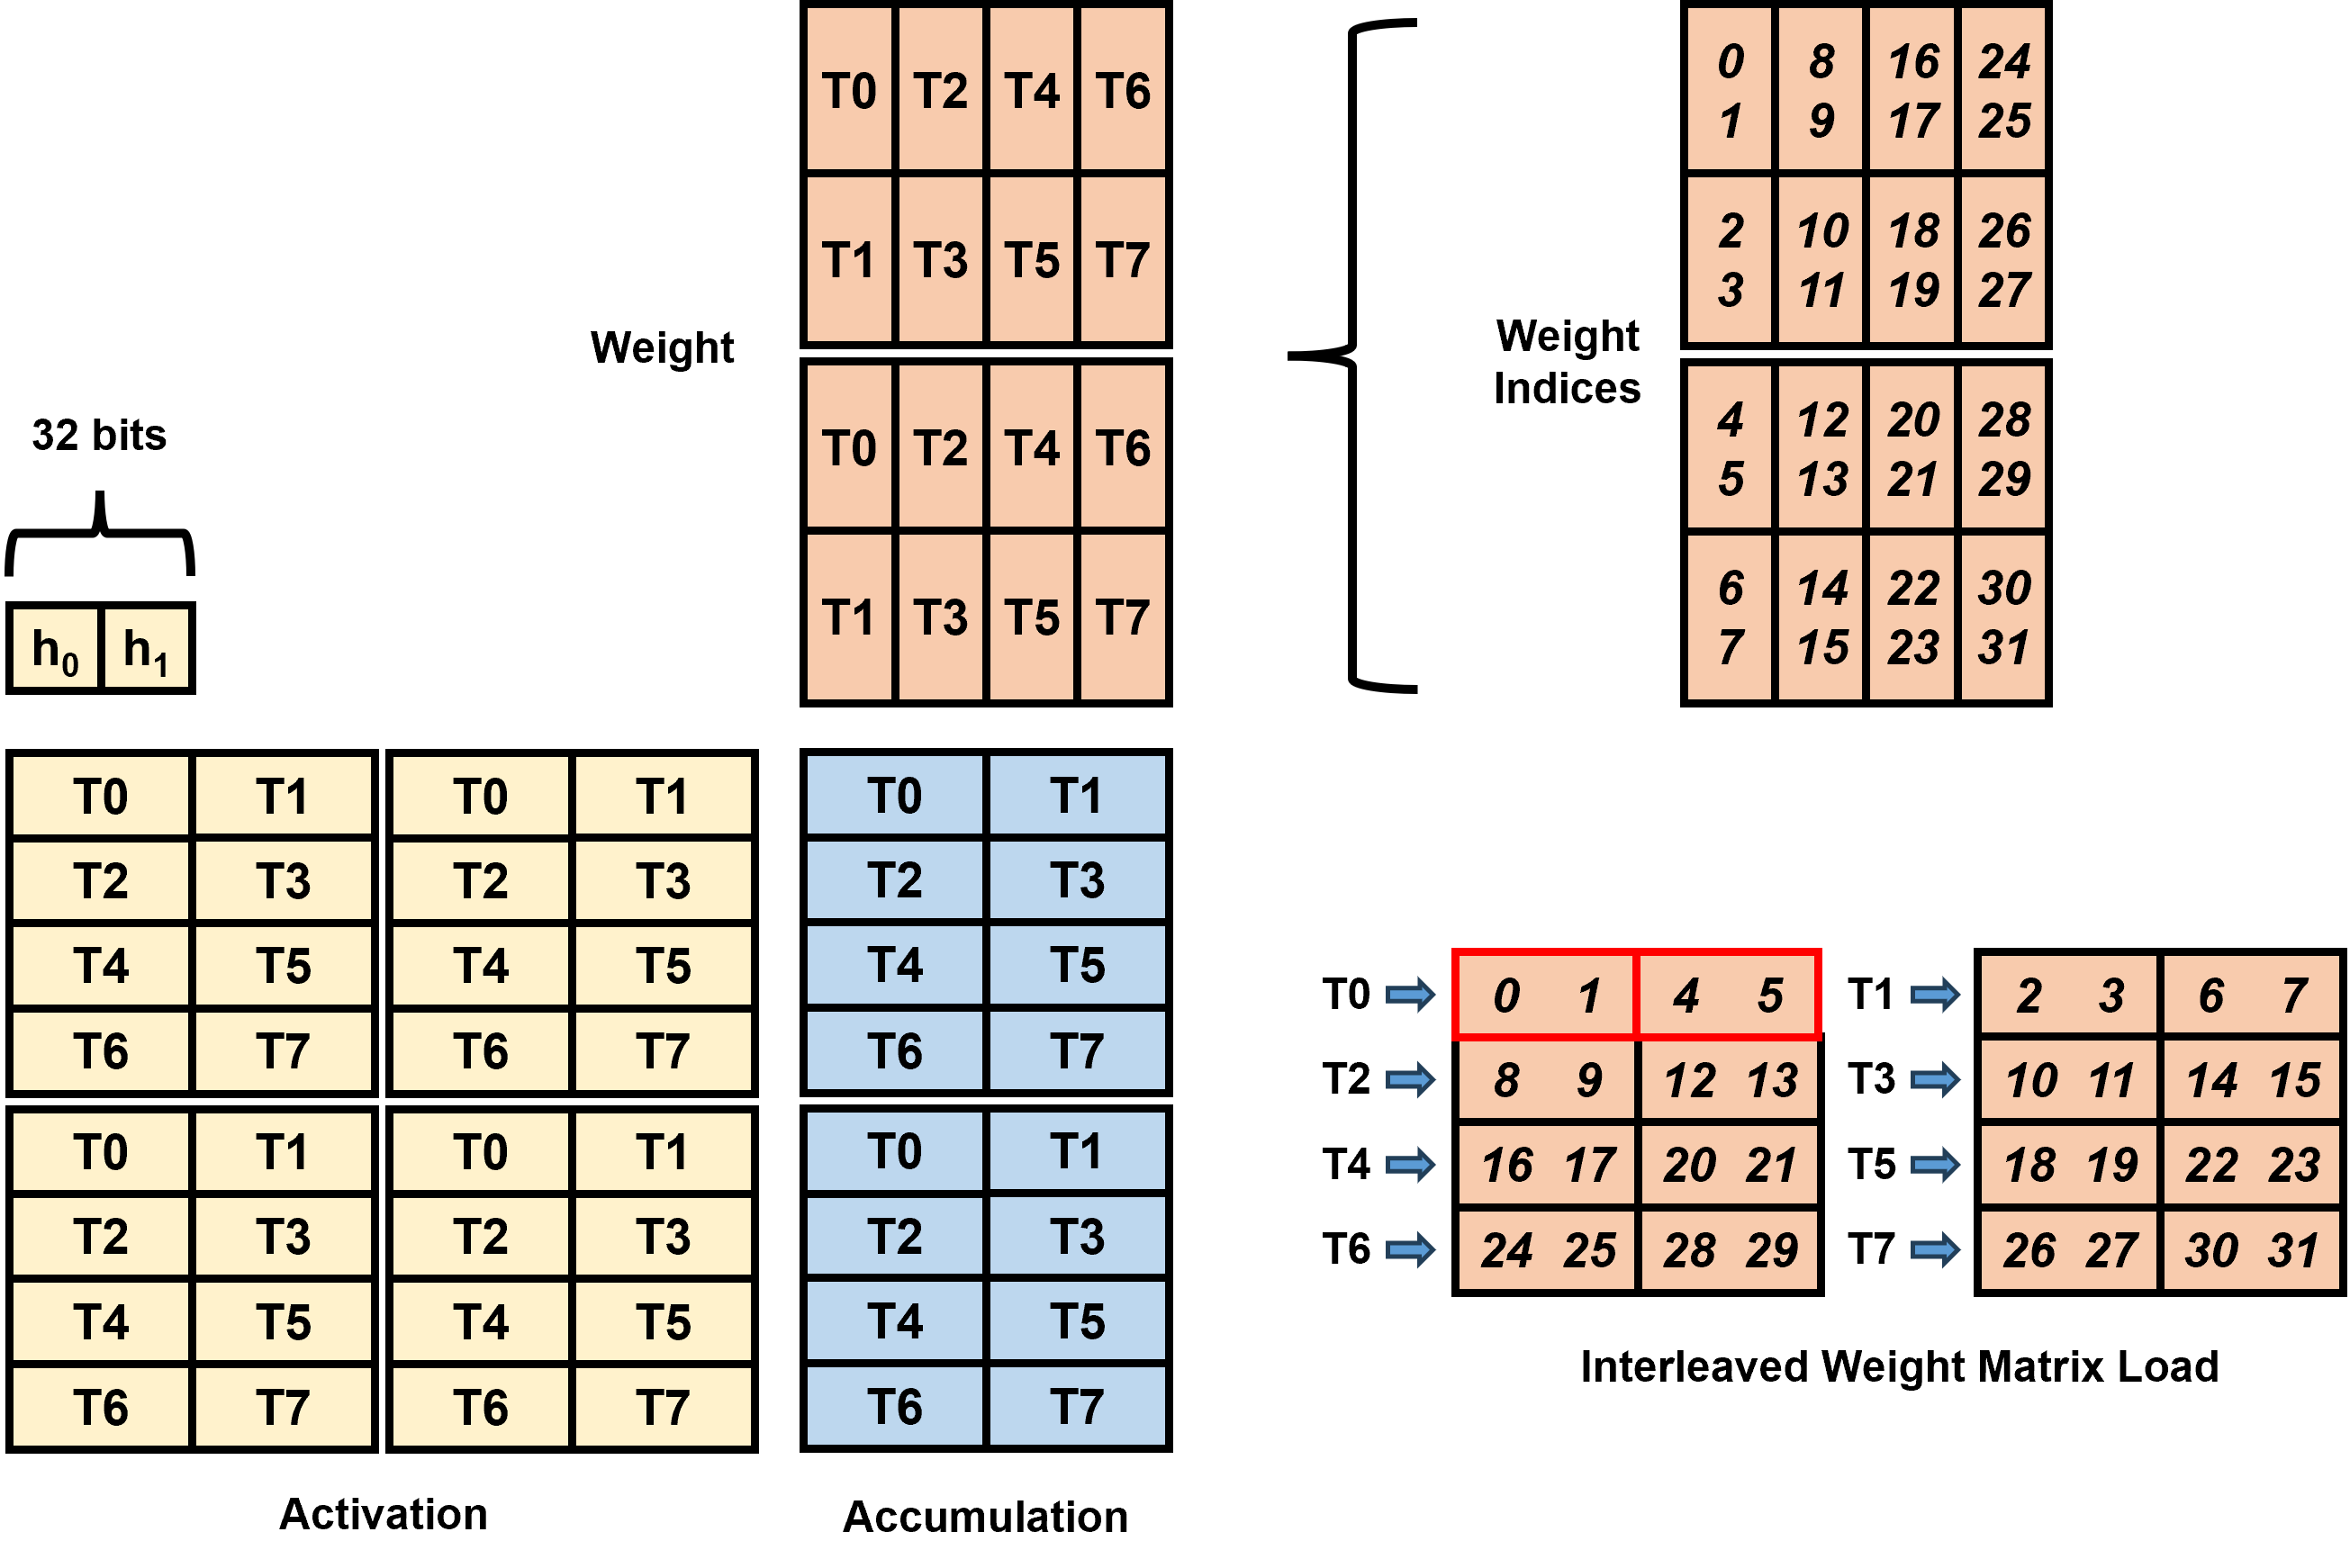
[2402.10076] QUICK: Quantization-aware Interleaving and Conflict-free ...

AWQ: Activation-aware Weight Quantization for LLM Compression and ...

AWQ: Activation-aware Weight Quantization for LLM Compression and ...

Paper page - QUICK: Quantization-aware Interleaving and Conflict-free ...
Advertisement Space (300x250)

GitHub - fkatada/hf-llm-awq: AWQ: Activation-aware Weight Quantization ...

Bit-Weight Adjustment for Bridging Uniform and Non-Uniform Quantization ...
Quantization aware training with full integer quantization support in ...

Quick Quantum Bits – Quantization - YouTube
Quantization Aware Training not supported for nn.Embedding layers ...

quantization aware training in InceptionV3 · Issue #24490 · tensorflow ...
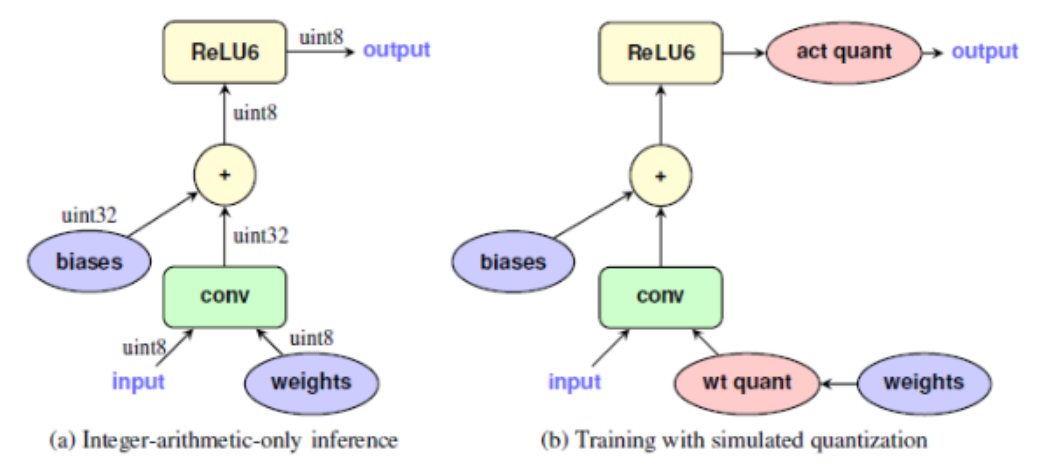
딥러닝의 Quantization (양자화)와 Quantization Aware Training - gaussian37
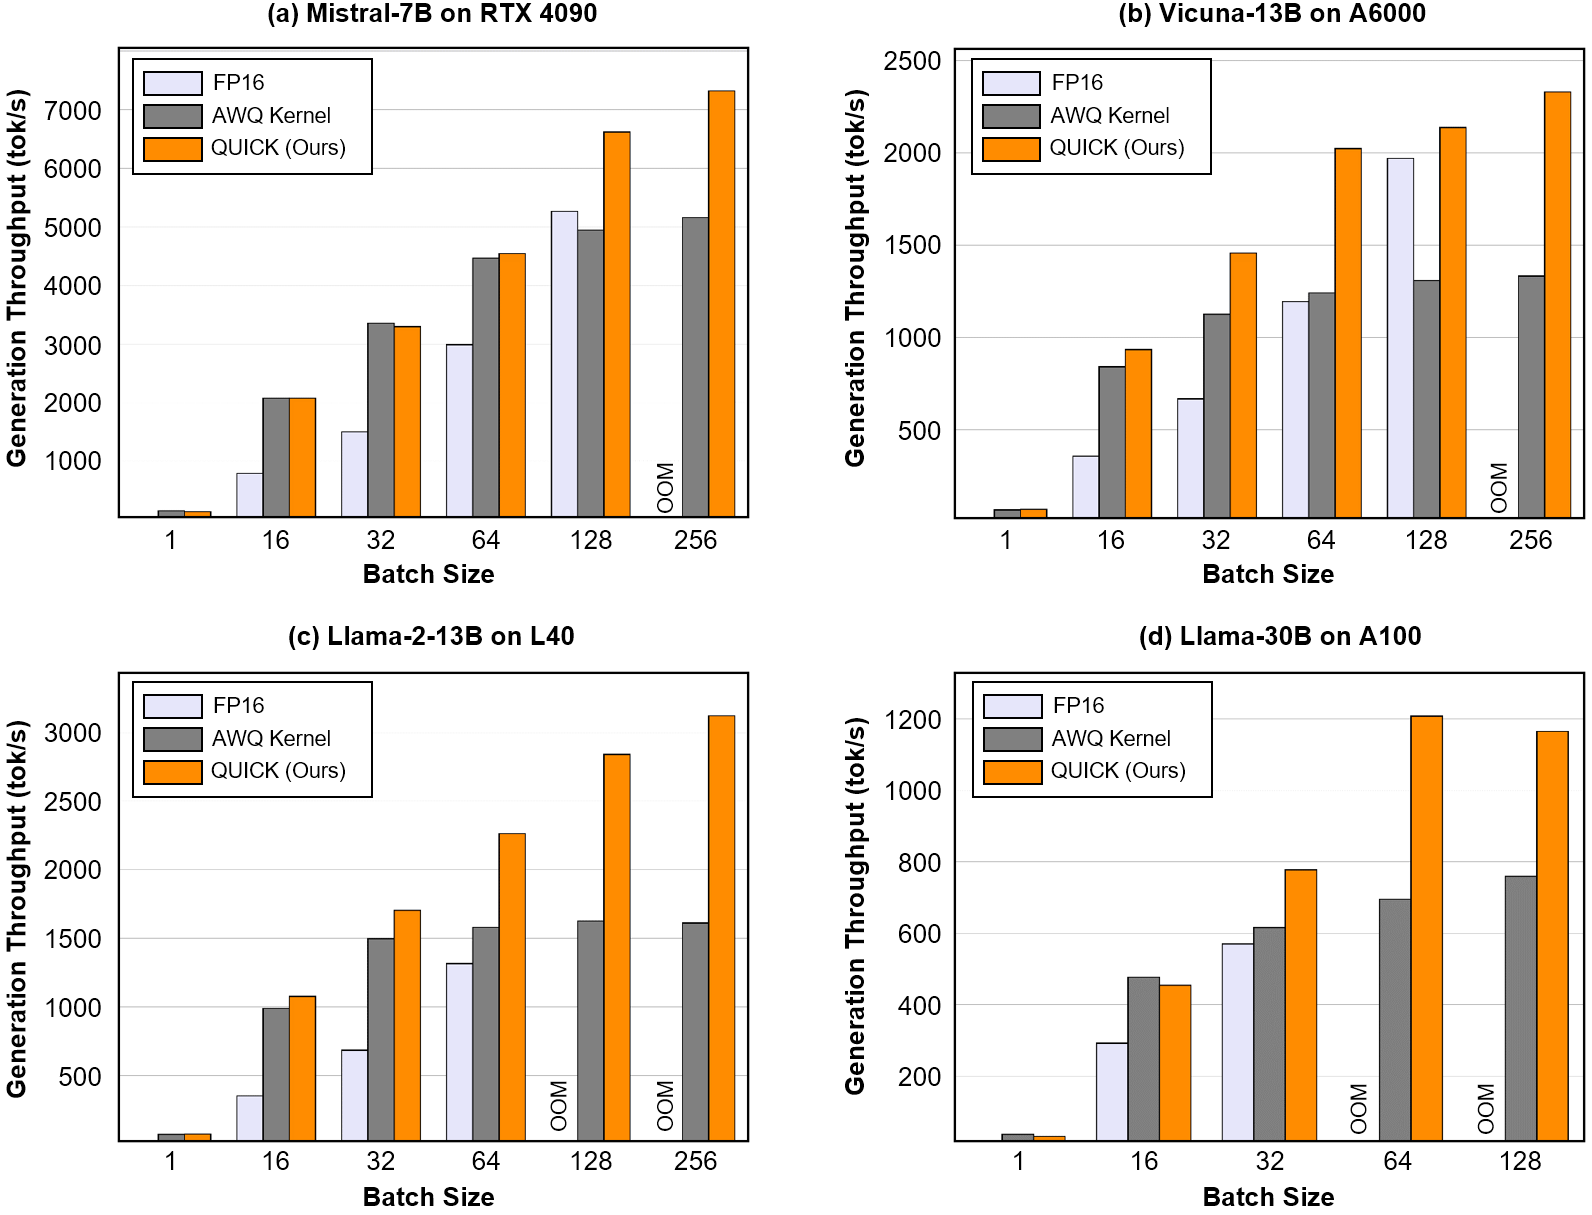
[2402.10076] QUICK: Quantization-aware Interleaving and Conflict-free ...
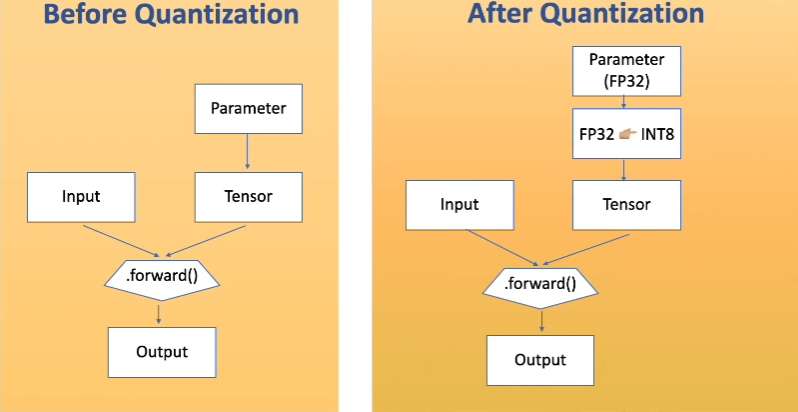
딥러닝의 Quantization (양자화)와 Quantization Aware Training - gaussian37
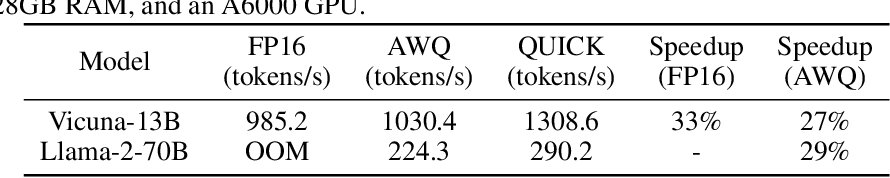
Table 1 from QUICK: Quantization-aware Interleaving and Conflict-free ...
Advertisement Space (336x280)
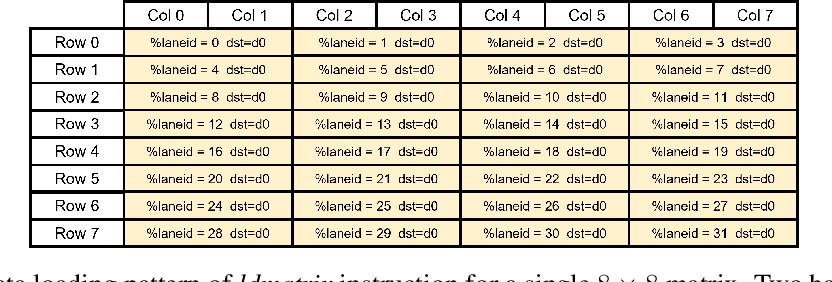
Figure 1 from QUICK: Quantization-aware Interleaving and Conflict-free ...
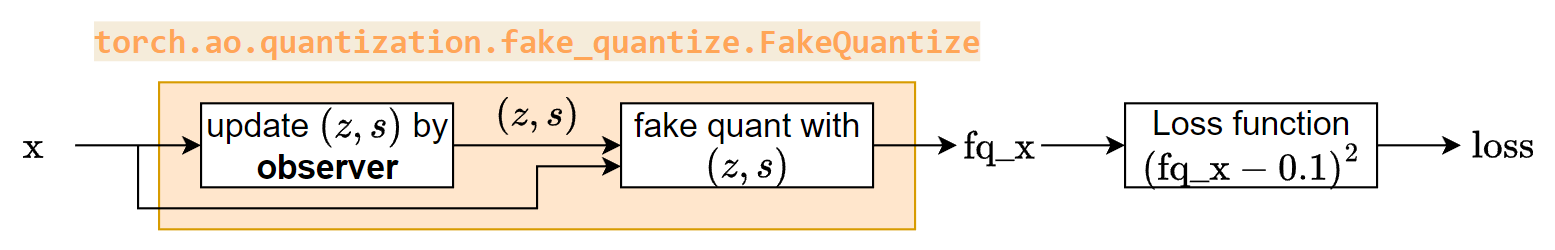
搞懂 Quantization Aware Training 中的 Fake Quantization | 棒棒生
INT8 Quantization Aware Training · ultralytics yolov5 · Discussion ...

AWQ: Activation-aware Weight Quantization for LLM Compression and ...

GitHub - deepglint/EasyQuant: EasyQuant(EQ) is an efficient and simple ...
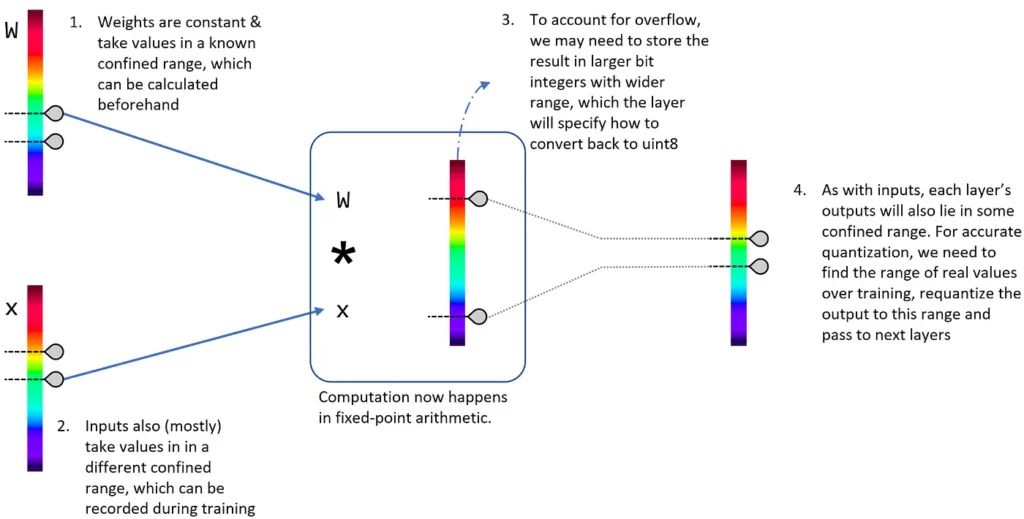
8-Bit Quantization and TensorFlow Lite: Speeding up mobile inference ...

Quantization Aware Training does not seem to perform per-channel ...

Quantization and Training of Neural Networks for Efficient Integer ...
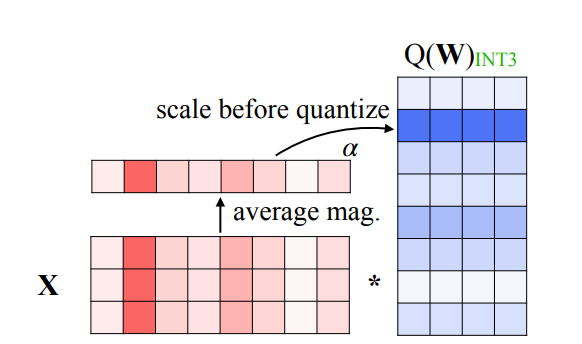
Fast and Small Llama 3 with Activation-Aware Quantization (AWQ)
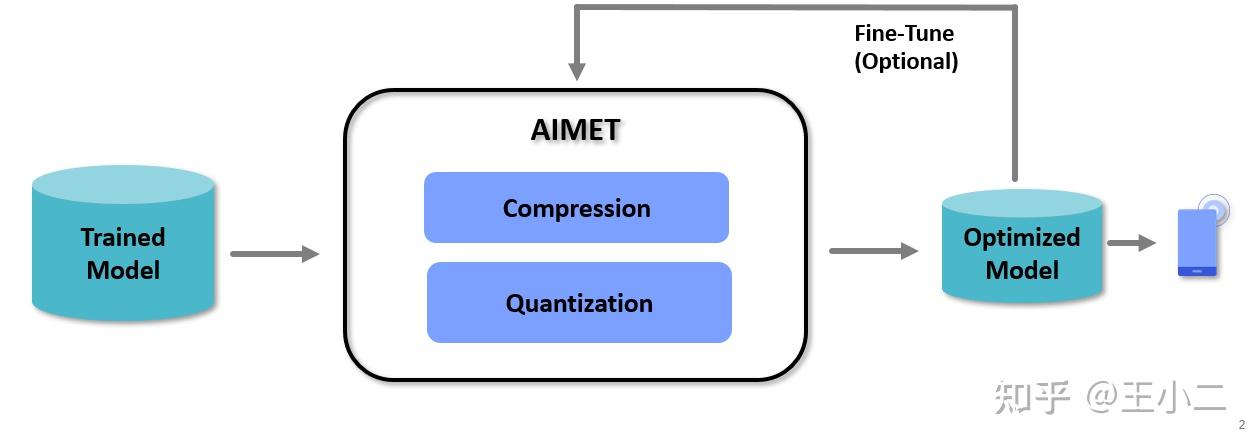
Quantization aware training(QAT)-AIMET - 知乎
Advertisement Space (336x280)
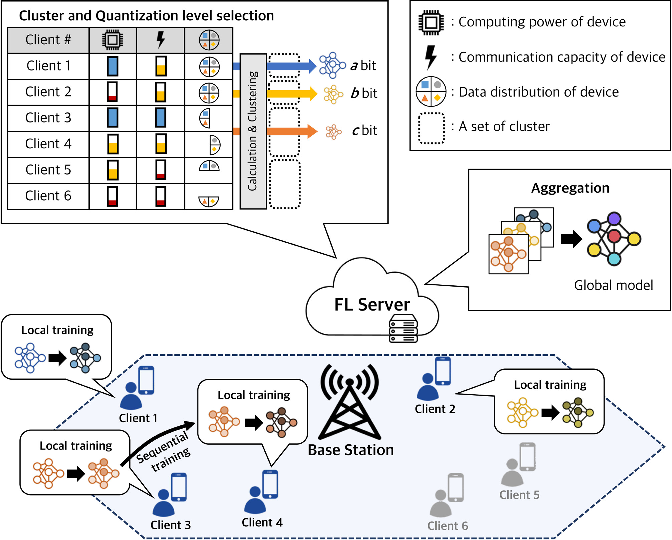
Figure 1 from Situation-Aware Cluster and Quantization Level Selection ...

AWQ: Activation-aware Weight Quantization for LLM Compression and ...

GitHub - shuai-huang/1Bit-CS: 1-bit and multi-bit compressive sensing ...

Qwen/Qwen3.6-27B · Quantization Aware Training
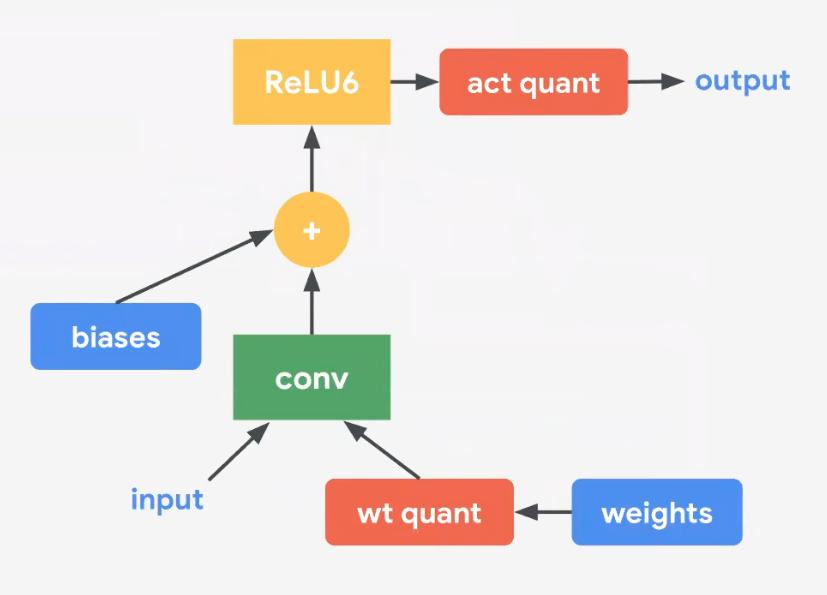
Quantization - Ahmed Thahir
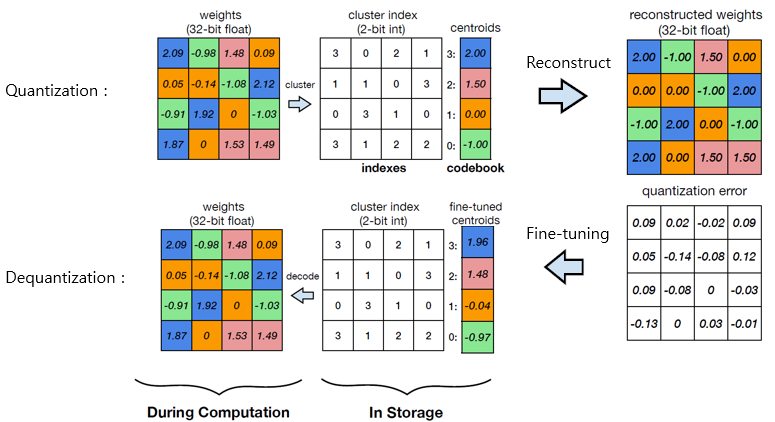
Quantization – SqueezeLLM