
Github Zhaolinzhangmyspider Github
GitHub - zhaolinzhang/mySpider · GitHub
GitHub - zach0zhang/Python_Spider: python Spider
GitHub - zhaozhengcoder/Spider: Python爬虫
GitHub - thunderZhang1/SpiderDemo: 初试网路爬虫 · GitHub
GitHub - Chauncey2/zhaopin_spider: 用scrapy编写的一个可以爬取智联招聘全部职位信息的爬虫
GitHub - GZhangjl/zhihu_spider: 这是一个zhihu爬虫,涉及到scrapy多块知识,同时涉及几项应对反爬虫设计 ...
GitHub - hzja/python_spider_: python爬虫教程系列、从0到1学习python爬虫,包括浏览器抓包,手机APP ...
GitHub - LewisCoder/spider_zhilian: 使用 scrapy 框架爬取智联上的 PHP 岗位信息,并存储到 ...
GitHub - dataaug/zhihu-spider: 知乎爬虫,用于爬取问题和对应的回答
GitHub - Rose-zhang/Spider
Advertisement Space (300x250)
GitHub - rayzgithub/ZhiHuSpider: 自写爬虫爬取知乎问题及回答 · GitHub
GitHub - luzihang123/smart_spider: 智能解析爬虫(封装API)&可配置 爬虫,新闻列表页到详情页全解析 ...
GitHub - bizhangjie/CatVodSpider: CatVodSpider一个TVBox的自定义源接口 · GitHub
GitHub - pythonyhd/custom_spider: 中国执行信息公开网-中国市场监管 · GitHub
GitHub - fox-world/zhilianSpider: 利用Java Jsoup来实现爬取智联招聘上特定岗位信息的爬虫项目 ...
ZhihuSpider/util/net/net.py at master · Foxgeek36/ZhihuSpider · GitHub
GitHub - KevinZhaoZL/Spiders: 包含爬取商品信息的京东,天猫,苏宁的三个爬虫 ...
GitHub · Where software is built
GitHub - szjoez/spider: 🚀🚀🚀feapder is an easy to use, powerful crawler ...
GitHub - he-You/Spider: Python3.5基于Scrapy的爬虫: 天猫、唯品会、云集的 美妆类的数据 以及一个基础 ...
Advertisement Space (336x280)
GitHub - dragonsfly/spider_: 爬虫面试题
GitHub - senran110/ZSpider: Python网络爬虫实战--红薯中文网、企名片、汽车之家、有道翻译、知乎
spider/豆瓣.py at main · dxawdc/spider · GitHub
GitHub - Seedin/ArticleSpider: A Spider To Catch News Articles On Outer ...
GitHub - Xiaoqi-Zhao-DLUT/Spider-UniCDSeg: (ICML 2024) Spider: A ...
spider_collection/README.md at master · srx-2000/spider_collection · GitHub

Zhang-spider · GitHub
GitHub - spider-rs/spider-clients: Python, Javascript, and Rust ...
GitHub - 2ming/NodeWebSpider: node爬虫实例,猫眼、今日头条、淘宝商品、图片验证码识别等
GitHub - zhanghe06/news_spider: 新闻抓取(微信、微博、头条...) · GitHub
Advertisement Space (336x280)
GitHub - Double-A-Spider/Double-A-Spider: Config files for my GitHub ...
GitHub - chapzq77/PersonSpiderEngine: 多线程爬取百度,搜狗,bing等浏览器检索的结果,结果保存在轻量级 ...
GitHub - dhjz/spider: 纯前端js实现爬取页面内容,支持分页爬取,保存内容为json, 爬虫 · GitHub
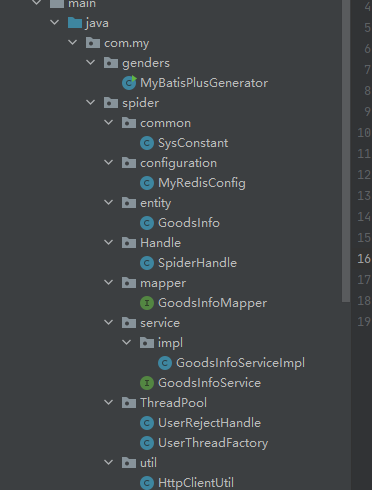
GitHub - mainongtt/mySpider
GitHub - leebeep/spider_demo: 根据网上的开源项目整理了几个常用的爬虫样例,更多内容可以访问我的知识星球:有树的成长世界
GitHub - crawler01/spider_class: 备课资料,主要来自书籍《Python网络爬虫实例教程》 · GitHub