
Gpu Tvm Hyperai
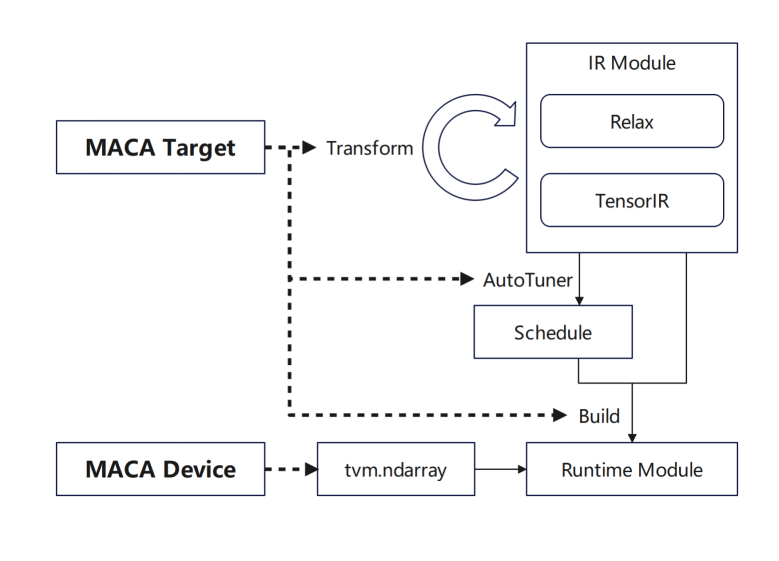
从架构特性到生态建设,沐曦董兆华深度剖析国产 GPU 上的 TVM 应用实践 | 资讯 | HyperAI超神经
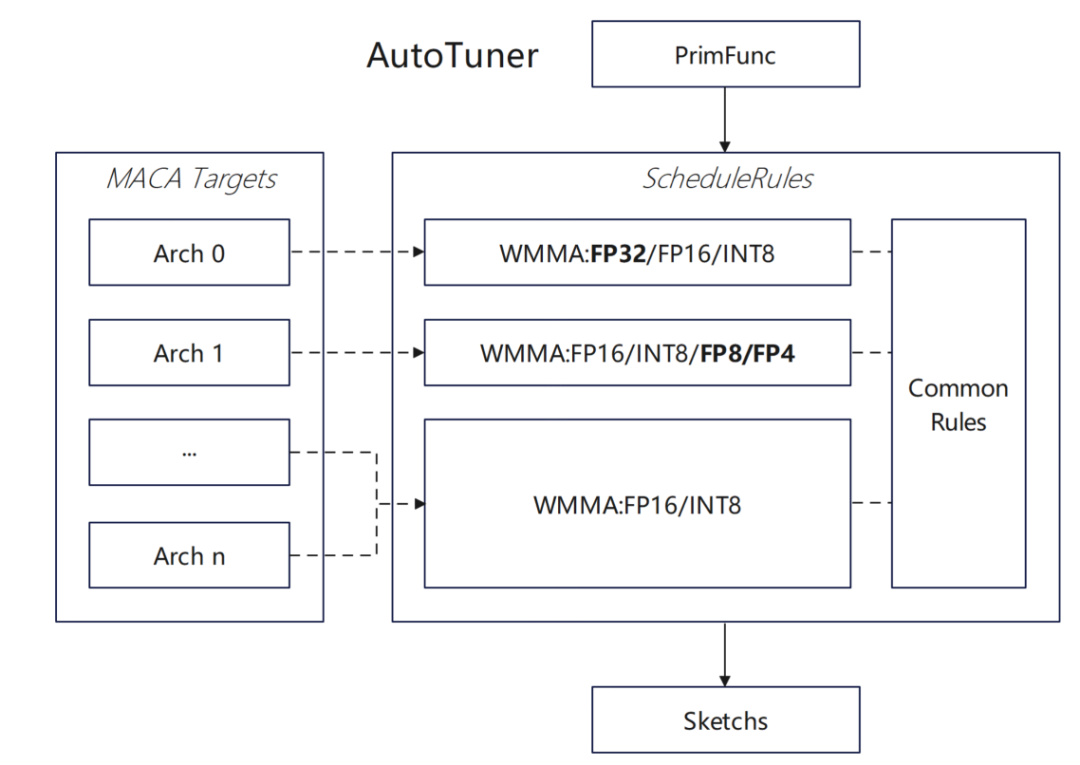
从架构特性到生态建设,沐曦董兆华深度剖析国产 GPU 上的 TVM 应用实践 | 资讯 | HyperAI超神经
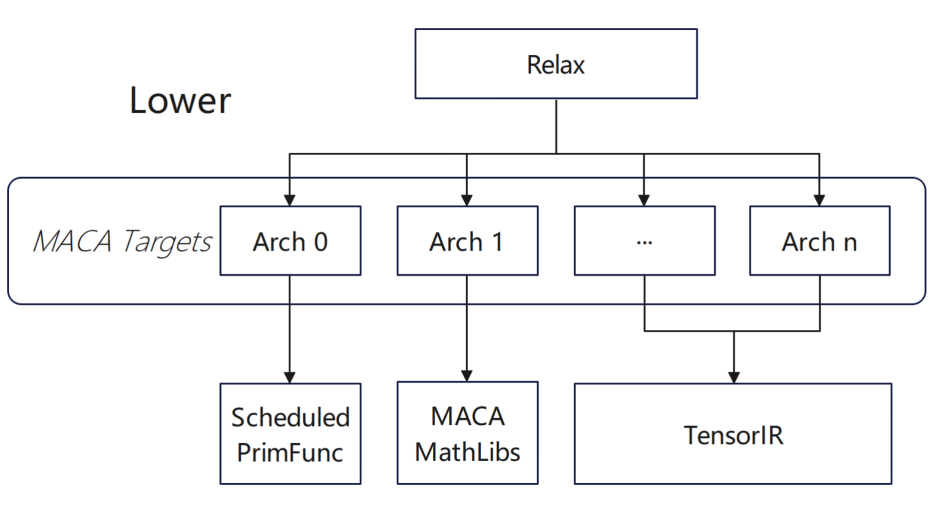
从架构特性到生态建设,沐曦董兆华深度剖析国产 GPU 上的 TVM 应用实践 | 资讯 | HyperAI超神经
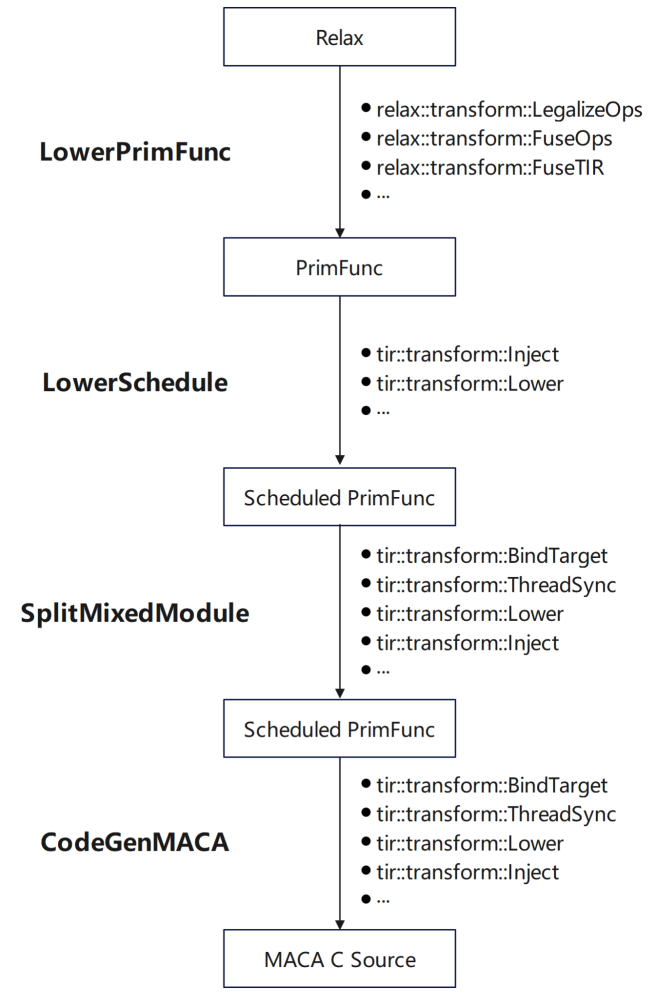
从架构特性到生态建设,沐曦董兆华深度剖析国产 GPU 上的 TVM 应用实践 | 资讯 | HyperAI超神经
NVIDIA A100 SXM4 80 GB | GPU Leaderboard | HyperAI
从架构特性到生态建设,沐曦董兆华深度剖析国产 GPU 上的 TVM 应用实践 | 资讯 | HyperAI超神经

从架构特性到生态建设,沐曦董兆华深度剖析国产 GPU 上的 TVM 应用实践 - 超神经HyperAI - SegmentFault 思否
HyperAI — Sovereign GPU Compute for Enterprise AI | MomentumX

从架构特性到生态建设,沐曦董兆华深度剖析国产 GPU 上的 TVM 应用实践 - 超神经HyperAI - SegmentFault 思否
从架构特性到生态建设,沐曦董兆华深度剖析国产 GPU 上的 TVM 应用实践 | 资讯 | HyperAI超神经
Advertisement Space (300x250)
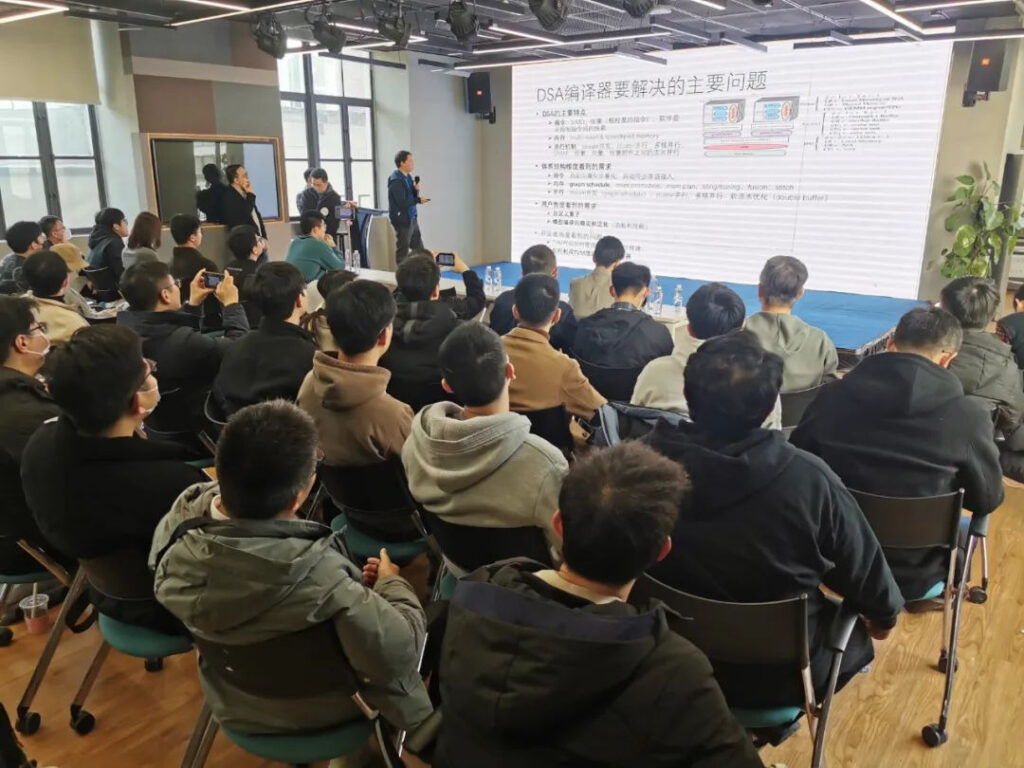
Sim Computing: DSA AI Compiler Build Based on TVM | News | HyperAI

阿里将 TVM 融入 TensorFlow,在 GPU 上实现全面提速-腾讯云开发者社区-腾讯云
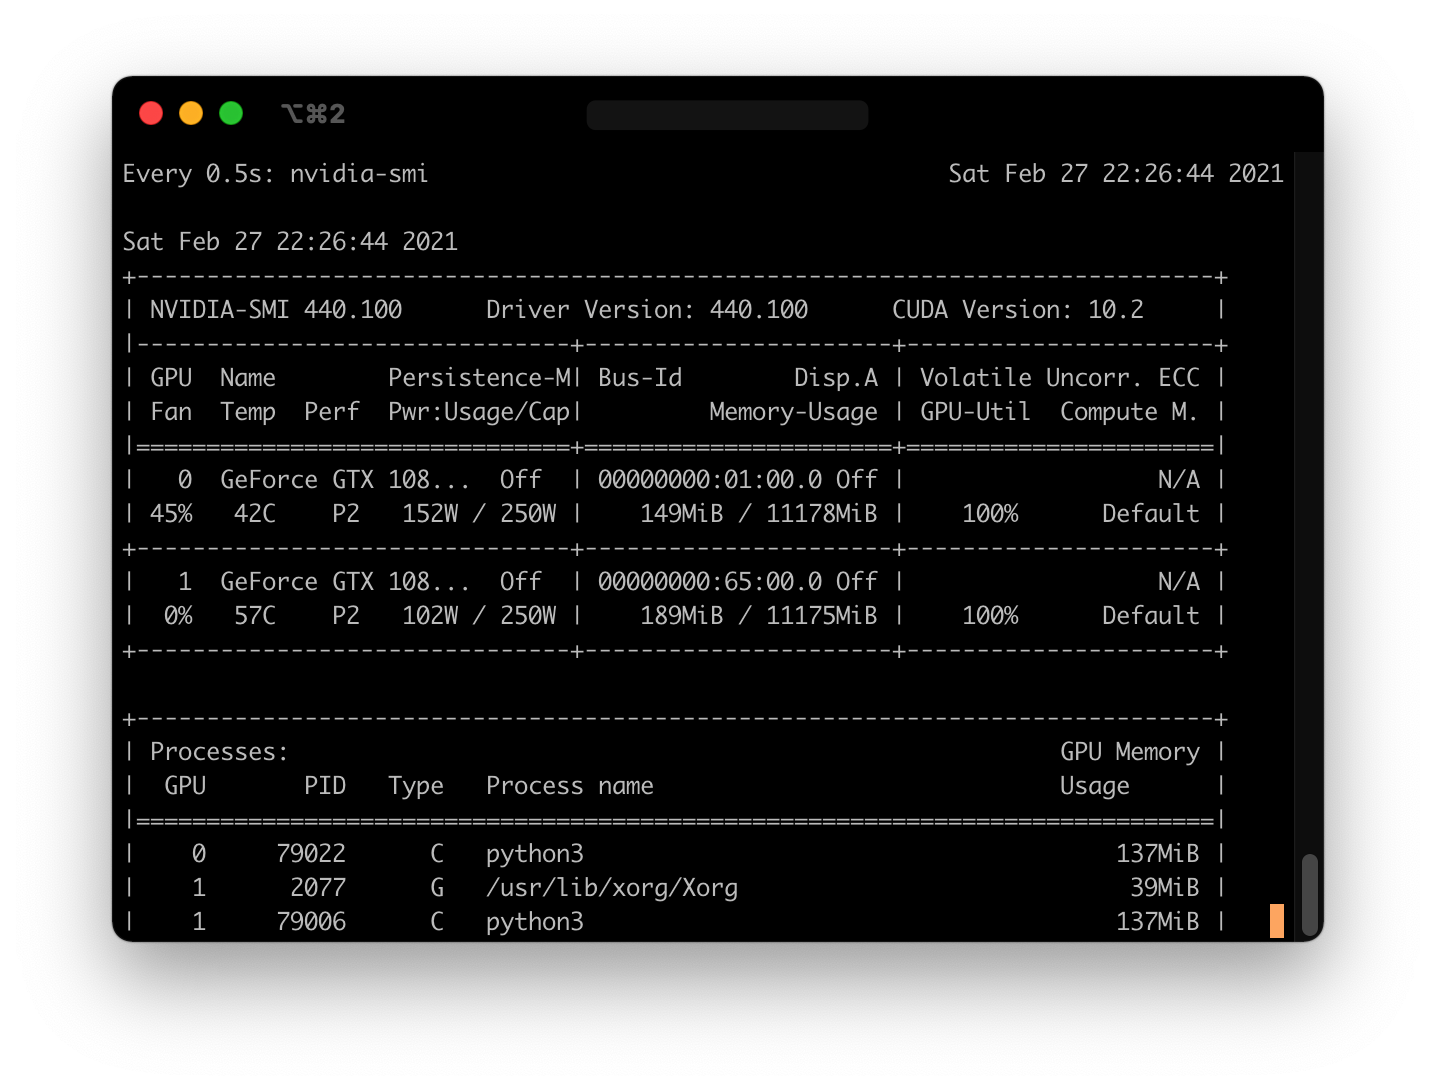
TVM AutoTVM 多 GPU 加速 Tuning - Junyi’s Lab

The GPU peak FLOPS measured by tvm is half the result mesured by clpeak ...
NVIDIA H200 SXM 141 GB | GPU 리더보드 | HyperAI초신경
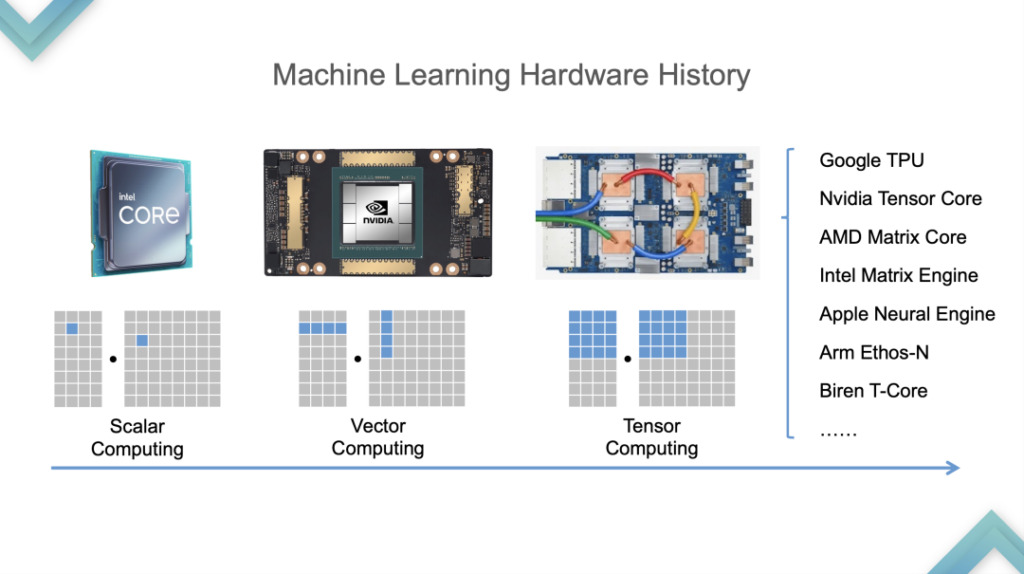
Feng Siyuan: Apache TVM と機械学習コンパイルの開発 | ニュース | HyperAI超神経
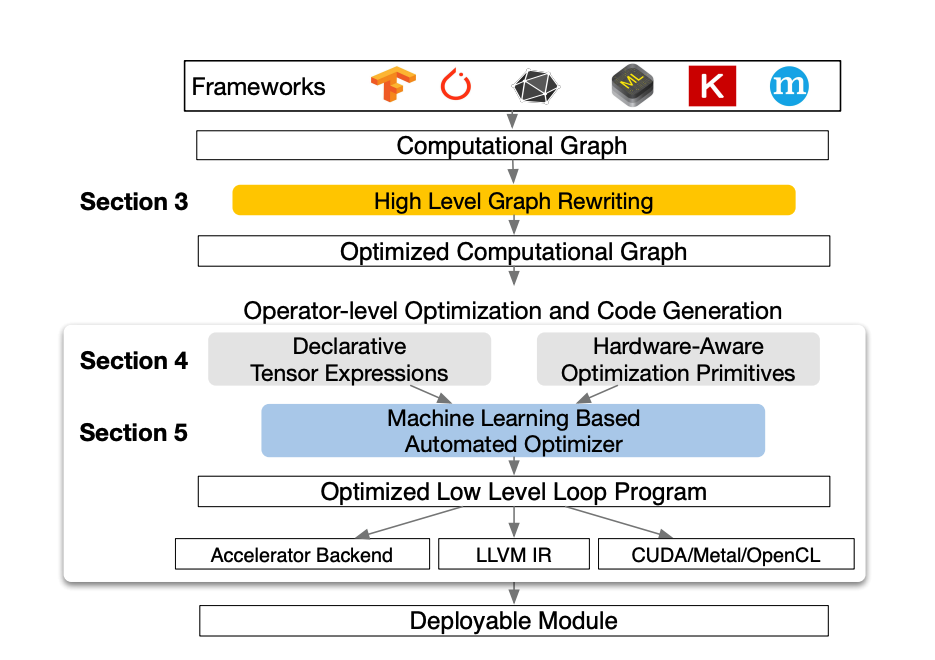
TVM 中文站正式上线!最全机器学习模型部署「参考书」它来了 | 资讯 | HyperAI超神经

TVM Compiler with Adreno | Optimized ML Solutions | Qualcomm
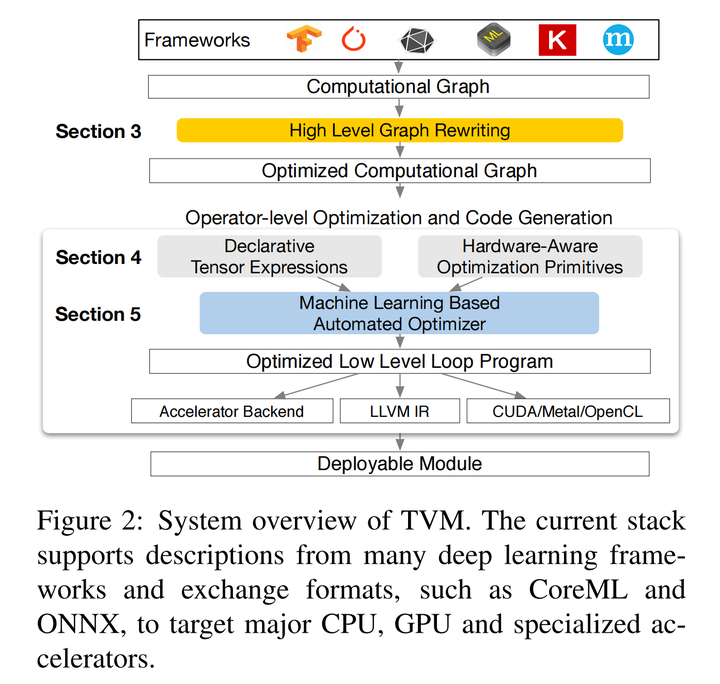
TVM | 一种用于深度学习的端到端自动优化编译器 - 知乎

人工智能 - 【TVM教程】为 Mobile GPU 自动调优卷积网络 - 超神经HyperAI - SegmentFault 思否
Advertisement Space (336x280)
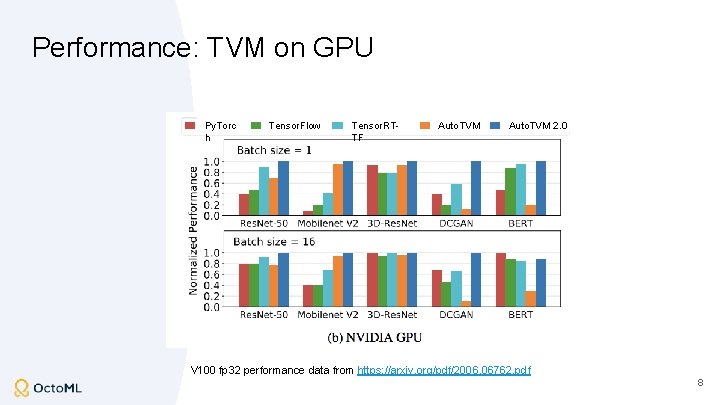
Apache TVM and ONNX What can ONNX do
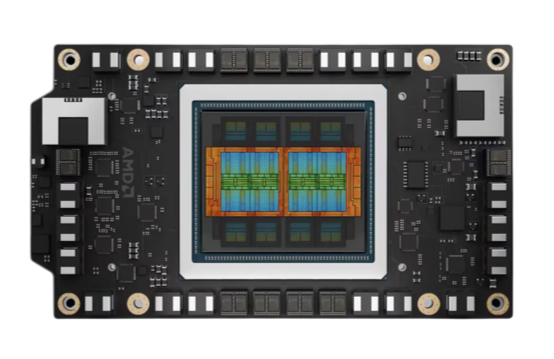
AMD Instinct™ MI355X | GPU 排行榜 | HyperAI超神经

Feng Siyuan: Apache TVM と機械学習コンパイルの開発 | ニュース | HyperAI超神経
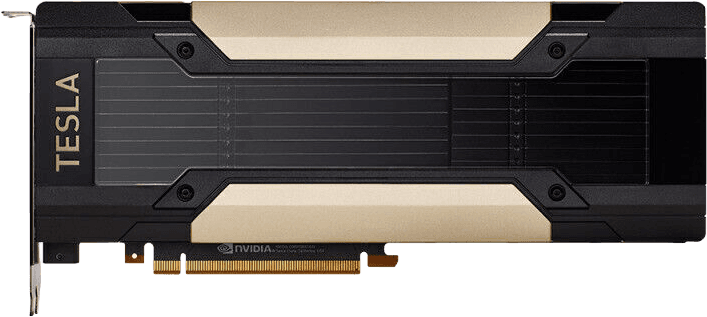
NVIDIA Tesla V100 PCIe 16 GB | GPU 天梯 | HyperAI超神经
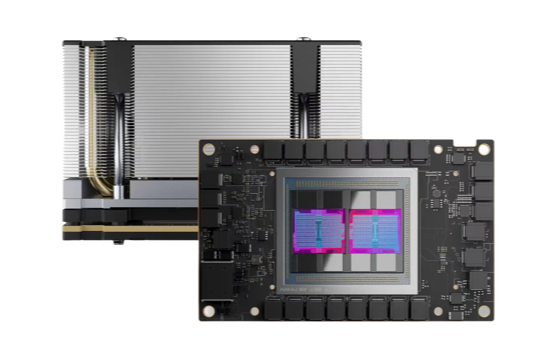
AMD Instinct™ MI250 | GPU 排行榜 | HyperAI超神经
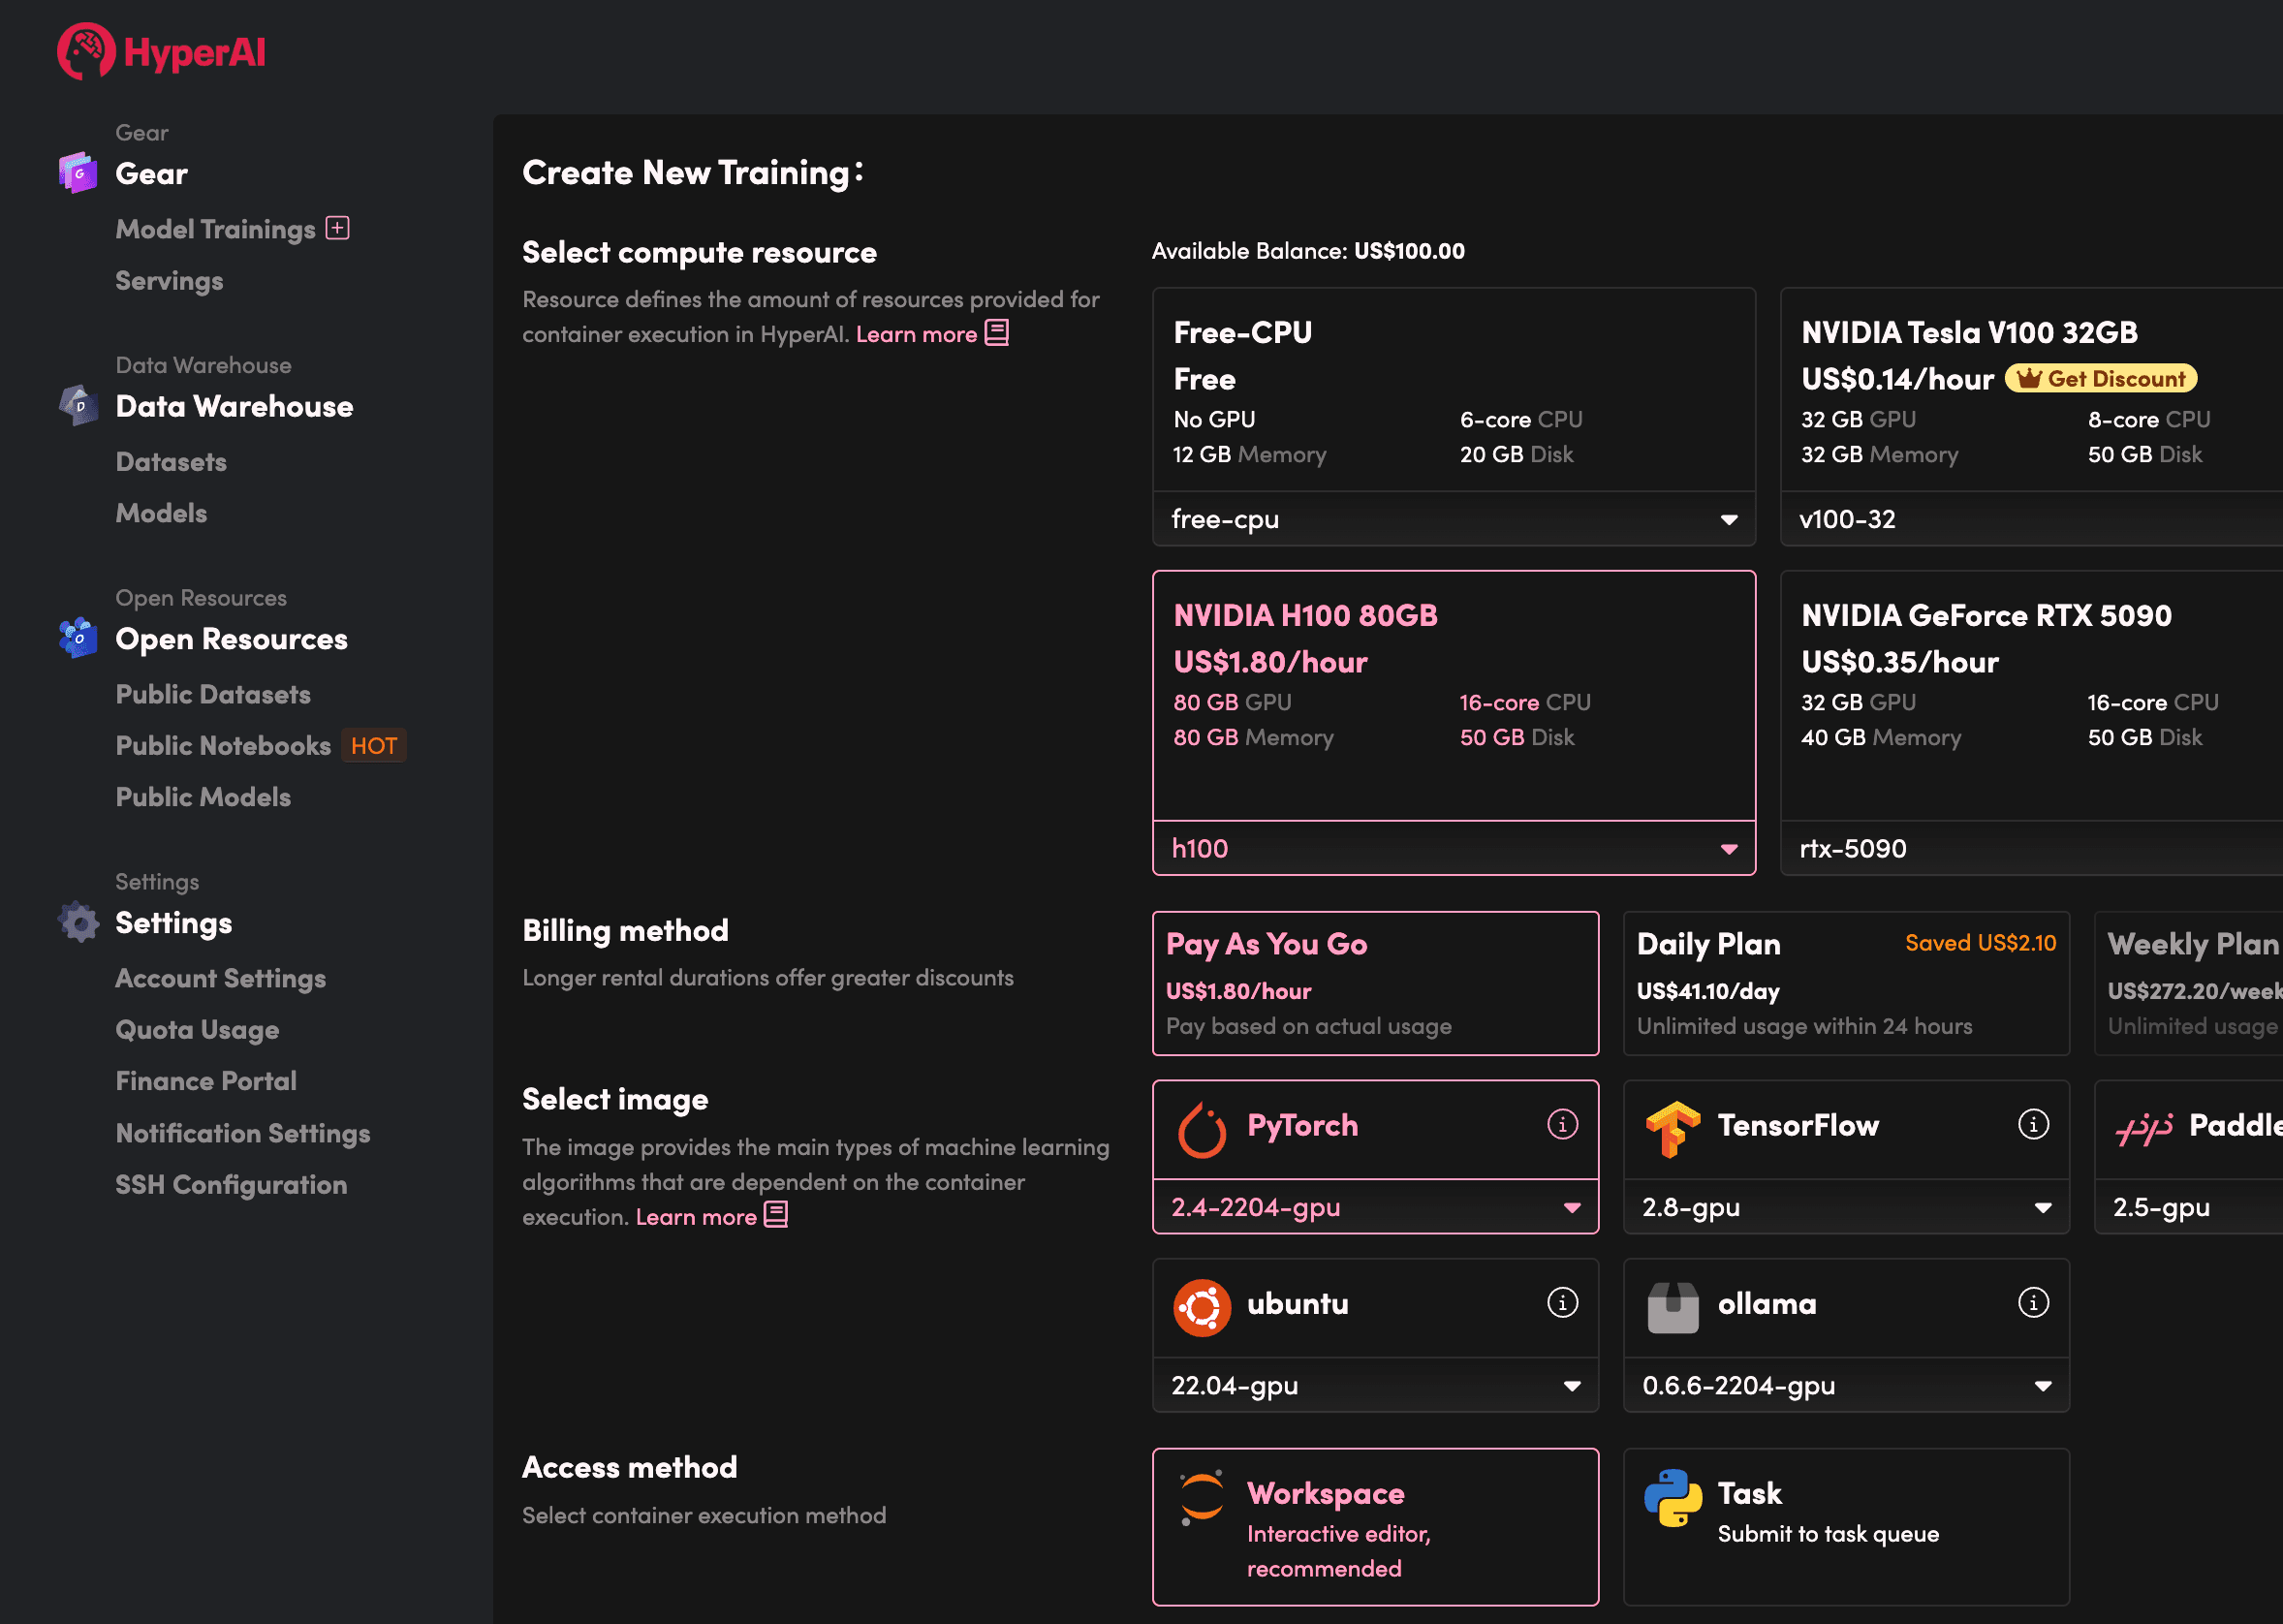
HyperAI
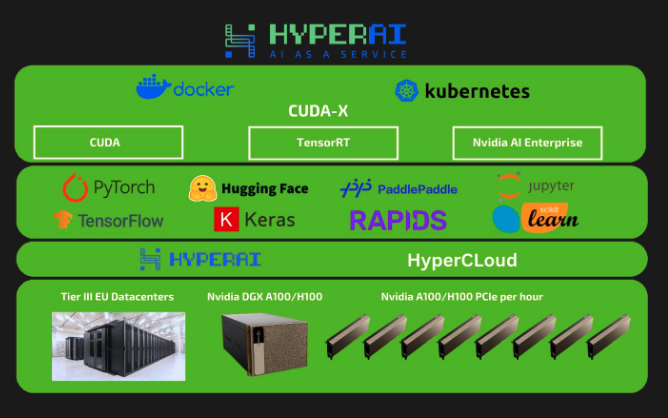
Integrate HyperAI with ZenML - Orchestrator Integrations
TVM Architecture | hyperai/tvm-cn | DeepWiki
Intel Gaudi 2 | GPU 排行榜 | HyperAI超神经
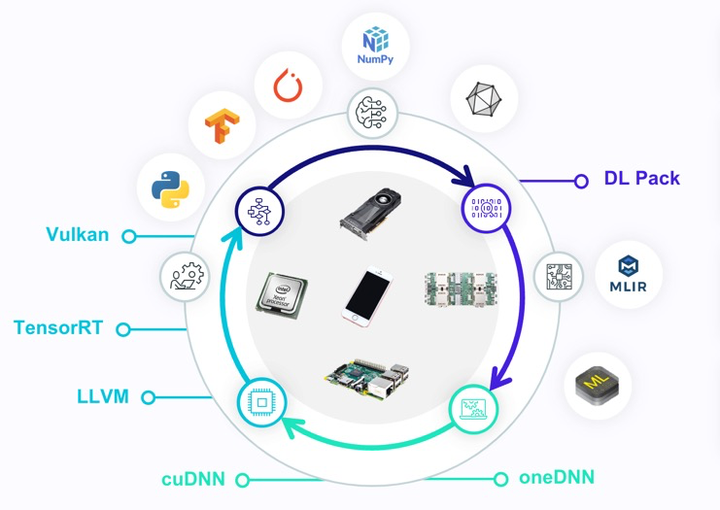
TVM 中文文档正式上线!最全机器学习模型部署「参考书」它来了 - 知乎
Advertisement Space (336x280)
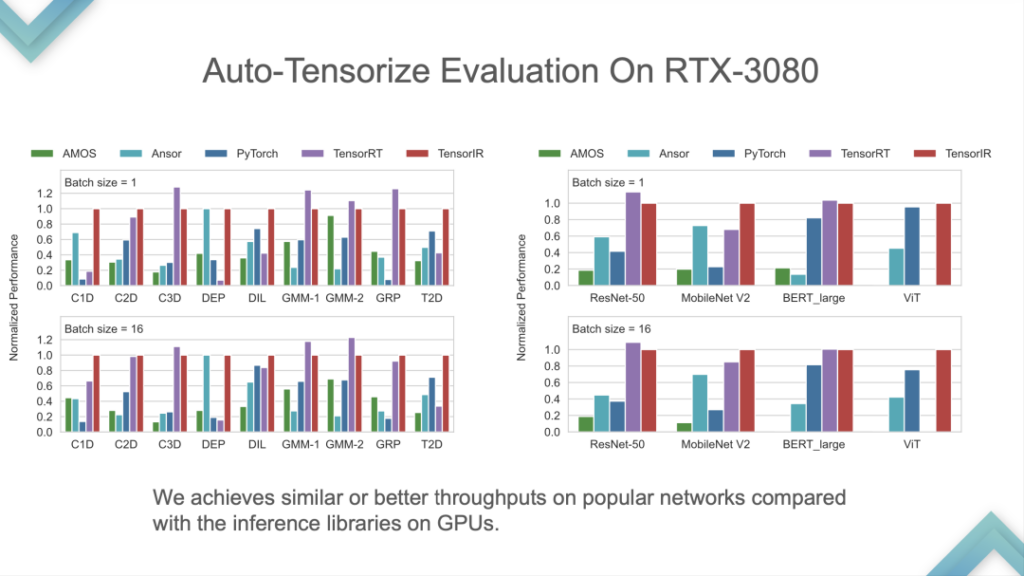
Feng Siyuan: Apache TVM と機械学習コンパイルの開発 | ニュース | HyperAI超神経

ただ!世界最速の GPU RTX 5090 の公式価格は 14,000 元以上、国家銀行の去勢版 5090 D の価格は 16,000 元以上 ...
HyperAI

AI Tool : DRP-AI TVM | Renesas ルネサス
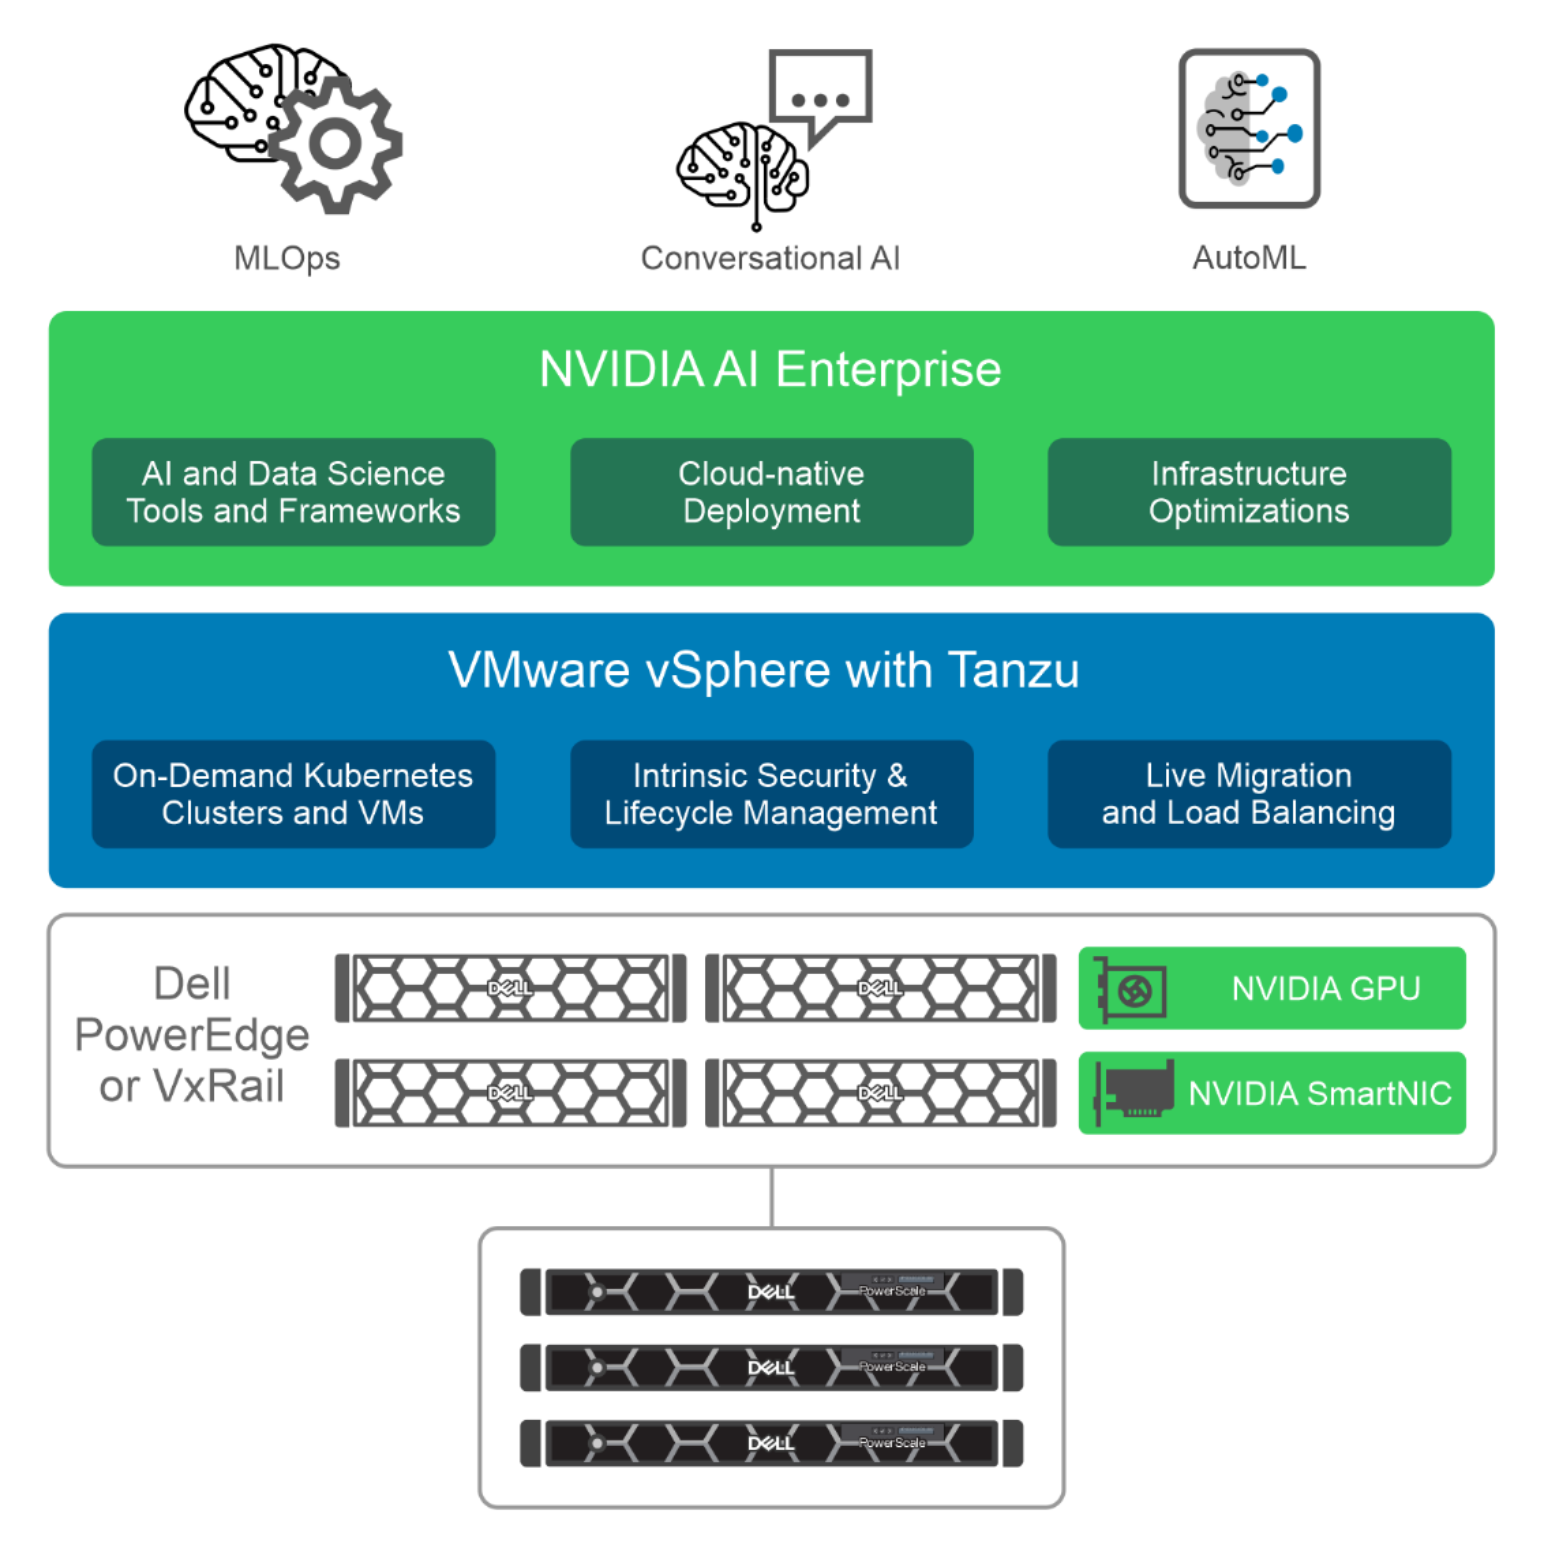
Ảo hóa GPU cho AI với VMware và NVIDIA Dựa trên Cơ sở hạ tầng Dell - Gtek
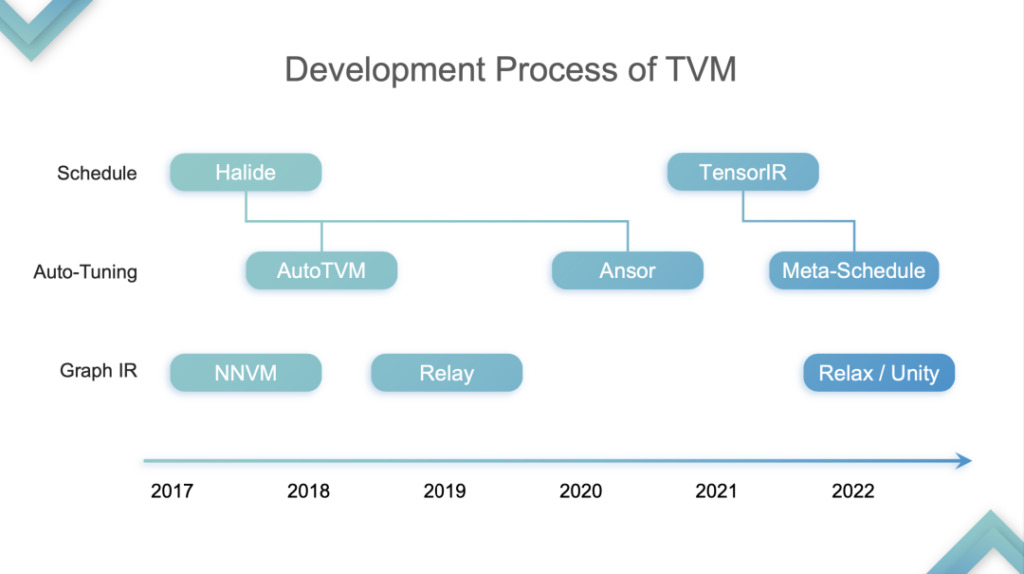
冯思远:Apache TVM 与机器学习编译发展 | 资讯 | HyperAI超神经