
How Positional Encoding Multi Head Attention Powers Transformers

How Positional Encoding & Multi-Head Attention Powers Transformers ...

How Positional Encoding & Multi-Head Attention Powers Transformers ...

How Positional Encoding & Multi-Head Attention Powers Transformers ...

How Transformers See Language: Multi-Head Attention and Positional ...

How Transformers See Language: Multi-Head Attention and Positional ...

Positional Encoding & Multi-Head Attention

Positional Encoding in Transformers Explained from First Principles
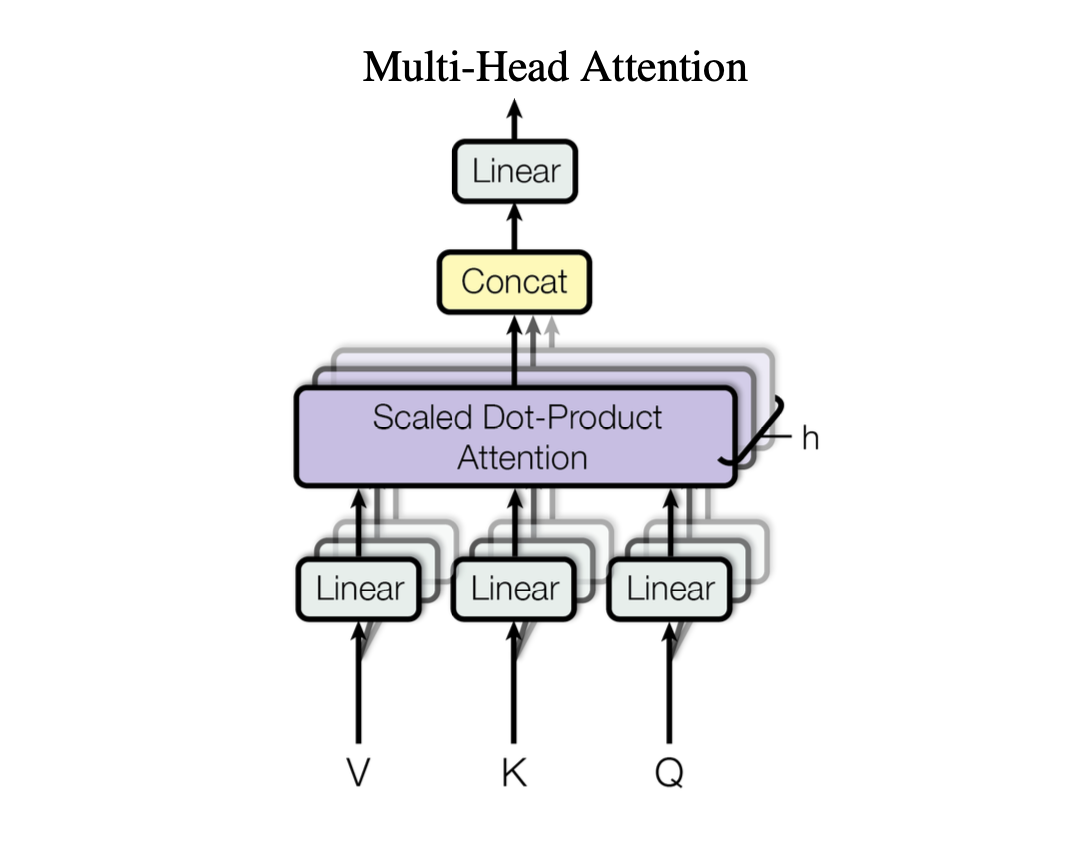
Multi-Head Attentionの仕組み | Multi Head Attention Concat – ZDSUR
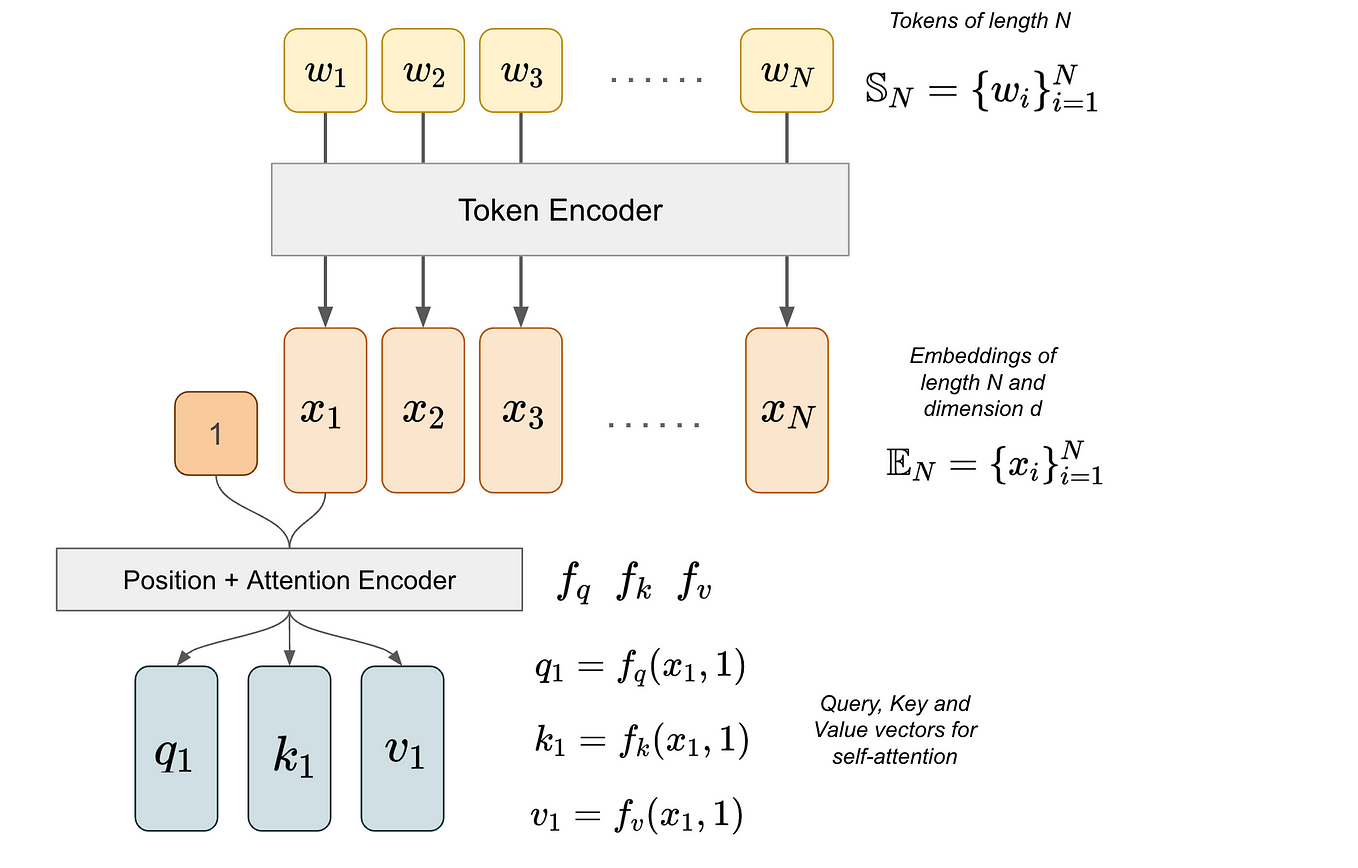
Understanding Positional Encoding in Transformers and Beyond with Code ...
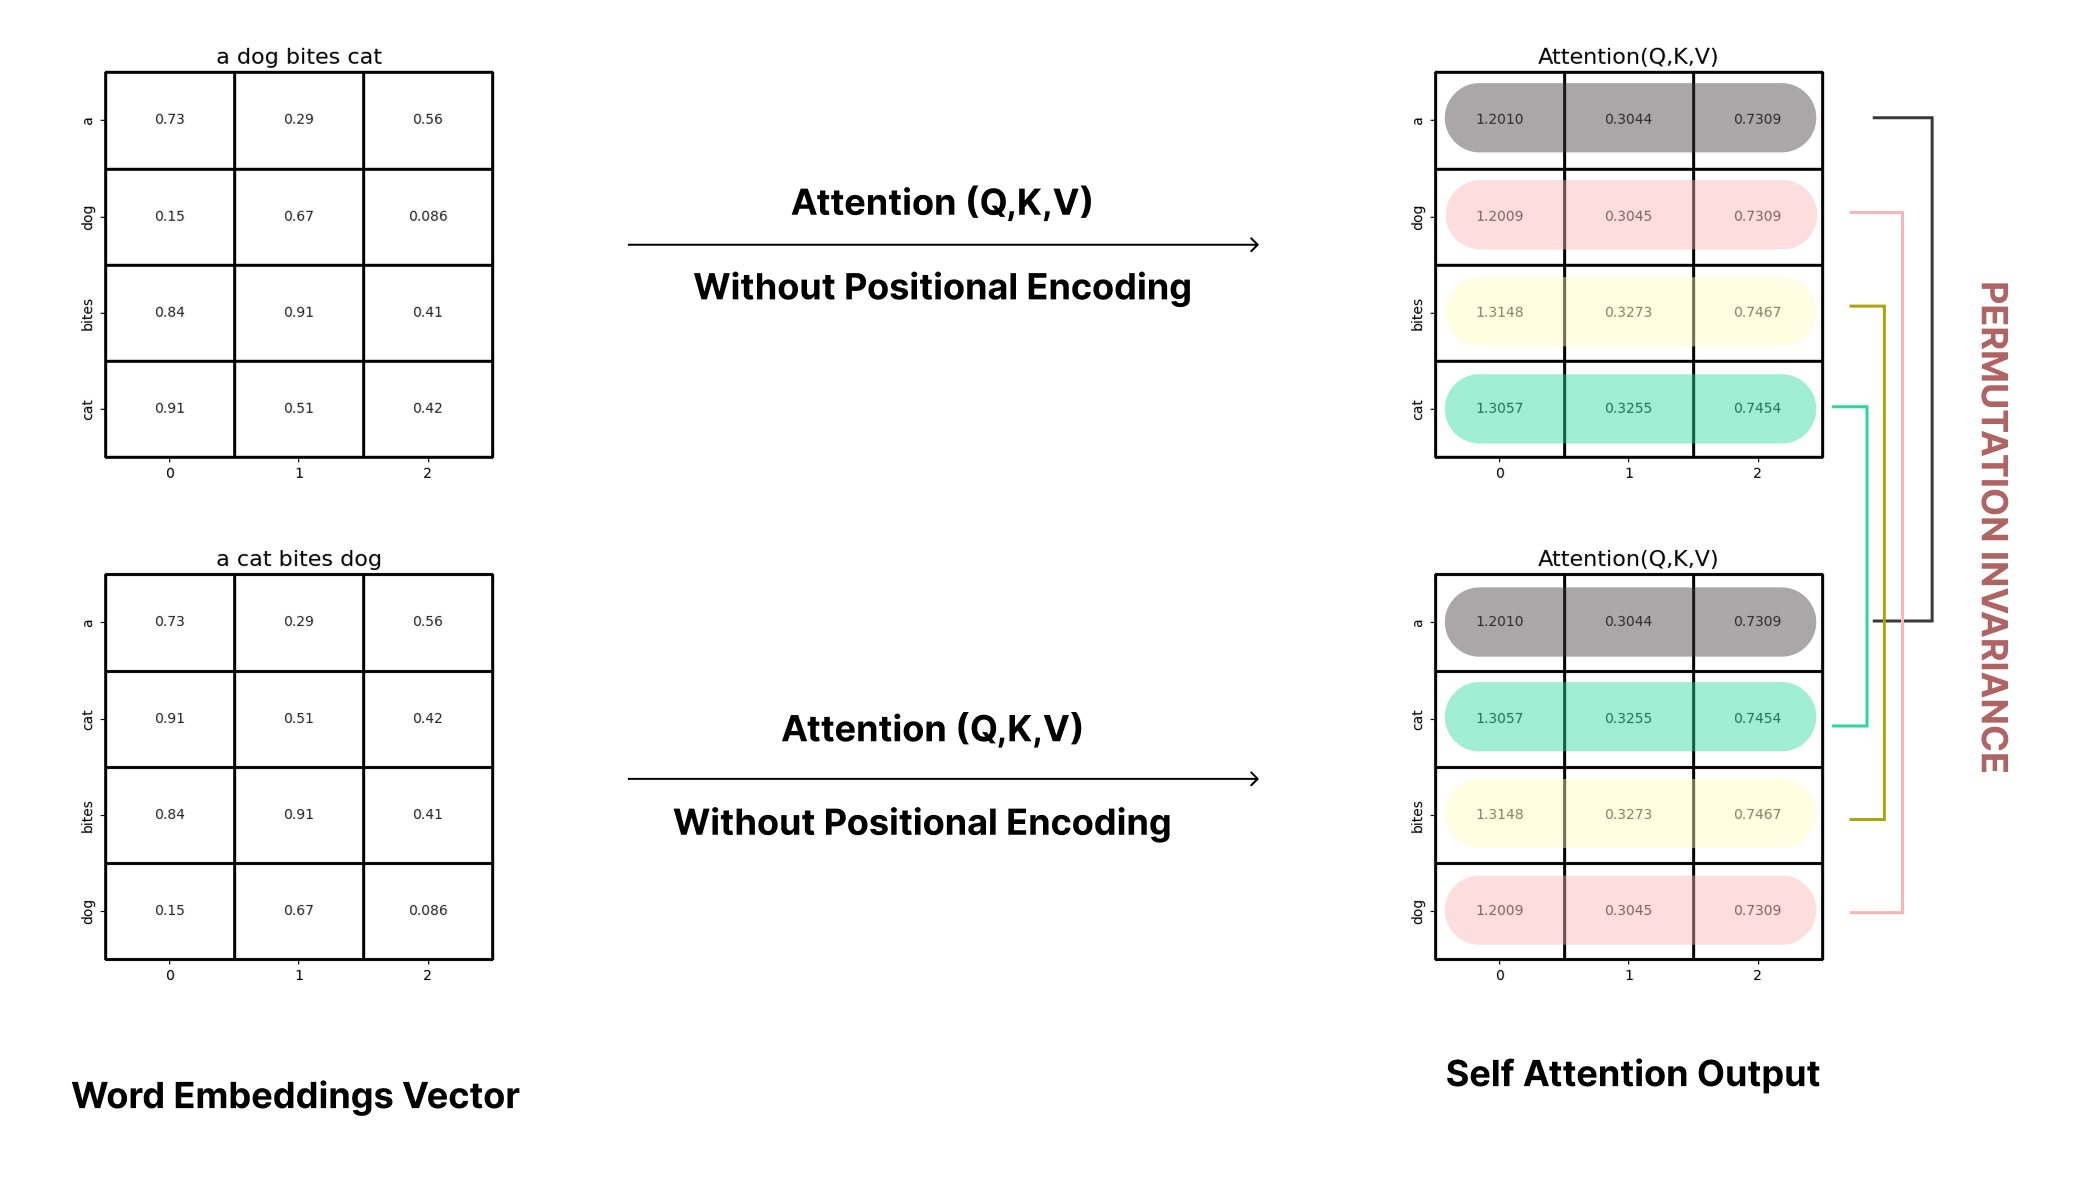
Two Whys Behind Positional Encoding in Transformers | Sri dhurkesh
Advertisement Space (300x250)

Flow chart of Transformer,¹ which consists of positional encoding ...
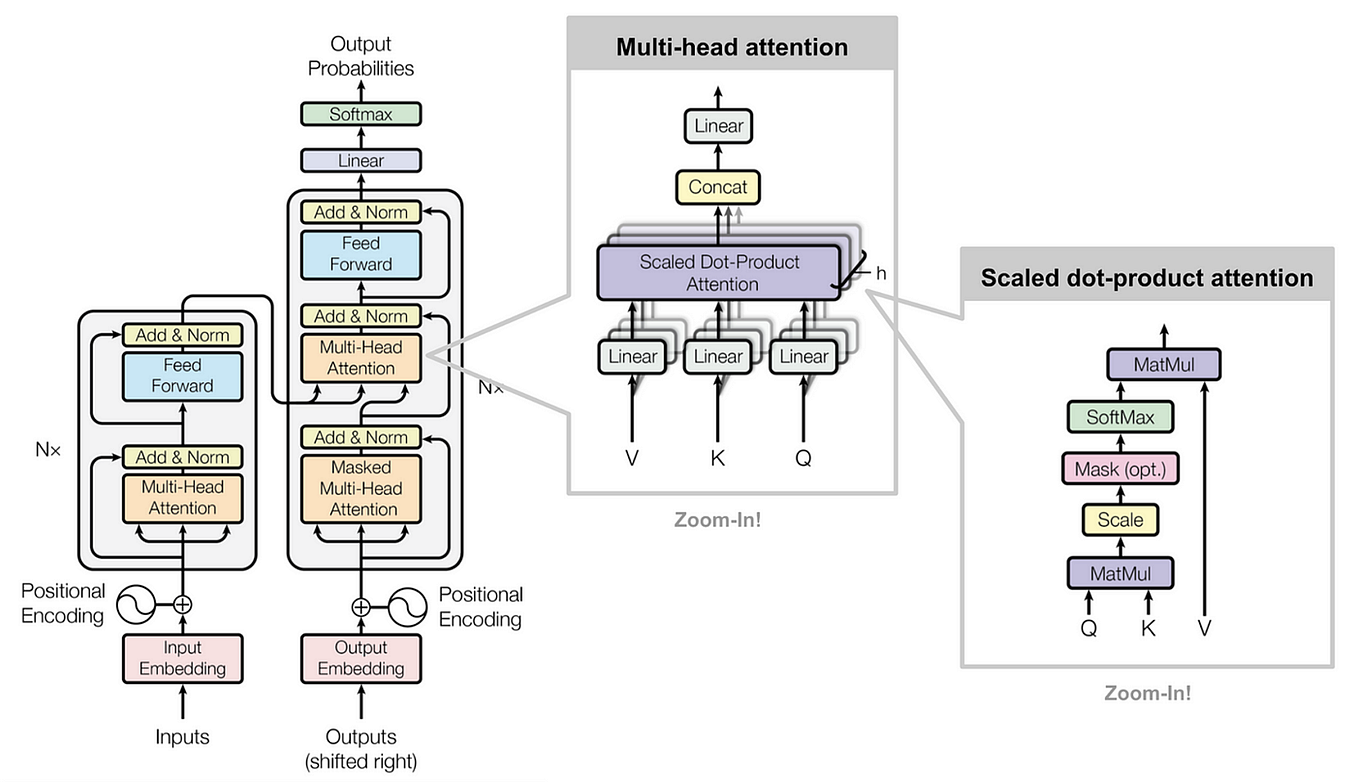
Demystifying Transformers: Positional Encoding | by Dagang Wei | Medium

Understanding The Attention Mechanism in Transformers with Code | by ...
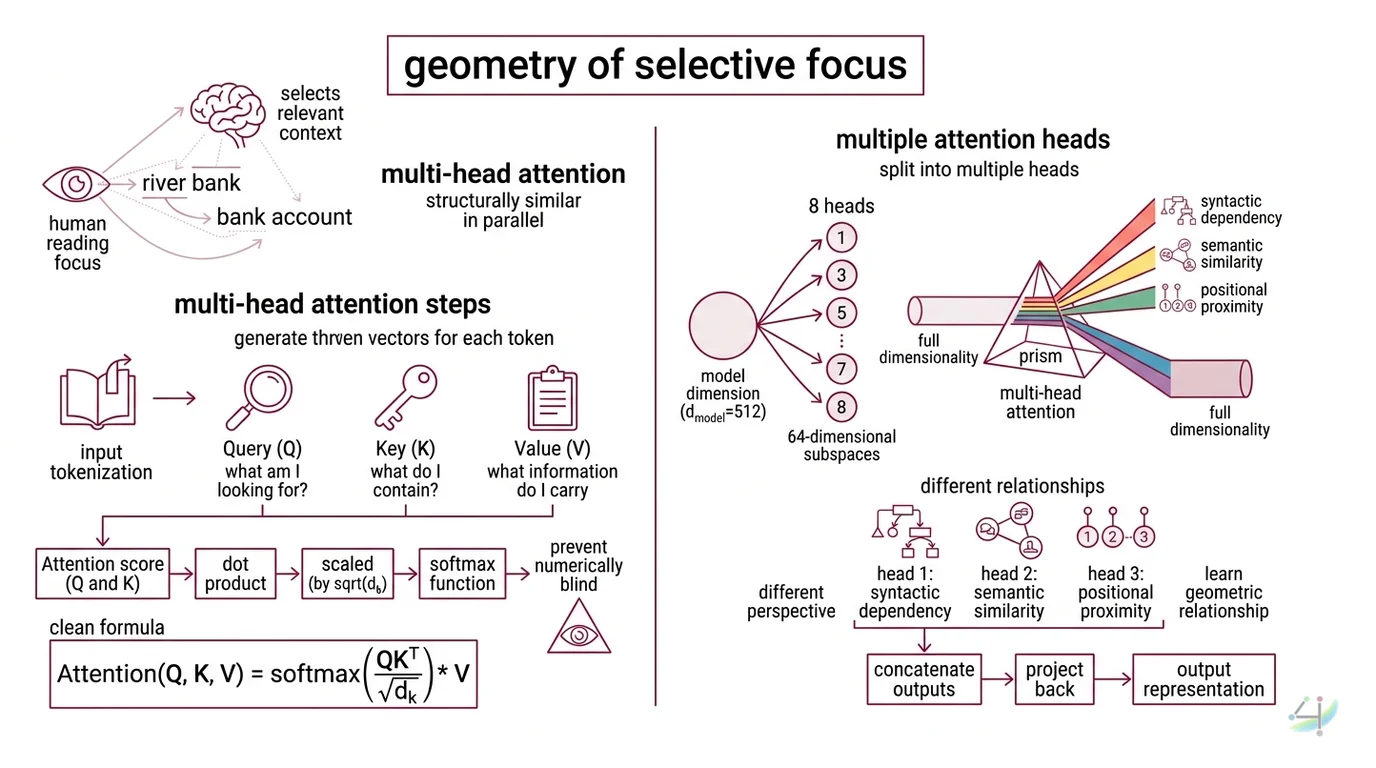
How Transformer Architecture Works: Attention Explained

Explain the need for Positional Encoding in Transformer models (with ...
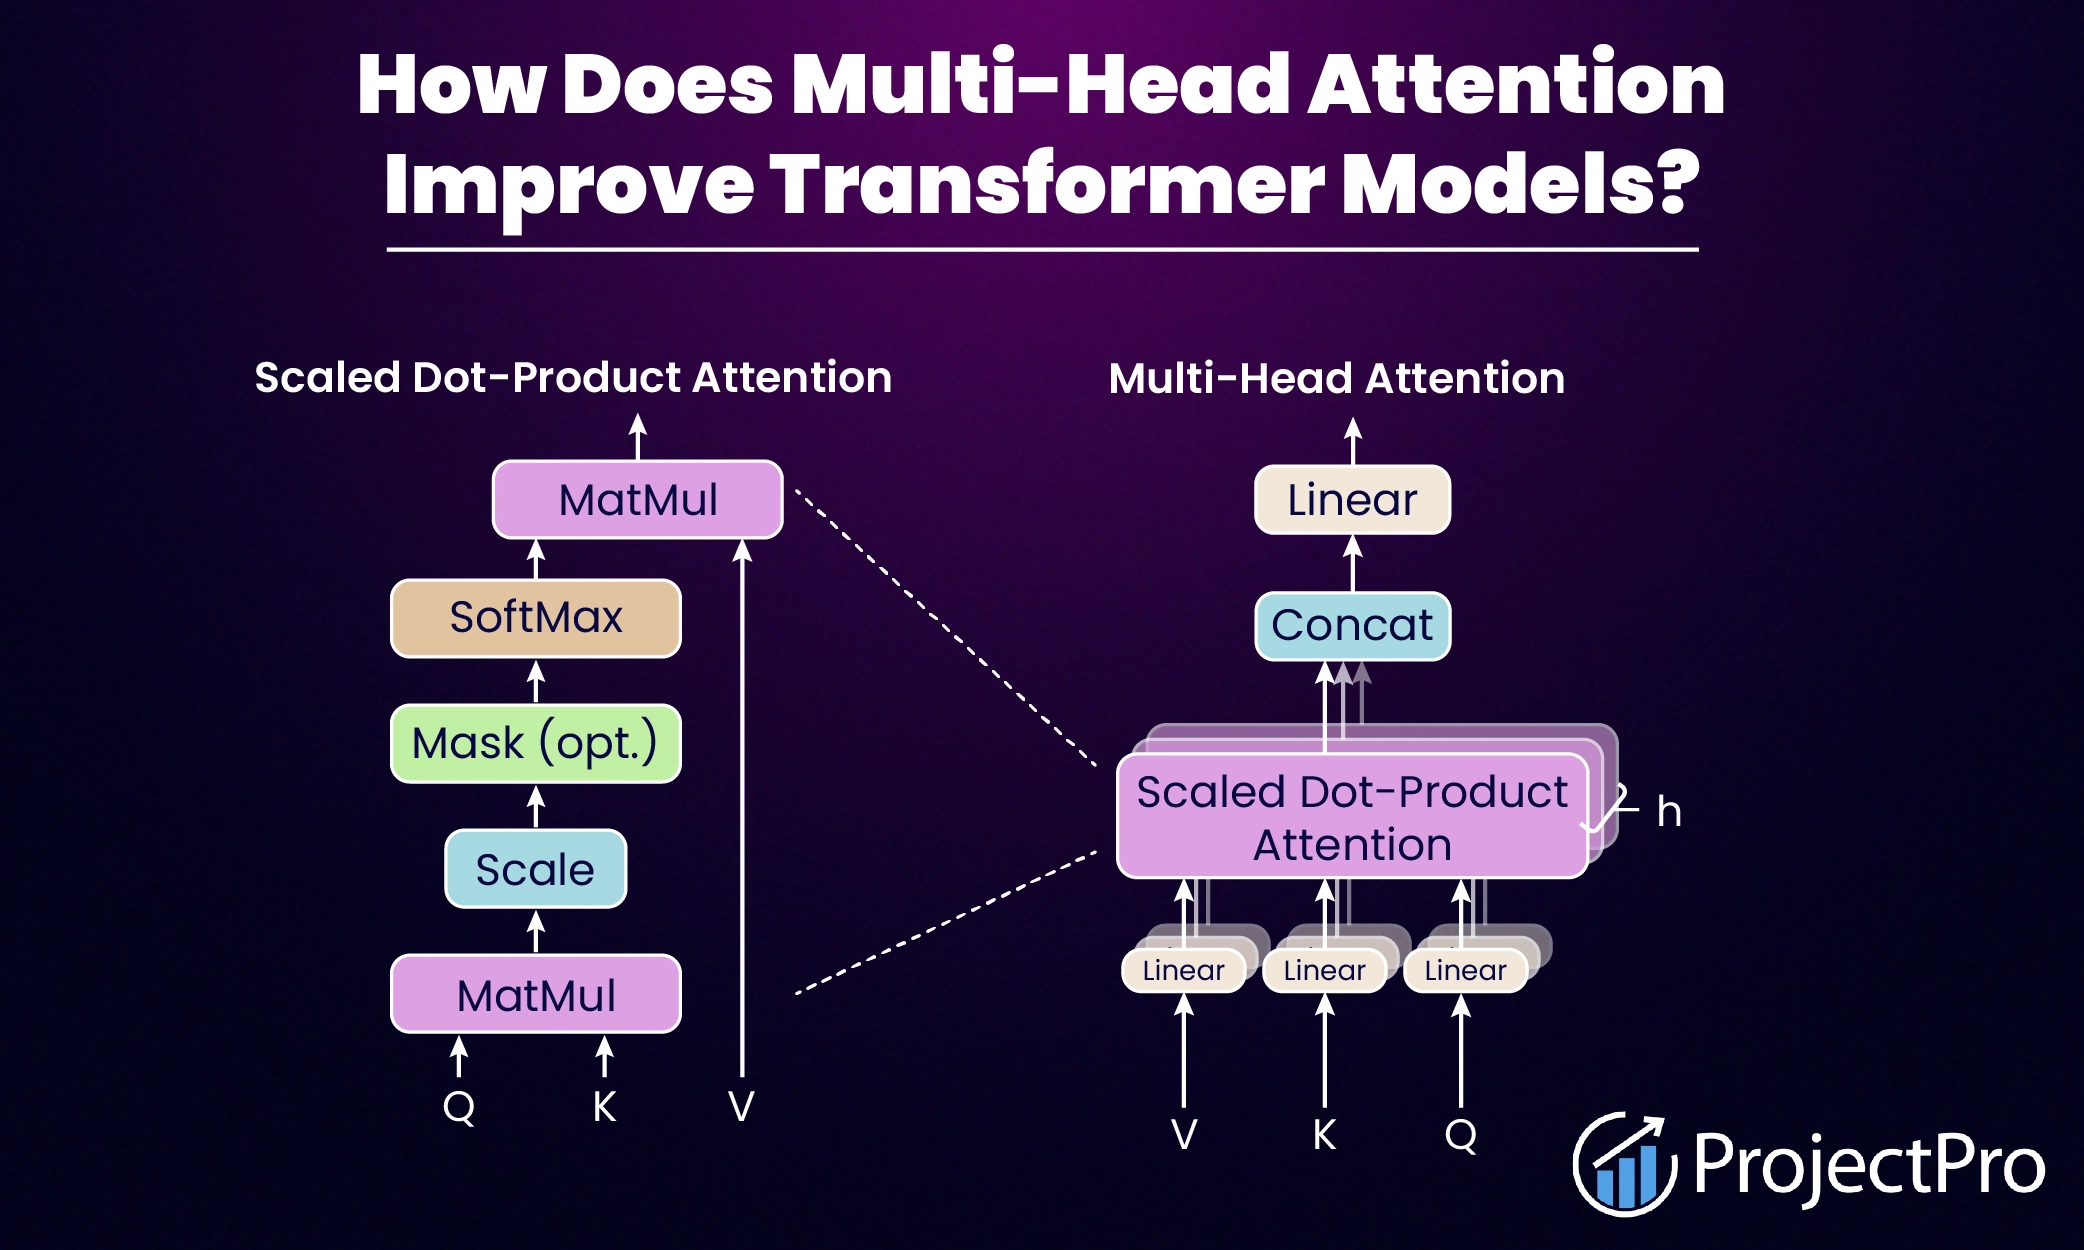
How Does Multi-Head Attention Improve Transformer Models?
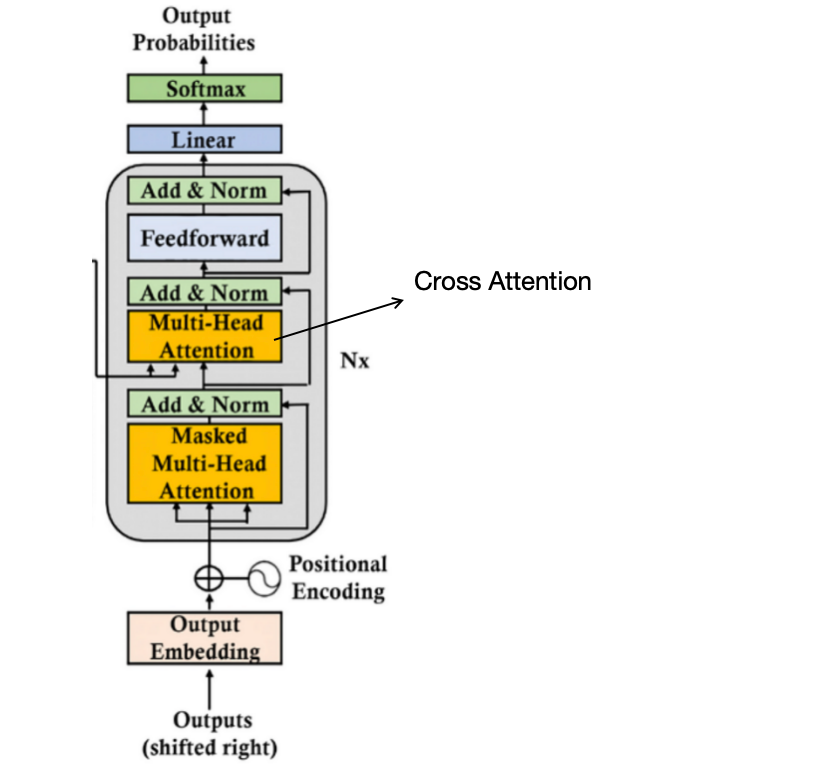
Attention Evolved: How Multi-Head Latent Attention Works | by Karl ...

28. Transformers – Improving Natural Language Processing with Attention ...
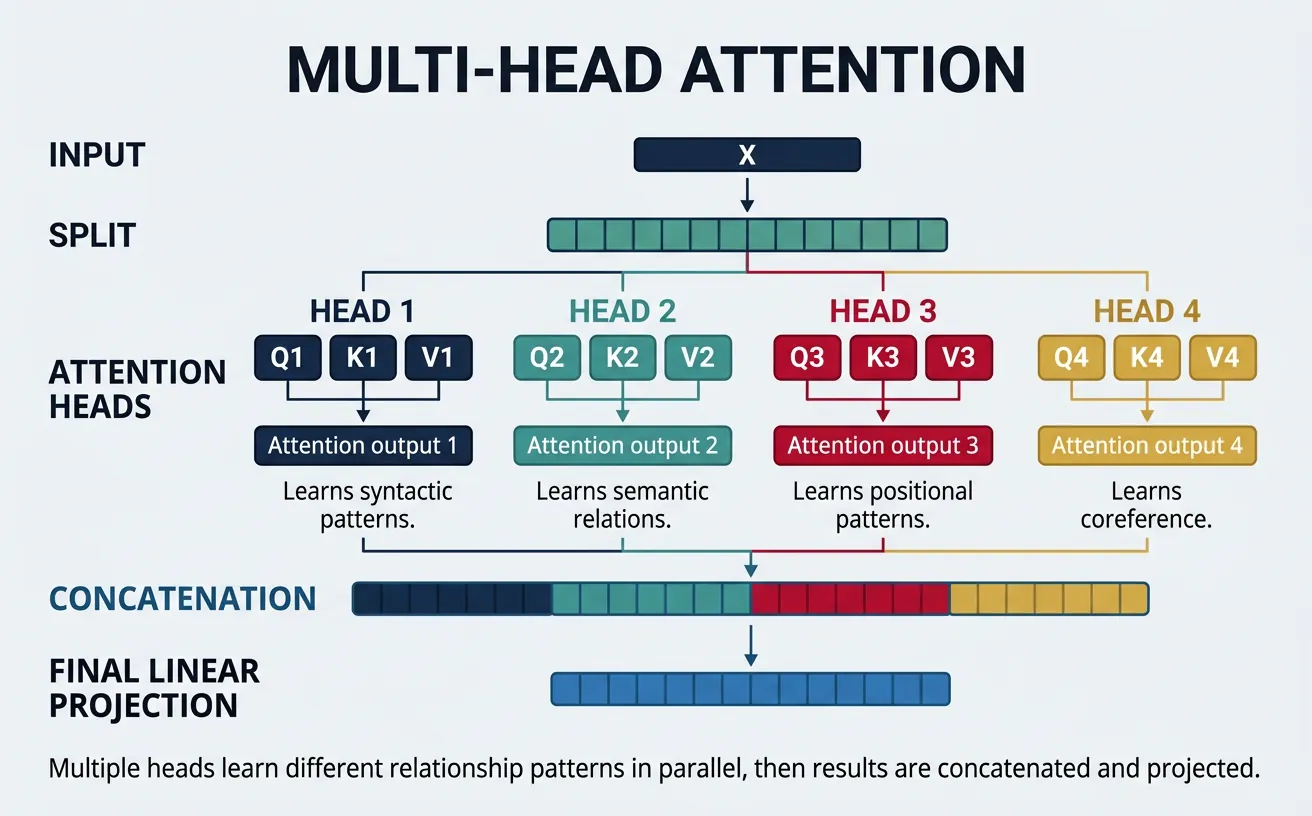
Transformers & Attention Mechanism - Complete NLP Series Part 8 - Wasil ...
How Transformer Architecture Works: Attention Explained
Advertisement Space (336x280)
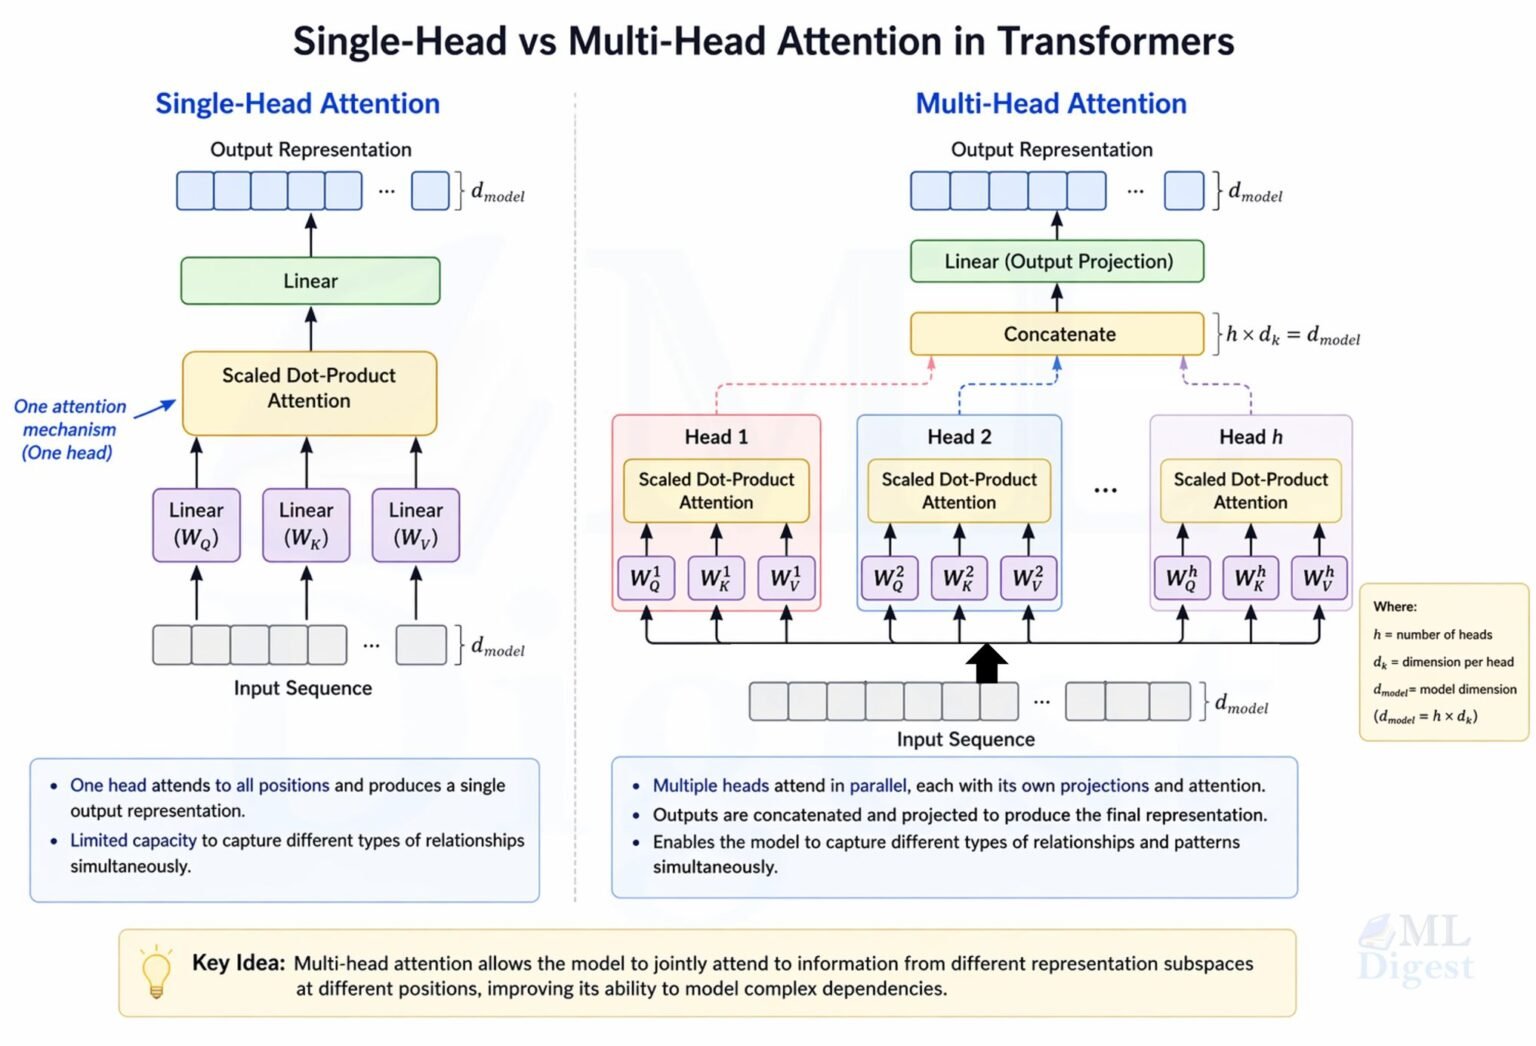
Attention Mechanism: The Heart of Transformers - ML Digest

Positional Encoding Made Simple : an Illustrated guide | by Salomé ...
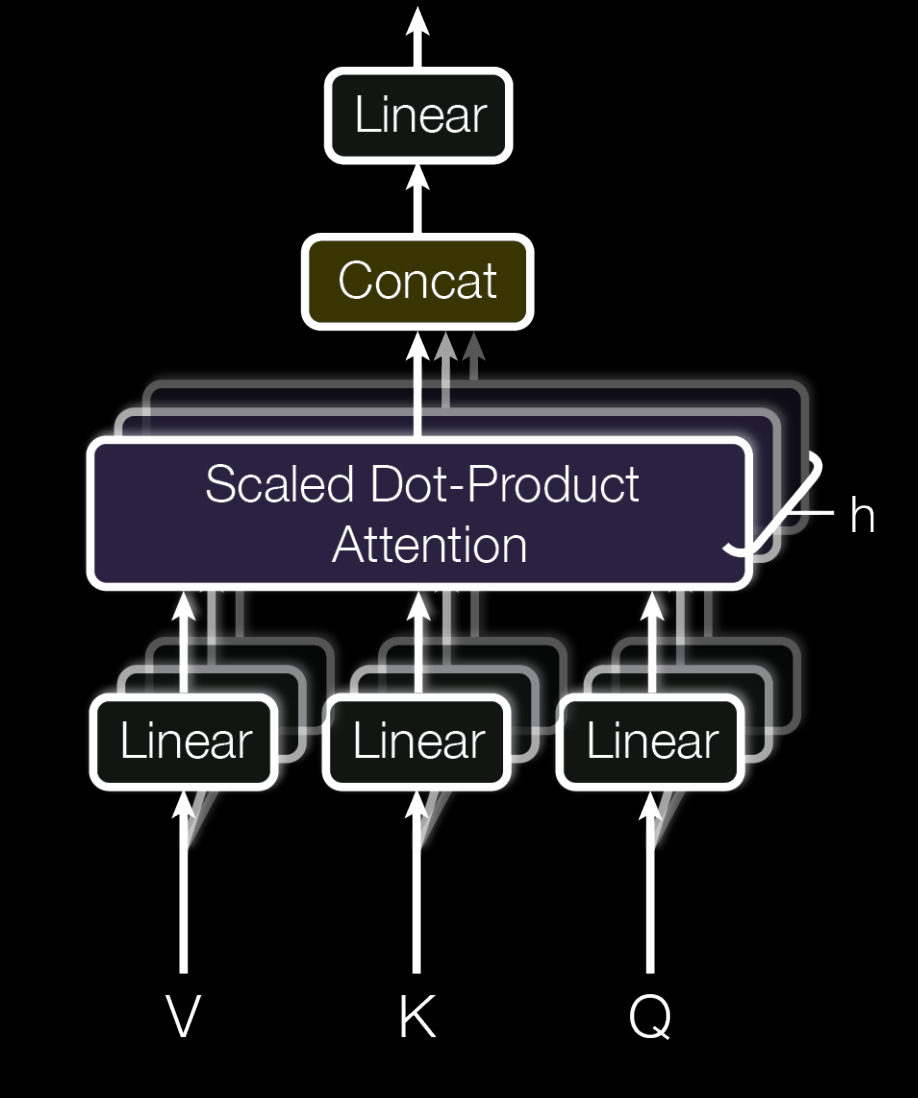
Attention & Transformers | CAIS++

Positional Encoding in Transformer-Based Time Series Models: A Survey
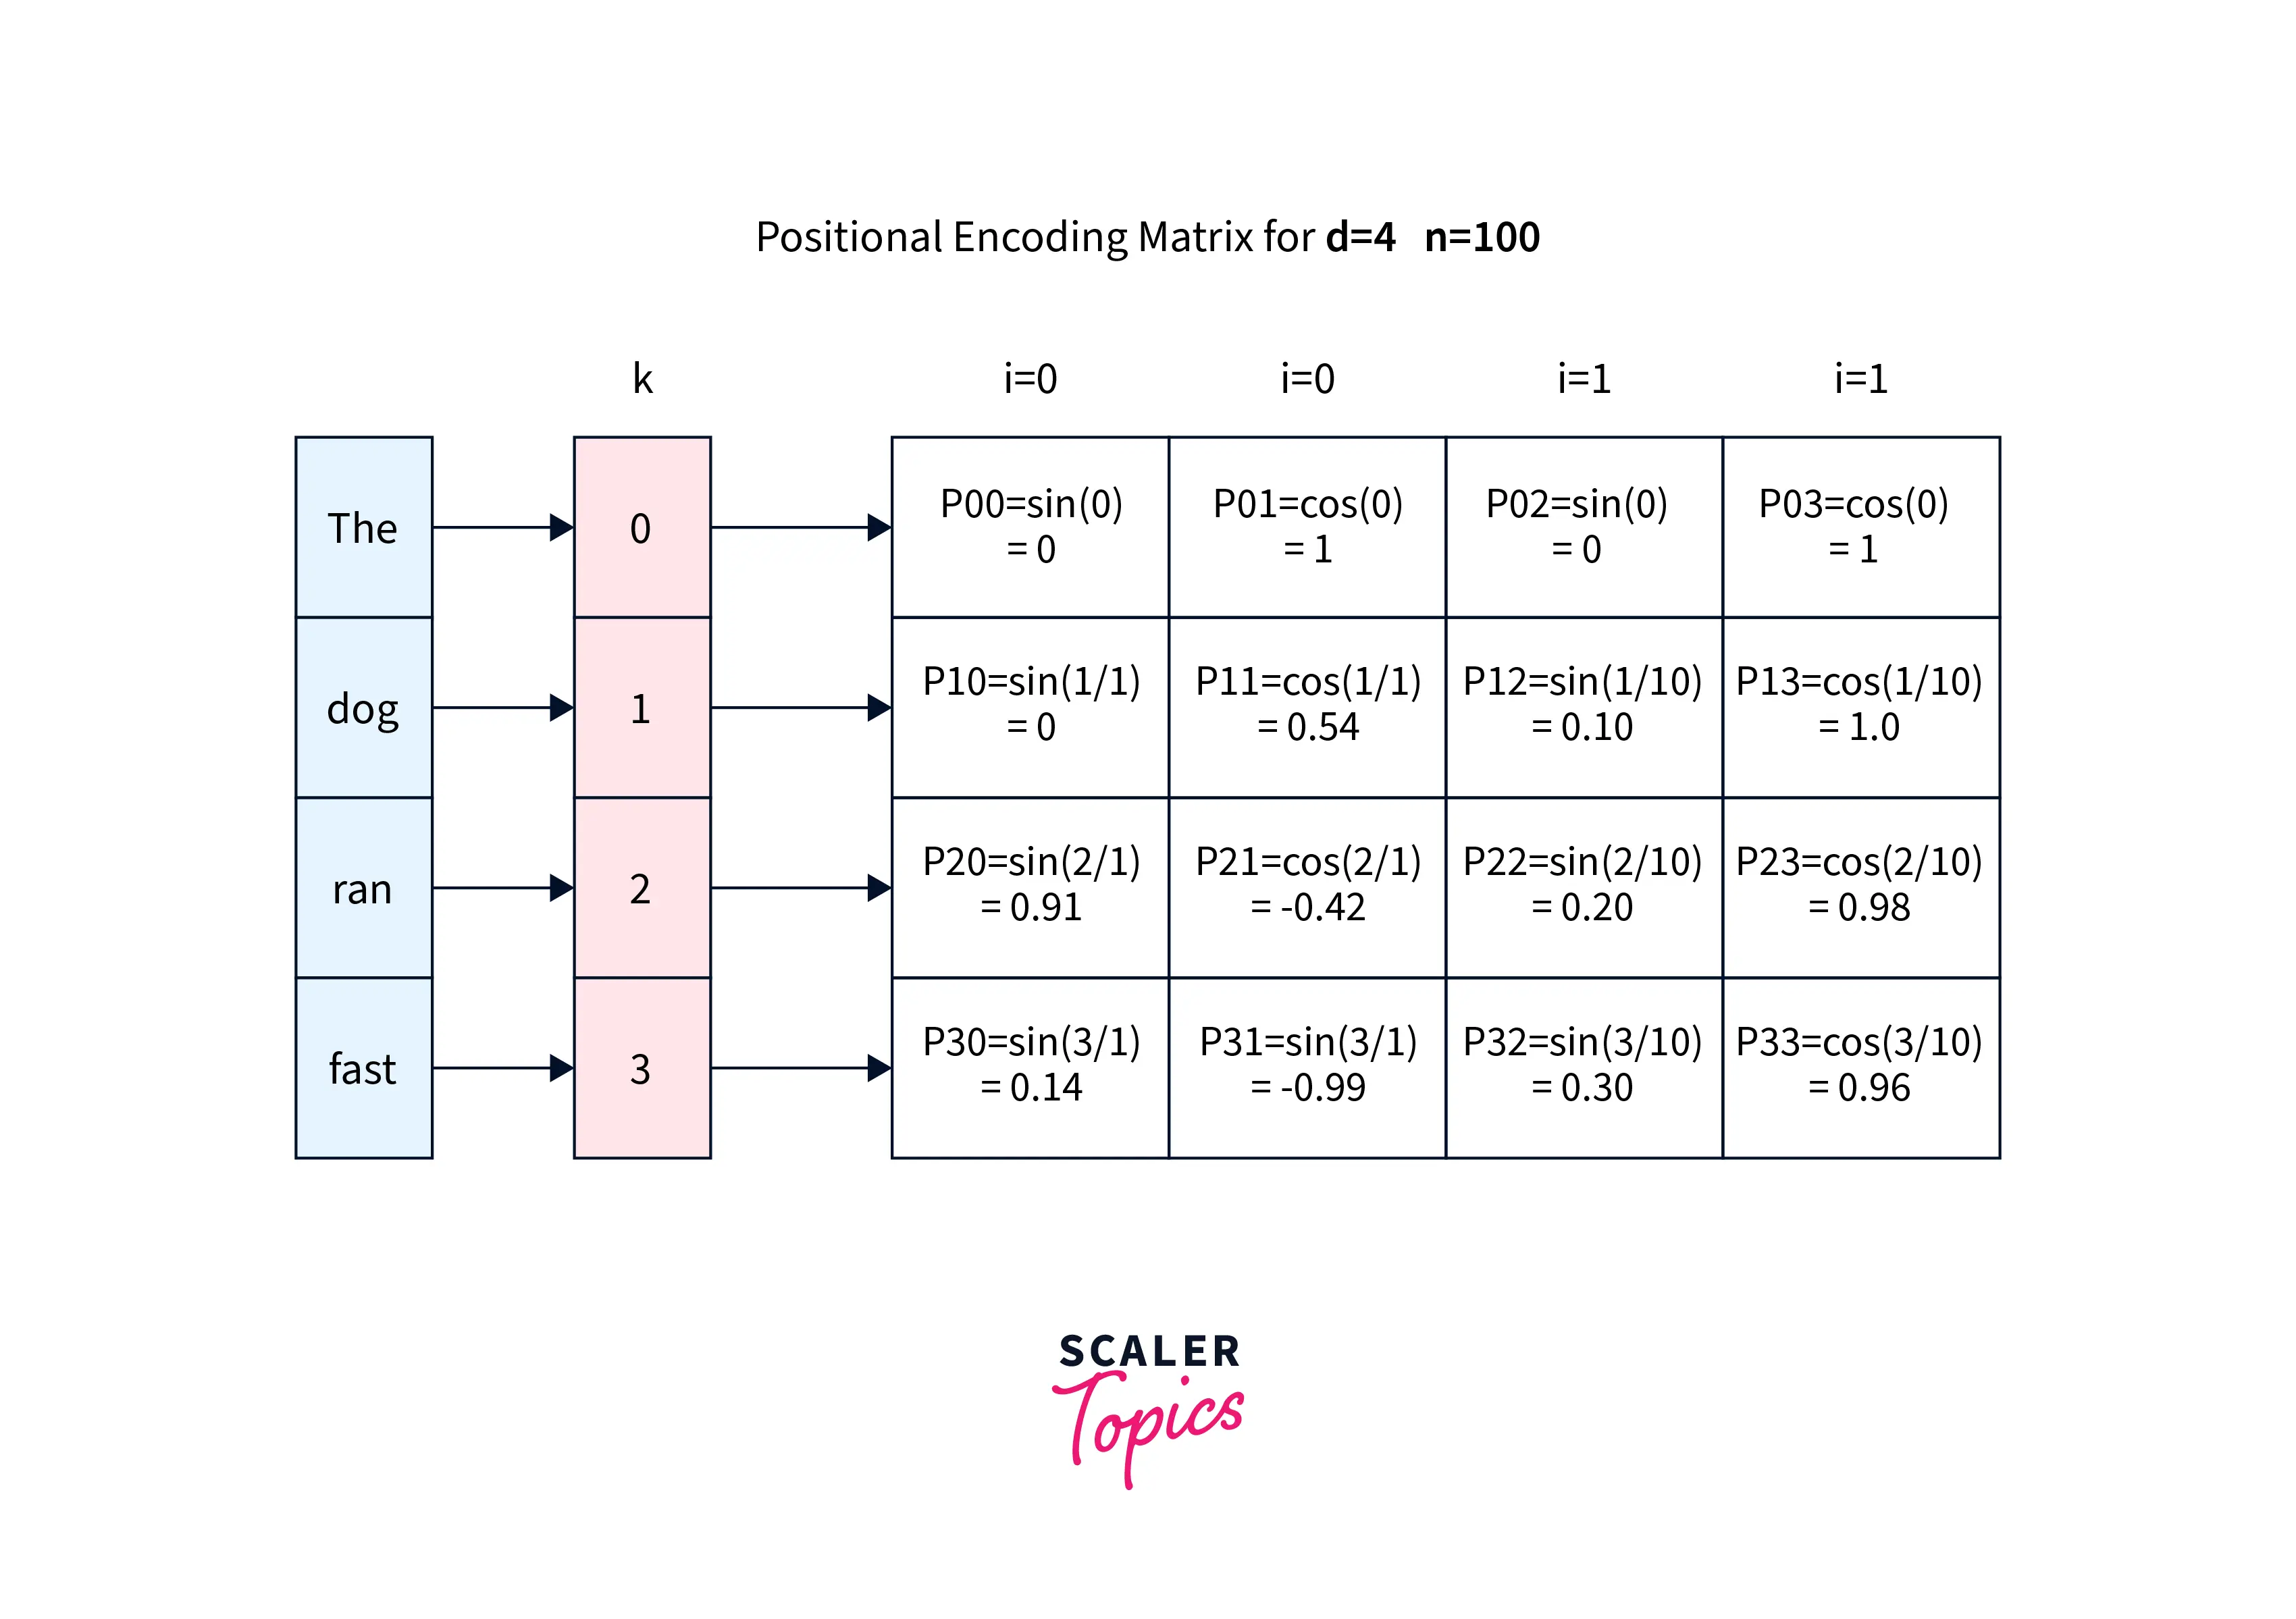
A Gentle Introduction To Positional Encoding In Transformer Models – PWQAVC
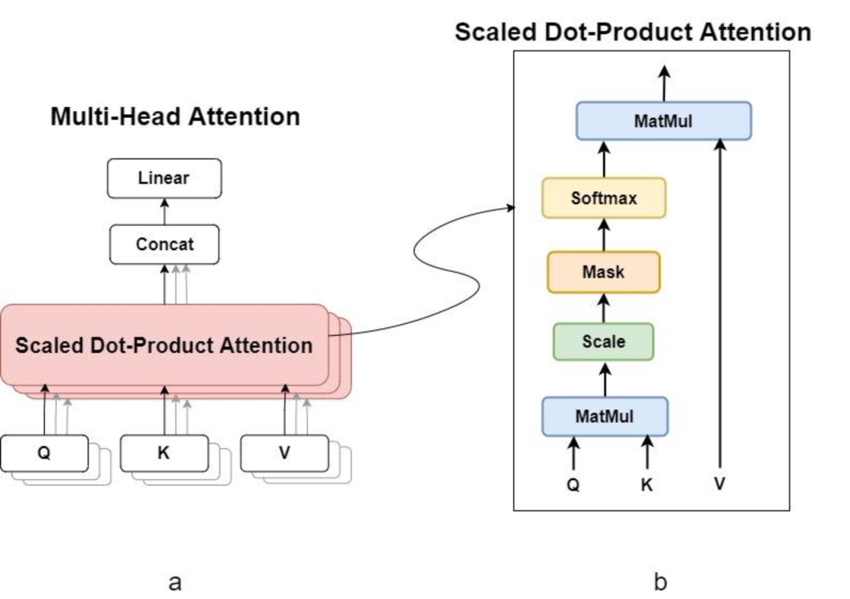
How Does Multi-Head Attention Improve Transformer Models?

Flow chart of Transformer,¹ which consists of positional encoding ...
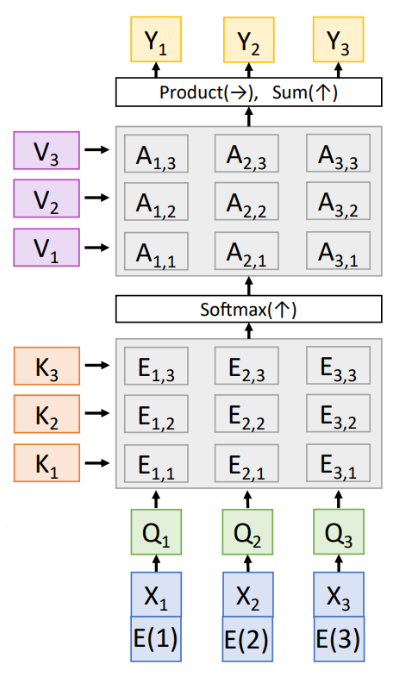
Attention & Transformers | Vision-Array

Multi-Head Attention in Transformers | AI Tutorial | Next Electronics

Detailed view of a transformer block which powers the dynamic state of ...
Advertisement Space (336x280)

Details of the internal layers of the multi-head attention layer. The ...
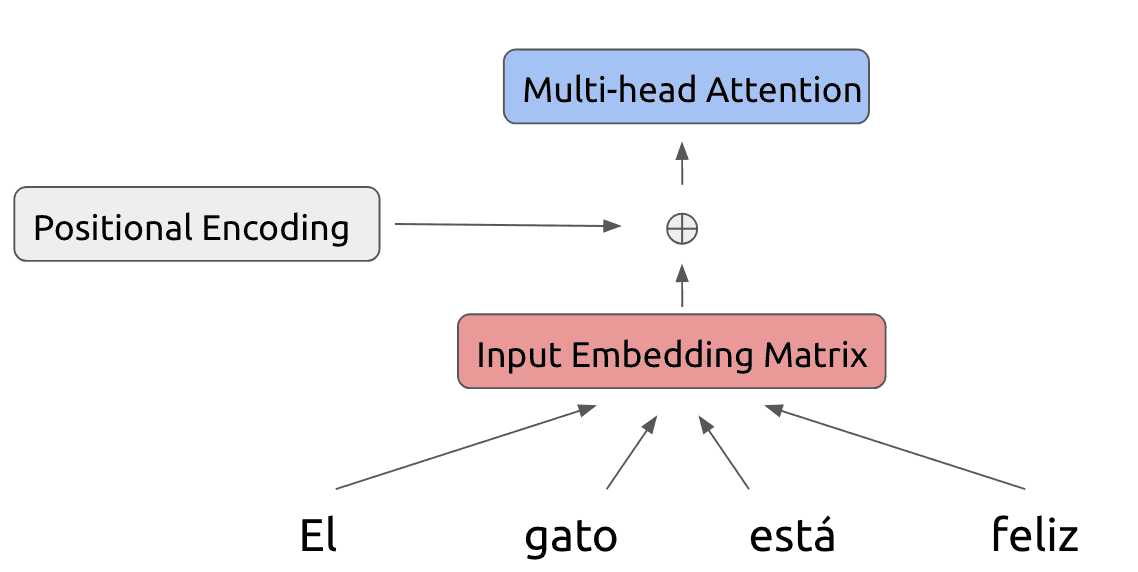
Transformers: Attention in Disguise - Mihail Eric

Attention and Transformer Networks | Springer Nature Link

Transformers | Pu Zhang's Personal Website
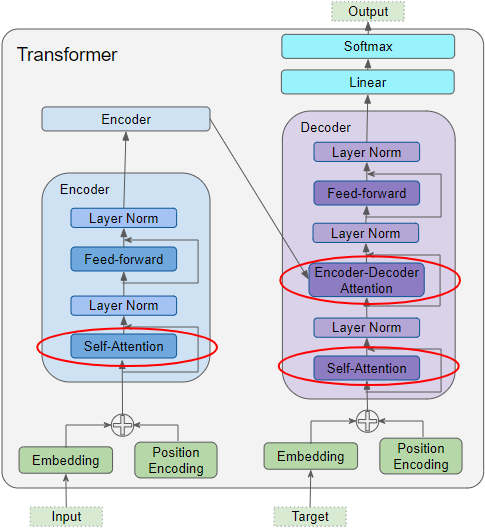
Transformers Explained Visually - Multi-head Attention, deep dive ...
Transformer and Multi-Head attention mechanism. In contrast to LSTM ...