
I Vitinteger Only Quantization For Efficient Vision Transformer
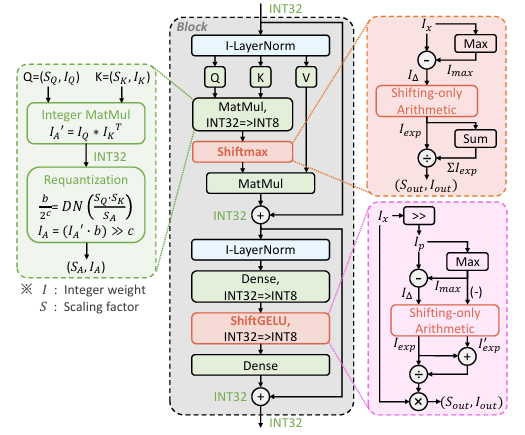
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
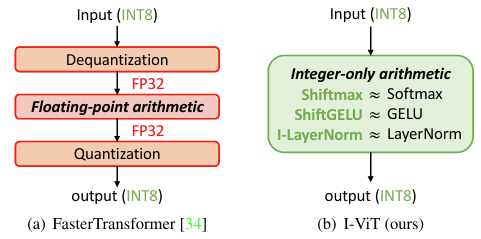
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
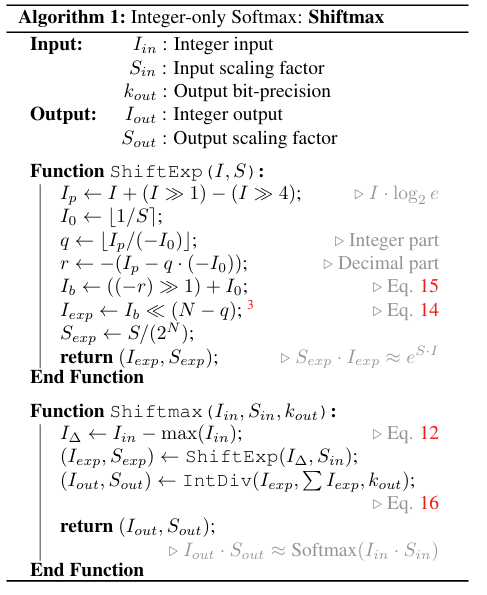
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
I-ViT Integer-only Quantization for Efficient Vision Transformer ...

I-ViT: Integer-only Quantization for Efficient Vision Transformer Inference
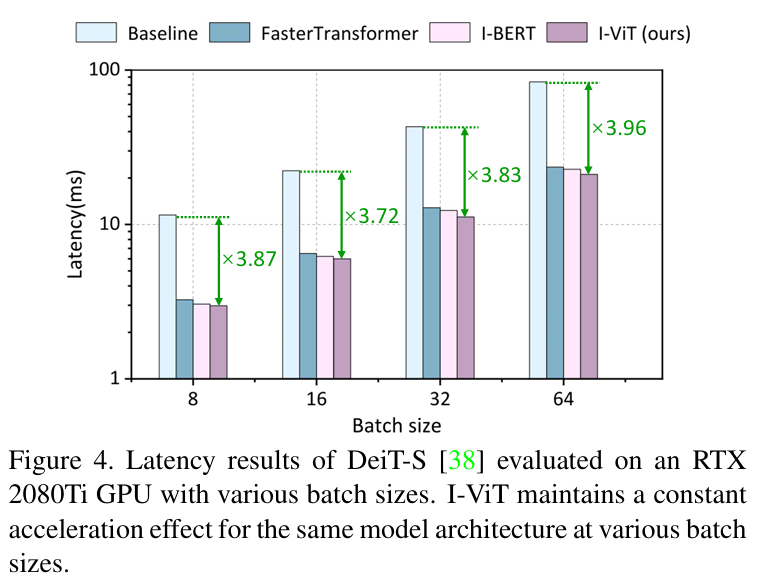
I-ViT: Integer-only Quantization for Efficient Vision Transformer ...

I-ViT: Integer-only Quantization for Efficient Vision Transformer Inference
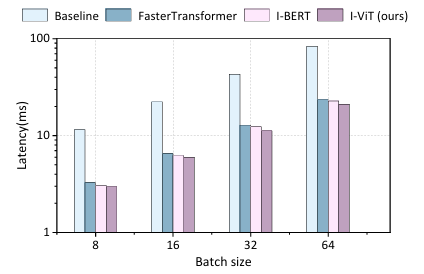
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
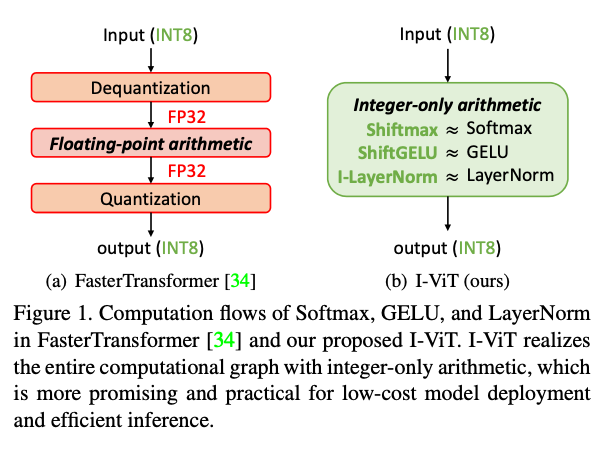
I-ViT: Integer-only Quantization for Efficient Vision Transformer ...
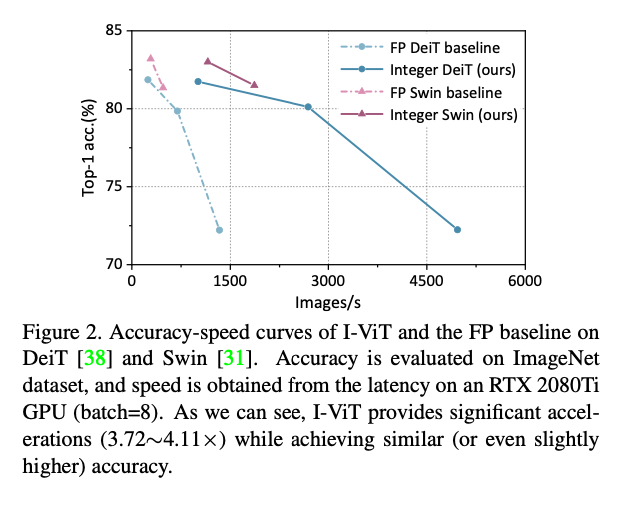
I-ViT: Integer-only Quantization for Efficient Vision Transformer ...
Advertisement Space (300x250)
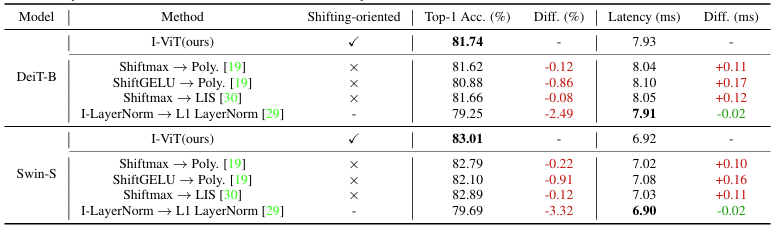
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
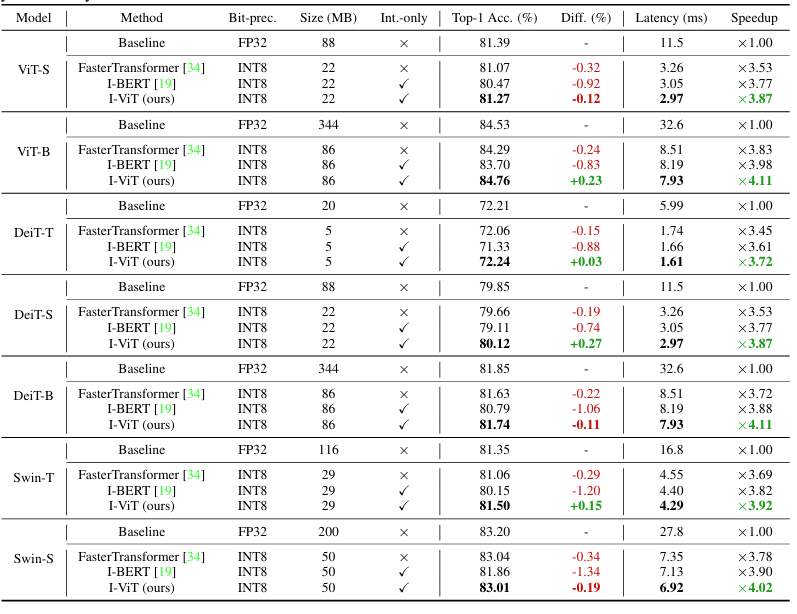
I-ViT Integer-only Quantization for Efficient Vision Transformer ...

Figure 1 from Post-Training Quantization for Vision Transformer in ...

I-Segmenter: Integer-Only Vision Transformer for Efficient Semantic ...
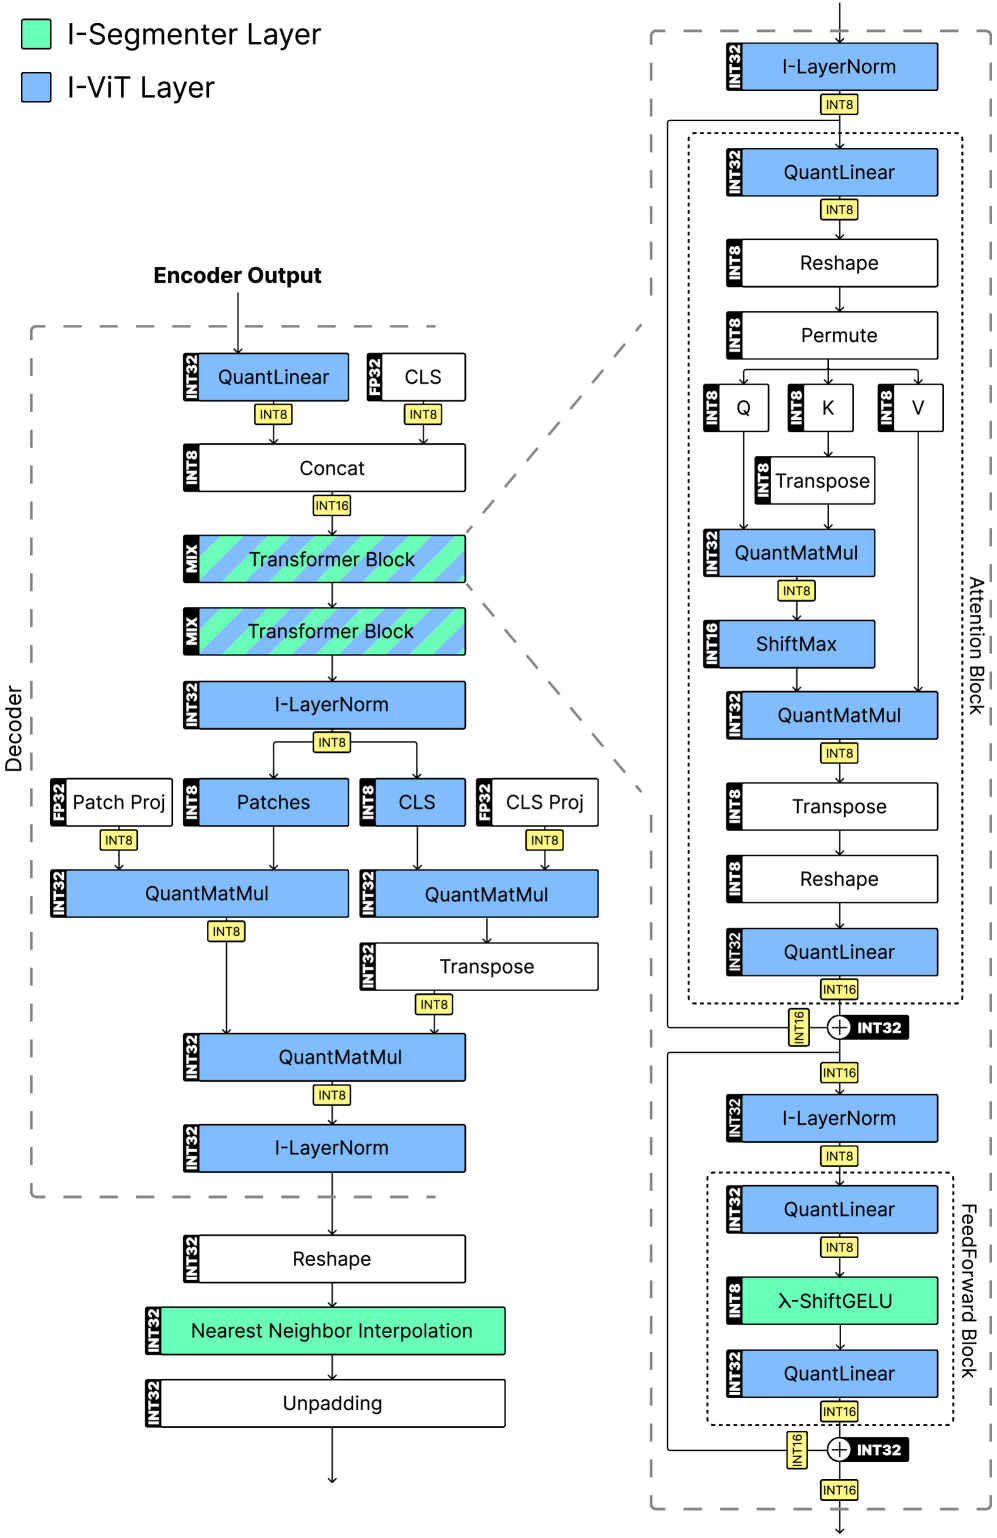
I-Segmenter: Integer-Only Vision Transformer for Efficient Semantic ...
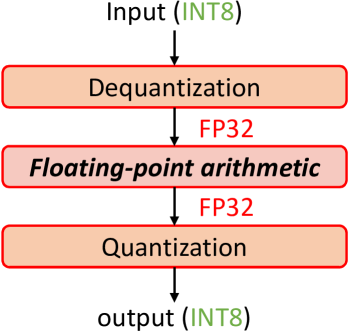
[2207.01405] I-ViT: Integer-only Quantization for Efficient Vision ...

Paper page - I-ViT: Integer-only Quantization for Efficient Vision ...

(PDF) I-Segmenter: Integer-Only Vision Transformer for Efficient ...

論文解説|I-ViT:Integer-only Quantization for Efficient Vision Transformer…

Paper page - I-Segmenter: Integer-Only Vision Transformer for Efficient ...
Advertisement Space (336x280)
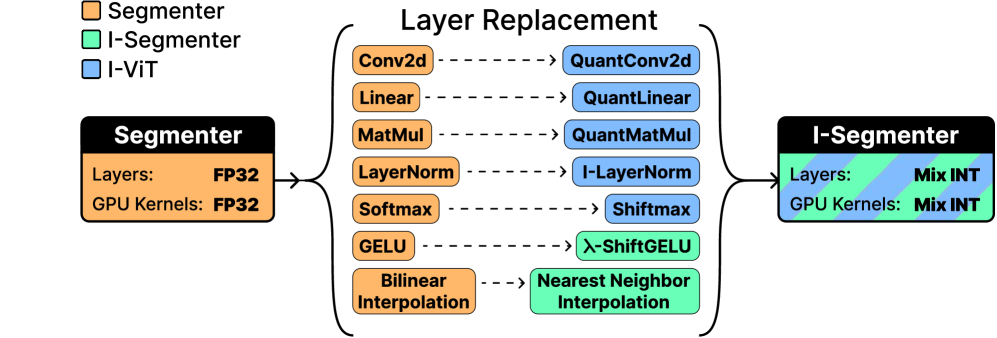
I-Segmenter: Integer-Only Vision Transformer for Efficient Semantic ...

(PDF) Scaled Quantization for the Vision Transformer

(PDF) Q-ViT: Fully Differentiable Quantization for Vision Transformer
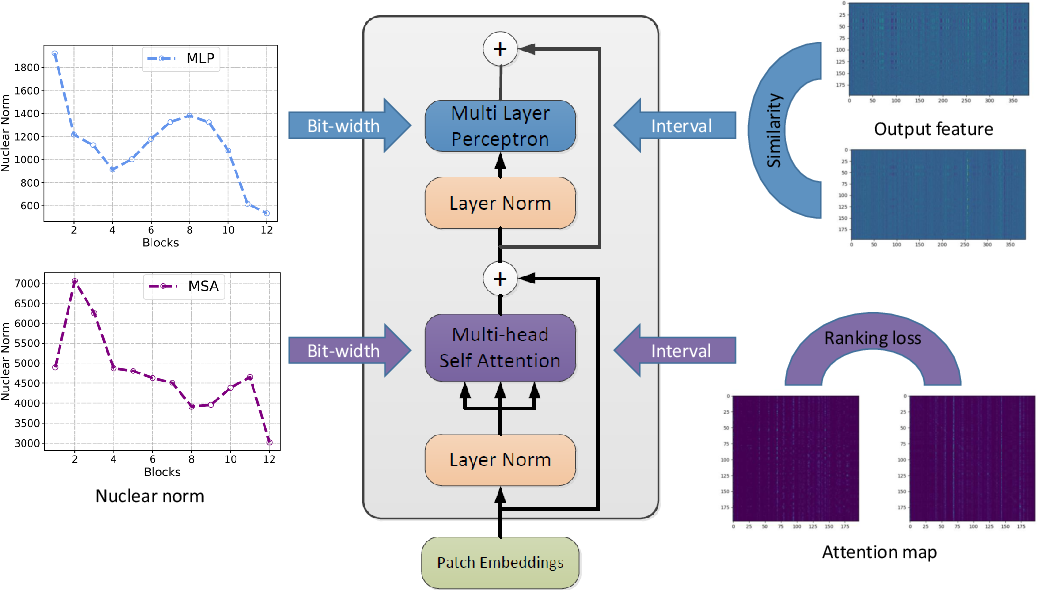
Figure 1 from Post-Training Quantization for Vision Transformer ...

(PDF) Q-HyViT: Post-Training Quantization for Hybrid Vision Transformer ...
TSPTQ-ViT: TWO-SCALED POST-TRAINING QUANTIZATION FOR VISION TRANSFORMER ...

(PDF) Efficient Vision Transformer YOLOv5 for Accurate and Fast Traffic ...
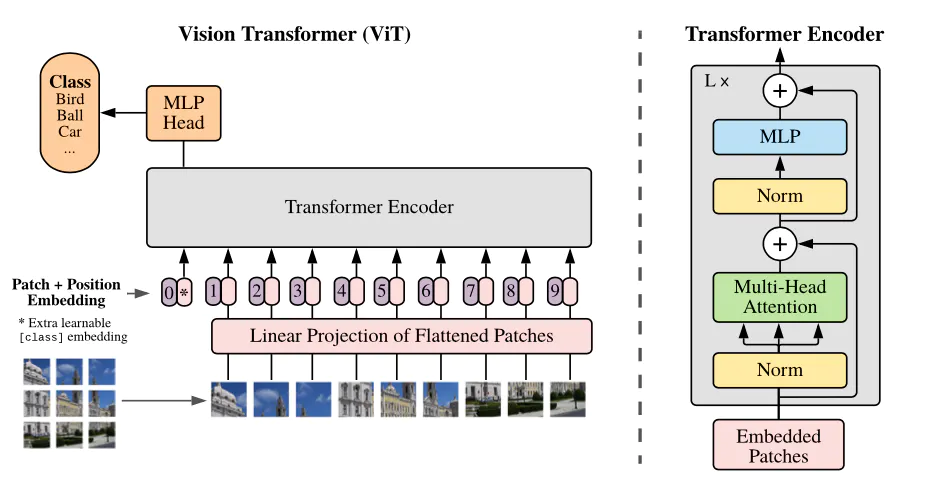
Accelerate Vision Transformer (ViT) with Quantization using Optimum
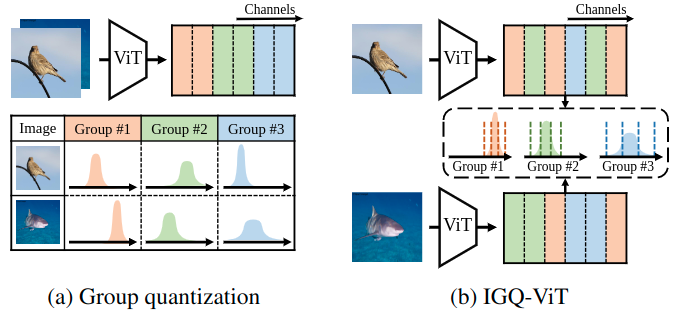
Instance-Aware Group Quantization for Vision Transformers
FQ-ViT: Post-Training Quantization for Fully Quantized Vision ...
Advertisement Space (336x280)

(PDF) TSPTQ-ViT: Two-scaled post-training quantization for vision ...

(PDF) Bi-ViT: Pushing the Limit of Vision Transformer Quantization

(PDF) Variation-aware Vision Transformer Quantization
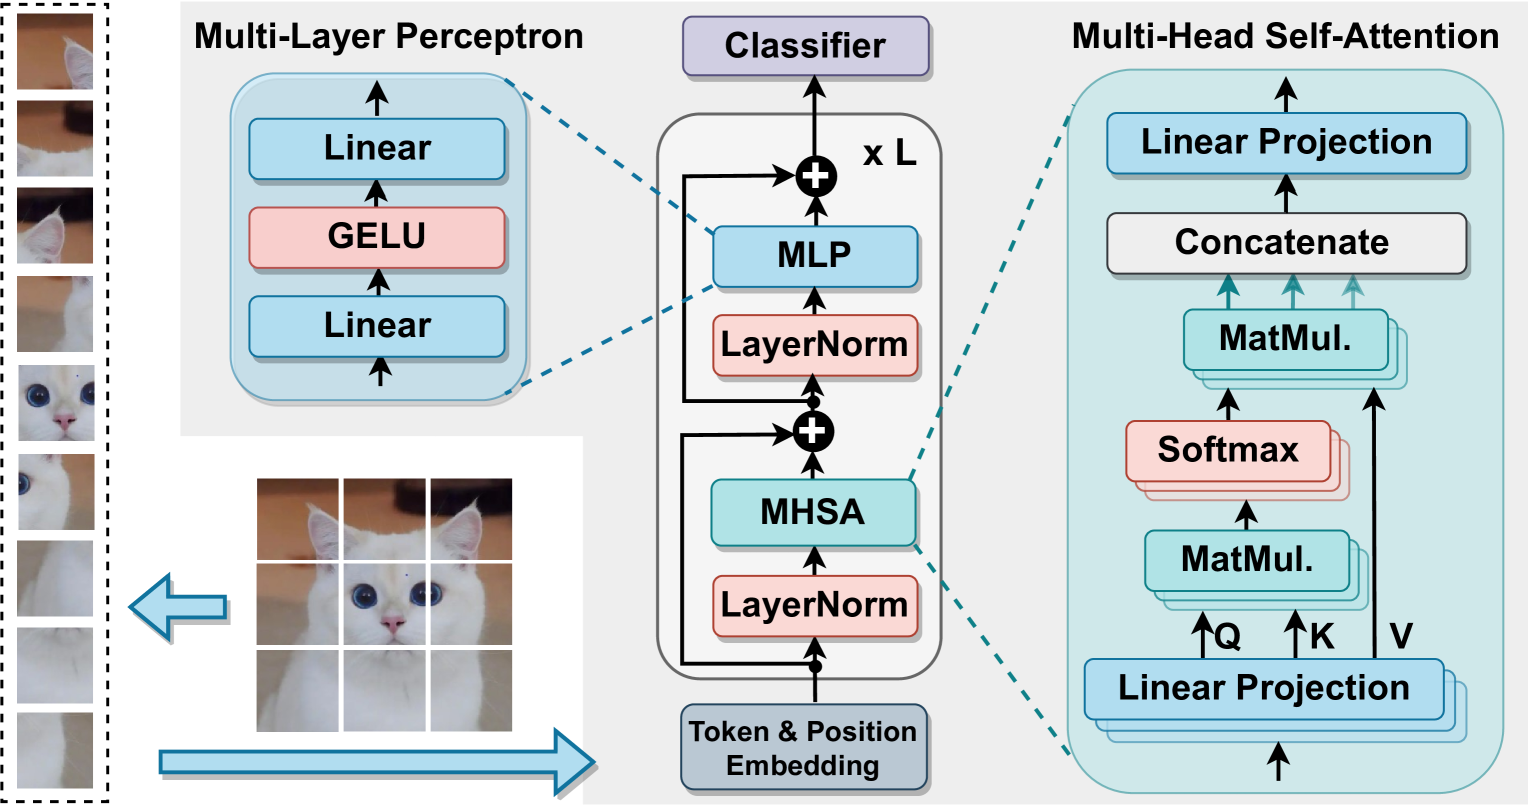
Model Quantization and Hardware Acceleration for Vision Transformers: A ...

Patch-wise Mixed-Precision Quantization of Vision Transformer | DeepAI
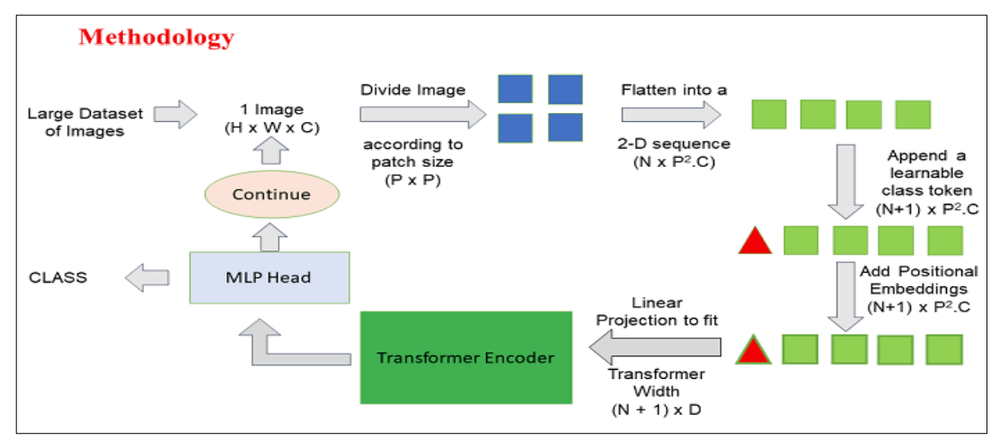
Quantizing Vision Transformers for Efficient Deployment: Strategies and ...