
I Segmenter Integer Only Vision Transformer For Efficient Semantic
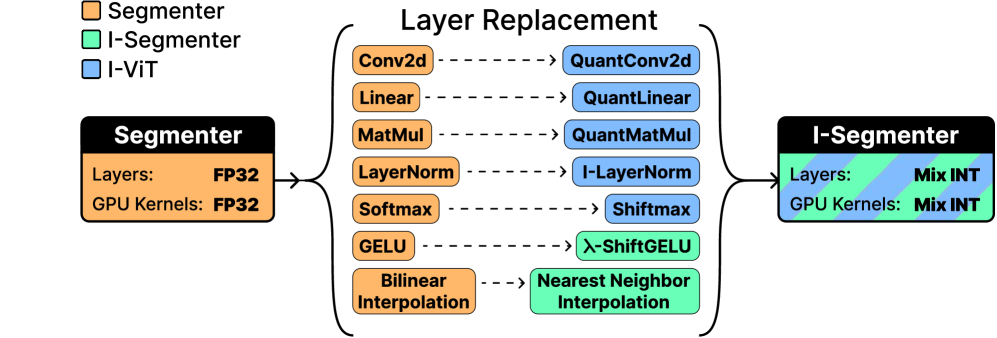
I-Segmenter: Integer-Only Vision Transformer for Efficient Semantic ...

I-Segmenter: Integer-Only Vision Transformer for Efficient Semantic ...
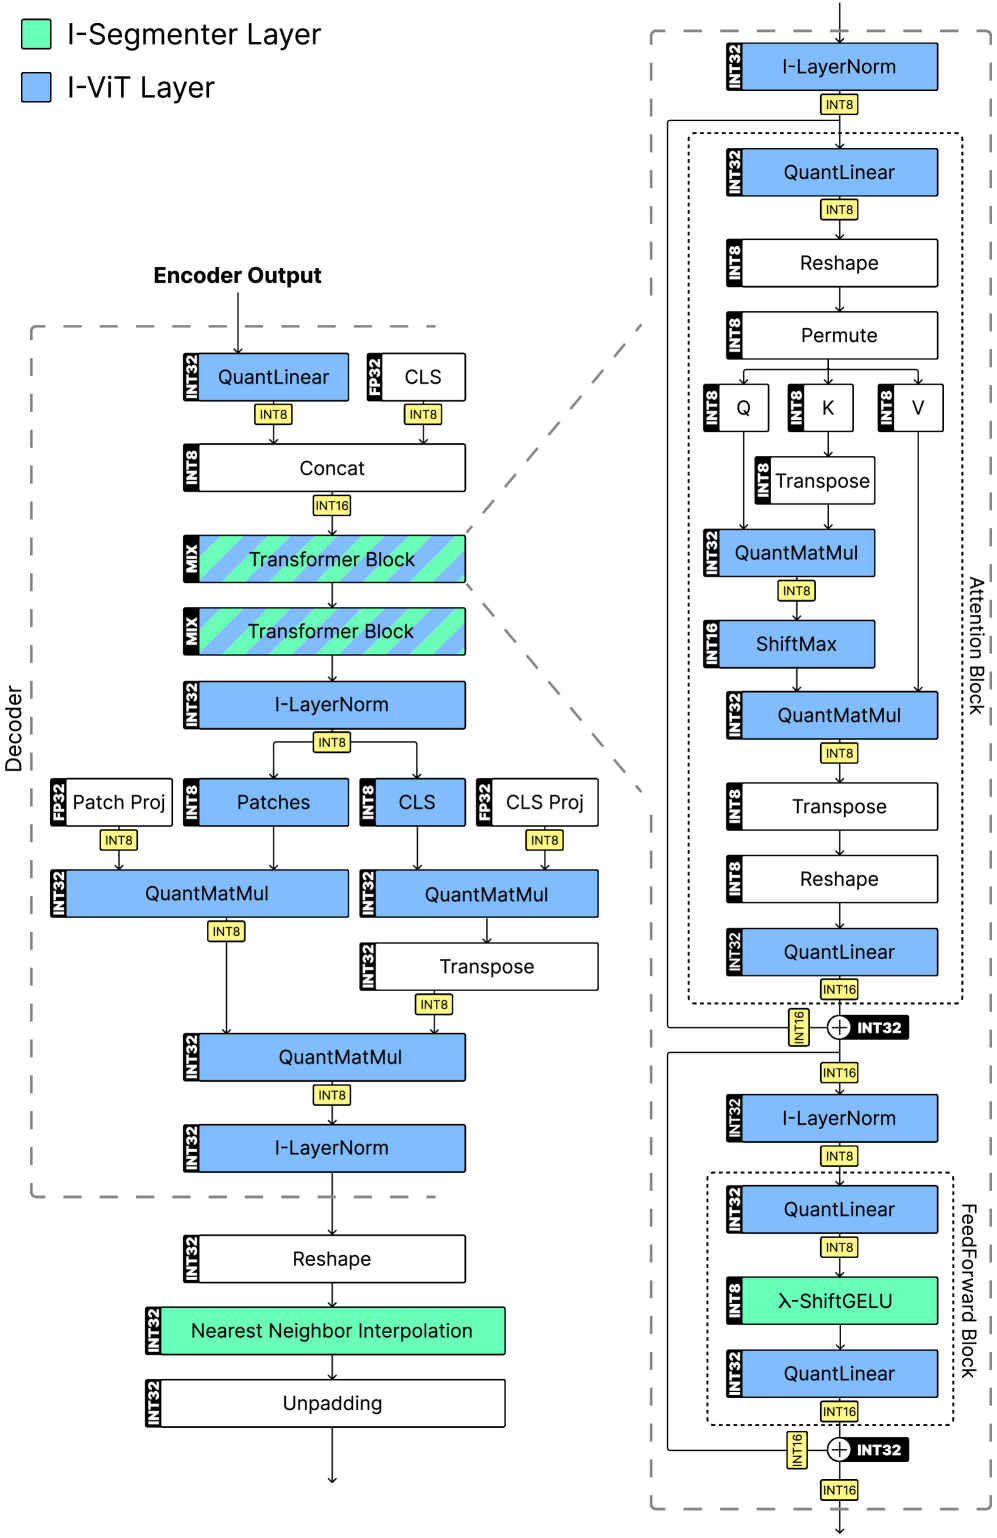
I-Segmenter: Integer-Only Vision Transformer for Efficient Semantic ...
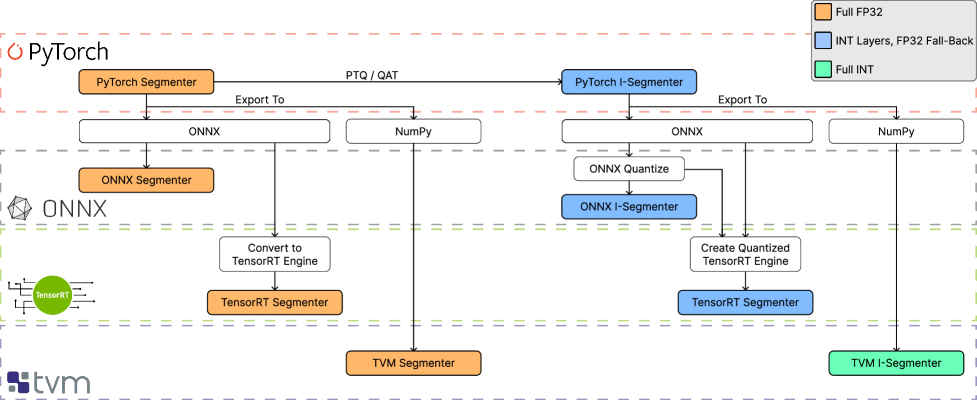
I-Segmenter: Integer-Only Vision Transformer for Efficient Semantic ...
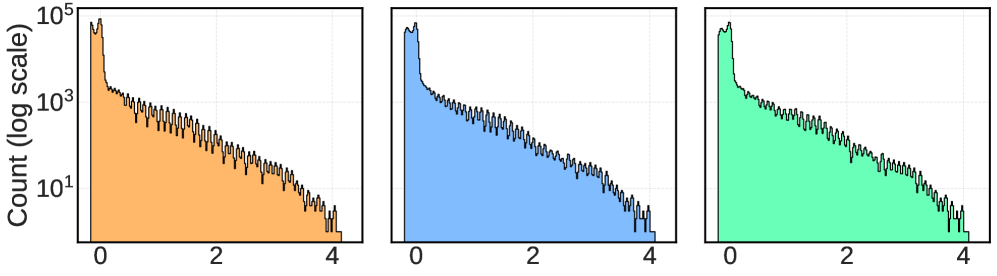
I-Segmenter: Integer-Only Vision Transformer for Efficient Semantic ...

I-Segmenter: Integer-Only Vision Transformer for Efficient Semantic ...

Paper page - I-Segmenter: Integer-Only Vision Transformer for Efficient ...

(PDF) I-Segmenter: Integer-Only Vision Transformer for Efficient ...
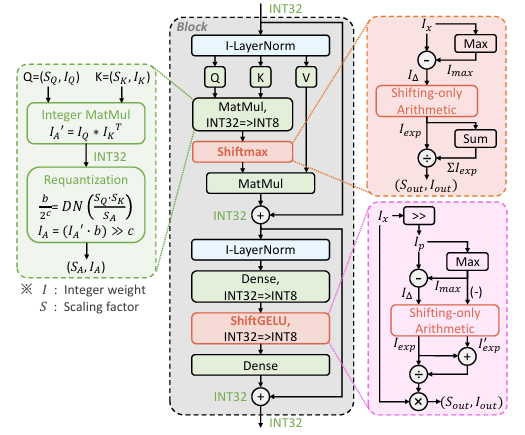
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
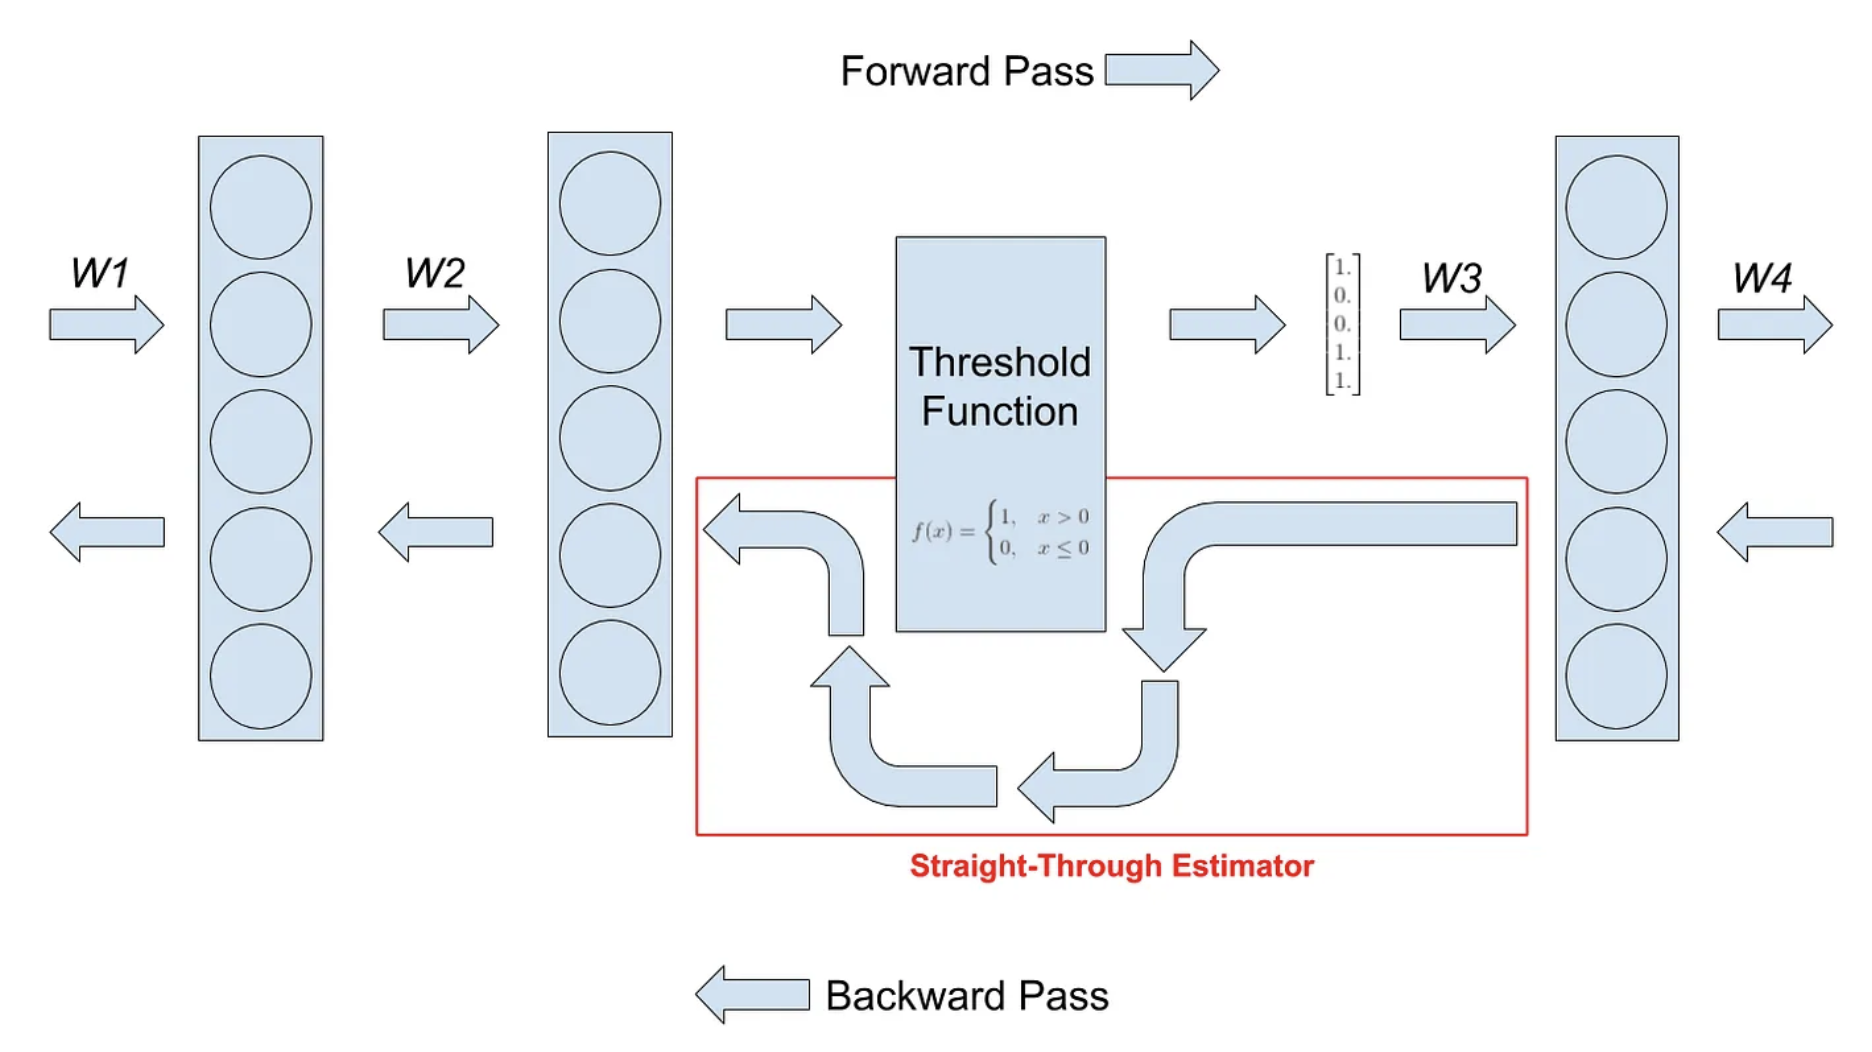
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
Advertisement Space (300x250)
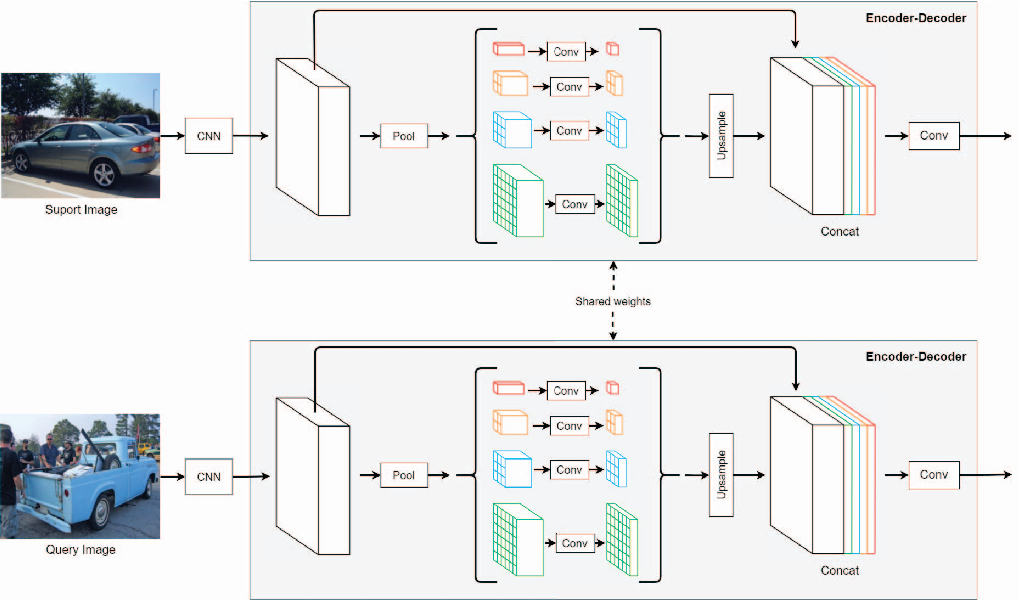
Figure 2 from Cross-Attention Vision Transformer for Few-Shot Semantic ...
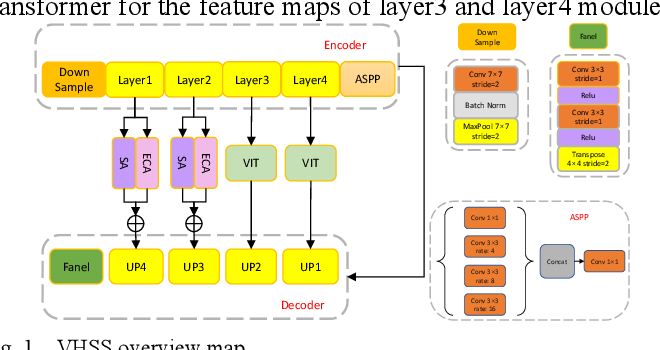
Figure 1 from Vision Transformer is Required for Hyperspectral Semantic ...
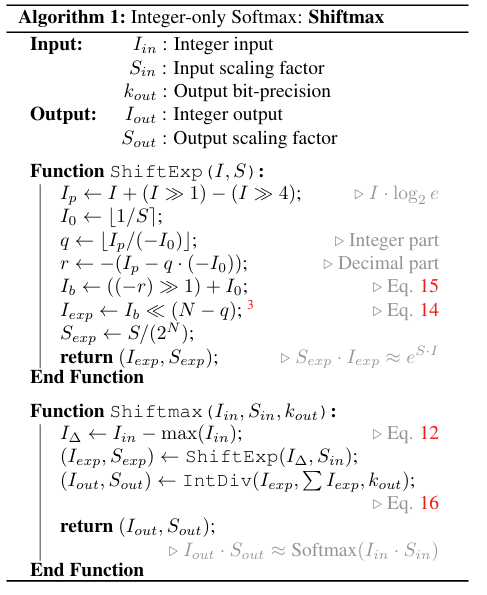
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
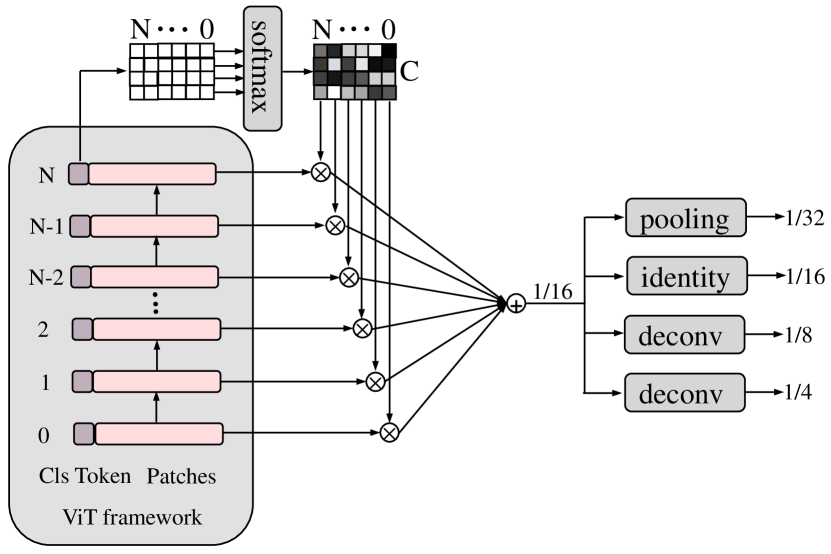
[2305.01279] Exploring vision transformer layer choosing for semantic ...

I-ViT: Integer-only Quantization for Efficient Vision Transformer Inference
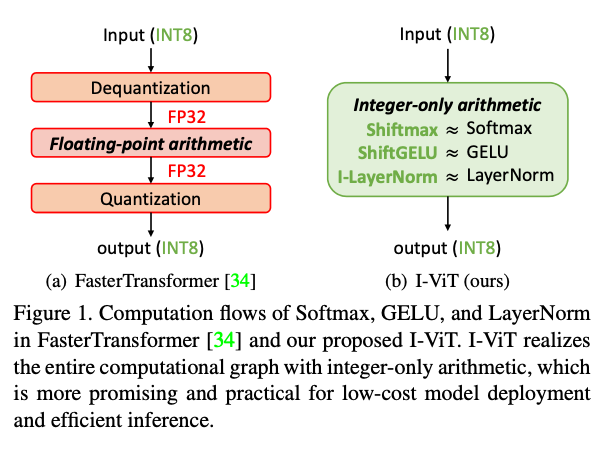
I-ViT: Integer-only Quantization for Efficient Vision Transformer ...
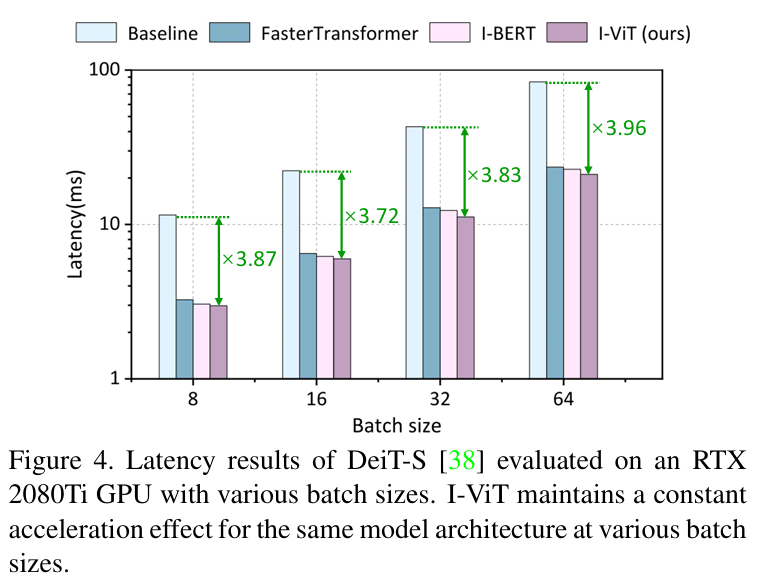
I-ViT: Integer-only Quantization for Efficient Vision Transformer ...

SegFormer: Simple and Efficient Design for Semantic Segmentation with ...
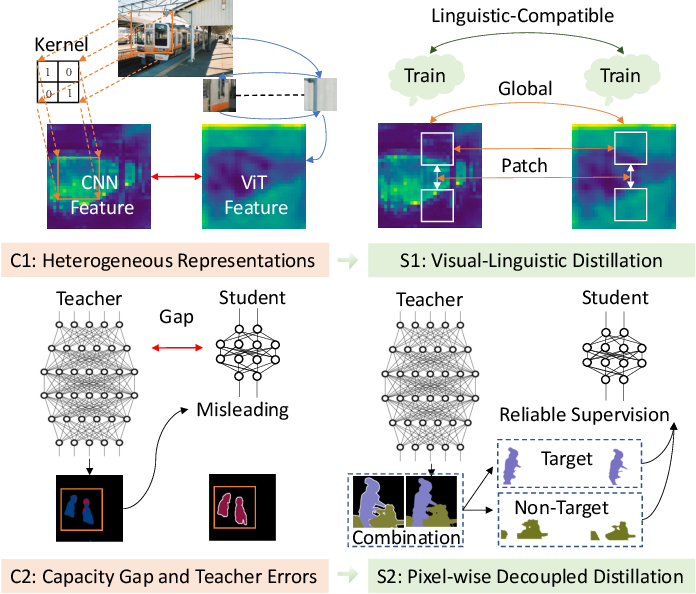
Figure 1 from Distilling Efficient Vision Transformers from CNNs for ...
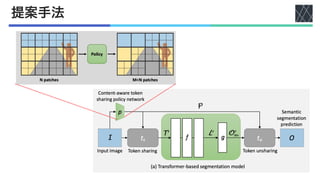
論文紹介:Content-Aware Token Sharing for Efficient Semantic Segmentation ...
Advertisement Space (336x280)

An Efficient Semantic Segmentation Method for Remote-Sensing Imagery ...
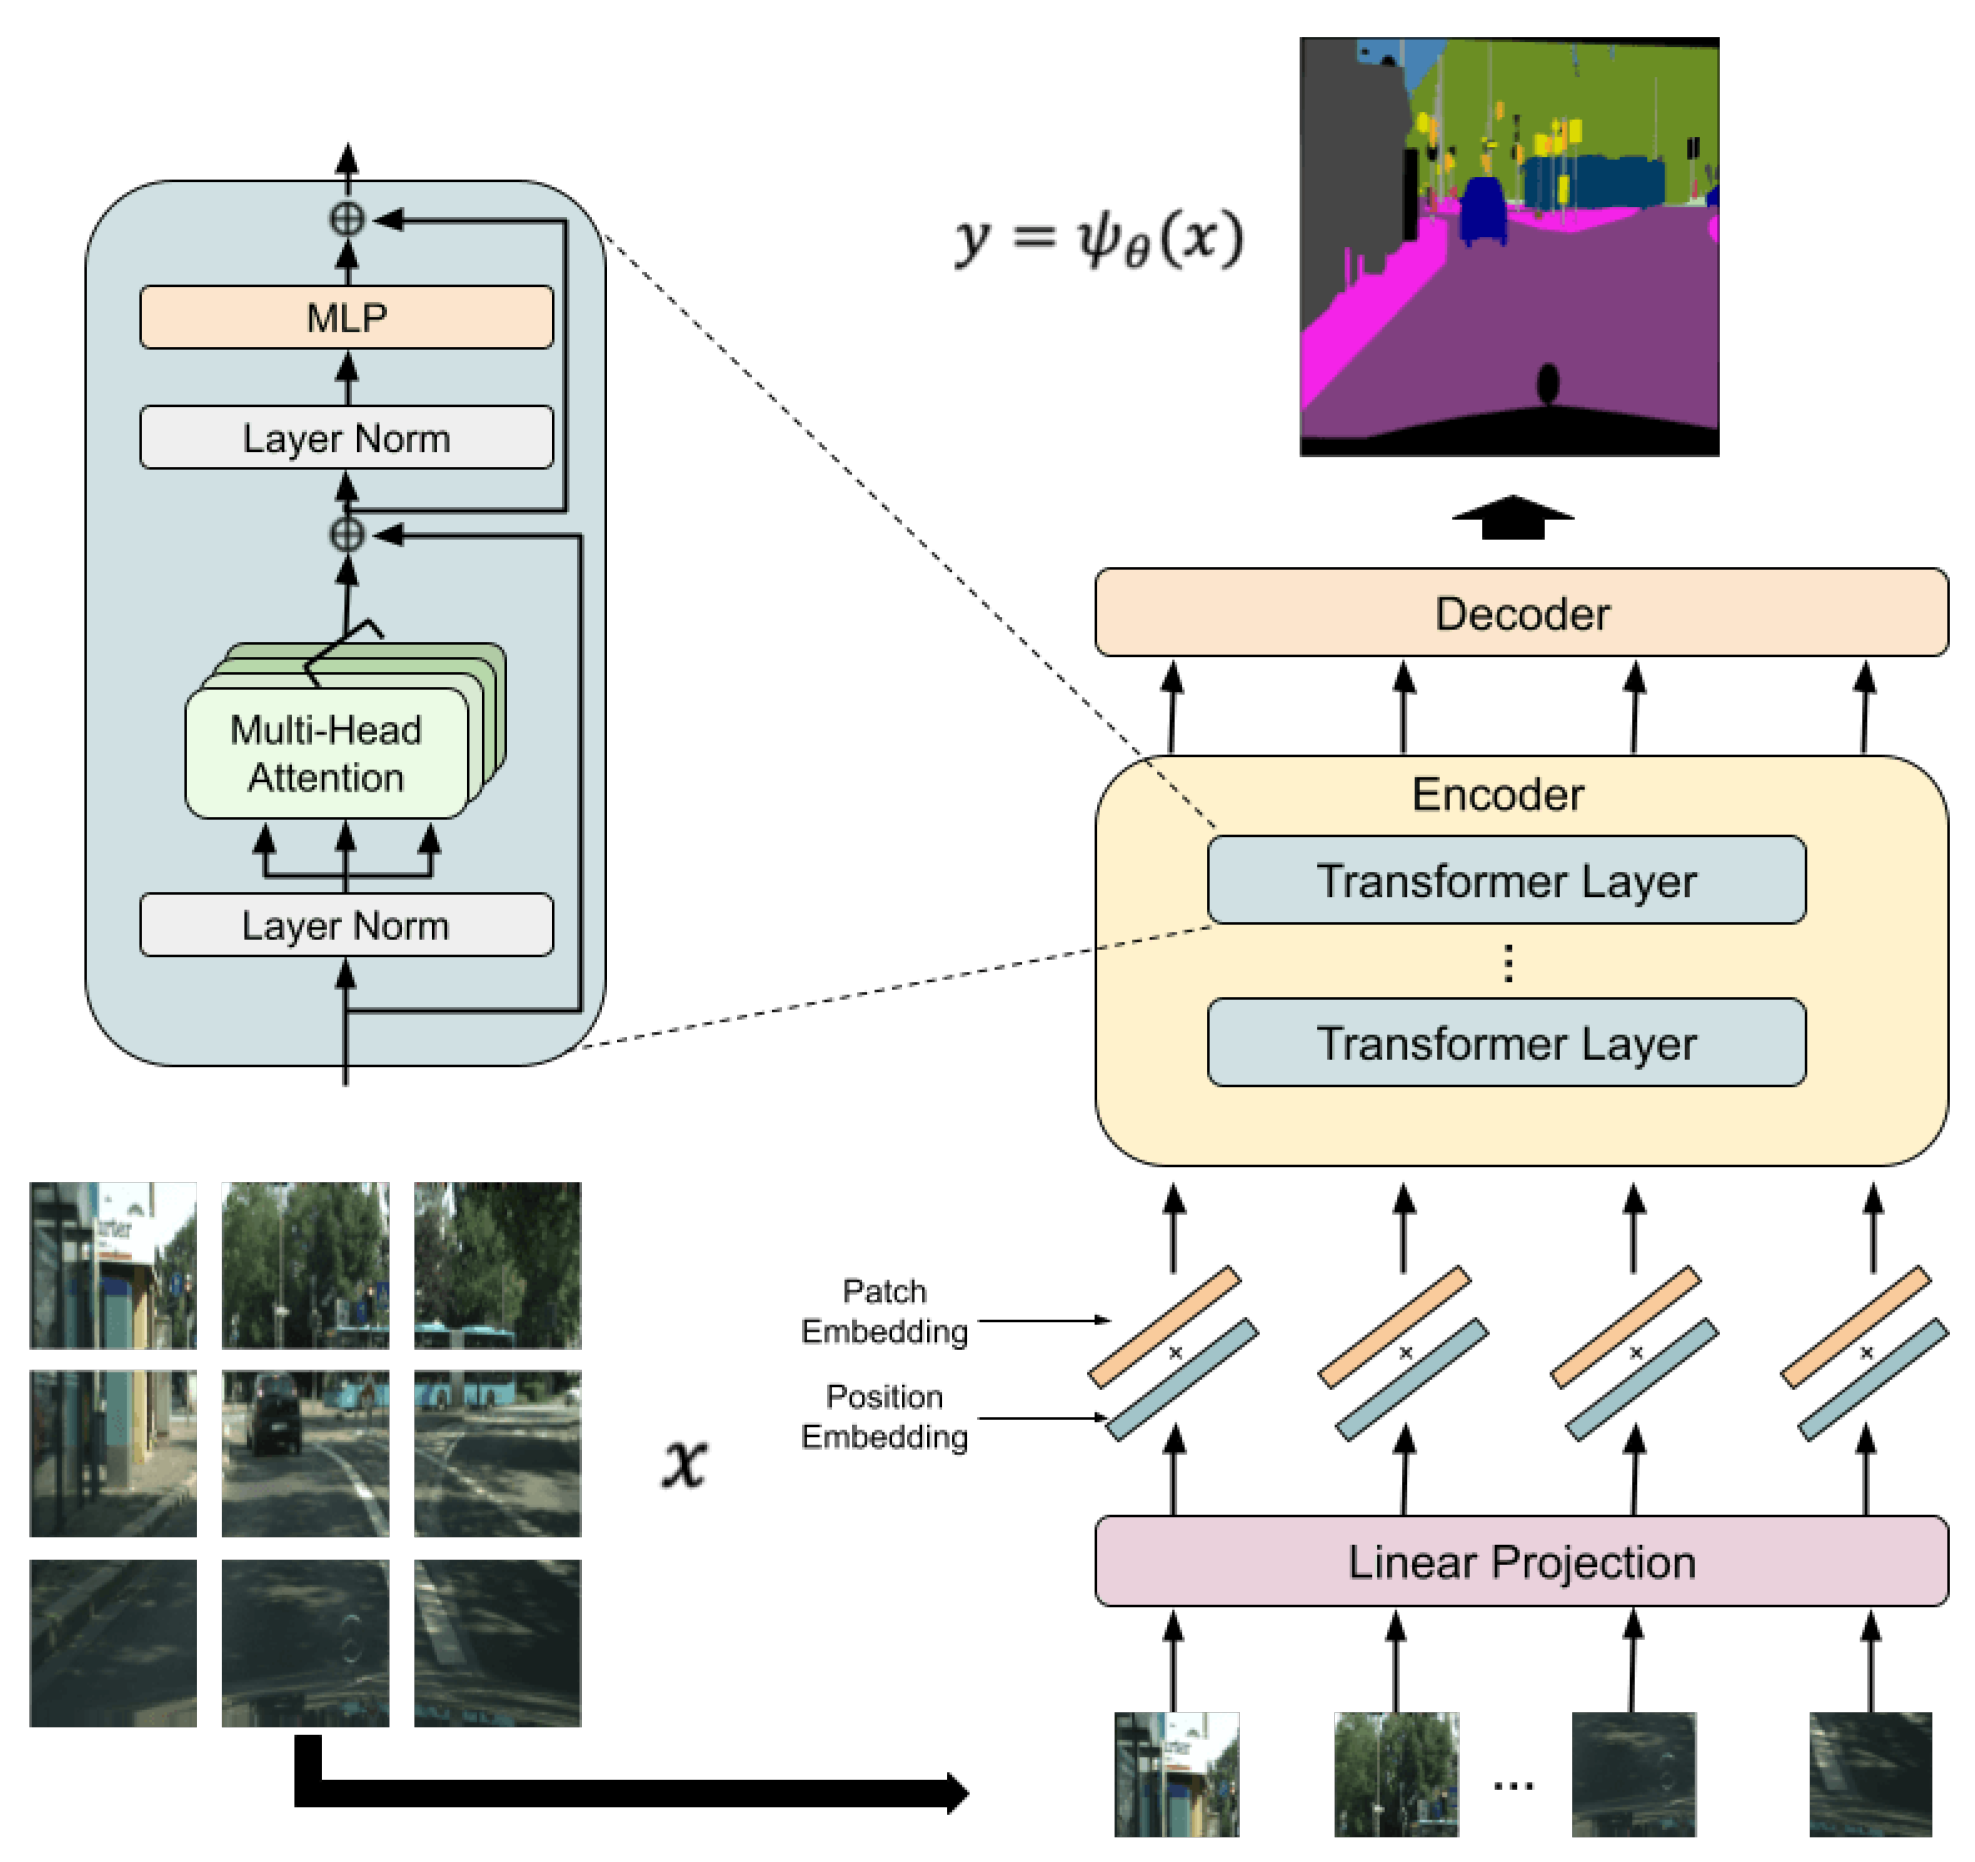
Privacy-Preserving Semantic Segmentation Using Vision Transformer

Figure 1 from Content-aware Token Sharing for Efficient Semantic ...
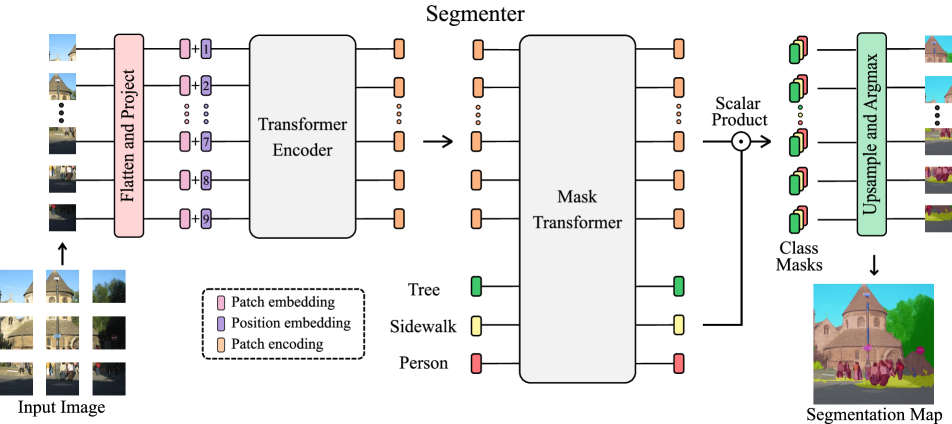
[2105.05633] Segmenter: Transformer for Semantic Segmentation

《SegFormer:Simple and Efficient Design for Semantic Segmentation with ...
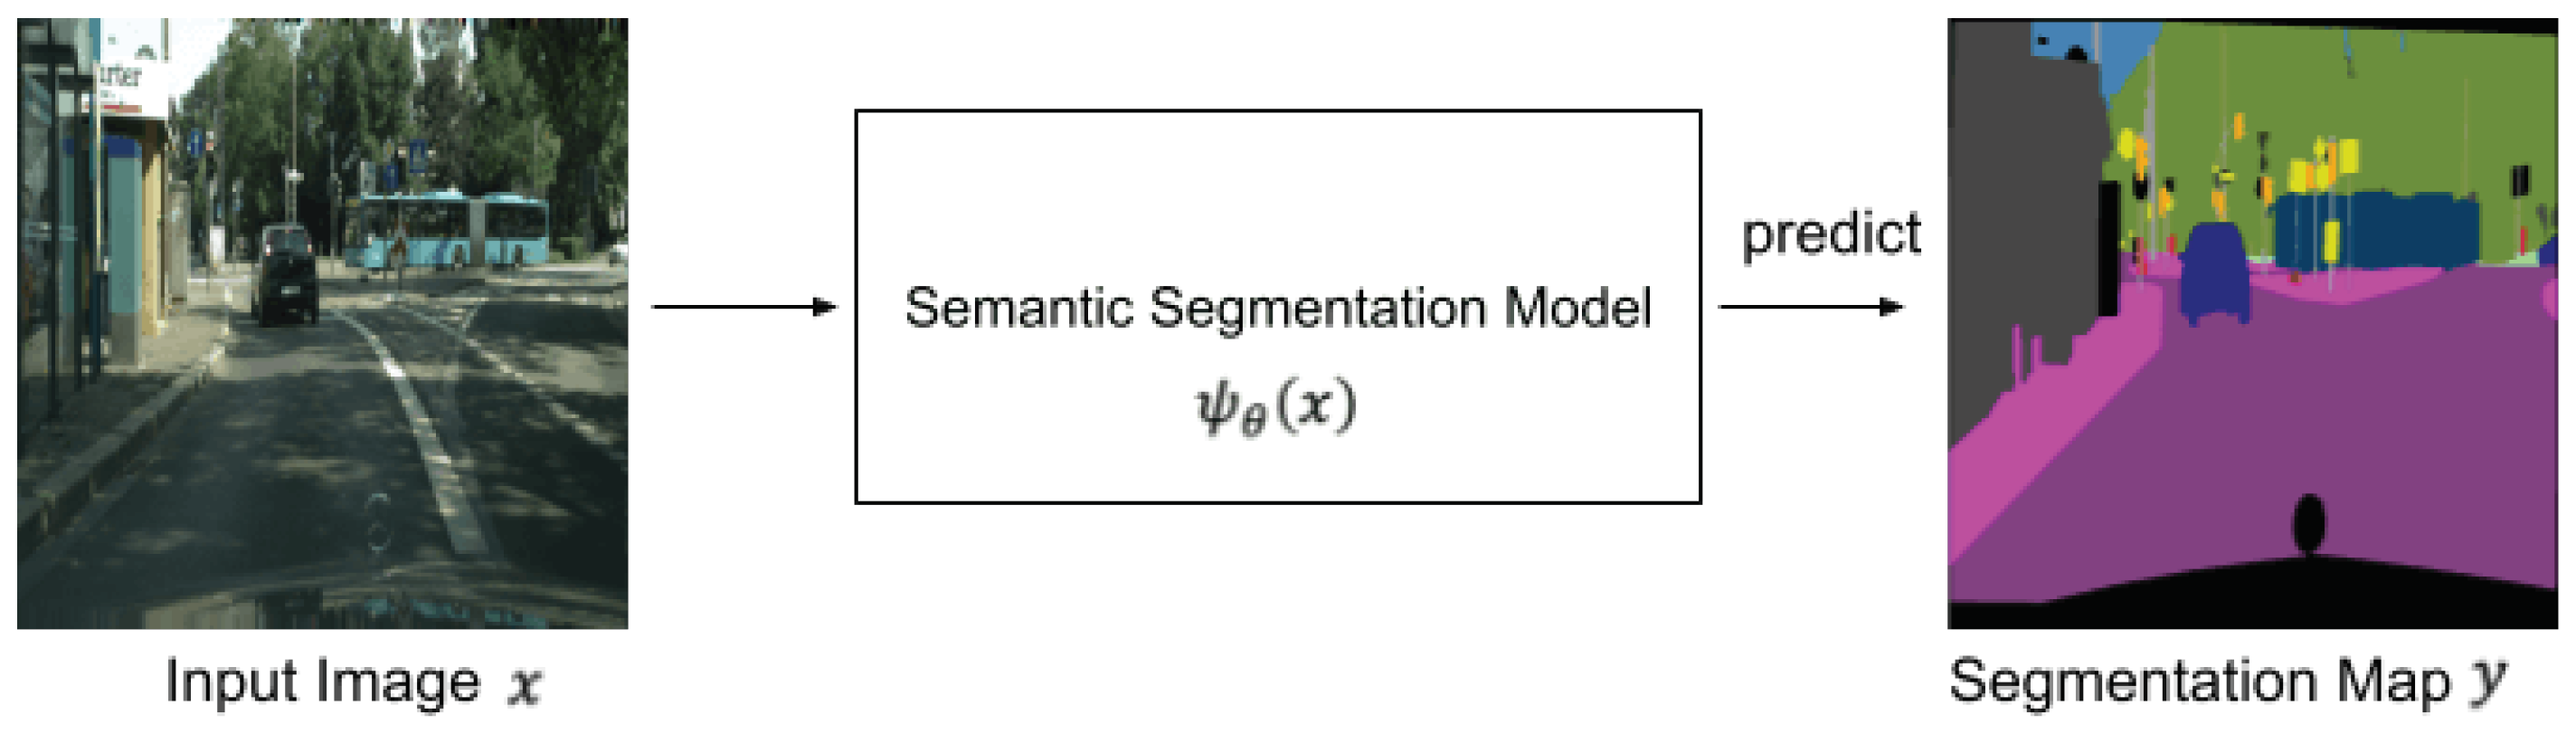
Privacy-Preserving Semantic Segmentation Using Vision Transformer
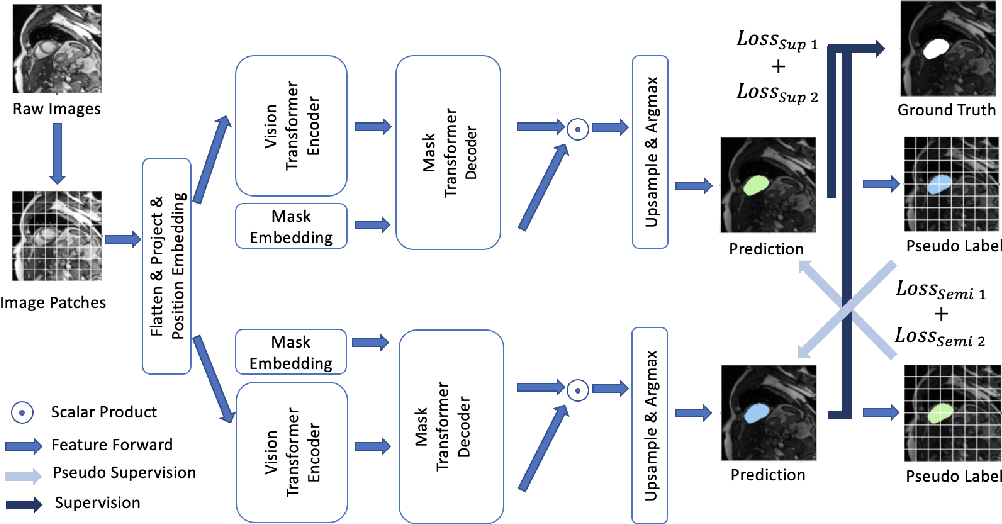
Figure 1 from Computationally-Efficient Vision Transformer for Medical ...
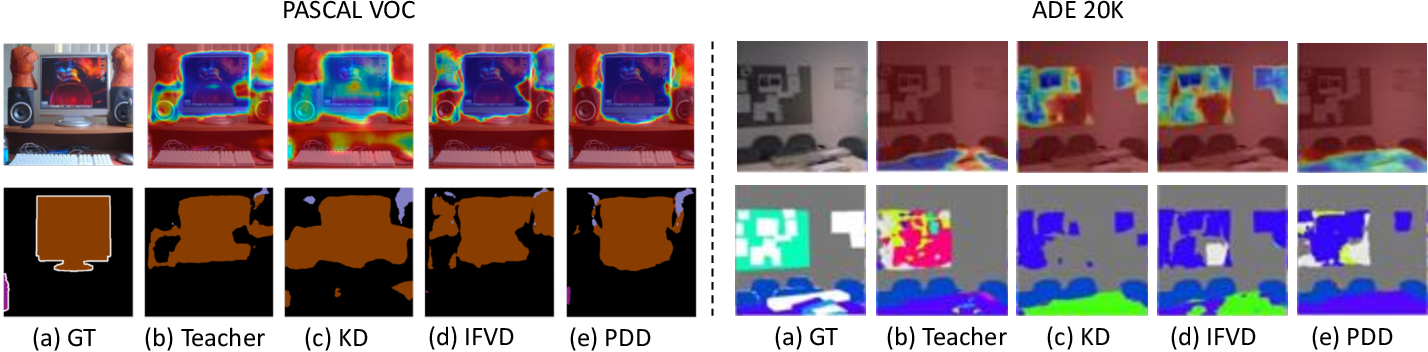
Figure 10 from Distilling Efficient Vision Transformers from CNNs for ...
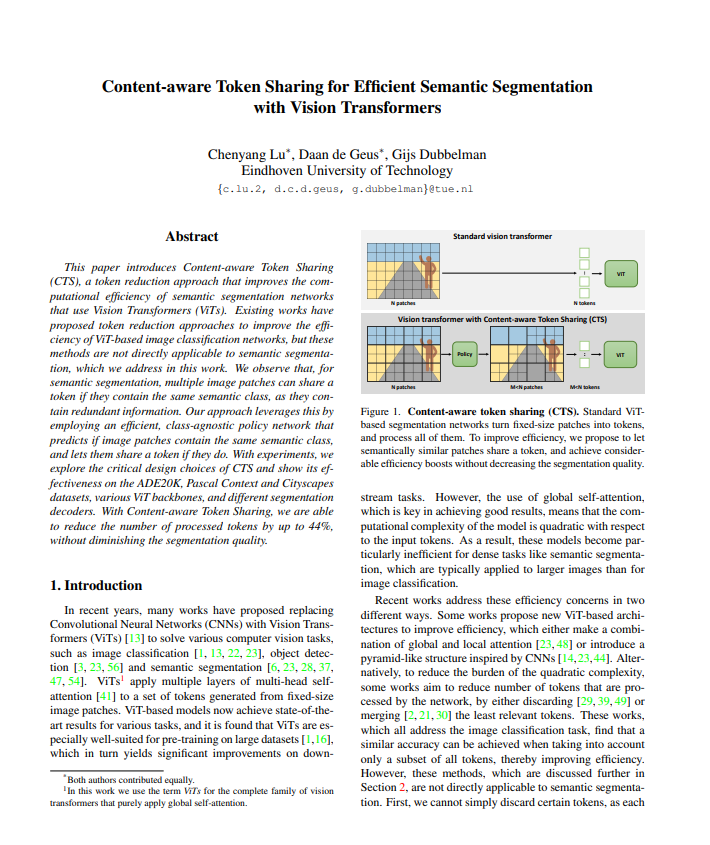
Content-aware Token Sharing for Efficient Semantic Segmentation with ...
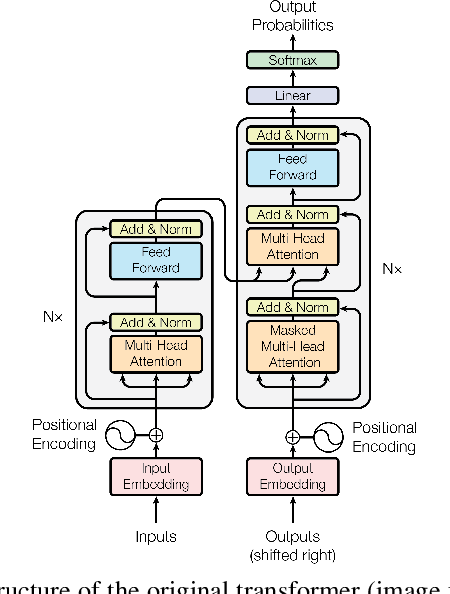
Figure 2 from A Survey on Vision Transformer | Semantic Scholar
Advertisement Space (336x280)
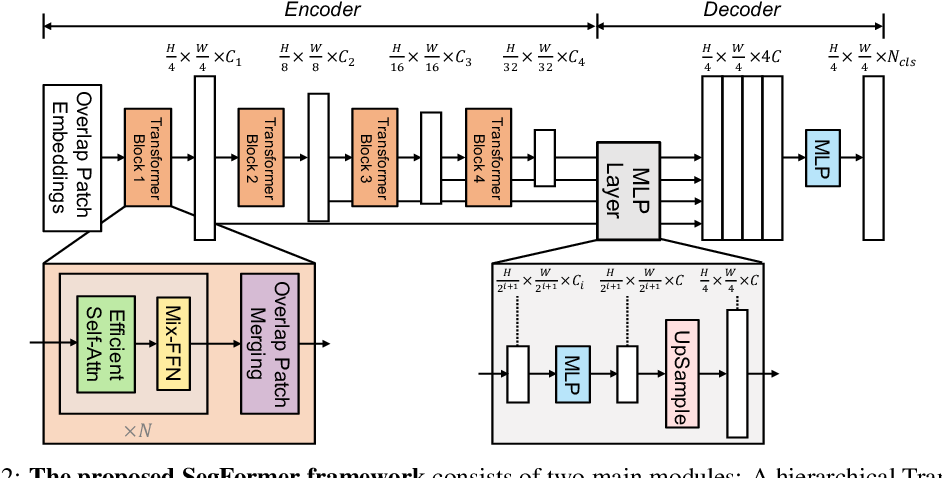
Figure 2 from SegFormer: Simple and Efficient Design for Semantic ...
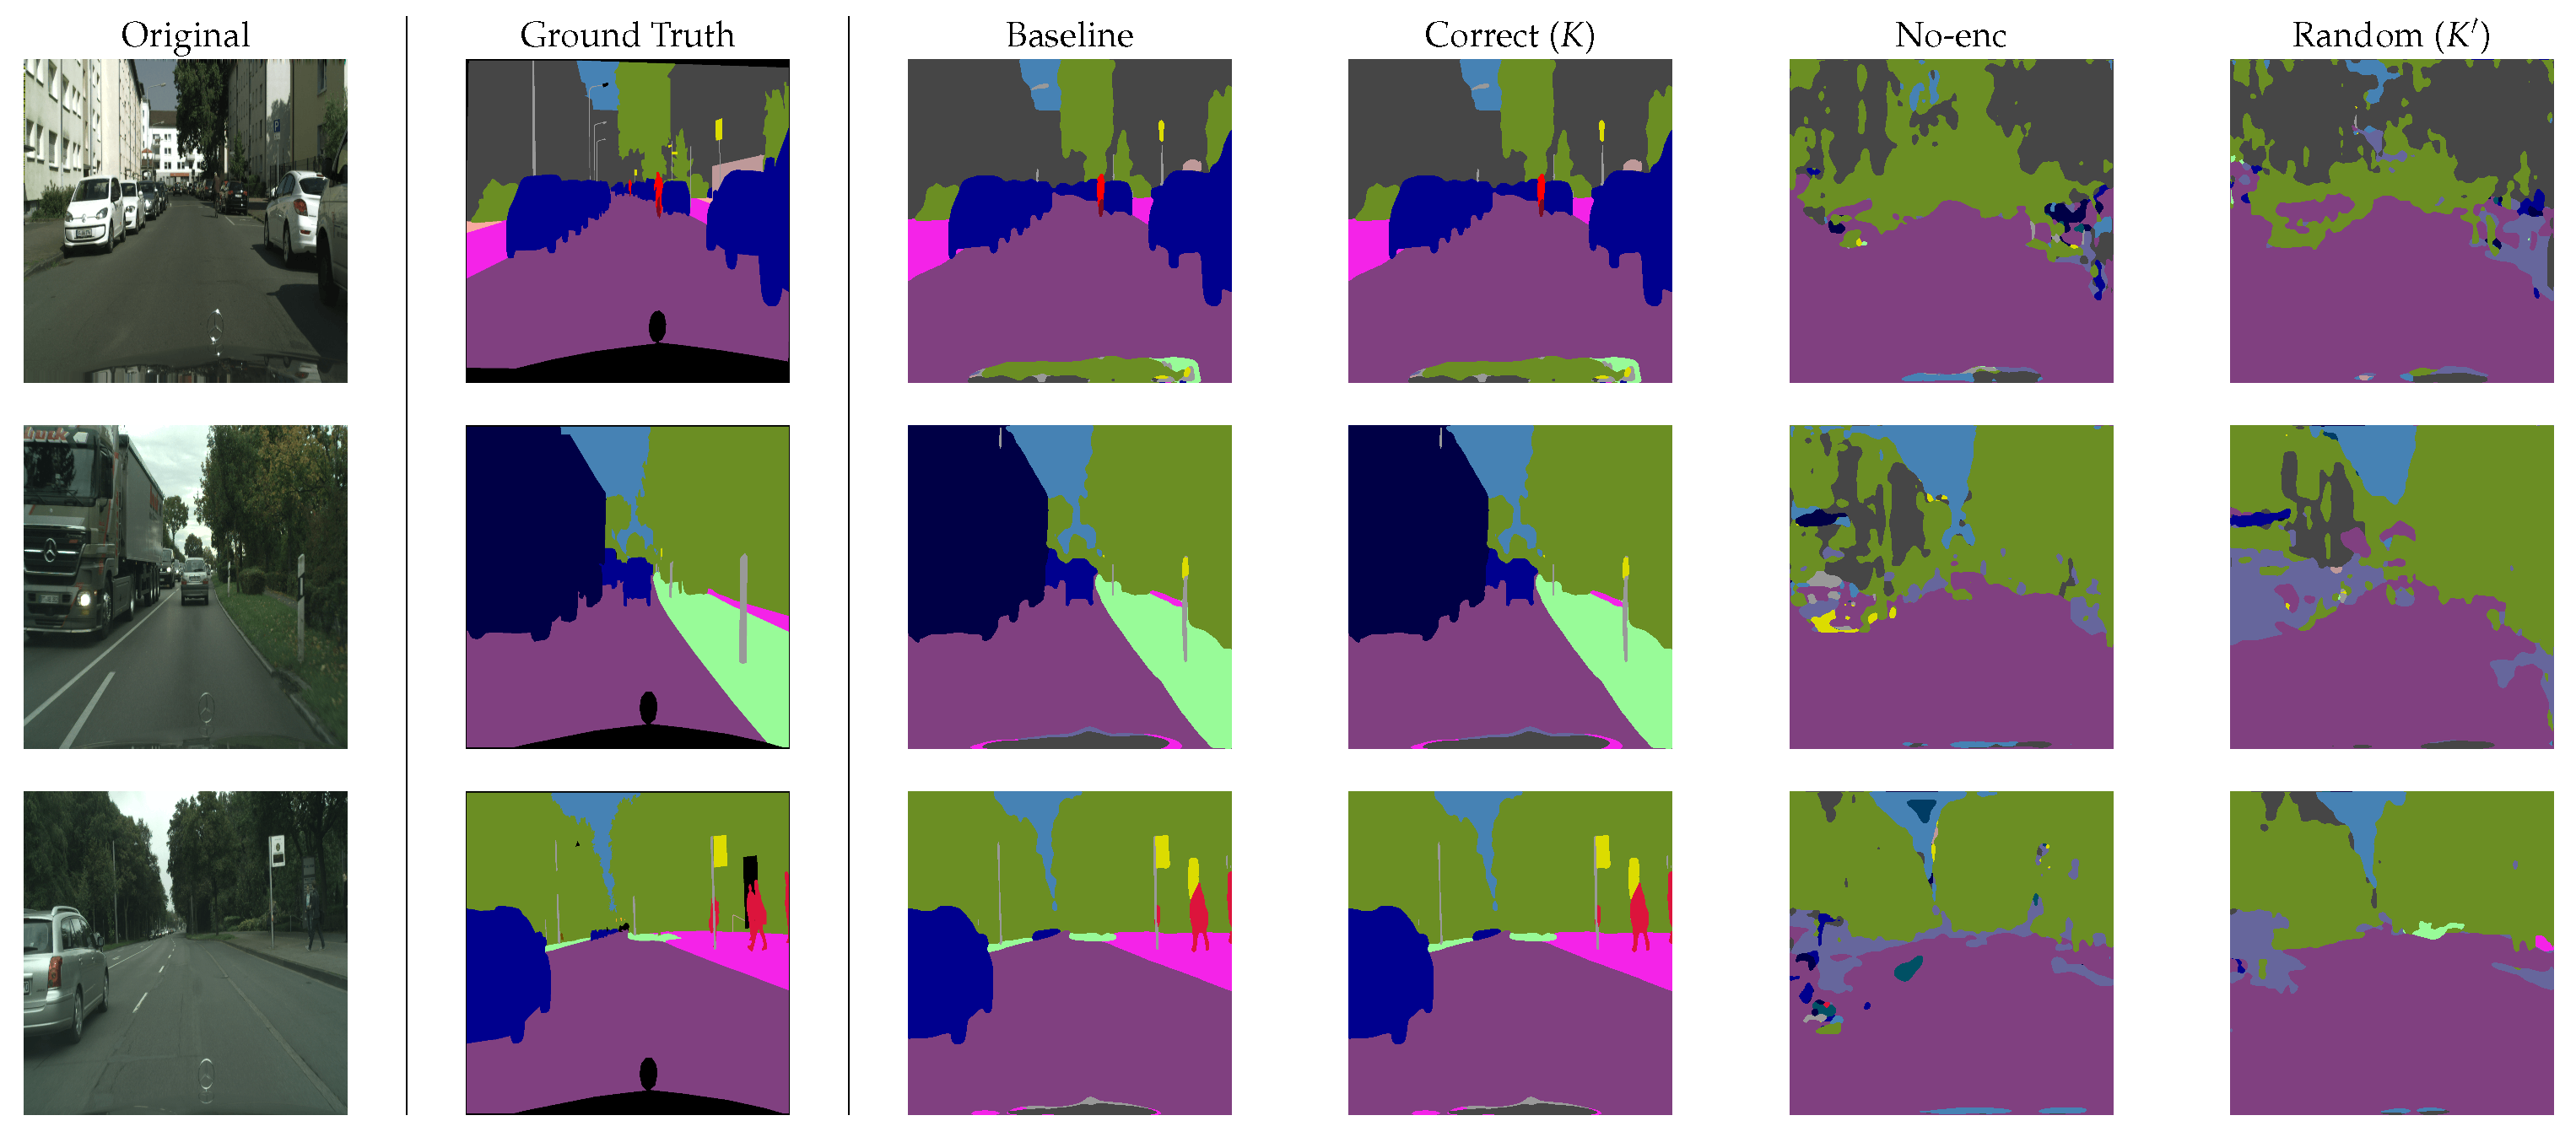
Privacy-Preserving Semantic Segmentation Using Vision Transformer
論文紹介:Content-Aware Token Sharing for Efficient Semantic Segmentation ...

Privacy-Preserving Semantic Segmentation Using Vision Transformer

SegFormer: Simple and Efficient Design for Semantic Segmentation with ...
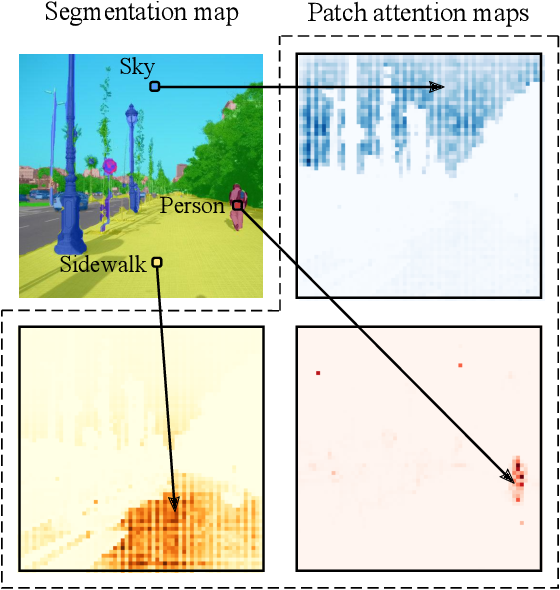
Figure 1 from Segmenter: Transformer for Semantic Segmentation ...